O DeepSeek V4 Flash 0731 entrou em versão beta pública e traz uma promessa conhecida: capacidade de codificação e agente mais forte a preços...

O DeepSeek V4 Flash 0731 entrou em versão beta pública com uma promessa familiar: capacidades mais fortes de codificação e agentes a preços de API extremamente baixos.
Os desenvolvedores rapidamente transformaram essa afirmação em experimentos práticos.
Um dos casos mais divulgados veio de uma execução do Hermes Agent, na qual o DeepSeek V4 Flash gerou um jogo de tiro 3D em primeira pessoa jogável com apenas um prompt inicial. O projeto levou 32 minutos e o custo de uso do modelo foi de apenas US$ 0,07.
Os resultados finais incluíram:
O DeepSeek V4 suporta uma janela de contexto de 1 milhão de tokens.
Os sistemas de atenção tradicionais se tornam extremamente caros nessa escala, pois cada novo token pode precisar examinar uma grande quantidade de contexto anterior e manter um grande cache KV.
O relatório técnico do DeepSeek descreve um design de atenção híbrida, combinando:
A estratégia geral é evitar computação de atenção completa e cara em todo o histórico a cada etapa.
O sistema comprime e filtra o contexto, permitindo que o modelo concentre a computação nas informações mais úteis.
O DeepSeek relatou que, em um contexto de 1 milhão de tokens, o V4 Pro precisa de:
27% dos FLOPs de inferência por token do DeepSeek V3.2.
Essas porcentagens exatas são relatadas no artigo técnico para o V4 Pro, não são dados de auditoria separados para o Flash.
O V4 Flash usa a mesma família de arquitetura, portanto se beneficia dos mesmos princípios de design de contexto longo.
Os efeitos práticos incluem a redução de:
e tráfego de memória
O modelo V4 Flash lançado usa pesos de precisão mista baixa.
A DeepSeek lista:
Precisão mista FP4 + FP8
A menor precisão reduz a quantidade de dados que precisam ser armazenados, carregados da memória, transferidos entre dispositivos e processados durante a inferência.
Isso é importante porque a inferência de modelos de linguagem modernos costuma ser limitada pela largura de banda da memória, não apenas pela capacidade bruta de operações aritméticas.
Se o hardware e o kernel forem projetados para executar esse formato com eficiência, representações menores de dados podem aumentar a taxa de transferência.
Baixa precisão não é gratuita por natureza.
Quantização ruim reduz a qualidade do modelo.
O lançamento da DeepSeek foi projetado e treinado em torno do esquema de precisão escolhido, não apenas dependendo de quantização comunitária posterior.
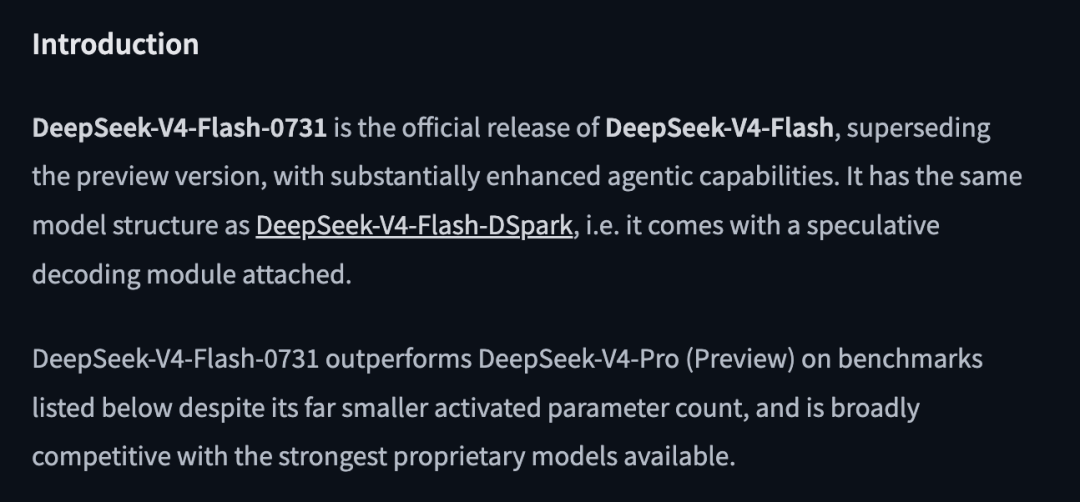
A DeepSeek afirma que a versão oficial 0731 mantém a mesma arquitetura e escala do V4 Flash preview.
A empresa não realizou um pré-treinamento completo novamente para esta atualização.
Em vez disso, refez o processo de pós-treinamento.
O artigo original resume as mudanças como:
O relatório técnico da DeepSeek descreve o processo de pós-treinamento mais amplo do V4 como:
A atualização 0731 foca em melhorar essas capacidades em fluxos de trabalho reais de agentes.
O DeepSeek-V4-Flash-0731 vem com o módulo de decodificação especulativa DSpark.
A decodificação especulativa usa um caminho de rascunho menor ou mais barato para propor múltiplos tokens futuros.
O modelo principal valida essas propostas em lote.
O fluxo simplificado é:
O módulo de rascunho propõe tokens
→ O modelo principal valida simultaneamente
→ Tokens aceitos são emitidos
→ Caminhos rejeitados são corrigidos
Quando as previsões do rascunho são precisas, o sistema pode gerar múltiplos tokens aceitos com menos inferência sequencial cara do modelo principal.
A DeepSeek oferece suporte ao DSpark tanto para vLLM quanto para SGLang.
Para vLLM, o cartão oficial do modelo usa:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Para SGLang, a opção correspondente é:
--speculative-algorithm DSPARK
A DeepSeek afirma que os pesos do modelo alvo e do modelo de rascunho estão armazenados no mesmo checkpoint, portanto o SGLang não precisa de um caminho separado para o modelo de rascunho.
A decodificação especulativa melhora principalmente a velocidade de serviço e a taxa de transferência.
Por si só, ela não explica os ganhos de capacidade de raciocínio do modelo.
Esses avanços vêm do processo de pós-treinamento atualizado.
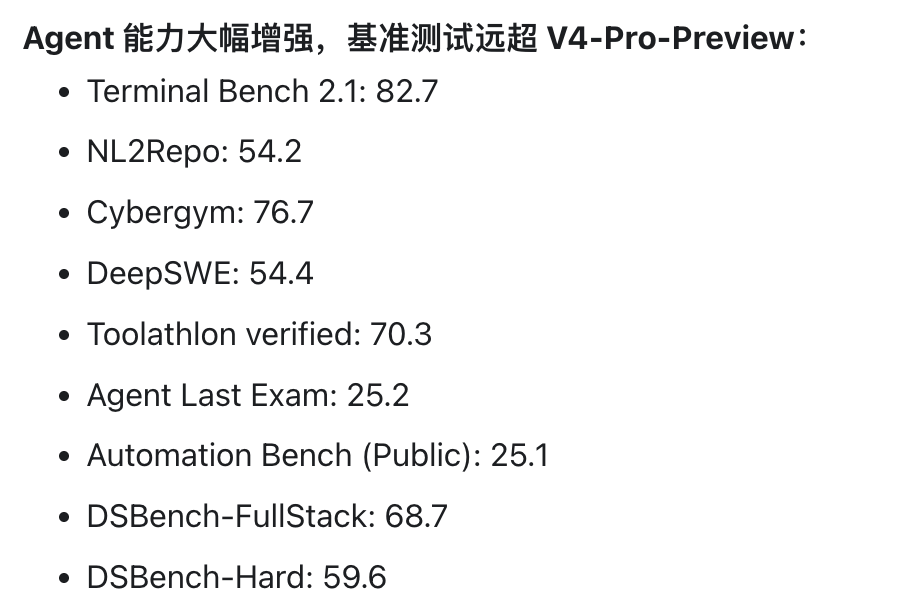
A DeepSeek relatou grandes avanços em vários testes focados em agentes em comparação com o V4 Flash preview.
| Benchmark | V4 Flash 0731 | V4 Flash preview | V4 Pro preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 |
12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
A DeepSeek afirma que os benchmarks públicos de agentes de código foram executados com a seguinte configuração:
Modo mínimo do DeepSeek Harness
reasoning_effort = max
top_p = 0.95
temperature = 1.0
Até o momento da atualização oficial, essa estrutura de testes ainda não havia sido publicada.
DSBench-FullStack e DSBench-Hard são benchmarks internos da DeepSeek.
Isso significa que suas pontuações podem servir como evidência de referência relatada pela empresa, mas não são verificáveis de forma independente como suítes de benchmark totalmente públicas.
O Terminal Bench avalia a capacidade do agente de concluir tarefas em um ambiente de terminal.
O modelo pode precisar inspecionar arquivos, executar comandos, instalar dependências, depurar falhas, modificar código e verificar a conclusão.
Uma pontuação alta reflete o desempenho combinado do modelo, da estrutura do agente, da estratégia de ferramentas, do orçamento de raciocínio e do ambiente de execução.
O Toolathlon avalia tarefas de longo ciclo em vários aplicativos e ferramentas de software.
O benchmark inclui cenários envolvendo calendário, sistemas de arquivos, Notion, WooCommerce, Kubernetes e BigQuery.
As tarefas exigem múltiplas interações com ferramentas e são validadas por avaliadores baseados em execução.
A pontuação de 70,3 relatada pela DeepSeek representa um grande avanço em relação ao modelo de visualização.
Mas isso não deve ser interpretado como uma garantia de 70,3% de sucesso em toda automação de negócios real.
O exemplo de jogo na fonte revela uma diferença importante entre desempenho em benchmarks e codificação criativa.
O V4 Flash teve desempenho forte nas avaliações oficiais de agentes, mas uma comparação de jogos ainda exigiu três iterações.
Benchmarks podem medir taxas de sucesso em conjuntos de tarefas bem definidos e regras de avaliação conhecidas.
Projetos criativos podem incluir requisitos visuais vagos, problemas de compatibilidade com navegadores, erros do motor de física, recursos ausentes, julgamentos subjetivos de qualidade e nenhuma suíte de testes única que defina sucesso.
Nesse cenário, modelos de baixo custo são especialmente úteis, pois o fluxo de trabalho pode tolerar múltiplas iterações.
Seu valor não está necessariamente em gerar perfeição na primeira tentativa.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Pode ser:
Qualidade aceitável
×
Grande número de tentativas acessíveis
A DeepSeek disponibiliza seus modelos das seguintes formas:
A URL Base compatível com OpenAI é:
https://api.deepseek.com
A URL Base compatível com Anthropic é:
https://api.deepseek.com/anthropic
A DeepSeek afirma que o V4 Flash é atualmente o único modelo da API V4 que suporta a API Responses.
O suporte ao V4 Pro será planejado separadamente.
A compatibilidade com a API Responses também permite que o modelo seja usado no Codex por meio da configuração documentada da DeepSeek.
O DeepSeek V4 Flash suporta modos de raciocínio e sem raciocínio.
O modo de raciocínio é o padrão.
Para inferência local, o cartão oficial do modelo suporta três níveis de esforço de raciocínio:
low
high
max
A DeepSeek recomenda:
temperature = 1.0
top_p = 0.95
para cenários de agentes.
Para os níveis de esforço de raciocínio high e max, a empresa recomenda permitir um comprimento máximo de saída de até 384 mil tokens.
Configurações de raciocínio mais altas podem melhorar o desempenho em tarefas difíceis, mas também podem aumentar a latência, o volume de saída, o custo da API e o tempo do ciclo do agente.
Sistemas de produção devem avaliar o nível de esforço mais baixo que atenda de forma confiável aos requisitos da tarefa.
A DeepSeek publicou os pesos do V4 Flash 0731 no Hugging Face sob licença MIT.
Isso torna o modelo excepcionalmente permissivo em comparação com muitos lançamentos comerciais de grande porte.
Os desenvolvedores podem usar o repositório oficial do modelo com mecanismos suportados, incluindo:
O modelo é bastante grande.
O modelo principal possui 284 bilhões de parâmetros, e o checkpoint 0731 inclui adicionalmente um componente DSpark.
Executá-lo em velocidades utilizáveis exige grandes quantidades de memória e recursos de hardware.
Os pesos poderem ser baixados não significa que o modelo completo funcione sem problemas em notebooks comuns de consumidor.
Versões quantizadas da comunidade podem reduzir os requisitos de memória, mas podem alterar a precisão, a taxa de transferência, a capacidade de contexto, o comportamento do DSpark e a confiabilidade da chamada de ferramentas.
As fontes concluem que o V4 Flash não produz os melhores resultados em todas as comparações, mas é difícil de superar em termos de custo-benefício.
Este é um resumo razoável dos exemplos, mas com uma ressalva importante:
O custo-benefício depende do fluxo de trabalho completo.
O V4 Flash é especialmente atraente quando:
Em contrapartida, modelos frontier mais caros ainda podem ser mais econômicos no geral quando:
A comparação correta não é:
preço por token
mas sim:
custo por tarefa bem-sucedida e validada
Não teste apenas demonstrações cuidadosamente elaboradas.
Use tarefas compatíveis com a carga de trabalho de produção, incluindo cenários difíceis e complexos.
Mantenha consistência entre modelos em prompts, ferramentas, limites de tempo, estratégias de repetição, frameworks, sandboxes, suítes de teste e configurações de raciocínio.
Acompanhe entradas sem cache, entradas com cache, tokens de saída, chamadas de ferramentas, tentativas de repetição, tempo de execução, revisão humana e tentativas falhas.
Para código, execute testes e verifique a manutenibilidade.
Para jogos, verifique controles, colisões, desempenho e compatibilidade com navegadores.
Quando um contexto estável é reutilizado repetidamente em múltiplas etapas do agente, modelos com preços muito baixos em cache hits tornam-se mais valiosos.
Um modelo que só tem sucesso após três tentativas baratas pode ter melhor custo-benefício do que um que acerta de primeira a um preço alto.
Quando repetições são lentas ou arriscadas, o inverso também pode ocorrer.
O DeepSeek V4 Flash 0731 é a versão pós-treinada oficial do modelo V4 de mistura de especialistas de menor escala da DeepSeek. Ele substitui a versão de pré-visualização, adiciona o módulo de decodificação especulativa DSpark e foca em tarefas de codificação e agentes de uso de ferramentas.
A DeepSeek atualmente divulgou os seguintes preços regulares: US$ 0,0028 por milhão de tokens de entrada com cache, US$ 0,14 por milhão de tokens de entrada sem cache e US$ 0,28 por milhão de tokens de saída. A empresa anunciou que futuras políticas dobrarão os preços em horários de pico determinados.
Um desenvolvedor relatou que uma execução do Hermes Agent gerou um jogo de tiro em primeira pessoa jogável em 32 minutos a um custo de US$ 0,07. Isso é um estudo de caso de mídia social, não um benchmark padronizado, portanto os custos para outras tarefas podem ser maiores ou menores.
O relatório técnico do V4 lista um total de 284 bilhões de parâmetros para o modelo Flash principal, com 13 bilhões de parâmetros ativados por token. O repositório completo da versão 0731 pode exibir cerca de 304 bilhões de parâmetros, pois inclui o componente de decodificação especulativa DSpark que o acompanha.
Seu baixo custo vem da ativação esparsa de especialistas, atenção de contexto longo comprimida, precisão mista FP4/FP8, cache de prompts, decodificação especulativa e serviço de alta concorrência. Apenas uma pequena fração dos especialistas totais é ativada por token.
Com os preços atuais de API, ele é muito mais barato e demonstrou competitividade em várias demonstrações da comunidade. Opus 5 e GPT-5.6 ainda podem oferecer maior confiabilidade ou qualidade na primeira tentativa em algumas tarefas, e as comparações virais não são benchmarks controlados.
Sim. A DeepSeek publicou os pesos sob licença MIT e fornece orientação de uso com vLLM e SGLang. O modelo completo é extremamente grande, portanto uma implantação local prática requer uma quantidade substancial de memória de aceleradores ou esquemas de quantização agressivos da comunidade.
Sim. A DeepSeek afirma que a versão Flash oficial suporta nativamente a API Responses e foi adaptada para uso no Codex. A API atual do V4 Pro ainda não suporta a API Responses.
0731: repositório oficial do modelo, com pesos, benchmarks, licença e guia de implantação.
O DeepSeek V4 Flash 0731 atraiu ampla atenção porque desenvolvedores relataram que construíram demos interativas completas por apenas alguns centavos. Segundo relatos, um jogo de tiro em primeira pessoa custou apenas US$ 0,07, enquanto comparações em outras redes sociais mostraram custos de tarefas dezenas de vezes menores que o Claude Opus 5 ou o GPT-5.6.
Esses exemplos não são benchmarks controlados, mas os preços oficiais da API apoiam o ponto central. O V4 Flash cobra US$ 0,14 por milhão de tokens de entrada não armazenados em cache, US$ 0,28 por milhão de tokens de saída, e surpreendentes US$ 0,0028 para acertos de cache.
Sua economia decorre de todo o sistema: um núcleo MoE de 284B ativando 13B por token, atenção de contexto longo comprimida, pesos FP4/FP8, janela de contexto de um milhão de tokens, capacidade de serviço eficiente e decodificação especulativa DSpark. A atualização 0731 preserva a arquitetura de pré-visualização e melhora o comportamento do agente com novo pós-treinamento.
A evidência oficial mais forte está nos ganhos de benchmark. O Terminal Bench 2.1 subiu de 61,8 para 82,7, o Toolathlon-Verified de 49,7 para 70,3, mantendo o modelo no nível de preço Flash.
A vantagem do V4 Flash não é vencer todas as comparações — é seu custo marginal extremamente baixo que torna
viável na prática realizar experimentos de agente repetidamente em uma escala difícil de alcançar com muitos modelos de preço de ponta.
Comece com uma frase e tenha um site completo em minutos.



