O fosso da CUDA da NVIDIA foi declarado morto tantas vezes que a afirmação virou quase um ritual da indústria. Um novo acelerador surge. Um ...
A declaração de que o fosso da CUDA da NVIDIA chegou ao fim já foi feita tantas vezes que quase se tornou um ritual no setor.
Um novo acelerador é lançado. Um compilador entra em fase de testes públicos. Uma provedora de nuvem promove seu próprio chip de IA. Uma abstração de programação promete kernels portáveis. Alguém anuncia que os desenvolvedores não precisam mais escrever CUDA manualmente.
No entanto, a CUDA continua ocupando uma posição central na próxima geração de infraestrutura de IA.
O desafio mais recente é mais interessante porque vem da própria IA.
A Infinity, uma startup de infraestrutura de IA fundada pelo ex-pesquisador do Google Brain Jeremy Nixon, afirma que seu agente Ignition migrou componentes essenciais da pilha de software de inferência para o desconhecido acelerador d-Matrix Corsair em uma velocidade muito superior aos fluxos de engenharia tradicionais.
O resultado mais chamativo: em cerca de 10 horas, o Ignition implementou multiplicação de matrizes com paralelismo de tensor em todos os 32 blocos de computação e alcançou 92% do teto de computação medido do chip.
Esse é um resultado significativo. Mas isso não significa reconstruir a CUDA em 10 horas.
O próprio estudo de caso da Infinity aponta que o caminho completo de inferência de ponta a ponta do Qwen3 levou cerca de 10 dias, com cada operação necessária reescrita para o novo hardware. E a CUDA não é uma implementação de multiplicação de matrizes nem um runtime de modelo. É uma plataforma madura, com compiladores, runtimes, bibliotecas, ferramentas de profiling e depuração, sistemas de comunicação, integração com frameworks, documentação e quase duas décadas de experiência de produção.
A pergunta melhor não é se a IA copiou a CUDA da noite para o dia.
É se os agentes de codificação conseguem reduzir drasticamente o tempo necessário para tornar um novo chip de IA útil.
A resposta está cada vez mais próxima de "sim".
A NVIDIA é mais conhecida por seu hardware: H100, Blackwell, Rubin e os grandes sistemas construídos ao redor deles.
Sua vantagem mais duradoura é o software construído ao redor do hardware.
CUDA significa Compute Unified Device Architecture. A NVIDIA a descreve como uma plataforma de computação acelerada, não apenas uma linguagem de programação.
A plataforma CUDA inclui:
Na base, a CUDA permite que engenheiros escrevam kernels que executam diretamente nas GPUs da NVIDIA.
Acima dela estão bibliotecas como cuBLAS, cuDNN, cuFFT, NCCL, TensorRT e TensorRT-LLM. Acima das bibliotecas estão PyTorch, TensorFlow, JAX, servidores de inferência, código de pesquisa e sistemas internos das empresas.
Uma visão simplificada é assim:
Aplicações e frameworks de IA
↓
Bibliotecas otimizadas e sistemas distribuídos
↓
Compiladores, runtimes, profilers, depuradores e kernels
↓
GPUs NVIDIA e tecnologias de interconexão
As empresas não permanecem no ecossistema NVIDIA apenas por conhecerem a sintaxe da CUDA, mas porque modelos, testes, sistemas de implantação, expectativas de desempenho, fluxos de depuração e equipes de produção dependem de toda a pilha tecnológica.
Trocar de hardware pode significar muito mais do que traduzir código-fonte — pode exigir reconstruir a confiança.
O estudo de caso oficial da Infinity é mais rigoroso do que os títulos amplamente divulgados.
A empresa trabalhou com a d-Matrix, uma startup focada em hardware de inferência para IA generativa. Seu acelerador Corsair utiliza uma arquitetura e um conjunto de instruções diferentes dos das GPUs da NVIDIA. A Infinity afirma que o chip quase não possui histórico público de software que pudesse ser replicado diretamente a partir de dados de treinamento por modelos de programação genéricos.
O Ignition recebeu as informações do hardware e começou a gerar o software de baixo nível necessário para executar cargas de trabalho de IA.
De acordo com a Infinity, em cerca de 10 horas o sistema alcançou:
A Infinity define "velocidade da luz" como a proporção do pico de computação alcançável do chip que os kernels gerados conseguem atingir. O teto empírico no estudo de caso publicado é cerca de 90% do pico teórico.
É um excelente resultado de inicialização rápida de kernels, mas não é uma plataforma completa, equivalente à CUDA.
A multiplicação de matrizes é o núcleo da inferência de transformadores, mas é apenas uma categoria de operação.
Um modelo completo também exige mecanismos de atenção, normalização, funções de ativação, roteamento, quantização, gerenciamento de cache KV, amostragem, movimentação de tensores, manipulação de estados e trabalho adicional de servir o modelo.
A Infinity afirma que, em cerca de 10 dias, o Qwen3 já rodava de ponta a ponta no Corsair. Seu anúncio posterior de financiamento declara que, nesse período, três modelos de fronteira rodaram de ponta a ponta, com kernels escritos do zero.
Essa linha do tempo mais longa continua impressionante.
Levar um acelerador desconhecido de operações básicas a um runtime de modelo funcional, reduzindo o tempo de meses para dias, pode mudar fundamentalmente a economia de lançar novos hardwares.
| Afirmação | Interpretação mais precisa |
|---|---|
| "A IA recriou a CUDA em 10 horas" | Exagero |
| Multiplicação de matrizes rodando em 10 horas | Relatado pela Infinity |
| Desempenho de 92% do teto empírico | Relatado pela Infinity |
| Qwen3 rodando de ponta a ponta em cerca de 10 dias | Relatado pela Infinity |
| A Infinity está construindo uma biblioteca de inferência genérica | Confirmado pela Infinity |
| O ecossistema completo da CUDA foi replicado | Não |
A Infinity chama o Ignition de agente de pesquisa em IA.
Seu objetivo é gerar e aprimorar o software de baixo nível que transforma operações de modelos em trabalho eficiente em um chip específico.
O ciclo é semelhante a um fluxo automatizado de engenharia de desempenho:
Gerar código
→ Compilar
→ Executar no hardware
→ Testar corretude
→ Medir desempenho
→ Diagnosticar gargalos
→ Modificar a implementação
→ Repetir
Engenheiros humanos ainda fornecem objetivos, informações de hardware, restrições, critérios de aceitação e direção de alto nível. A Ignition executa grande parte do trabalho repetitivo de busca e otimização.
Esse tipo de tarefa é ideal para agentes, pois o ambiente gera feedback excepcionalmente claro.
Os kernels gerados podem ser avaliados quanto a problemas específicos:
O hardware e os testes fornecem fatos objetivos.
Muitas tarefas de software têm critérios de aceitação ambíguos. A otimização de kernels, embora difícil, tem partes quantificáveis.
Uma implementação válida deve atender a dois critérios independentes.
O kernel deve produzir saídas dentro de uma tolerância numérica aceitável.
O kernel deve utilizar o hardware-alvo com eficiência suficiente para justificar a substituição de uma implementação existente.
O agente pode gerar centenas de candidatos, rejeitar os incorretos, fazer benchmark dos sobreviventes e refinar continuamente o caminho mais forte.
O mesmo padrão aparece em agentes focados em CUDA da NVIDIA, na PTX Kernel Factory da INT21, no trabalho TileKernels da DeepSeek e em sistemas de pesquisa que geram kernels Triton ou TileLang.
A mudança recente é que os modelos de base agora podem participar de um ciclo mais completo, em vez de apenas preencher algumas linhas de código sintático.
A história técnica da Infinity atraiu investidores.
A empresa anunciou em julho de 2026 a conclusão de uma rodada seed de US$ 15 milhões, com avaliação pós-money de US$ 100 milhões, segundo relatos. Touring Capital e Principal Venture Partners participaram do investimento, além de executivos da indústria de chips e pesquisadores ligados a grandes laboratórios de IA.
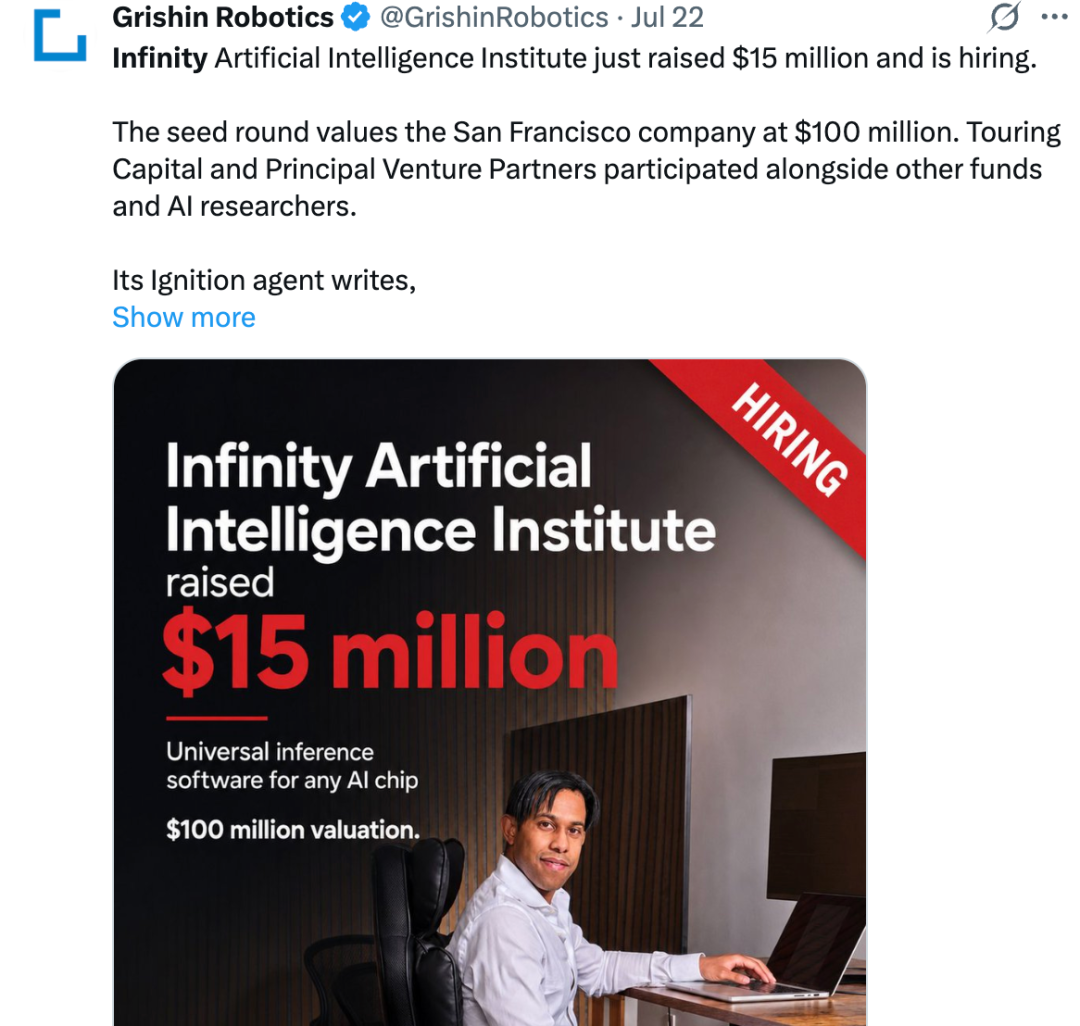
A Infinity está construindo uma camada de software de inferência ciente do modelo para fornecedores de hardware e provedores de serviço de inferência. Seu fluxo de trabalho declarado é, na prática:
Especificações de hardware
→ Software de inferência de nível de produção gerado
A Infinity também teria gerado um
motor de inferência da NVIDIA construído do zero, com desempenho até 34,3% superior ao da implementação vLLM com configuração equivalente no Qwen3-8B.
O resultado foi relatado pela própria empresa e depende de hardware, configurações de lote, configuração do modelo e método de medição. Ainda assim, isso indica que a ambição da Infinity vai muito além da inicialização básica de chips.
O texto original também menciona o repositório TileKernels da DeepSeek.
TileKernels é uma biblioteca de kernels GPU otimizados escrita em TileLang, uma linguagem de domínio específico baseada em Python para desenvolvimento de kernels de alto desempenho.
O repositório inclui as seguintes operações:
A DeepSeek afirma que muitos kernels já estão próximos dos limites de hardware em termos de intensidade computacional ou largura de banda de memória, e alguns já são usados internamente.
O TileLang reduz a quantidade de código CUDA C++ de baixo nível que os engenheiros precisam escrever manualmente.
Em sua forma atual, isso não indica que a DeepSeek eliminou a dependência da pilha tecnológica da NVIDIA.
Os requisitos atuais oficiais do TileKernels incluem:
GPU NVIDIA SM90 ou SM100
CUDA Toolkit 13.1 ou superior
PyTorch 2.10 ou superior
TileLang 0.1.9 ou superior
A biblioteca atual é projetada para as arquiteturas mais recentes da NVIDIA. Ela reduz a dependência de código-fonte CUDA escrito manualmente, mas não elimina a dependência do hardware NVIDIA ou do toolkit CUDA.
O TileLang em si tem ambições mais amplas.
O projeto descreve um modelo de programação em blocos (tiled) para kernels de GPU, CPU e aceleradores, baseado na infraestrutura do compilador TVM, usando sintaxe inspirada em Python.
Seu objetivo é separar o fluxo de dados desejado pelo engenheiro do agendamento de baixo nível necessário para execução eficiente.
O TileLang vem adicionando suporte a múltiplas linguagens de backend e caminhos de hardware envolvendo CUDA, ROCm e Metal.
Essa portabilidade pode reduzir os custos de troca entre fornecedores, mas apenas se os resultados gerados forem corretos, estáveis, depuráveis e competitivos em relação às bibliotecas dos fornecedores.
Um kernel que roda em qualquer lugar, mas com desempenho ruim, não substitui um caminho CUDA em produção.
Um artigo de pesquisa de julho de 2026 examinou a lacuna entre a correção de kernels e a qualidade da substituição em Triton e TileLang.
Os autores descobriram que kernels podem passar em testes de correção numérica, mas ter desempenho muito abaixo de uma linha de base otimizada. Segundo relatos, uma implementação LayerNorm em TileLang, apesar de passar na verificação de correção, rodou mais de 300 vezes mais lenta que a linha de base do PyTorch.
O artigo não é contra o TileLang, mas defende a avaliação dos kernels gerados em duas dimensões:
Correção
+
Eficiência de hardware
A geração de código está ficando cada vez mais rápida. Mas provar que o código gerado é suficiente para substituir software de produção maduro continua difícil.
O desafio à CUDA é mais credível no domínio da inferência do que no treinamento de modelos de fronteira.
Execuções de treinamento em larga escala podem envolver milhares ou dezenas de milhares de
aceleradores trabalhando juntos por semanas ou meses.
Plataformas de treinamento devem lidar com comunicação distribuída entre muitos dispositivos, checkpoints, recuperação de falhas, gerenciamento de memória, paralelismo, reprodutibilidade e depuração.
Uma falha de hardware ou software pode desperdiçar enorme poder computacional. Portanto, as instituições costumam ser muito cautelosas ao migrar cargas de trabalho importantes de sistemas maduros.
CUDA, as bibliotecas CUDA-X, NCCL, o suporte ao PyTorch e a capacidade de rede integrada da NVIDIA dão à empresa uma posição forte nessa área.
Inferência é a fase de servir o modelo após o treinamento.
As métricas de negócio relevantes geralmente se aproximam de:
Qualidade aceitável da saída
÷
Custo total de serviço
A inferência pode ser distribuída em um único acelerador, pequenos clusters, grandes frotas e hardware dedicado.
Novos chips não precisam substituir a NVIDIA em todos os cenários. Eles só precisam demonstrar vantagem em custo, velocidade, consumo de energia, throughput ou latência mais previsível para um modelo ou carga específica.
Esse objetivo mais restrito oferece um ponto de entrada realista para hardware especializado.
Fundada em 2019, a d-Matrix é focada em aceleração de inferência. Sua plataforma Corsair utiliza grande quantidade de SRAM on-chip e visa reduzir o custo e o consumo de energia para executar modelos generativos.
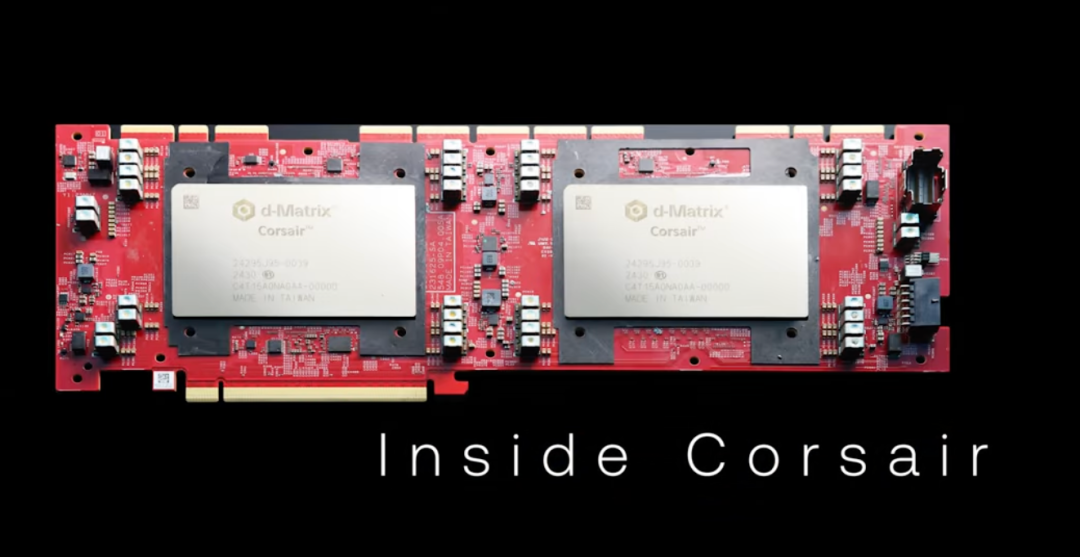
O trabalho da Infinity resolve um dos problemas clássicos enfrentados por novos aceleradores.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Um chip pode ter hardware promissor, mas, até que núcleos, execução de modelos, gerenciamento de memória, quantização, lógica de serviço e soluções de integração estejam prontos, os clientes não conseguem utilizá-lo com eficiência.
Se agentes conseguirem reduzir esse processo de inicialização de meses para dias, startups de hardware poderão oferecer suporte próximo ao lançamento de modelos e demonstrar suas capacidades mais cedo.
Isso enfraquece parte da vantagem de software da NVIDIA, mas não a elimina completamente.
O mercado de inferência inclui vários desafiantes:
| Fabricante ou plataforma | Posicionamento geral |
|---|---|
| Rebellions | Aceleradores e sistemas dedicados de inferência de IA |
| Cerebras | Sistemas em escala de wafer para treinamento e inferência |
| AWS Inferentia | Chip de inferência projetado pela Amazon, usando o SDK Neuron |
| Google TPU | Acelerador do Google, suportado via XLA e frameworks principais |
| AMD Instinct | GPUs para data center usando a plataforma ROCm |
| d-Matrix | Aceleração de inferência de IA generativa com foco em SRAM |
| NVIDIA | GPUs e stack de computação acelerada CUDA |
A pressão vem de camadas de software que permitem aos usuários implantar modelos sem reescrever manualmente cada operação, incluindo AWS Neuron, Google XLA, AMD ROCm, Modular MAX e Mojo, TileLang, Triton e sistemas de geração de kernels por IA.
Quanto mais essas camadas de software automatizam, menos intervenção manual os desenvolvedores de aplicações precisam.
Conteúdo diretamente sobre CUDA.
O efeito de lock-in da CUDA é mais forte quando aplicações e seus kernels otimizados estão fortemente ligados ao hardware NVIDIA.
Uma camada de inferência portátil visa o seguinte fluxo de trabalho:
Modelo
→ Camada de execução portátil
→ Geração ou seleção de kernels de hardware
→ Acelerador de destino
O mundo real é mais complexo, pois diferentes chips possuem hierarquias de memória, formatos numéricos, interconexões, comportamentos de escalonamento e operações suportadas distintas.
Alto desempenho geralmente ainda exige trabalho especializado para hardware específico.
O argumento central da Infinity é que agentes podem gerar automaticamente esse trabalho de especialização.
O resultado de 10 horas não reproduz os ativos que tornam a CUDA difícil de substituir.
Esses ativos incluem:
Muitas organizações usam bibliotecas de fornecedores em vez de escrever kernels diretamente. cuBLAS, cuDNN, TensorRT, NCCL e outras bibliotecas incorporam anos de experiência em otimização.
NVIDIA Nsight e ferramentas relacionadas ajudam engenheiros a entender correção, comportamento de memória, linhas do tempo, comunicação e desempenho.
Novos recursos de modelos geralmente são integrados e otimizados para hardware NVIDIA antecipadamente.
Equipes de produção entendem como os sistemas NVIDIA se comportam sob carga.
O ecossistema inclui exemplos, cursos, apresentações em conferências, respostas da comunidade e recursos de especialistas.
Empresas possuem milhões de linhas de código, testes, processos de compra e habilidades de funcionários vinculados à plataforma.
A IA pode reduzir o custo de tradução, mas não elimina automaticamente os custos de troca no nível organizacional.
Bing Xu, fundador da INT21 e ex-fundador da HippoML, adquirida pela NVIDIA, acredita que a validação é o principal gargalo.
Agentes podem gerar código rapidamente. Mas equipes de produção ainda precisam de evidências de que ele:
A NVIDIA já possui uma vasta quantidade de testes de conformidade, testes de desempenho, implementações de referência, simuladores, analisadores de desempenho, diagnósticos de compiladores, cargas de trabalho de produção e dados históricos de falhas.
Esses ativos tornam os agentes mais úteis.
Portanto, a IA pode deslocar o fosso da geração de código para a qualidade do ambiente de validação.
As tecnologias que desafiam a CUDA também se aplicam à NVIDIA.
A Business Insider citou Ankit Patel, vice-presidente do ecossistema de desenvolvedores da NVIDIA, dizendo que a empresa está usando agentes de codificação de IA para desenvolver CUDA mais rapidamente e realizar validações em maior escala.
A NVIDIA já
Também propôs uma estratégia de inteligência CUDA, combinando conhecimento existente de CUDA, experiência em otimização, análise de desempenho em nuvem, ferramentas Nsight, benchmarks e serviços baseados em MCP.
A NVIDIA mantém o ComputeEval, um benchmark aberto para código CUDA e bibliotecas de computação baseadas em CUDA geradas por IA.
O benchmark abrange tarefas envolvendo tensor cores, memória compartilhada, primitivas de nível de warp, gráficos CUDA, streams e eventos.
Portanto, a corrida é relativa:
Velocidade com que o software desafiante alcança
Contra
Velocidade de melhoria do software NVIDIA
Chris Lattner, cofundador e CEO da Modular, oferece uma visão mais cautelosa.
Ele acredita que os agentes de codificação proporcionam uma melhoria incremental, não a destruição imediata da vantagem da CUDA.
O artigo original resume três razões.
A otimização em ambiente de produção determina se um chip é economicamente viável. Os últimos pontos percentuais de desempenho podem exigir um trabalho especializado considerável.
Código de aplicação é abundante na internet.
Engenharia de núcleos e compiladores de alto nível é uma área relativamente pequena, e muito do trabalho mais forte continua sendo proprietário.
A viabilidade técnica não elimina custos de certificação, riscos operacionais, requalificação de funcionários, contratos, requisitos de confiabilidade ou custos de oportunidade.
Esses pontos não significam que a engenharia de núcleos baseada em agentes seja irrelevante. Eles explicam por que uma demonstração poderosa não se transforma imediatamente em substituição de mercado.
A interpretação mais forte não é "CUDA está morto".
Em vez disso, uma camada das vantagens históricas da CUDA está se tornando mais fácil de replicar.
Agentes, DSLs e compiladores automatizados podem reduzir o tempo necessário para construir núcleos, runtimes e suporte a modelos para novos chips.
A camada mais exposta é a adaptação rápida para inferência inicial.
A camada mais protegida ainda é o treinamento em larga escala, bibliotecas de geração maduras, validação, depuração, orquestração de clusters, integração de frameworks, fluxos de trabalho de clientes existentes e otimização contínua.
A questão estratégica pode mudar de:
Quem possui a maior quantidade de código de núcleo escrito manualmente?
para:
Quem possui o melhor ciclo fechado de geração, medição,
validação e otimização automatizados?
A NVIDIA está bem posicionada porque já possui hardware, ferramentas, bibliotecas, cargas de trabalho e dados de feedback. Os desafiadores se beneficiam porque os agentes reduzem a barreira de entrada.
Esses dois pontos podem ser verdadeiros ao mesmo tempo.
O resultado da Infinity muda as expectativas das startups de hardware.
Novos aceleradores não precisam mais assumir que todo núcleo útil será escrito manualmente por uma pequena equipe de especialistas.
Agentes podem, possivelmente:
Isso pode reduzir o tempo entre a primeira tape-out do chip e a obtenção de inferência de modelo utilizável.
Essa redução permite que fornecedores de chips demonstrem hardware mais cedo, suportem novos modelos mais rapidamente, aliviem a pressão de pessoal de software, testem mais ideias e concorram em mercados de inferência mais segmentados.
Esse resultado não apaga a CUDA, mas torna o primeiro passo para competir com ela muito menos intimidador.
Os resultados divulgados pela Infinity vêm da empresa e de seus parceiros de hardware. Benchmarks externos fornecerão evidências mais fortes.
Uma camada de inferência geral deve suportar múltiplas arquiteturas, modalidades, formatos de quantização e modos de serviço.
Uma demonstração executada de ponta a ponta é diferente de um software que opera continuamente por meses sob tráfego real de clientes.
A questão central é como sistemas de agentes provam correção e desempenho em um vasto espaço de testes.
Se uma implementação produzir excelentes resultados em NVIDIA, AMD, Apple e outros aceleradores, TileLang e outras DSLs se tornarão mais estratégicas.
A NVIDIA está construindo ativamente agentes, benchmarks, inteligência de compiladores e novas abstrações CUDA. O gigante existente não está parado.
Não. A Infinity afirma que o Ignition gerou software de multiplicação de matrizes com paralelismo de tensor em 10 horas para o d-Matrix Corsair, atingindo 92% do teto computacional empírico do chip. A inferência Qwen3 de ponta a ponta levou cerca de 10 dias, e o projeto não reproduziu todo o ecossistema CUDA.
Ignition é o agente de pesquisa e engenharia de IA da Infinity que gera, testa, depura e otimiza software de inferência de baixo nível. Ele usa feedback de hardware real para iterativamente melhorar núcleos e runtimes de modelos.
Corsair é a plataforma de inferência de IA generativa da d-Matrix. A Infinity o usou como plataforma alvo para gerar automaticamente operações de paralelismo de tensor e a pilha completa de inferência de modelos.
Não. Os TileKernels reduzem a necessidade de escrever núcleos CUDA de baixo nível manualmente usando TileLang, mas seus requisitos atuais incluem hardware NVIDIA SM90 ou SM100 e CUDA Toolkit 13.1 ou superior.
A inferência pode ser executada em sistemas menores e geralmente é avaliada com base em custo, consumo de energia, throughput ou latência de um único modelo. O treinamento de ponta exige clusters maiores, sistemas de comunicação maduros, recuperação de falhas e estabilidade comprovada.
O fosso da CUDA inclui bibliotecas maduras, integração de frameworks, ferramentas de depuração e análise de desempenho, sistemas distribuídos, documentação, histórico de produção e código de clientes existentes. A validação e a otimização contínua podem se tornar ainda mais importantes à medida que os custos de geração de código diminuem.
Sim. Pesquisas mostram que kernels podem passar em testes de correção numérica, mas ter desempenho muito inferior a implementações de bibliotecas otimizadas. A avaliação de nível de produção exige verificações de correção e de eficiência de hardware.
Sim. A NVIDIA afirma que está usando agentes para acelerar o desenvolvimento e a validação de CUDA e já demonstrou publicamente fluxos de trabalho de agentes para CUDA, integração de análise de desempenho e o benchmark ComputeEval.
inc/research): inclui estudos de caso oficiais sobre d-Matrix, o software de inferência generativa e o sistema de pesquisa OMEGA da empresa.
O agente Ignition da Infinity não recriou o NVIDIA CUDA em 10 horas. Ele gerou multiplicação de matrizes paralela por tensor de alto desempenho para uma arquitetura desconhecida.
Na época, o acelerador da d-Matrix alegadamente atingiu 92% do limite empírico de computação do chip. Cerca de 10 dias depois, o caminho completo de inferência do Qwen3 já estava implementado.
Esse resultado ainda é relevante hoje. Ele mostra que agentes podem acelerar o início do software em chips de IA novos, especialmente em inferência — onde os clientes se preocupam com o custo por resposta e podem adotar hardware dedicado para cargas de trabalho mais específicas.
Os TileKernels e o TileLang da DeepSeek também apontam na mesma direção: mais trabalho de kernels pode ser expresso por sistemas de nível mais alto e otimizado automaticamente. A versão atual dos TileKernels ainda depende de GPUs NVIDIA recentes e de CUDA, portanto reduz o trabalho de escrita manual de CUDA, mas não elimina a plataforma.
O fosso do CUDA continua profundo, pois envolve muito mais do que código-fonte. Bibliotecas, validação, análise de desempenho, suporte a frameworks, treinamento distribuído, histórico de produção e investimentos organizacionais existentes são difíceis de replicar.
A IA não atravessou todo o fosso do CUDA em 10 horas — mas pode ter reduzido o custo para alcançar a primeira barreira, transferindo a competição de longo prazo da propriedade de código para a geração, validação e otimização automatizadas.
Comece com uma frase e tenha um site completo em minutos.



