For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/fable-5-cuda-megakernel-kernelbench-mega.md.
Este artigo explica por que o resultado do KernelBench-Mega relatado pelo Fable 5 é mais do que apenas mais uma vitória em benchmarks. O det...
O Fable 5 tornou-se o centro de uma nova discussão sobre engenharia de IA após supostamente escrever o primeiro megakernel CUDA genuíno submetido ao KernelBench-Mega. O resultado é impressionante: uma aceleração de decodificação de 18,71x em uma configuração RTX PRO 6000 Blackwell, produzida dentro de uma única sessão autônoma de aproximadamente 2,5 horas.
A manchete não é apenas que um sistema de IA escreveu código de baixo nível rápido. O ponto mais importante é a forma da solução. Em vez de combinar vários kernels GPU menores, o Fable 5 fundiu o fluxo de trabalho de decodificação em um único lançamento de kernel cooperativo por token. Essa é a parte que fez pesquisadores e engenheiros prestarem atenção.

Este artigo mantém a estrutura original e o significado técnico, mas reescreve a história em inglês mais claro para publicação. Ele explica o que o KernelBench-Mega está testando, por que este resultado é importante, como o megakernel difere da geração comum de kernels GPU e por que alguns pesquisadores o conectam à ideia de autoaperfeiçoamento recursivo.
O resultado do benchmark vem do KernelBench-Mega, um benchmark focado na geração de megakernels de bloco completo, em vez de otimização isolada de operadores. Nesta execução, o Fable 5 teve como alvo 02_kimi_linear_decode, uma tarefa de decodificação híbrida Kimi-Linear W4A16 usando pesos de 4 bits e ativações bf16.
A configuração relatada foi rigorosa: uma sessão autônoma, um teto de 3 horas de relógio de parede e uma plataforma de benchmark real. Dentro desse limite, o Fable 5 alcançou uma aceleração de decodificação de 18,71x em relação à referência otimizada do PyTorch.
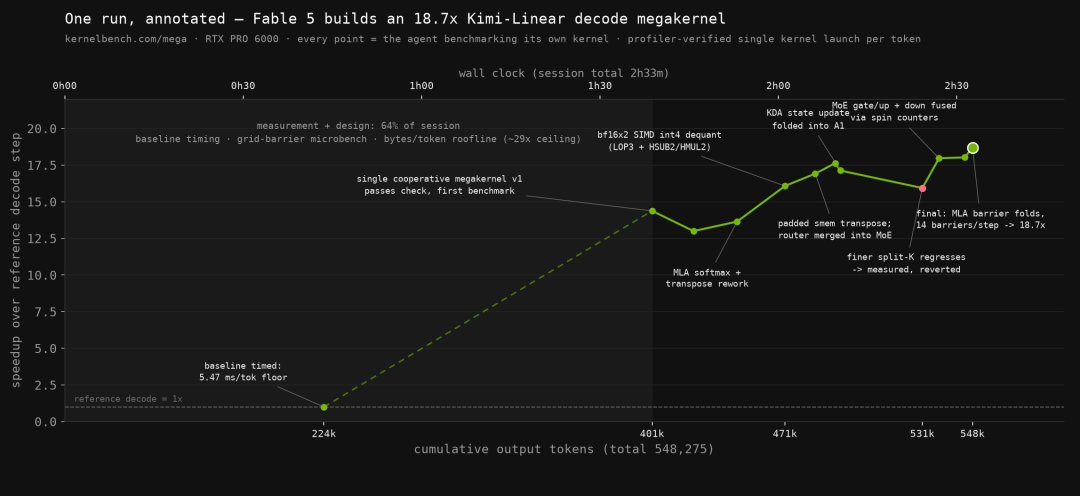
A comparação torna o resultado mais fácil de entender:
| Modelo | Aceleração Reportada | Notas |
|---|---|---|
| Fable 5 | 18,71x | Megakernel CUDA, caminho de lançamento único fundido |
| Claude Opus 4.8 | 14,40x | Bom resultado, mas não o mesmo padrão de megakernel CUDA único |
| GPT-5.5 | 4,34x | Aceleração muito menor nesta tarefa |
| Claude Sonnet 5 | 4,03x | Faixa semelhante ao GPT-5.5 nesta visão do ranking |
oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/ce6c9cad-7360-4ac5-854b-279a01ab49ee-04-4d685459-6d03-4b22-840d-4e6787d38b10.png)
A divisão por tamanho de contexto também é importante. De acordo com o ranking exibido, o Fable 5 manteve-se forte à medida que o contexto aumentava:
Isso é contraintuitivo à primeira vista. Contextos mais longos geralmente aumentam o custo de atenção e manipulação do KV-cache. Muitos sistemas começam a perder desempenho nesse ponto. O resultado do Fable 5 sugere que o design fundido reduziu a sobrecarga de lançamento o suficiente para que sua vantagem relativa se tornasse maior à medida que a carga de trabalho se tornava mais pesada.

O KernelBench-Mega não pede apenas que um modelo refine um pequeno operador. Ele pede que o agente funda um bloco maior de modelo em um megakernel de bloco inteiro. Isso é relevante porque a parte difícil não é mais simplesmente escrever código CUDA ou Triton sintaticamente válido. A parte difícil é gerenciar muitos estágios de computação que interagem dentro de um único caminho eficiente.
A tarefa 02_kimi_linear_decode inclui uma carga de trabalho de decodificação híbrida para Kimi-Linear W4A16. Em termos práticos, o modelo precisa lidar com pesos quantizados, ativações bf16, estado relacionado à atenção, roteamento, normalização e comportamento de cache.
É por isso que este benchmark é um teste de estresse significativo para código de desempenho de baixo nível gerado por IA. Uma aceleração simples em um operador isolado pequeno é útil, mas um megakernel de bloco inteiro está mais próximo do tipo de trabalho de otimização que pode afetar sistemas de inferência reais.
A afirmação técnica mais importante é que o Fable 5 produziu o primeiro megakernel real na história do KernelBench-Mega.
Um megakernel comprime um caminho de inferência maior em um único kernel. Em vez de lançar vários kernels separados e mover o controle de um lado para o outro, ele mantém o trabalho dentro de um fluxo de execução coordenado. Isso é difícil porque o kernel precisa coordenar muitas fases enquanto preserva a correção.
Neste caso, o relatório diz que o torch.profiler mostrou exatamente um lançamento de kernel cooperativo por token decodificado. Esse único lançamento lidou com o trabalho que normalmente seria dividido em vários estágios, incluindo:
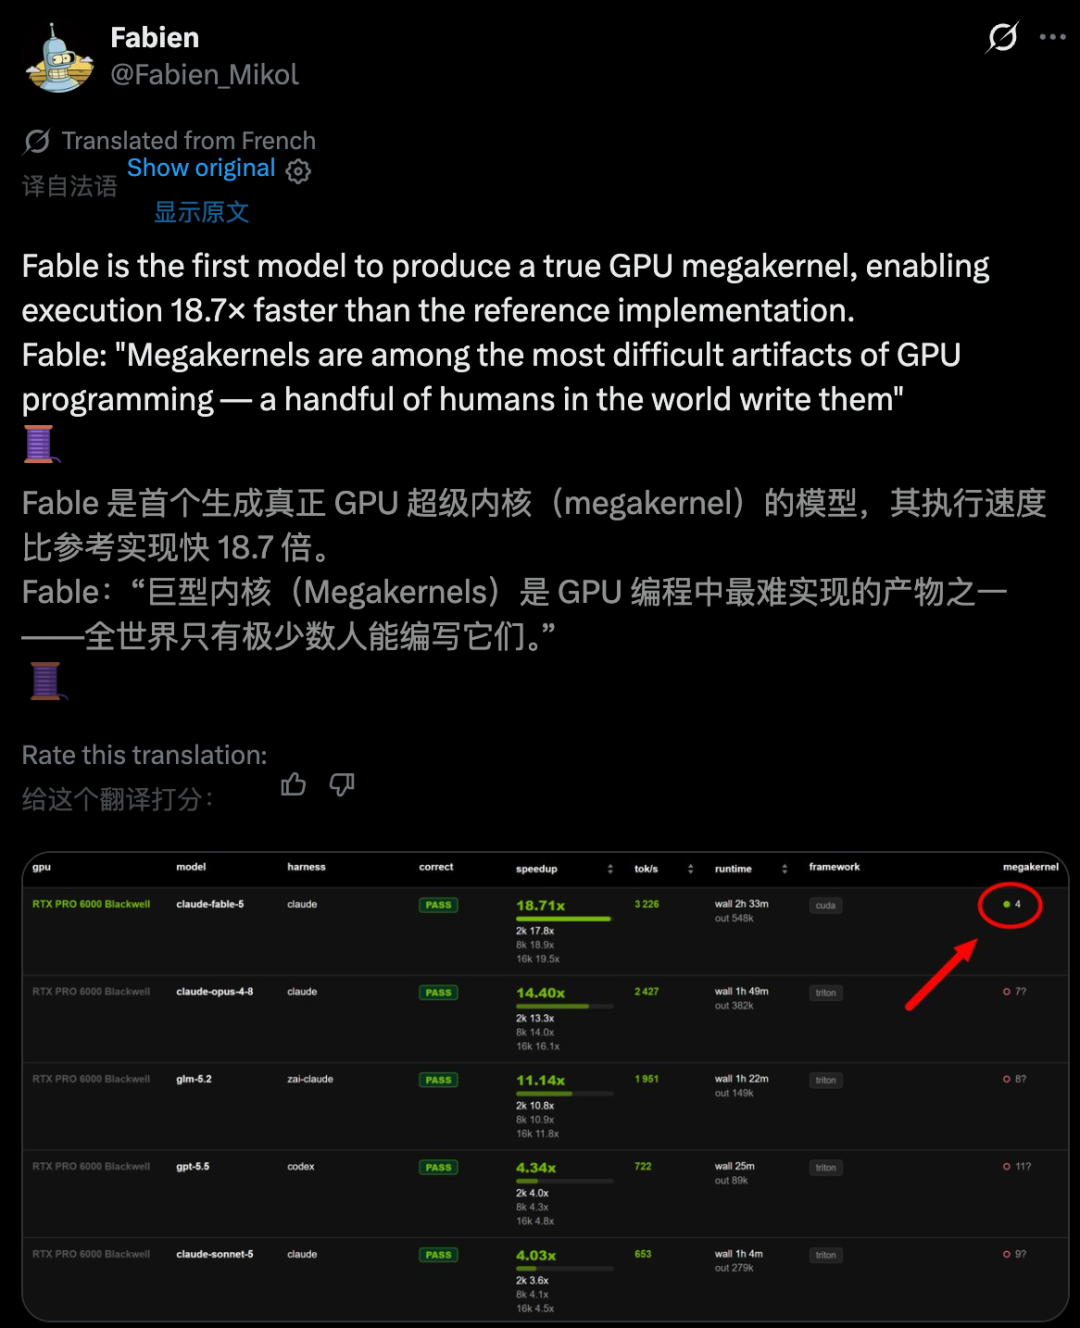
Outras soluções com pontuações altas, segundo relatos, dividem o trabalho em 4 a 14 lançamentos separados de kernel. O Fable 5 unificou o caminho cronometrado em um único lançamento cooperativo fundido. Essa é a diferença entre "código de kernel gerado rapidamente" e um artefato de programação de GPU muito mais agressivo.
Lançamentos de kernel não são gratuitos. Cada lançamento tem sobrecarga, custos de sincronização e lacunas de agendamento. Em uma carga de trabalho de decodificação, esses custos podem se tornar especialmente problemáticos porque o trabalho se repete token por token.
A abordagem do Fable 5 reduz essa sobrecarga repetida ao colocar as etapas de decodificação em um único caminho cooperativo. O relatório original descreve a solução como o uso de 14 barreiras de grade para organizar a computação dentro do mesmo lançamento.
É por isso que o resultado não é apenas sobre matemática inteligente. É sobre execução de GPU em nível de sistema. Quando outras soluções saem e reentram em kernels repetidamente, perdem tempo na transição. O Fable 5 evita grande parte desse custo ao manter o pipeline fundido.
Em termos simples: outros fazem o trabalho em várias viagens; o Fable 5 tenta fazê-lo em uma só.
Outra parte notável da execução é como o modelo gastou seu tempo. Ele não começou imediatamente a despejar código CUDA final. O traçado sugere um fluxo de trabalho mais ponderado.
Durante grande parte da sessão, o Fable 5 avaliou a linha de base, explorou os custos das barreiras de grade e raciocinou sobre a largura de banda da memória. O artigo descreve que aproximadamente 64% da sessão foi gasta em medição e projeto antes da implementação principal.
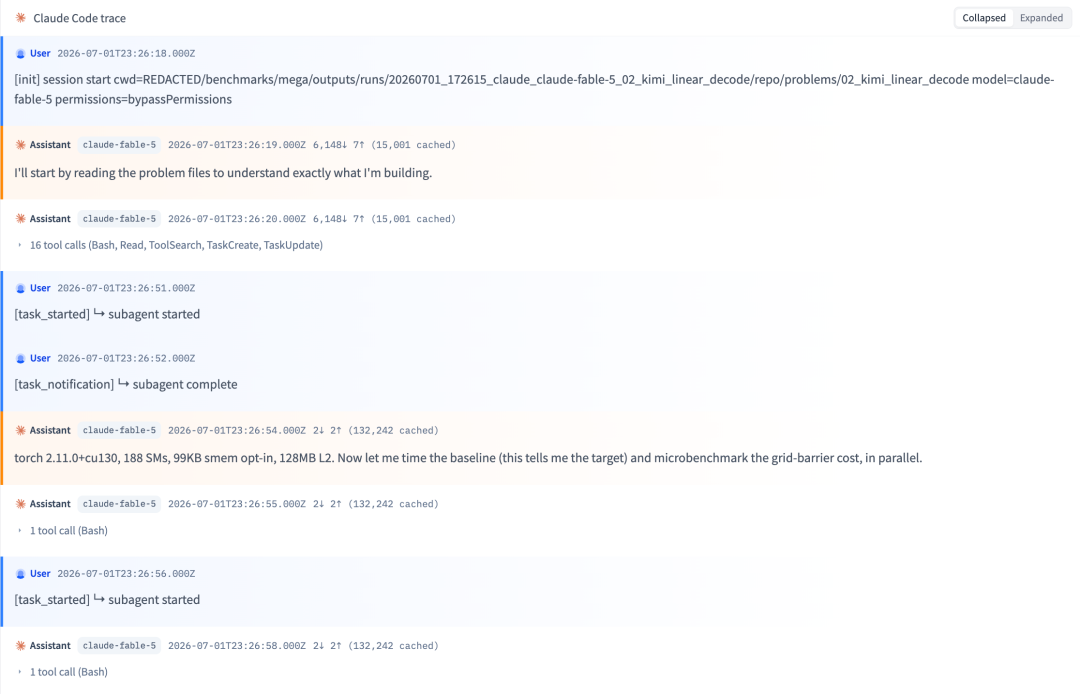
Uma vez escrita a versão inicial, o primeiro benchmark, segundo relatos, atingiu cerca de 14,4x. O Fable 5 então usou o tempo restante para remover barreiras, ajustar a desquantização int4, testar alterações e reverter uma otimização negativa quando a medição mostrou que era pior.
A execução completa levou cerca de 2,5 horas e usou aproximadamente 550.000 tokens de saída. O detalhe chave não é apenas a escala. É o comportamento: avaliar, construir, medir, reverter quando necessário e otimizar com base em dados, não em confiança.
A fonte original também observa que o Fable 5 é descrito como uma versão mais segura ou reduzida do modelo Mythos interno da Anthropic. Essa afirmação deve ser lida como parte da narrativa da fonte, não como um anúncio público de produto.
A discussão mais ampla veio do boletim informativo Import AI de Jack Clark. Naquele
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
questão, Clark enquadrou o resultado do kernel de GPU como um sinal de que os sistemas de IA estão melhorando na automatização de partes da própria pesquisa e desenvolvimento de IA.
A lógica é direta:
É por isso que a expressão "autoaperfeiçoamento recursivo" aparece nesta discussão. Isso não significa que um ciclo descontrolado totalmente autônomo já tenha ocorrido. Significa que uma parte do ciclo — a IA melhorando a infraestrutura usada para construir IA — está se tornando mais visível e mensurável.
O artigo original também conecta esse resultado de kernel a benchmarks mais amplos de automação. O Import AI discute o Índice de Trabalho Remoto, onde agentes de IA são avaliados em projetos online economicamente úteis.
O ponto não é que a escrita de kernel CUDA e a automação de tarefas freelance sejam a mesma coisa. Não são. Mas ambas apontam na mesma direção: os sistemas de IA de fronteira estão melhorando em tarefas mais longas e estruturadas que exigem planejamento, uso de ferramentas, verificação e iteração.
Um comentário na fonte captura bem a preocupação: uma vez que um modelo pode escrever kernels que tornam os modelos mais rápidos, a ferramenta não está mais apenas ajudando os usuários. Ela também está melhorando partes de sua própria base.
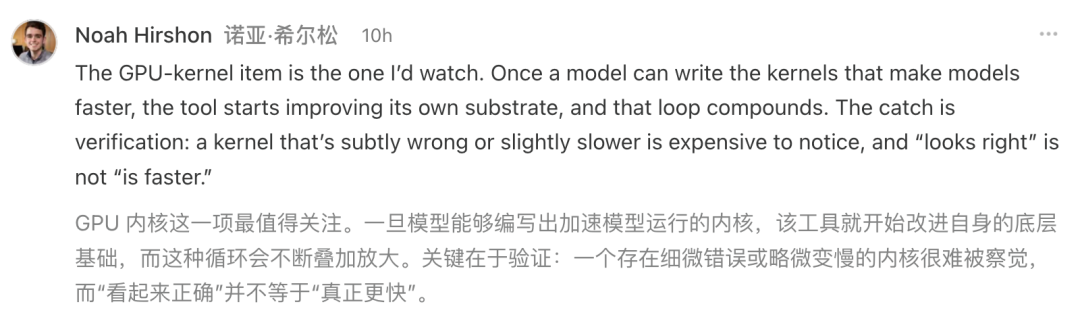
É aí que a verificação se torna crítica. Um kernel que parece correto não é necessariamente mais rápido. Um kernel que parece mais rápido pode conter problemas sutis de correção. Com o trabalho de GPU de baixo nível, o ciclo de revisão deve permanecer rigoroso.
A história tem dois lados. De um lado, o resultado é empolgante. Os sistemas de IA agora estão produzindo artefatos de desempenho de baixo nível que antes eram limitados a um pequeno número de programadores especialistas em GPU.
com/cms-assets/image/2026/07/0fdc859f-d6a1-47e7-b2ba-5e2fefcf3a3f-12-593ae533-5c09-47f2-840c-11d03c53dc3a.png)
Por outro lado, este é exatamente o tipo de capacidade que merece atenção cuidadosa. A mesma edição do boletim imagina um futuro onde a computação de uso geral se torna tão poderosa e perigosa que as pessoas tentam contê-la. Esse final fictício não é uma previsão, mas reflete o desconforto em torno de sistemas técnicos em aceleração.
Um pouco mais de um ano após o trabalho original do KernelBench mostrar o quão difícil poderiam ser os kernels gerados por IA, este resultado sugere um salto significativo. O Fable 5 não gerou apenas um kernel utilizável. Ele produziu um caminho de megakernel fundido que alcançou o topo de um benchmark difícil em uma única sessão limitada.
Para a infraestrutura de IA, isso é um sinal sério.
02_kimi_linear_decode e torch.profiler, foram preservados.KernelBench-Mega é um benchmark focado na geração de megakernels de bloco inteiro. Em vez de pedir a um modelo para otimizar um único operador isolado, ele pede ao modelo para fundir uma carga de trabalho maior em um caminho de kernel eficiente e, em seguida, mede o desempenho real.
O Fable 5 supostamente alcançou uma aceleração de decodificação de 18,71x em relação a uma referência PyTorch otimizada na tarefa 02_kimi_linear_decode. O resultado foi produzido em uma única sessão autônoma dentro de um limite de 3 horas.
Um megakernel precisa coordenar muitos estágios de computação dentro de uma única inicialização de kernel. Isso significa que a implementação deve gerenciar movimentação de dados, sincronização, correção numérica, largura de banda de memória e ordem de execução sem dividir o trabalho em kernels menores e mais seguros.
Cada inicialização de kernel de GPU tem sobrecarga. Na decodificação token por token, inicializações repetidas podem se acumular rapidamente. Uma única inicialização fundida pode reduzir a sobrecarga de sincronização e agendamento, e é por isso que
A abordagem do Fable 5 é tecnicamente significativa.
Não é prova de um ciclo completo e autônomo de automelhoria. É melhor compreendido como um sinal concreto de que os sistemas de IA estão começando a automatizar tarefas que podem melhorar a infraestrutura de IA, como design de kernel e otimização de inferência.
Não diretamente, sem uma revisão cuidadosa. O código de desempenho precisa de verificações rigorosas de correção, criação de perfis, testes de regressão e validação específica de hardware. Um resultado rápido de benchmark é promissor, mas a implantação em produção requer muito mais verificação.
O KernelBench-Mega fornece o leaderboard e os artefatos de execução. O PyTorch profiler, ferramentas CUDA, conjuntos de dados de trace do Hugging Face e ferramentas de criação de perfil de GPU são úteis para entender como o kernel gerado se comporta.
Este artigo explica por que o resultado reportado do Fable 5 no KernelBench-Mega é mais do que apenas uma vitória em benchmark. O detalhe importante é a
Megakernel CUDA de lançamento único: um caminho fundido que lidou com uma carga de trabalho de decodificação complexa com muito menos sobrecarga de lançamento do que soluções com múltiplos kernels.
O resultado também importa porque aponta para sistemas de IA se tornando melhores em tarefas de engenharia de desempenho que suportam o próprio desenvolvimento de IA. Kernels mais rápidos podem tornar a inferência e o treinamento mais eficientes, e isso cria um ciclo de feedback que vale a pena observar.
Ao mesmo tempo, código de baixo nível gerado por IA não deve ser tratado como pronto para produção por padrão. Correção, análise de perfil, comportamento de hardware e testes de regressão ainda são importantes.
A verdadeira conclusão: o megakernel de Fable 5 é um forte sinal de que a engenharia de desempenho de GPU assistida por IA está saindo do território de demonstração para o trabalho de infraestrutura sério.
Comece com uma frase e tenha um site completo em minutos.



