For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/flux-3-image-klein-specs-gpu-memory-api-a-c62c858a.md.
A Black Forest Labs lançou o **FLUX 3 Image Klein** em 15 de outubro como um modelo de pesos abertos para gerar e editar imagens. Um único m...
A Black Forest Labs lançou o FLUX 3 Image Klein em 15 de outubro como um modelo de pesos abertos para gerar e editar imagens. Um único modelo processa pedidos de texto para imagem, edições com base numa referência e composições com múltiplas referências.
O seu gerador de imagens contém 5,6 mil milhões de parâmetros. Esse número exclui o codificador de texto separado, um detalhe importante ao comparar dimensões de modelos ou planear hardware local. A BFL oferece tanto um checkpoint base para adaptação como um checkpoint destilado para geração mais rápida, além do acesso através da sua API.
O lançamento combina um gerador menor com suporte para até dez imagens de referência, geração nativa em 4K e orientação por caixas delimitadoras. As decisões de implementação continuam a depender do checkpoint, da precisão, da implementação de inferência e dos termos de licenciamento.
O modelo aceita um prompt e até dez imagens de referência, devolvendo uma imagem. As entradas de referência podem ajudar a fixar um sujeito ou a combinar material de várias fontes, enquanto a descrição escrita controla a cena e a composição pretendidas.
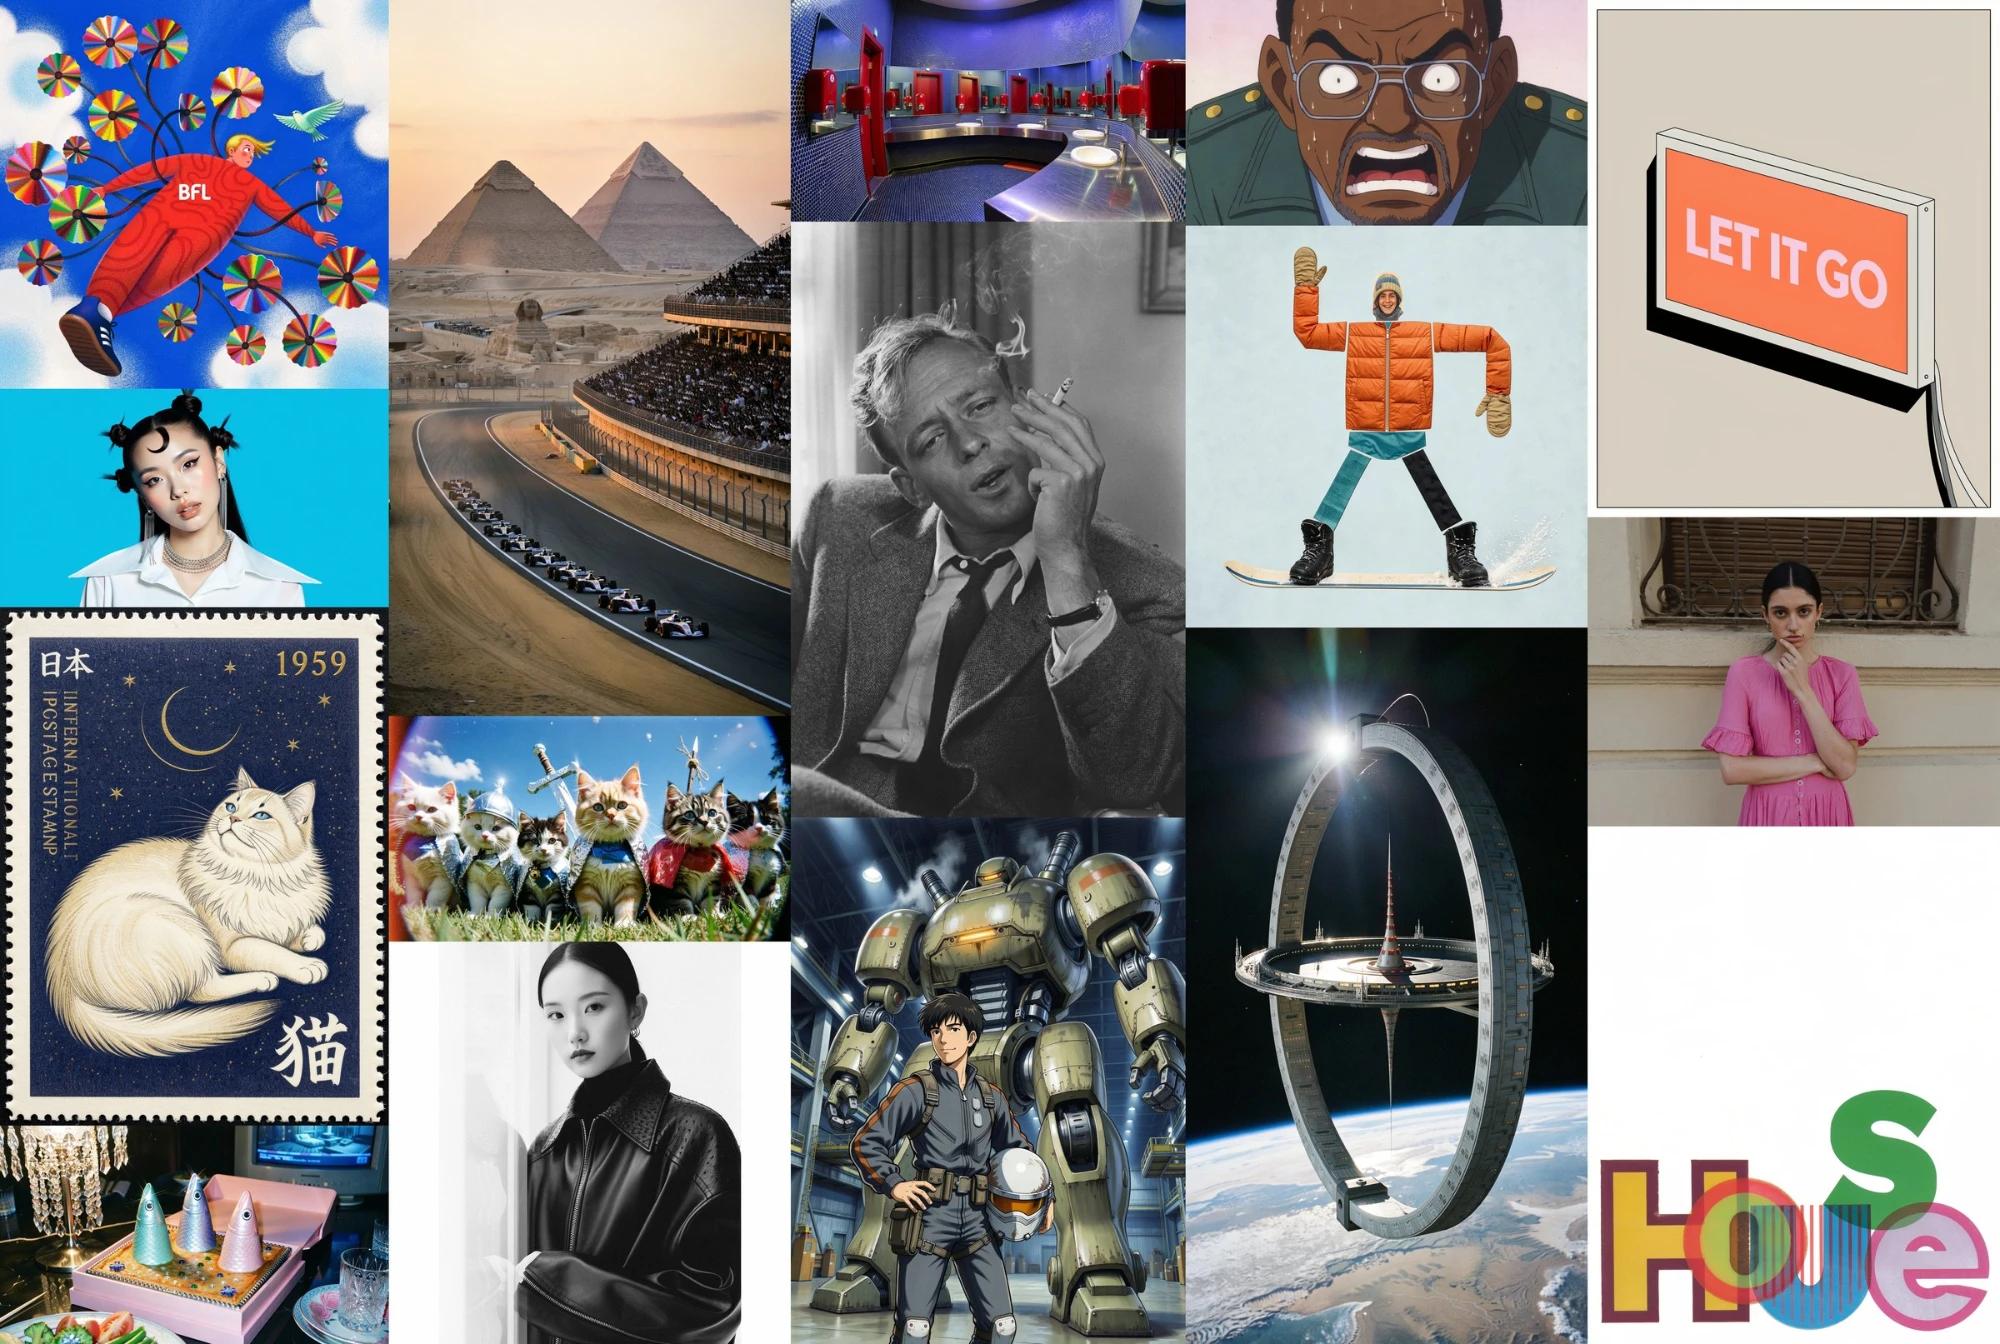
Fonte: Black Forest Labs. Esta é uma coleção de resultados gerados selecionada pela editora, não uma avaliação independente da qualidade.
A BFL descreve o modelo como baseado em aprendizagens partilhadas da investigação da família FLUX 3 em imagem, vídeo e áudio. Para o Image Klein em si, a interface disponibilizada é de geração e edição de imagens; esse contexto de investigação não implica que o checkpoint gere áudio ou vídeo.
As caixas delimitadoras orientam a posição e a escala dos elementos. O cartão oficial do modelo especifica uma grelha de coordenadas de 0 a 1000 e ordena cada caixa como topo, esquerda, fundo, direita. Também alerta que as caixas não são máscaras rígidas de píxeis: os elementos podem ultrapassá-las, os elementos pequenos podem desaparecer e as edições podem afetar áreas fora da região solicitada.
A API alojada da BFL adiciona restauração de píxeis, destinada a preservar exatamente as regiões não editadas. Esta funcionalidade de serviço não deve ser tratada como uma propriedade incondicional da inferência com o checkpoint bruto.
Os dois checkpoints principais servem objetivos diferentes:
| Checkpoint | Configuração de passos publicada | Configuração de orientação | Utilização prevista |
|---|---|---|---|
| Klein Base | 50 | 3,5 | Ajuste fino, treino de LoRA e investigação |
| Klein | 16 | Nenhuma | Geração, edição e inferência autoalojada |
Fonte: cartão oficial do modelo da BFL. O checkpoint destilado é também o modelo por trás da API alojada Image Klein.
O modelo utiliza o Qwen3-VL-4B-Instruct como codificador de texto separado. O pacote do Hugging Face inclui o transformador de imagem, o codificador de texto e o autoencoder de imagens; as variantes BF16, FP8 e NVFP4 são descritas nesse local, enquanto o anúncio de lançamento também identifica compilações INT8 suportadas pela NVIDIA.
Para adaptação, a BFL orienta os programadores para o modelo base. O lançamento indica suporte de Diffusers, AI Toolkit da Ostris e NVIDIA NeMo AutoModel para LoRA e outros fluxos de trabalho de treino.
A BFL informa que o Image Klein lidera as suas comparações internas de texto para imagem, edição e múltiplas referências face às alternativas selecionadas. O artigo de lançamento destaca ganhos de 91 Elo em texto para imagem e de 70 Elo em edição sobre o FLUX.2 [klein] 9B, utilizando 38% menos parâmetros no gerador.
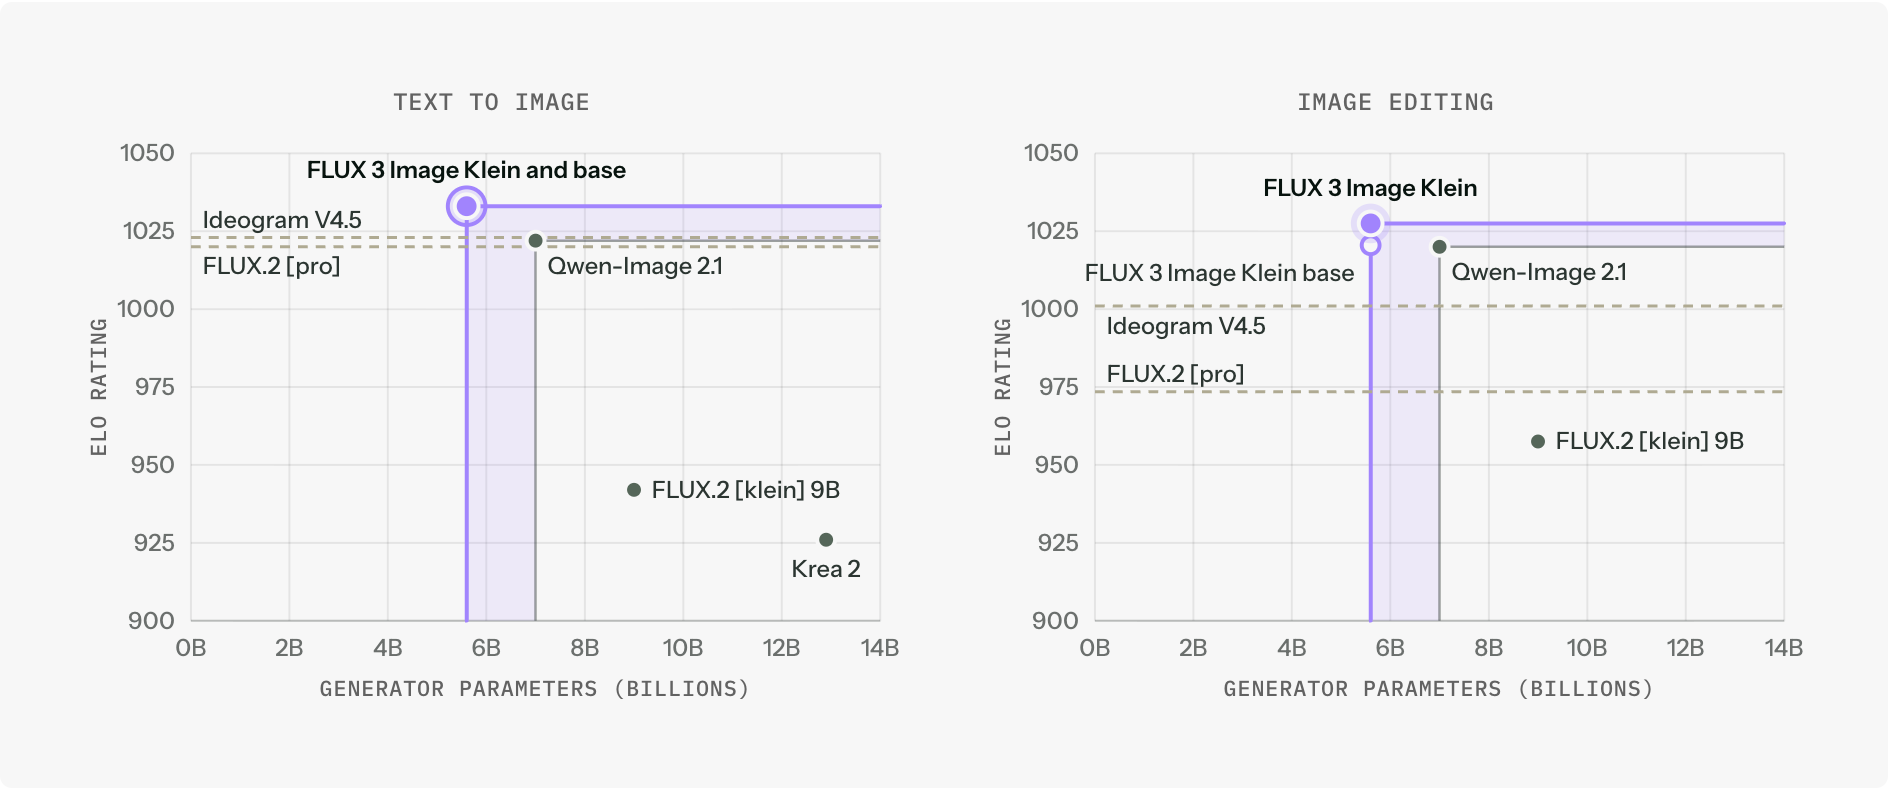
Fonte: Black Forest Labs. As contagens de parâmetros do gerador excluem os codificadores de texto; o Krea 2 é omitido da comparação de edição porque não suporta essa tarefa.
Estas classificações descrevem o conjunto de comparação e o procedimento de avaliação da BFL. Não estabelecem que o modelo produzirá o melhor resultado para todos os prompts, estilos, idiomas ou restrições de edição. Para um fluxo de trabalho de produção, teste os tipos de referências e edições que realmente ocorrem nesse fluxo.
O anúncio de lançamento indica requisitos de pesos do gerador de 11,2 GB em BF16 e 5,6 GB em FP8. Estes são tamanhos de pesos, não orçamentos completos de memória GPU.
A BFL afirma que uma compilação INT8 otimizada pode ser executada em GPUs GeForce RTX com apenas 8 GB de VRAM através de configurações ComfyUI ou Diffusers suportadas. Esta afirmação depende da compilação e da implementação; não significa que o pipeline de referência não modificado caiba em 8 GB.
O cartão do modelo apresenta a seguinte memória máxima do código de referência numa B200 a 1024 por 1024 píxeis, com o expansor de prompt desativado:
| Precisão | Memória GPU máxima reportada |
|---|---|
| BF16 | 31 GB |
| FP8 | 26 GB |
| NVFP4 | 25 GB |
O mesmo cartão afirma que o expansor de prompt adiciona cerca de 28 GB numa GPU de 80 GB. A codificação de texto, as ativações intermédias, a resolução e o processamento de referências ajudam a explicar por que a memória total é maior do que os pesos armazenados do gerador.
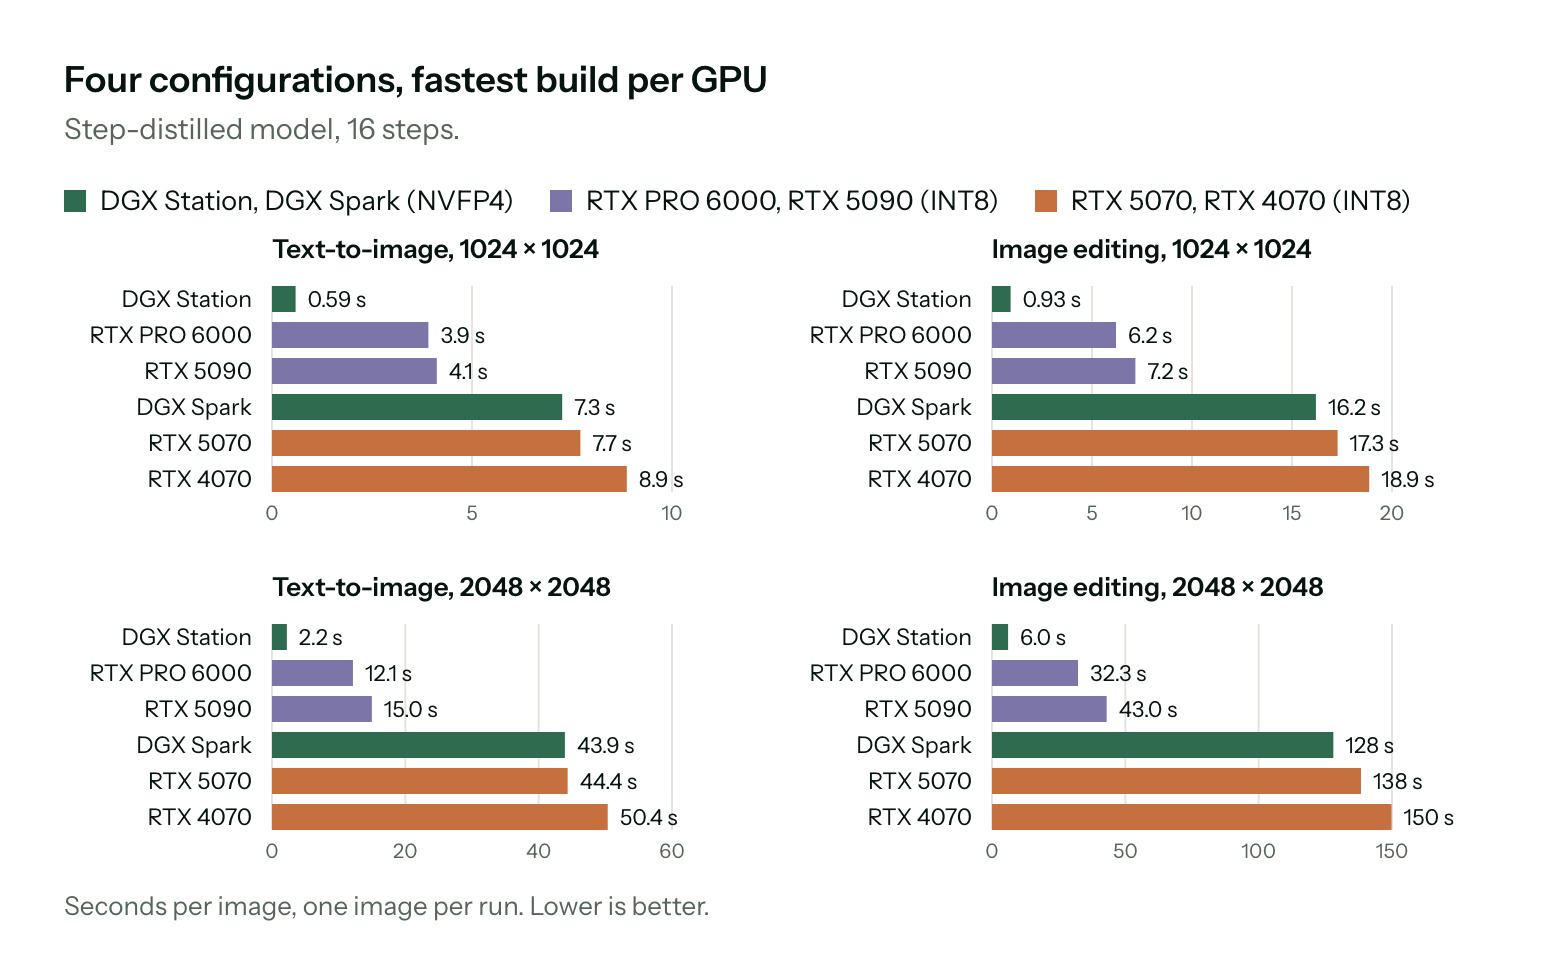
Fonte: BFL, medições da NVIDIA. O gráfico utiliza uma imagem por execução e a compilação listada mais rápida de cada GPU; as medições RTX utilizam ComfyUI. Estes são tempos de geração, e não tempos de resposta completos da API.
Para o checkpoint destilado de 16 passos, o gráfico informa 4,1 segundos para um resultado de texto para imagem a 1024 por 1024 numa RTX 5090 e 8,9 segundos numa RTX 4070. A edição demora mais nessas medições, e as configurações maiores de 2048 por 2048 são substancialmente mais lentas.
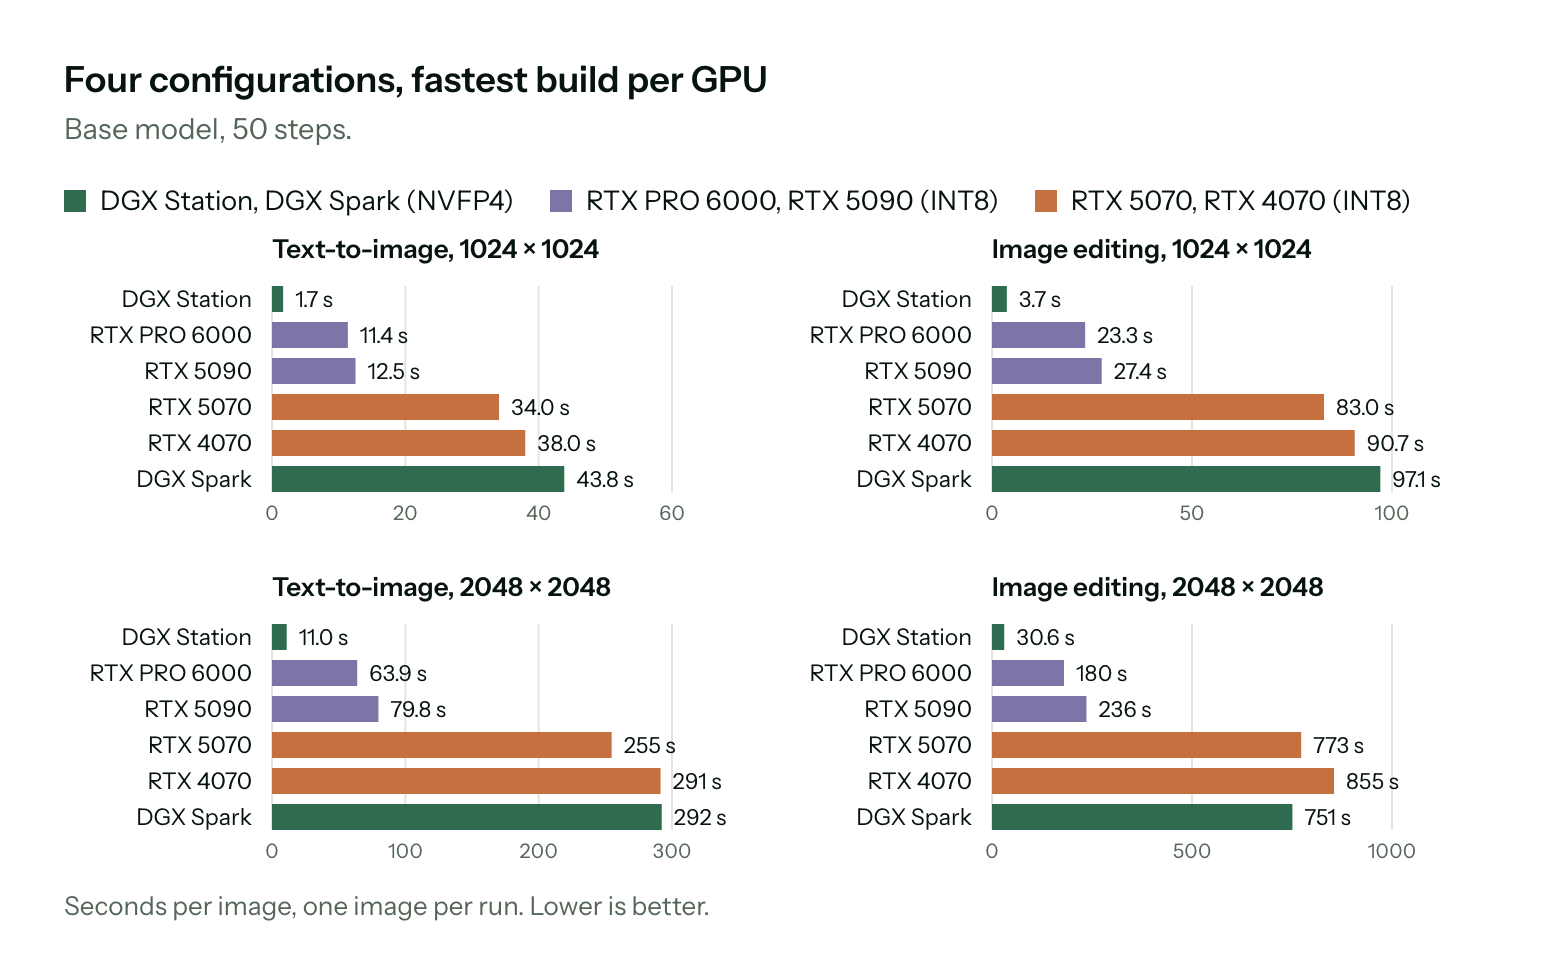
Fonte: BFL, medições da NVIDIA. Este gráfico utiliza o checkpoint base de 50 passos e a compilação mais rápida apresentada para cada GPU.
O modelo base de 50 passos tem um perfil de velocidade diferente. É útil manter os seus resultados separados dos do modelo destilado, especialmente ao estimar o tempo de iteração para treino ou edição de imagens de referência.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A API da BFL disponibiliza o modelo destilado como flux-3-image-klein. O anúncio de lançamento afirma que os preços começam em US$ 0,009 por imagem de 1K e incluem expansão de prompt e restauração de píxeis na oferta alojada. Consulte a documentação atual da API e os preços da conta antes de estimar um custo de produção.
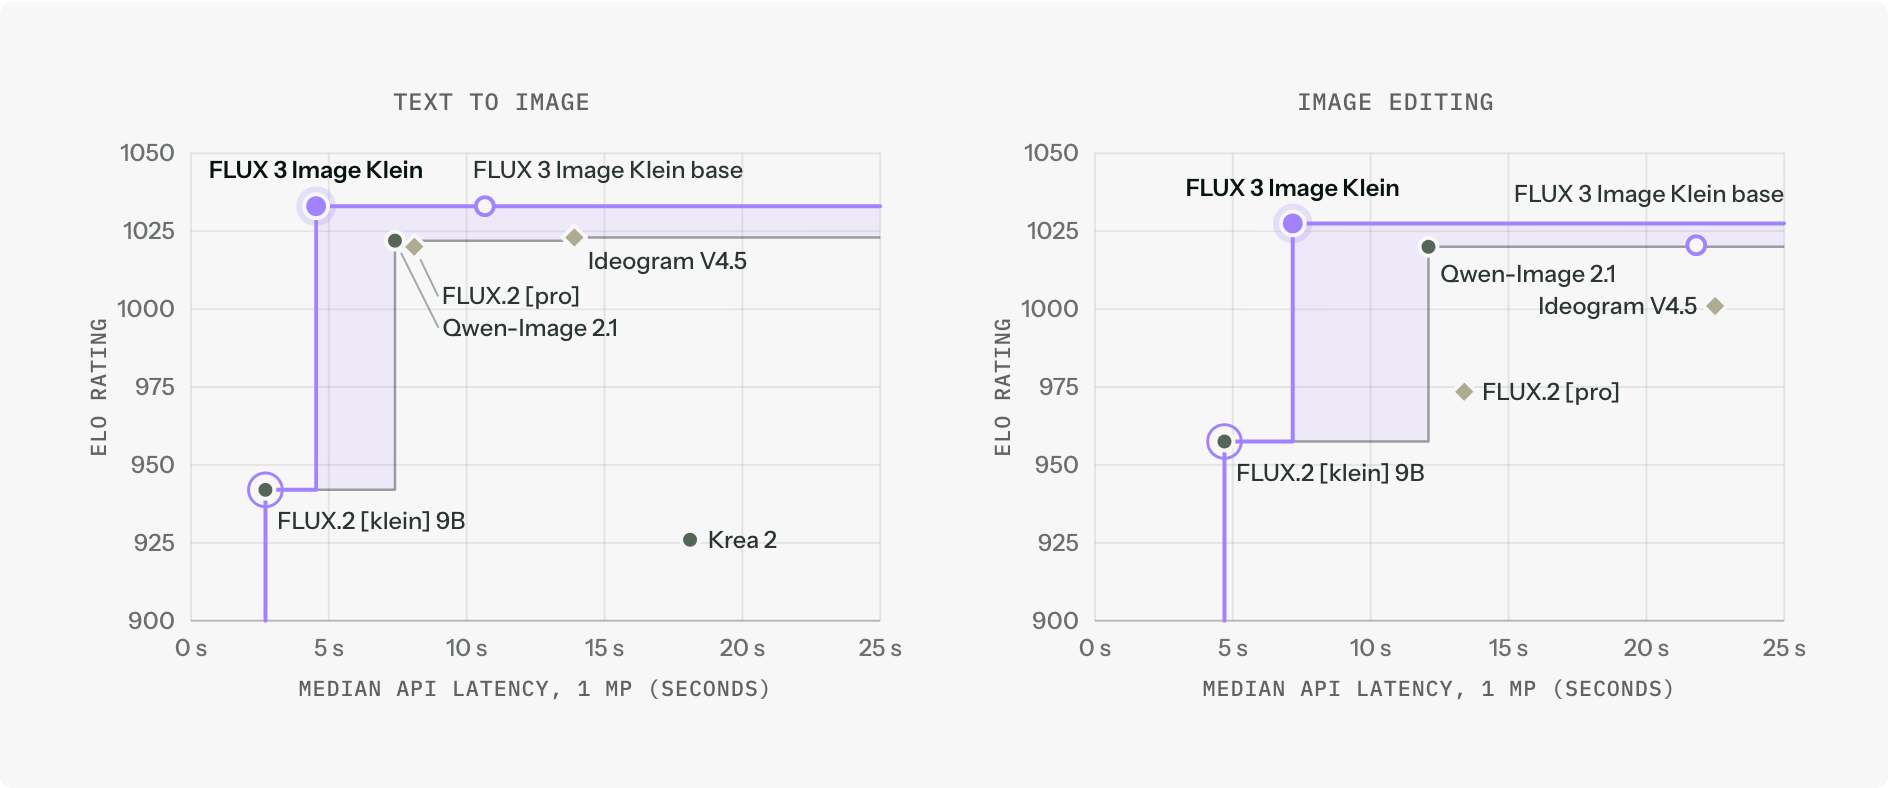
Fonte: Black Forest Labs. A comparação publicada utiliza imagens finais de 1 MP e inclui tempo de fila; a BFL mediu o seu próprio modelo nos seus servidores, enquanto as medições dos concorrentes foram feitas do lado do cliente e incluíram sondagem e tempo de rede.
Estas diferenças de medição são importantes para interpretar a classificação de velocidade. O tempo de geração local, a medição do lado do servidor e a latência da API observada pelo cliente respondem a perguntas relacionadas, mas distintas. Uma aplicação deve medir o tempo desde o envio do seu próprio pedido até dispor de um resultado utilizável.
O cartão oficial do modelo enfatiza descrições completas da cena. Instruções curtas enviadas diretamente ao modelo de imagem podem gerar resultados genéricos ou reenquadrar involuntariamente uma edição.
Uma sequência prática de avaliação é:
A CLI de referência carrega o expansor de prompt da BFL por predefinição. O Diffusers não o invoca automaticamente, pelo que essa etapa deve ser tratada separadamente ao utilizar o pipeline modular documentado.
O anúncio de lançamento contém um bloco de citação, reproduzido aqui para atribuição:
@misc{bfl2026flux3imageklein,
  author       = {{Black Forest Labs}},
  title        = {{FLUX} 3 Image Klein},
  year         = {2026},
  url          = {https://bfl.ai/blog/flux-3-image-klein},
}
O Image Klein utiliza a FLUX Kommunity License v1.0. O cartão do modelo descreve uso não comercial e uma exceção para geração de resultados comerciais para utilizadores qualificados com menos de 5 milhões de dólares americanos em receita bruta anualizada, incluindo afiliadas, sujeita ao acordo.
Essa exceção não é uma autorização geral para todo o treino comercial, redistribuição ou acordo de prestação de serviços. Organizações maiores e outras utilizações precisam de consultar os termos de licenciamento comercial da BFL ou utilizar a API alojada nos termos aplicáveis. O codificador de texto Qwen separado utiliza Apache-2.0.
A BFL relata filtragem de dados de treino, mitigações após o treino, red teaming interno e avaliação pela Cinder. Estas medidas não eliminam as limitações indicadas no cartão do modelo: o texto gerado pode ser impreciso, o seguimento de prompts pode falhar, podem surgir enviesamentos e a edição pode alterar regiões não pretendidas.
É o modelo de imagem de pesos abertos da BFL para geração de texto para imagem, edição de imagens e composições com múltiplas referências. O valor de 5,6 mil milhões de parâmetros descreve o transformador de imagem e exclui o seu codificador de texto separado.
A BFL afirma que configurações INT8 otimizadas e suportadas podem ser executadas em GPUs com apenas 8 GB de VRAM. A sua implementação de referência tem um pico de memória documentado muito maior, pelo que a adequação do hardware depende da configuração completa do runtime.
O Klein Base é o checkpoint não destilado destinado a ajuste fino, LoRA e investigação, com uma configuração publicada de 50 passos. O Klein é destilado para geração e edição, com uma configuração publicada de 16 passos e sem orientação.
Não. O cartão oficial do modelo afirma que as caixas orientam a posição e a escala, em vez de imporem uma máscara rígida. A funcionalidade de restauração de píxeis da API alojada é uma parte separada do fluxo de serviço.
A licença inclui uma exceção de resultados comerciais para utilizadores qualificados abaixo do seu limite de 5 milhões de dólares americanos de receita bruta anualizada, sujeita a todos os termos. O ajuste fino comercial, a distribuição e outros acordos exigem a verificação do acordo completo, em vez de depender apenas do limite de receita.
O pipeline Diffusers documentado não executa o expansor de prompt por si só. A BFL aconselha executar primeiro o seu expansor ou outro modelo de linguagem adequado e passar a descrição completa resultante ao pipeline de imagem.
O FLUX 3 Image Klein reúne geração de texto para imagem, edição baseada em referências e orientação de layout num gerador de imagens menor e de pesos abertos. Os checkpoints base e destilado oferecem aos programadores caminhos distintos para adaptação e inferência mais rápida.
Os principais detalhes de implementação vão além da contagem de parâmetros: utilização completa de memória, expansão de prompts, comportamento de edição e âmbito da licença. Escolha e avalie o pipeline completo, em vez de tratar um valor de tamanho de pesos ou um benchmark de lançamento como uma especificação completa de implementação.
Comece com uma frase e tenha um site completo em minutos.
