For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gemini-3-6-flash-prioritizes-efficiency.md.
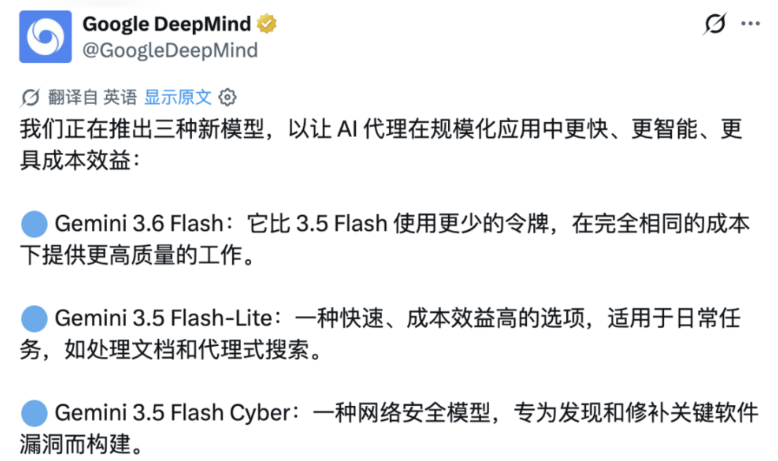
O Google lançou três novos modelos Gemini, cada um voltado para diferentes segmentos do mercado de agentes:
O Google lançou três novos modelos Gemini, cada um voltado para diferentes segmentos do mercado de agentes:
O anúncio do Google tem a eficiência como ponto central. A empresa afirma que o novo modelo Flash consegue concluir tarefas com menos tokens de saída, menos chamadas de ferramentas e menor sobrecarga no ciclo de execução. O preço também é inferior ao do Gemini 3.5 Flash.
Essa afirmação é apoiada pelos benchmarks internos do Google e por testes independentes iniciais.
A questão mais complexa é se o Gemini 3.6 Flash representa um avanço substancial em inteligência em comparação com o modelo que substitui.
A Artificial Analysis, em seu índice de inteligência abrangente, registrou a mesma pontuação para o novo modelo e o Gemini 3.5 Flash. Usuários iniciais também relataram experiências mistas, especialmente em design visual, geração em chinês, seleção de ferramentas e seguimento de instruções.
O resultado não é um fracasso absoluto. O Gemini 3.6 Flash parece ser mais rápido, produzir saídas mais concisas e ter um custo menor por tarefa concluída em muitas cargas de trabalho. Ele também apresenta melhorias em diversos benchmarks de codificação, uso computacional, aprendizado de máquina e trabalho do conhecimento.
Mas este lançamento destaca uma diferença importante:
Um modelo pode se tornar mais eficiente sem apresentar um salto igualmente grande em inteligência geral ou qualidade subjetiva de saída.
| Modelo | Função principal | Preço da API por milhão de tokens | Nível de raciocínio padrão | Disponibilidade |
|---|---|---|---|---|
| Gemini 3.6 Flash | Codificação, trabalhos multimodais e fluxos complexos de agentes | Entrada US$ 1,50 / Saída US$ 7,50 | Médio | Amplamente disponível |
| Gemini 3.5 Flash-Lite | Extração de alto volume, pesquisa, tradução, roteamento e subagentes | Entrada US$ 0,30 / Saída US$ 2,50 | Mínimo | Amplamente disponível |
| Gemini 3.5 Flash Cyber | Descoberta, verificação e correção de vulnerabilidades | Não divulgado publicamente | Especializado | Programa piloto limitado para governos e parceiros de confiança |
Tanto o Gemini 3.6 Flash quanto o Gemini 3.5 Flash-Lite suportam:
A ficha técnica do Google lista a data de corte de conhecimento de ambos os modelos amplamente disponíveis como março de 2026.
O Gemini 3.6 Flash é baseado no
Gemini 3.5 Flash, e foi projetado para substituí-lo em diversas cargas de trabalho de codificação, trabalho do conhecimento, multimodalidade e agentes.
A melhoria mais consistente é a eficiência.
O Google relatou que, no índice de análise de IA, o Gemini 3.6 Flash utiliza 17% menos tokens de saída do que o Gemini 3.5 Flash. Em algumas avaliações de codificação com agentes (incluindo DeepSWE), o Google observou reduções de tokens de saída de até 65%.
O modelo também tende a usar:
Essas mudanças são importantes porque o custo de um agente não depende apenas do preço por token divulgado.
Um agente de longa duração pode chamar o modelo repetidamente, enviar definições de ferramentas grandes, verificar arquivos, executar código, recuperar-se de falhas e gerar uma grande quantidade de saída de raciocínio. Mesmo que o preço por token mude pouco, reduzir o número de rodadas de chamadas e a quantidade de tokens diminui o custo total.
O Google lista os seguintes preços de API:
| Tipo de Token | Gemini 3.6 Flash | Gemini 3.5 Flash |
|---|---|---|
| Entrada | US$ 1,50 por milhão de tokens | US$ 1,50 por milhão de tokens |
| Saída | US$ 7,50 por milhão de tokens | US$ 9,00 por milhão de tokens |
O preço de entrada permanece inalterado, enquanto o preço de saída caiu aproximadamente 16,7%.
Em suas configurações de avaliação, a Artificial Analysis mediu um custo médio por tarefa de aproximadamente US$ 0,50 para o Gemini 3.6 Flash, contra US$ 0,59 para o Gemini 3.5 Flash. Devido à redução do preço de saída e à geração de menos tokens, isso representa uma queda de cerca de 18%.
Esses números devem ser considerados específicos para cada carga de trabalho, e não universalmente aplicáveis. O custo real depende de:
A Artificial Analysis relata que o tempo médio por tarefa do Gemini 3.6 Flash é de aproximadamente 1,3 minuto, abaixo dos cerca de 2,7 minutos do Gemini 3.5 Flash.
Essa melhoria vem de saídas mais rápidas e de um processo de raciocínio mais econômico.
Um modelo que gera tokens rapidamente ainda pode levar muito tempo se ficar preso em loops repetitivos de chamadas de ferramentas. Por outro lado, um modelo um pouco mais lento pode concluir mais cedo se encontrar a solução correta com menos chamadas.
Para desenvolvedores de agentes, o tempo necessário por tarefa concluída geralmente é mais útil do que a taxa bruta de tokens por segundo.
O Google relata melhorias em várias categorias de benchmarks.
No DeepSWE, a pontuação do Gemini 3.6 Flash subiu de 37% para 49% em comparação com o Gemini 3.5 Flash.
O Google afirma que o modelo:
Este último ponto envolve uma compensação.
O guia do desenvolvedor do Google observa que o Gemini 3.6 Flash pode executar scripts de diagnóstico antes de editar, o que pode aumentar a precisão em tarefas complexas. No entanto, em trabalhos front-end simples, essas etapas exploratórias adicionais
podem aumentar a latência sem necessariamente melhorar o resultado.
A Google também afirmou que avaliadores humanos, por vezes, preferem o layout visual e o estilo de versões anteriores de modelos, mesmo que o Gemini 3.6 Flash gere um código mais prático. Portanto, programadores que criam interfaces podem precisar fornecer restrições de design visual mais claras.
No benchmark MLE-Bench, a Google reportou um aumento de 49,7% para 63,9%.
Esta avaliação foca-se em tarefas reais de engenharia e investigação em machine learning, em vez de problemas de codificação isolados. Esta melhoria indica que o modelo tem um melhor desempenho em fluxos de trabalho que exigem experimentação, processamento de dados, implementação e melhorias iterativas.
No OSWorld-Verified, de acordo com a comparação divulgada pela Google, o Gemini 3.6 Flash subiu de 78,4% para 83,0%.
A capacidade de uso de computador está agora disponível como uma ferramenta de cliente integrada, através da API Gemini e do Gemini Enterprise. Permite que sistemas de agentes interajam com interfaces gráficas, em vez de dependerem apenas de APIs diretas.
Os resultados dos testes de benchmark para a capacidade de uso de computador ainda são influenciados pela estrutura do agente, ambiente de ecrã, conceção de tarefas e estratégias de recuperação de falhas. Pontuações mais altas são benéficas, mas os sistemas de produção ainda precisam de definir permissões rigorosas e etapas de confirmação para operações importantes.
No GDPval-AA v2, o Gemini 3.6 Flash subiu de 1349 para 1421.
A Google destacou os seguintes cenários de aplicação:
Clientes como Figma, Harvey, Hebbia e JetBrains forneceram avaliações positivas para o anúncio de lançamento da Google. Estes testemunhos refletem a experiência do cliente e não devem ser considerados como benchmarks independentes.
O Gemini 3.6 Flash suporta uma janela de contexto de até 1 milhão de tokens e uma saída máxima de 64.000 tokens.
A sua ficha técnica do modelo lista a data de corte de conhecimento como março de 2026, uma melhoria em relação às versões anteriores do Gemini (cujas datas de corte eram significativamente mais antigas).
Uma data de corte mais recente reduz a quantidade de informações contextuais recentes básicas que os programadores têm de fornecer manualmente. No entanto, isto não torna o modelo fiável para lidar com notícias atuais, preços em tempo real, leis em mudança, lançamentos de software ou outras informações sensíveis ao tempo.
As aplicações que lidam com informações novas devem continuar a usar recuperação, pesquisa, bases de dados verificadas ou chamadas de ferramentas.
Uma janela de contexto grande também não garante que o modelo utilize todas as partes de um documento longo com a mesma eficácia. Os programadores devem testar:
A Google afirmou que o Gemini 3.6 Flash inclui medidas de segurança de fronteira mais fortes, direcionadas para:
A ficha técnica do modelo reporta que, em comparação com o Gemini 3.5 Flash, os resultados automáticos de segurança multilingue e de conteúdo melhoraram, mantendo ao mesmo tempo uma taxa de recusa injustificada relativamente baixa.
A Google também apontou
várias limitações:
A avaliação de segurança de fronteira da Google concluiu que o Gemini 3.6 Flash ainda se encontra abaixo do nível de capacidade crítica estabelecido pela empresa, incluindo o limiar de cibersegurança.
Esta conclusão baseia-se na estrutura de avaliação da Google e deve ser interpretada em conjunto com os resultados de testes de segurança independentes que se tornem disponíveis posteriormente.
O Gemini 3.5 Flash-Lite foi concebido para tarefas que priorizam velocidade, rendimento e custo, em detrimento da maior profundidade de raciocínio.
Os cenários de aplicação típicos incluem:
A Google descreve-o como o modelo mais rápido e de menor custo da série Gemini 3.5.
| Tipo de Token | Preço por Milhão de Tokens |
|---|---|
| Entrada | 0,30 USD |
| Saída | 2,50 USD |
O seu nível de raciocínio predefinido é Mínimo, priorizando o rendimento e a baixa latência.
Para subtarefas autónomas, execução de código, chamadas de ferramentas ou planeamento em vários passos, a Google sugere aumentar o nível de raciocínio para Médio ou Alto, quando necessário. Configurações mais altas melhoram a taxa de conclusão de tarefas, mas geralmente aumentam o uso de tokens e a latência.
O anúncio de lançamento da Google citou dados da Artificial Analysis, que, em testes de pré-lançamento, mediram cerca de 350 tokens de saída por segundo.
A Artificial Analysis registou posteriormente velocidades de fornecedores específicos que podem variar ao longo do tempo. O rendimento depende de:
A conclusão estável é que o Flash-Lite é concebido para ser significativamente mais rápido do que os modelos Flash maiores.
A Google reportou as seguintes melhorias em relação ao Gemini 3.1 Flash-Lite:
| Benchmark | Gemini 3.1 Flash-Lite | Gemini 3.5 Flash-Lite |
|---|---|---|
| Terminal-Bench 2.1 | 31% | 54% |
| GDM-MRCR v2 | 60,1% | 72,2% |
| GDPval-AA v2 | 642 | 1140 |
A Google também reportou que o Gemini 3.5 Flash-Lite superou o Gemini 3 Flash em vários benchmarks de agentes e codificação:
Isto torna o Flash-Lite mais do que apenas um modelo económico de baixa qualidade. Para certas tarefas de agente de alto rendimento e estreitas, pode oferecer um melhor equilíbrio do que o antigo Gemini 3 Flash.
A Artificial Analysis classificou o Gemini 3.5 Flash-Lite com uma pontuação de 36 no seu Índice de Inteligência, acima dos 25 pontos do Gemini 3.1 Flash-Lite.
Este aumento de 11 pontos é uma das melhorias de inteligência mais significativas neste lançamento.
O Flash-Lite ainda está abaixo dos modelos de fronteira mais poderosos, mas o seu objetivo não é competir com eles em todas as tarefas de raciocínio complexas. O seu papel é processar grandes volumes de trabalho de forma rápida e económica.
O terceiro lançamento, Gemini 3.5 Flash
Cyber, tem um propósito diferente.
É um modelo especializado baseado no Gemini 3.5 Flash, ajustado para:
Este modelo trabalha em conjunto com o agente de segurança de código do Google DeepMind, CodeMender.
No CodeMender, múltiplos agentes Flash Cyber podem pesquisar diferentes partes de uma base de código e consolidar as suas descobertas num único relatório.
A Google considera valioso o uso de modelos mais pequenos e de menor custo na área da cibersegurança, porque a investigação de vulnerabilidades frequentemente requer a exploração de um grande número de caminhos de execução possíveis. Chamar repetidamente modelos grandes e dispendiosos pode tornar-se um gargalo.
A Google afirmou que, quando utilizado através do sistema CodeMender, o Gemini 3.5 Flash Cyber atinge um desempenho competitivo a nível de fronteira no CyberGym.
Este resultado depende de toda a infraestrutura do agente, e não apenas do modelo subjacente. Orquestração, ferramentas, verificação e agregação de relatórios contribuem para a pontuação final.
O Gemini 3.5 Flash Cyber não será disponibilizado publicamente
A API Gemini está amplamente disponível.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O Google planeja disponibilizá-la por meio de um programa piloto limitado chamado CodeMender para:
Este lançamento limitado reflete a natureza de duplo uso do modelo. Um sistema capaz de encontrar e verificar vulnerabilidades pode ajudar defensores a corrigir software, mas uma capacidade semelhante também pode apoiar atividades ofensivas.
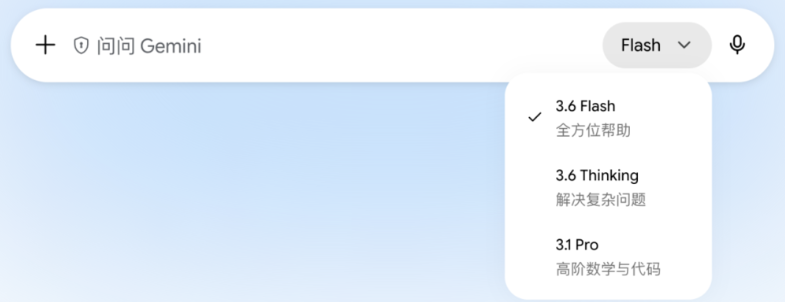
O Google afirma que o Gemini 3.5 Pro está sendo testado com parceiros e será lançado de forma mais ampla quando estiver pronto.
O artigo original do AIBase relaciona esse atraso a relatos externos e rumores online sobre desempenho de codificação e possível retreinamento.
O Google não confirmou publicamente as alegações de que o plano de treinamento original do modelo foi abandonado ou que o sistema foi reiniciado do zero.
As informações verificadas são limitadas:
A ausência do modelo Pro emblemático torna o lançamento do Flash estrategicamente mais importante. Com o modelo de ponta ainda indisponível, o Gemini 3.6 Flash e o Flash-Lite precisam cobrir uma parcela maior das necessidades de produção.
Isso não significa necessariamente que o Google abandonou o Gemini 3.5 Pro ou que o Gemini 4 está chegando em breve.
Os cronogramas de desenvolvimento de modelos podem mudar, e o pré-treinamento é apenas uma fase. Pós-treinamento, testes de segurança, integração de ferramentas, otimização de latência e preparação para implantação podem exigir um tempo adicional significativo.
As conclusões da análise humana são mais moderadas do que os anúncios de produtos do Google.
O Gemini 3.6 Flash obteve uma pontuação de 50 pontos no Índice de Inteligência da Análise Humana.
O Gemini 3.5 Flash também obteve 50 pontos.
Portanto, embora a avaliação mostre melhorias em algumas categorias, a pontuação geral de inteligência do novo modelo neste teste não aumentou.
O relatório de análise humana indica:
Esta é uma atualização de eficiência crível, mas não um salto amplo de inteligência.
A análise humana mediu:
O modelo reduziu em mais da metade o tempo para concluir a carga de trabalho de avaliação.
Estimativa da análise humana:
Para agentes de IA em grande escala, essa redução de custo é significativa, especialmente quando os sistemas executam milhares de tarefas.
A análise humana combina várias avaliações em um único índice. A pontuação composta pode ser usada para comparações aproximadas, mas pode mascarar diferenças significativas entre diferentes cargas de trabalho.
Modelos com a mesma pontuação total podem ser superiores em alguns aspectos, como:
Mas podem ser mais fracos em:
Escolher o modelo certo depende do cenário de aplicação específico.
O texto original coletou várias reações críticas nas redes sociais.
As reclamações dos usuários incluem:
Esse feedback é importante porque os benchmarks não conseguem cobrir todos os aspectos da qualidade do produto.
Um modelo pode ter um desempenho excelente em tarefas de base de código, mas gerar layouts ruins; pode usar menos tokens, mas tornar-se excessivamente conciso; pode ser mais preciso em um benchmark de programação, mas menos confiável em um idioma específico.
Ao mesmo tempo, os testes em redes sociais têm limitações sérias:
Portanto, o feedback inicial do usuário deve ser visto como um sinal para testes direcionados, não como uma conclusão final.
As equipes que consideram o uso do Gemini 3.6 Flash não devem adotá-lo apenas porque o Google relatou benchmarks mais altos, nem devem rejeitá-lo apenas porque algumas demonstrações online foram decepcionantes.
Testes de migração úteis devem comparar os modelos antigo e novo na mesma aplicação.
Construa um conjunto de avaliação a partir do trabalho real:
Acompanhe:
O Gemini 3.6 Flash tem como padrão um nível de raciocínio médio.
O Gemini 3.5 Flash-Lite tem como padrão o nível de raciocínio mais baixo.
Um modelo pode parecer pouco capaz simplesmente porque a configuração de raciocínio é muito baixa para a tarefa em questão. Por outro lado, usar um nível de raciocínio alto para uma tarefa simples de extração de informação pode desperdiçar tempo e dinheiro.
Benchmarks de codificação não medem se um site tem uma boa aparência ou se a redação em chinês é natural.
Use revisão humana dedicada para avaliar:
O resultado da operação de um agente não depende apenas do modelo.
Compare:
A migração do modelo pode exigir ajustes correspondentes em todo o ambiente do sistema.
O aplicativo precisa processar grandes volumes de documentos.
É mais fácil entender o Gemini 3.6 Flash como uma atualização na experiência operacional, e não como um avanço dramático de inteligência.
Ele foi projetado para reduzir os desperdícios que tornam os agentes caros:
Essas melhorias podem ser mais valiosas em ambientes de produção do que pequenos ganhos em benchmarks de raciocínio abstrato.
No entanto, eficiência não substitui qualidade em todas as aplicações.
Um modelo que conclui tarefas a baixo custo é inútil se o resultado exigir muito reparo manual. Um modelo com pontuação alta em programação ainda pode decepcionar no design. Um modelo com boa proficiência em inglês pode precisar de validação adicional em chinês ou outros idiomas.
A nova série Flash do Google cria opções mais especializadas:
Portanto, este lançamento é menos sobre um modelo substituir todos os outros e mais sobre alocar o nível certo de inteligência e custo para cada parte do sistema de agente.
O Gemini 3.6 Flash é o modelo carro-chefe multifuncional do Google para programação, tarefas multimodais, trabalho do conhecimento e fluxos de trabalho de agentes. Ele é baseado no Gemini 3.5 Flash, mas visa usar menos tokens, menos rodadas de interação e menos chamadas de ferramentas.
O Google relata melhorias em vários benchmarks de programação, uso de computador, aprendizado de máquina e trabalho do conhecimento. O Artificial Analysis atribui a ambos os modelos a mesma pontuação geral do Índice de Inteligência de 50, portanto, a melhoria mais aparente parece ser em eficiência e velocidade de conclusão de tarefas, em vez de um aumento na inteligência geral.
O Google definiu o preço do modelo em US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída. Os preços podem mudar, e o custo total do agente também depende de raciocínio, tamanho do contexto, chamadas de ferramentas, novas tentativas e comprimento da saída.
O Flash-Lite é adequado para cargas de trabalho de alto rendimento e sensíveis à latência, como extração, classificação, pesquisa, tradução, roteamento, processamento de dados estruturados e execução de subagentes. Ele é mais barato e mais rápido que o Gemini 3.6 Flash, mas não foi projetado para substituir modelos mais fortes em todas as tarefas difíceis.
Sim. A ficha técnica do modelo lista suporte para entrada de texto, imagem, áudio e vídeo, com saída em texto. A janela de contexto do modelo é de até 1 milhão de tokens.
É uma versão especializada do Gemini 3.5 Flash, treinada para descoberta, validação e correção de vulnerabilidades. O Google planeja disponibilizar este modelo para governos e parceiros de defesa confiáveis por meio de um programa piloto restrito chamado CodeMender.
O Google não indicou que foi cancelado. A empresa afirma que o Gemini 3.5 Pro está sendo testado com parceiros e estará amplamente disponível quando estiver pronto.
Não necessariamente. Antes de mudar, execute ambos os modelos em tarefas de produção representativas e compare as taxas de sucesso, tempo de correção manual, confiabilidade das ferramentas, latência, uso de tokens e custo total.
Antigravity (link: https://antigravity.google/): Ambiente de desenvolvimento de agentes do Google com Gemini 3.6 Flash integrado para fluxos de trabalho de codificação.
O lançamento mais recente do Flash do Google inclui três produtos distintos. O Gemini 3.6 Flash é voltado para agentes complexos e cenários de codificação, o Gemini 3.5 Flash-Lite foca em execução de alto rendimento,
O Gemini 3.5 Flash Cyber foca em pesquisa defensiva de vulnerabilidades sob acesso restrito.
O Gemini 3.6 Flash melhora vários benchmarks de nível de tarefa, reduz o uso de tokens de saída, acelera a conclusão de tarefas de agente e reduz o preço da saída. No entanto, testes independentes descobriram que sua pontuação geral de inteligência não melhorou em comparação com o Gemini 3.5 Flash.
Portanto, a reação complexa do mercado é compreensível. Este lançamento é mais uma prova convincente em termos de eficiência do que um salto em capacidade geral.
A melhor avaliação para o Gemini 3.6 Flash é: é um modelo de produção mais rápido e mais enxuto — não uma prova de que todas as formas de inteligência ou qualidade de saída melhoraram simultaneamente.
Comece com uma frase e tenha um site completo em minutos.



