For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
A ARC Prize anunciou uma **pontuação verificada de 97,5% para o Gemini 4 Argon no ARC-AGI-3**, tornando o Google DeepMind o segundo laborató...
A ARC Prize anunciou uma pontuação verificada de 97,5% para o Gemini 4 Argon no ARC-AGI-3, tornando o Google DeepMind o segundo laboratório de fronteira a ultrapassar 95% nesse benchmark, segundo o organizador.
O resultado vem acompanhado de uma comparação igualmente importante: a mesma família de modelos obteve 49,8% com o harness Standard, contra 97,5% com o Provider Adapter. Os custos de avaliação divulgados foram de aproximadamente US$ 5.800 e US$ 4.800, respetivamente.
Estes resultados dizem respeito a sistemas configurados. Antes de tirar conclusões com base no número em destaque, é necessário compreender o benchmark, o nível de raciocínio, o harness e as execuções incompletas.
O anúncio da ARC Prize apresenta os seguintes valores:
| Benchmark e configuração | Pontuação divulgada | Custo de avaliação divulgado |
|---|---|---|
| ARC-AGI-1, melhor configuração divulgada | 98,5% | Cerca de US$ 0,16 por tarefa |
| ARC-AGI-2, melhor configuração divulgada | 91,3% | Cerca de US$ 0,32 por tarefa |
| ARC-AGI-3, Provider Adapter, raciocínio baixo | 97,5% | Cerca de US$ 4.800 pela avaliação |
| ARC-AGI-3, Standard, raciocínio baixo | 49,8% | Cerca de US$ 5.800 pela avaliação |
As unidades de custo são diferentes. Os valores do ARC-AGI-1 e do ARC-AGI-2 são por tarefa; os valores do ARC-AGI-3 dizem respeito à execução da avaliação. Não devem ser comparados numa única escala de custos sem ter em conta esta diferença.
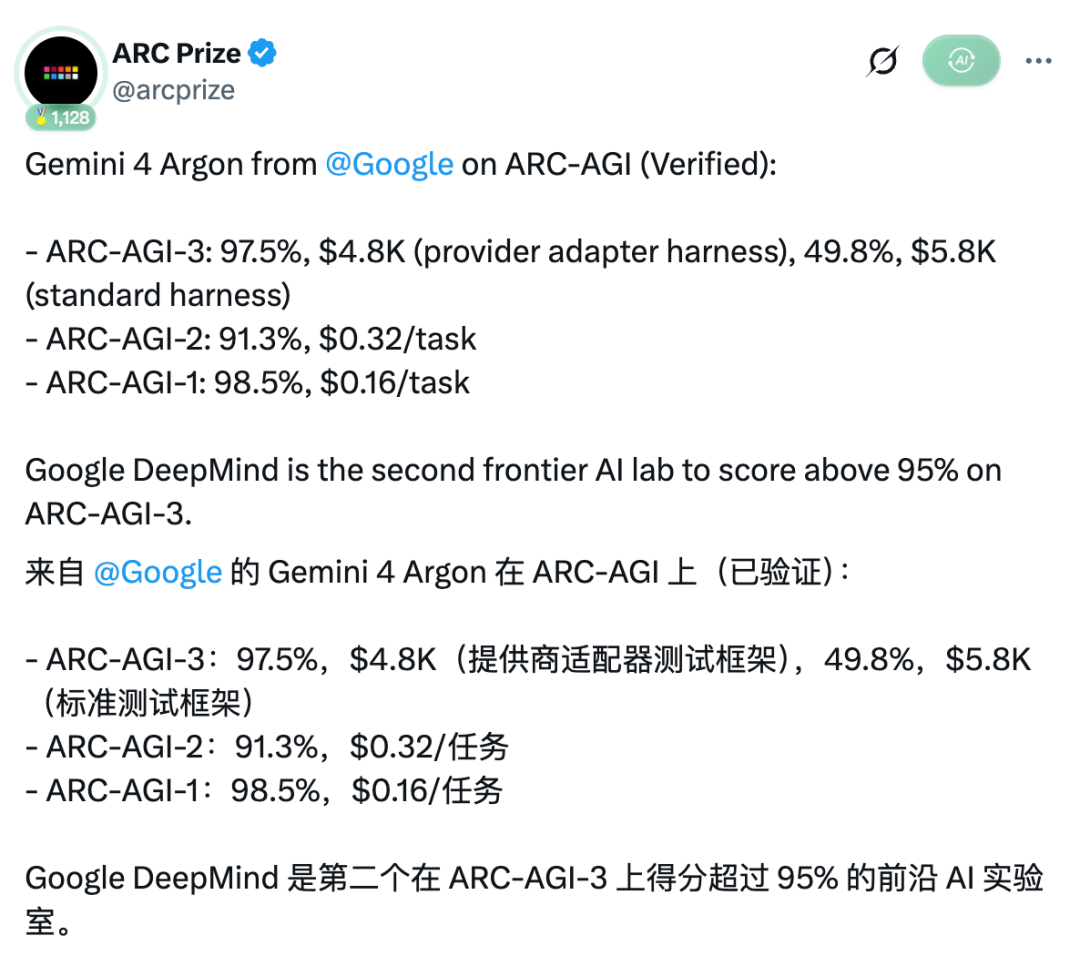
Anúncio da pontuação verificada da ARC Prize, reproduzido no relatório de origem.
A tabela atual apresenta custos mais precisos para as melhores configurações: US$ 0,162 por tarefa no ARC-AGI-1 e US$ 0,325 no ARC-AGI-2. Indica 91,3% para o ARC-AGI-2, em linha com o anúncio, embora o parágrafo que acompanha a página de resultados mencione 91,2%. Este artigo mantém o valor anunciado e apresentado na tabela, assinalando a discrepância.
O ARC-AGI-3 difere das duas primeiras gerações. Em vez de inferir uma grelha de saída a partir de exemplos estáticos, um agente explora ambientes interativos desconhecidos, descobre como funcionam as ações e aprende a alcançar objetivos sem instruções em linguagem natural que expliquem o jogo.
A ARC Prize descreve o teste como uma avaliação da eficiência na aquisição de competências, da adaptação e do planeamento ao longo do tempo. Por isso, a pontuação não corresponde simplesmente à «percentagem de jogos ganhos». A explicação do benchmark relaciona uma pontuação de 100% com a conclusão dos jogos com a mesma eficiência da referência humana.
A fonte descreve a evolução desde pontuações inferiores a 1% para os modelos de fronteira, por volta do lançamento do ARC-AGI-3 em março, até resultados próximos do limite máximo no final do ano. Destaca o resultado anterior do GPT-6 Astra, da OpenAI, seguido pela entrada do Gemini acima dos 95%.
Trata-se de uma mudança substancial nesta avaliação. Isso não significa que o organizador tenha testado todas as formas possíveis de raciocínio nem demonstrado que qualquer um dos sistemas consegue aprender qualquer tarefa nova da mesma forma que uma pessoa.
O relatório também descreve uma elevada eficiência de ação em 25 jogos públicos: 62% menos ações do que a referência humana, três jogos com resultados iguais ou superiores aos recordes de speedrun e seis a menos de 10% desses recordes. Estas comparações específicas são observações divulgadas pela fonte sobre o conjunto público; não devem ser generalizadas às 55 tarefas da avaliação nem a jogos arbitrários.
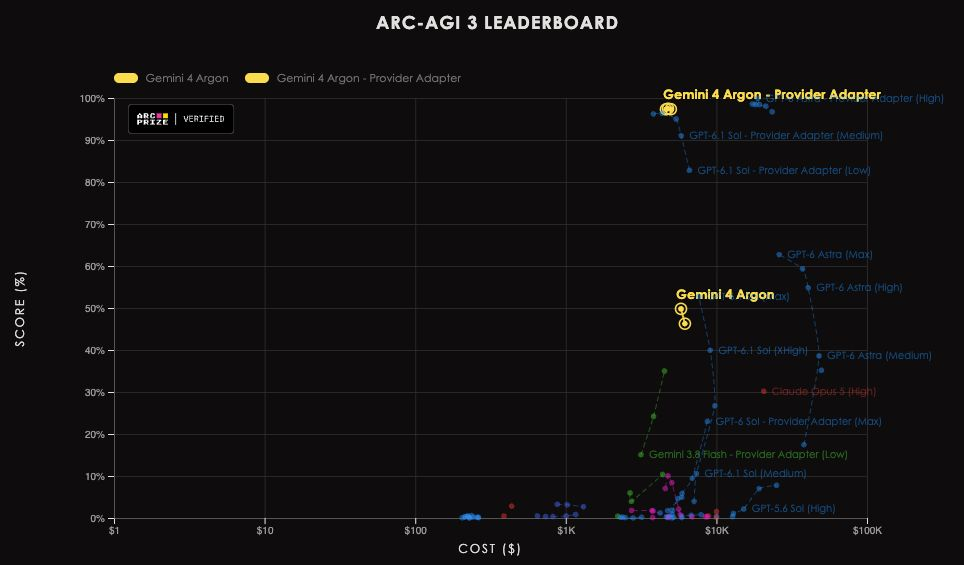
Captura de ecrã da classificação mantida no relatório; a página de resultados atual apresenta os detalhes da configuração vigente.
Um harness de agente controla a interação com um modelo: como as observações são recebidas, como as ações são enviadas, que contexto é preservado e o que acontece quando uma conversa se torna longa.
A ARC Prize define separadamente as duas condições:
Para o Gemini 4 Argon, os resultados atuais apresentam:
| Nível de raciocínio | Harness Standard | Harness Provider Adapter |
|---|---|---|
| Baixo | 49,8% | 97,5% |
| Médio | 46,3% | 97,3% |
| Alto | Sem ponto de comparação completo divulgado | 97,3% |
A diferença no nível de raciocínio baixo é de 47,7 pontos percentuais. Isto mostra que o sistema de interação configurado afeta materialmente o resultado medido, mas não permite identificar um único mecanismo causal. É necessário considerar a gestão de contexto, as condições de execução, a fiabilidade da API e outras configurações, além do rótulo do harness.
Em particular, a ARC Prize informa que problemas com a API impediram a conclusão de avaliações Standard. As execuções com raciocínio baixo, médio e alto foram concluídas, respetivamente, em 42, 46 e 19 das 55 tarefas. As pontuações agregadas divulgadas incluem as 55 tarefas e mantêm o crédito parcial das execuções incompletas; estes números de conclusão não significam que 42 ou 46 jogos tenham sido necessariamente resolvidos por completo.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O ponto incompleto do Standard com raciocínio alto foi excluído do gráfico. Por conseguinte, o maior esforço de raciocínio não produziu uma sequência de resultados Standard comparáveis, completos e inequívocos nesta avaliação.
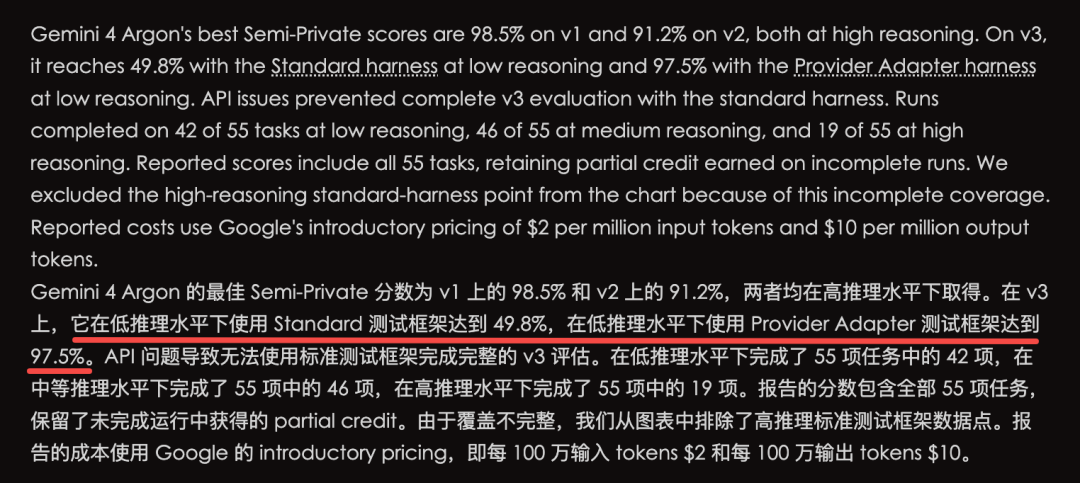
Nota sobre configuração e cobertura reproduzida no relatório de origem; consulte a página de resultados atual para ver atualizações.
Segundo a ARC Prize, as estimativas de custo utilizam os preços promocionais de lançamento da API da Google: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Não são um preço fixo para resolver uma nova tarefa do mundo real e podem mudar em função dos preços ou da configuração.
A principal lição prática da fonte é válida: o nome de um modelo e uma única percentagem não revelam grande parte do sistema avaliado. Duas pontuações associadas ao mesmo nome de modelo podem responder a perguntas diferentes quando as respetivas interfaces de gestão de contexto diferem.
A política da ARC Prize afirma explicitamente que os dois harnesses são apresentados em separado por responderem a perguntas de avaliação diferentes. Os resultados verificados são avaliações realizadas pelo organizador com metodologia publicada. Constituem evidência mais sólida do que um diapositivo de fornecedor sem comprovação, mas continuam limitados pela distribuição de tarefas e pelas condições testadas.
Para quem compara estes resultados, a ordem de leitura mais útil é: versão do benchmark, configuração exata do modelo, nível de raciocínio, harness, cobertura das tarefas, regras de pontuação e unidade de custo. Isso facilita distinguir uma melhoria real de uma comparação entre experiências diferentes.
Um desempenho próximo do limite máximo também levanta uma questão de investigação: quanto espaço de melhoria ainda resta num teste? Isso não elimina as limitações que persistem nem transforma a expressão «benchmark de AGI» numa prova de inteligência geral.
A ARC Prize divulga 97,5% com o harness Provider Adapter e raciocínio baixo. O resultado do harness Standard com raciocínio baixo foi de 49,8%, numa condição de avaliação diferente e com execuções incompletas.
Não. O ARC-AGI-3 mede o desempenho com um sistema de pontuação baseado na eficiência e pode atribuir crédito parcial. A pontuação não deve ser convertida diretamente no número de jogos concluídos por completo.
O harness Standard é uma interface mínima e independente do fornecedor que mantém as notas selecionadas pelo modelo. O Provider Adapter pode utilizar funcionalidades de gestão de contexto específicas do fornecedor, incluindo a preservação do estado de raciocínio e a compressão de conversas.
As execuções anunciadas com raciocínio baixo custaram cerca de US$ 4.800 com o Provider Adapter e US$ 5.800 com o harness Standard. A ARC Prize afirma que estas estimativas usam os preços promocionais dos tokens; são custos totais da avaliação, não preços por tarefa.
A ARC Prize classifica os resultados como verificados e publica a política de testes e a página de resultados específica do modelo. Este artigo consultou esses registos, mas não repetiu a avaliação nem reproduziu as pontuações de forma independente.
Não. Um único benchmark não permite estabelecer essa conclusão. O resultado demonstra um desempenho elevado no ARC-AGI-3 com a configuração de sistema indicada, mas é necessária evidência adicional para avaliar a fiabilidade e a generalização para além dessas condições.
Os resultados verificados do Gemini 4 Argon no ARC-AGI demonstram um desempenho elevado em testes estáticos e interativos. A pontuação de 97,5% no ARC-AGI-3 corresponde a uma configuração específica de raciocínio baixo com o Provider Adapter, com um custo de avaliação divulgado de cerca de US$ 4.800.
O resultado do Standard, as execuções incompletas e as diferenças na gestão de contexto são essenciais para interpretar a comparação. Analise em conjunto o modelo, o harness e as condições de avaliação; a percentagem, por si só, não comprova a existência de uma AGI.
Comece com uma frase e tenha um site completo em minutos.



