For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gemini-4-argon-launch-access-api-pricing-cf4e0dbb.md.
O [anúncio do Gemini 4 Argon](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/) do Google...
O anúncio do Gemini 4 Argon do Google apresenta um modelo voltado a trabalhos difíceis e prolongados: grandes alterações de código, criação visual, raciocínio científico e tarefas que continuam além de uma troca curta. O lançamento alcança tanto produtos para desenvolvedores quanto experiências de consumo, embora as condições de acesso sejam diferentes entre eles.
A história prática está nesses detalhes. Os preços introdutórios da API têm uma data de término, o limite de um milhão de tokens é compartilhado entre vários tipos de conteúdo, e um ganho de velocidade de software em destaque se aplica a uma parte específica de uma carga de trabalho. Consultar a documentação subjacente torna o anúncio muito mais fácil de avaliar.
O Google descreve acesso pago à API pelo AI Studio e pela plataforma Gemini, com a disponibilidade para desenvolvedores também se estendendo ao Android Studio. Assinantes do Google AI Ultra recebem acesso pelo Antigravity e pelo AI Studio, enquanto a disponibilização no aplicativo Gemini para consumidores e no Modo IA da Pesquisa inclui assinantes do Google AI Pro e Ultra.
São produtos diferentes, com direitos de acesso diferentes. O acesso do Google AI Pro a uma experiência de consumo não implica automaticamente que o mesmo plano inclua acesso de desenvolvedor ao Argon no AI Studio ou uma cota gratuita de API.
Para uma integração, verifique os requisitos atuais de acesso para desenvolvedores em vez de depender de uma manchete geral de lançamento. A página de preços do AI Studio identifica o modelo de API como gemini-4-argon e não lista nenhum nível gratuito para ele.
Conforme verificado em 15 de outubro, a documentação de preços padrão da API do Google apresenta dois períodos para o Gemini 4 Argon. Os preços abaixo estão em dólares americanos por um milhão de tokens.
| Categoria de token | Até 30 de novembro de 2026 | A partir de 1º de dezembro de 2026 |
|---|---|---|
| Entrada | US$ 2,00 | US$ 4,00 |
| Saída, incluindo raciocínio | US$ 10,00 | US$ 20,00 |
| Entrada armazenada em cache implicitamente | US$ 0,10 | US$ 0,20 |
As tarifas introdutórias de entrada e saída apresentadas no anúncio de lançamento são, portanto, limitadas no tempo, e não preços permanentes. O preço de entrada em cache representa uma redução de 95% em relação à tarifa de entrada correspondente, mas se aplica à entrada elegível armazenada em cache implicitamente; a página não lista o cache explícito como compatível com este modelo.
Os preços de tokens também não descrevem necessariamente o custo total de uma aplicação. Ferramentas cobradas separadamente e solicitações repetidas em um fluxo de trabalho podem acrescentar cobranças; portanto, uma estimativa de produção deve refletir o padrão real de solicitações e a documentação atual.
A documentação de decodificação longa do Google descreve um limite unificado de 1.048.576 tokens compartilhados entre entrada, raciocínio e saída. Não se trata de uma promessa de um milhão de tokens de entrada mais outro milhão de tokens de saída gerada.
A API Interactions normalmente limita a saída síncrona ou transmitida por streaming a 65.536 tokens. Gerar além disso exige modo em segundo plano, uma configuração maior de max_output_tokens e o armazenamento ativado, conforme especificado na documentação. O servidor realiza a geração mais longa em saltos de continuação.
Dois detalhes importam no planejamento dessa tarefa. Primeiro, max_output_tokens inclui tanto o raciocínio quanto a saída retornada. Segundo, os saltos de continuação podem contabilizar a entrada novamente, com o desconto de cache implícito documentado aplicado quando elegível; a decodificação longa não é uma extensão ilimitada e gratuita de uma solicitação.
Essa capacidade pode ajudar em uma implementação longa ou em uma análise extensa, mas uma grande permissão de saída não é uma garantia de correção. O resultado ainda precisa ser revisado, e a entrada consome parte do mesmo orçamento total.
O Google informa ter usado o Argon em uma refatoração envolvendo centenas de arquivos no Chrome, cuja base de código a empresa descreve como tendo aproximadamente 40 milhões de linhas, incluindo uma área legada de cerca de seis milhões de linhas. A empresa afirma que o trabalho passou de uma tarefa de meses para uma tarefa de semanas. Esses são resultados de projeto relatados pelo Google, não uma promessa geral sobre alterações em repositórios arbitrários.
O artigo de engenharia do ADK oferece um caso mais inspecionável. Ele trata de um repositório Python de cerca de 205.000 linhas distribuídas por aproximadamente 800 arquivos-fonte, com suporte de uma grande suíte pública de testes.
O trabalho ocorreu em duas rodadas. Uma tentativa inicial de duas horas expôs limitações; uma execução posterior durante a noite utilizou habilidades do projeto e uma meta do Antigravity. O modelo propôs seis otimizações em 32 arquivos, mas os mantenedores aceitaram duas e rejeitaram quatro. O trabalho final incorporado combinou alterações das rodadas em 22 arquivos e adicionou 17 funções de teste.
As otimizações aceitas trataram da filtragem antes da cópia de dados no serviço de sessão em memória e de importações preguiçosas de pacotes. O commit público incorporado disponibiliza o código resultante para inspeção.
O benchmark é útil porque separa diversos tempos em vez de apresentar um único ganho de velocidade como universal.
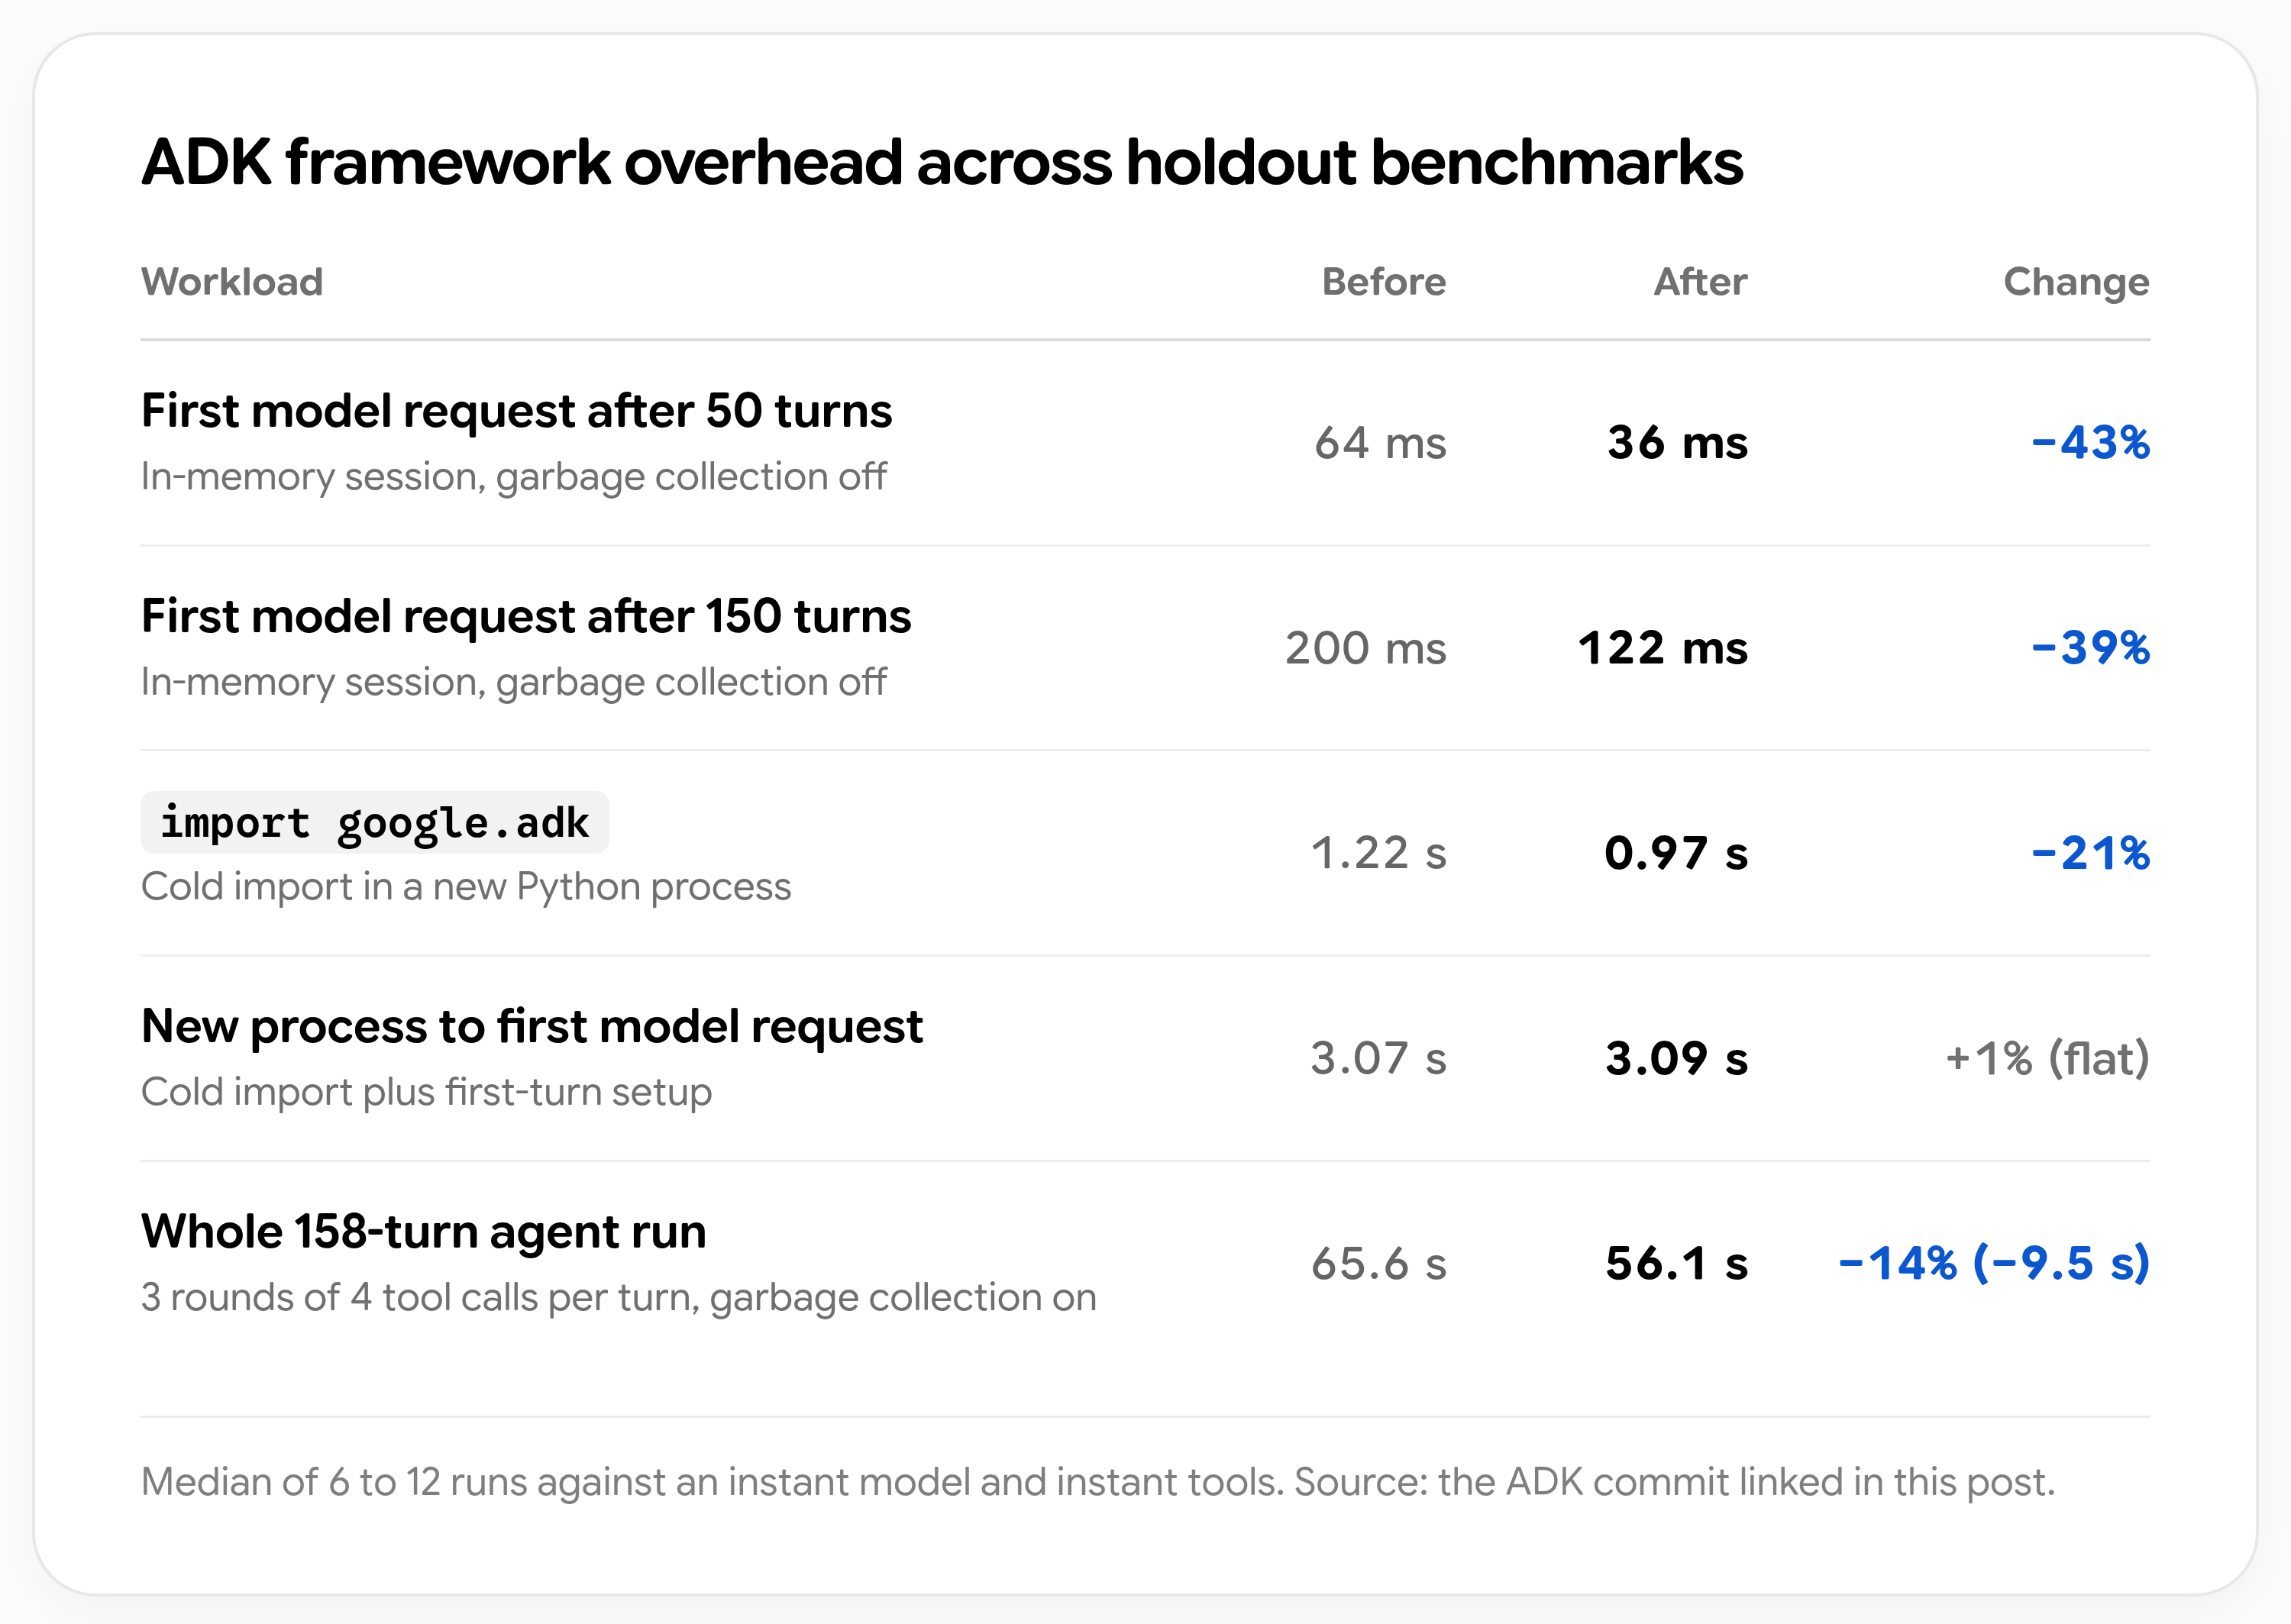
Fonte: Google Developers Blog, estudo de otimização do ADK. As medições usam um modelo instantâneo e ferramentas para isolar a sobrecarga do framework, com medianas de múltiplas execuções.
| Medição | Antes | Depois | Alteração relatada |
|---|---|---|---|
| Primeira solicitação ao modelo após 50 turnos | 64 ms | 36 ms | 43% mais rápido |
| Primeira solicitação ao modelo após 150 turnos | 200 ms | 122 ms | 39% mais rápido |
| Importação a frio | 1,22 s | 0,97 s | 21% mais rápido |
| Novo processo até a primeira solicitação | 3,07 s | 3,09 s | Essencialmente estável |
| Execução completa de 158 turnos | 65,6 s | 56,1 s | 14% mais rápido |
O ganho de aproximadamente 40% refere-se a um caminho de preparação de sessão no serviço em memória testado. Ele não deve ser descrito como se tornasse toda aplicação ADK 40% mais rápida, especialmente quando uma implantação usa outro backend de armazenamento ou passa a maior parte do tempo aguardando respostas do modelo e de ferramentas.
As importações a frio melhoraram, mas o tempo entre o início do processo e a primeira solicitação não melhorou. Isso é um lembrete prático para medir o fluxo de trabalho visível ao usuário em vez de presumir que uma otimização local melhora todas as métricas de ponta a ponta.
A alteração proposta passou em todos os 16.892 testes unitários públicos, mas 25 alvos de testes internos falharam porque era esperado que importações removidas continuassem podendo receber patches. Os mantenedores resolveram a compatibilidade com acessadores preguiçosos, em vez de tratar uma execução positiva de testes públicos como prova suficiente de segurança.
Outras alterações propostas foram rejeitadas por razões que incluíam dados em cache desatualizados, dependência de um atributo privado do OpenTelemetry, menor legibilidade sem benefício de ponta a ponta e uma otimização cujo ganho apareceu apenas em uma carga de trabalho sintética.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Isso torna o exemplo mais útil do que uma história de sucesso de programação sem supervisão. O modelo produziu melhorias candidatas; os mantenedores avaliaram as evidências, rejeitaram patches inadequados e corrigiram um problema de compatibilidade antes de incorporar o trabalho aceito.
O Google também informa uma otimização da inferência do Gemma 4 E2B usando vLLM em uma NVIDIA A100. Nessa configuração específica, o throughput aumentou de 37.900 para 108.000 tokens por segundo, um ganho relatado de 2,85 vezes com paridade de tokens.
Esse é um resultado específico de configuração. Ele não estabelece o mesmo ganho de velocidade para outro modelo, GPU, padrão de lote ou stack de implantação, e não deve ser confundido com o preço ou a latência de uma solicitação da API hospedada do Argon.
As demonstrações criativas do lançamento incluem um templo tridimensional construído com Blender e crítica visual, além de uma experiência de corrida inspirada em uma foto de mesa e montada com várias ferramentas. Esta última combina Blender MCP, texturas geradas, Three.js e recursos adicionais de mídia; portanto, o artefato final é o resultado de um fluxo de trabalho, e não evidência de que uma única chamada de texto simples cria todos os ativos sem ajuda.
Esses exemplos mostram os tipos de projetos que o Google quer que os desenvolvedores tentem. Eles não substituem testes diretos de código gerado, comportamento físico, licenciamento de ativos ou desempenho em um navegador.
O lançamento vai além da engenharia de software para vários domínios de pesquisa. Cada resultado aborda um problema mais restrito do que o nome de seu campo pode sugerir.
A demonstração de robótica segue o mesmo padrão. O robô Apollo do Google observa uma pessoa jogando cornhole, cria uma simulação e depois completa sete acertos consecutivos no mundo real na demonstração relatada. Isso é evidência sobre a execução exibida, não uma estimativa de confiabilidade para robôs, ambientes ou tarefas físicas arbitrários.
O Google afirma que as submissões internas de código aumentaram 35% e que as taxas de reversão caíram aproximadamente um terço. Esses são números internos relatados pela empresa; o artigo de lançamento não os apresenta como uma previsão controlada do que outra organização alcançará.
O caso do ADK oferece uma maneira mais prática de avaliar a alegação mais ampla. Comece com uma tarefa cuja linha de base seja mensurável, mantenha testes e verificações de compatibilidade e avalie o patch final aceito. O tempo gasto revisando e corrigindo uma alteração também faz parte do resultado.
Para trabalho de pesquisa, a questão correspondente é se a saída resiste à verificação relevante de domínio: uma prova, um experimento de laboratório, um cálculo independente ou uma avaliação cuidadosamente projetada. Uma explicação plausível do modelo é apenas uma etapa desse processo.
A página de preços do AI Studio verificada em 15 de outubro de 2026 não lista nenhum nível gratuito para gemini-4-argon. O acesso por assinatura para consumidores e o acesso à API para desenvolvedores têm condições diferentes; portanto, não se deve presumir que um recurso de consumo do Google AI Pro inclua o modelo de API.
As tarifas padrão introdutórias documentadas são de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, incluindo raciocínio, até 30 de novembro de 2026. A partir de 1º de dezembro, a página lista US$ 4 e US$ 20, respectivamente; a entrada de cache implícito elegível é cobrada separadamente, e cobranças de ferramentas podem se somar ao total.
Não. O Google documenta um orçamento compartilhado de 1.048.576 tokens para entrada, raciocínio e saída. Portanto, uma entrada mais longa deixa menos espaço para as outras partes da interação.
A documentação de decodificação longa exige modo em segundo plano, armazenamento e um valor de max_output_tokens acima do limite habitual. Os saltos de continuação continuam sujeitos ao orçamento compartilhado e ao comportamento de cobrança documentado; por isso, as aplicações devem seguir as instruções atuais da API Interactions.
Não. O resultado de aproximadamente 40% refere-se a um caminho específico de preparação de sessão em memória no benchmark do Google. A execução completa de 158 turnos melhorou 14%, enquanto o tempo entre um novo processo e a primeira solicitação permaneceu essencialmente inalterado.
Não. Os resultados relatados dizem respeito a problemas de pesquisa e demonstrações definidos. Eles exigem a validação independente apropriada, revisão de domínio e testes de implantação antes de serem generalizados para uso clínico, industrial ou no mundo físico.
O Gemini 4 Argon reúne um amplo conjunto de capacidades relatadas para código, projetos visuais e pesquisa. Seus detalhes práticos imediatos incluem acesso pago para desenvolvedores, preços introdutórios que terminam após novembro e um orçamento de contexto compartilhado que inclui raciocínio e saída.
A evidência de engenharia mais sólida vem das alterações aceitas e testadas no ADK e de seus limites medidos, com a revisão humana permanecendo parte do resultado.
Comece com uma frase e tenha um site completo em minutos.



