For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
Um novo nome de modelo da Z.ai apareceu discretamente no ZCode: **GLM-5.3 Highspeed**.
Um novo nome de modelo da Z.ai apareceu discretamente no ZCode: GLM-5.3 Highspeed.
O modelo surgiu no ZCode 3.15.1, no qual alguns assinantes estão sendo selecionados aleatoriamente para um teste do HighSpeed. Um usuário, @leo114119, publicou uma execução que mostrou uma velocidade de saída próxima de 490 tokens por segundo, com outra captura de tela indicando aproximadamente 493 tok/s.
Esse é um número impressionante.
Se um modelo pudesse sustentar 490 tokens de saída por segundo, gerar 10.000 tokens de saída levaria apenas cerca de:
10.000 / 490 ≈ 20,4 segundos
Esse cálculo cobre apenas a fase de geração de tokens. Ele não inclui o tempo até o primeiro token, o raciocínio antes da saída visível, chamadas de ferramentas, sobrecarga de rede ou pausas em um fluxo de trabalho de agente.
Mais importante ainda: o resultado de 490 TPS é atualmente uma observação da comunidade, e não uma garantia oficial de throughput da Z.ai.
O que está confirmado é que o ZCode 3.15.1 introduziu um teste aleatório de GLM HighSpeed para assinantes, e que o identificador glm-5.3-highspeed já está presente no catálogo público de modelos do Pi.
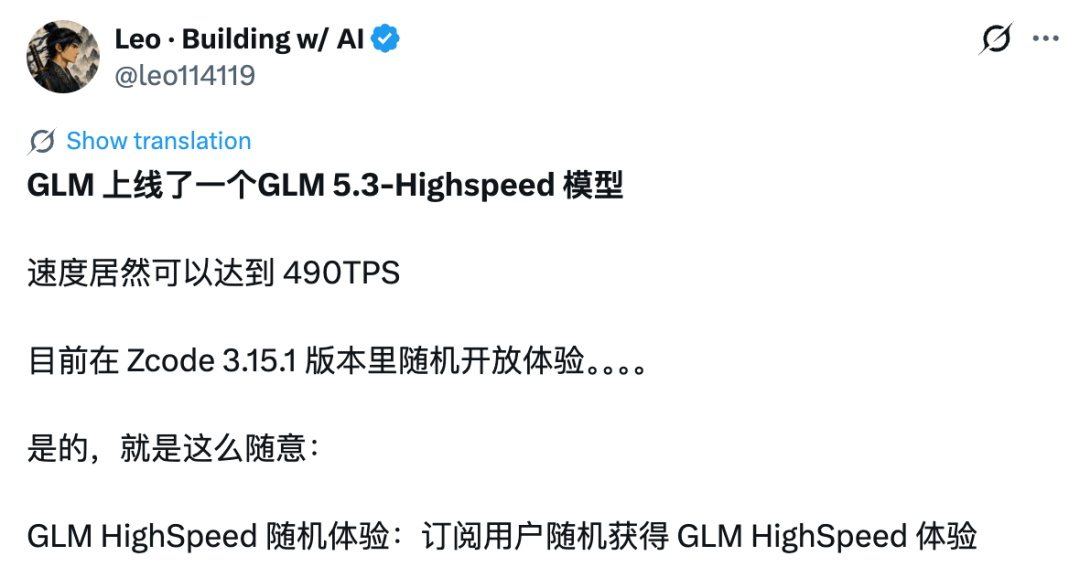
A primeira pista não é apenas uma captura de tela de redes sociais.
As notas oficiais de lançamento do ZCode para a versão 3.15.1 dizem:
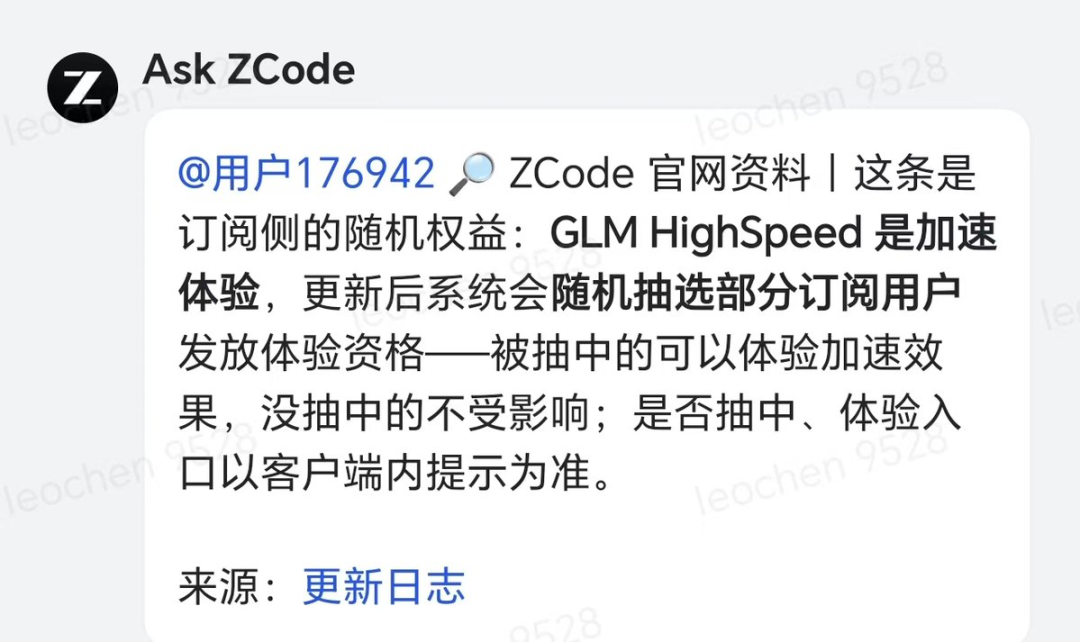
Agora os assinantes podem ser selecionados aleatoriamente para um teste do GLM HighSpeed.
Essa formulação importa porque explica por que o acesso é inconsistente entre contas.
O artigo de origem informa que o autor tentou adicionar e alternar manualmente para o GLM-5.3 Highspeed, mas não conseguiu utilizá-lo com uma assinatura Lite.
A interface mostrava que o modelo existia, mas o plano atual não incluía acesso.
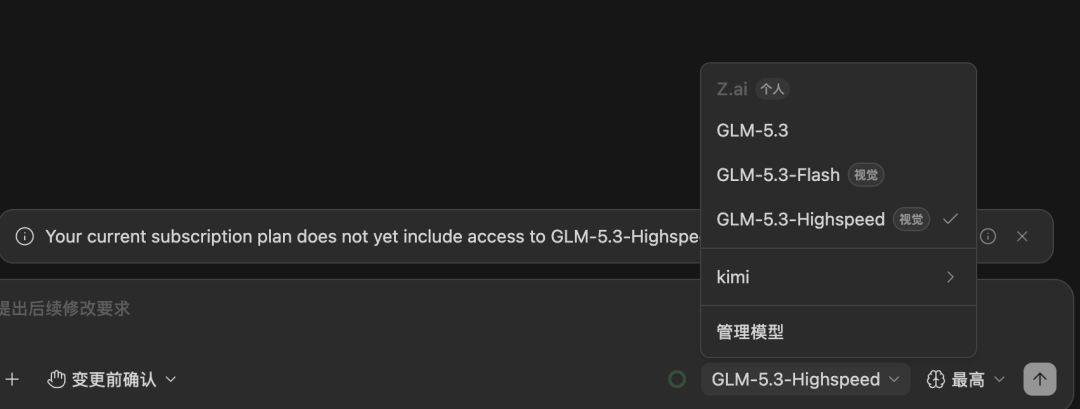
Isso é consistente com a estratégia atual de lançamento do ZCode:
Atualizar para o ZCode 3.15.1
        ↓
Conta de assinante
        ↓
Elegibilidade aleatória para o teste HighSpeed
        ↓
O acesso de teste aparece no cliente se a conta for selecionada
Atualmente, ele não é descrito como um recurso disponível automaticamente em todas as faixas pagas.
Uma captura de tela da comunidade que resume a formulação do próprio ZCode reforça o mesmo ponto: a experiência HighSpeed é um benefício atribuído aleatoriamente a assinantes, e o cliente é a fonte de verdade para saber se uma conta específica foi selecionada.
A principal razão pela qual o modelo atraiu atenção é a captura de tela de velocidade.
O usuário de origem publicou uma execução mostrando aproximadamente 493 tok/s.
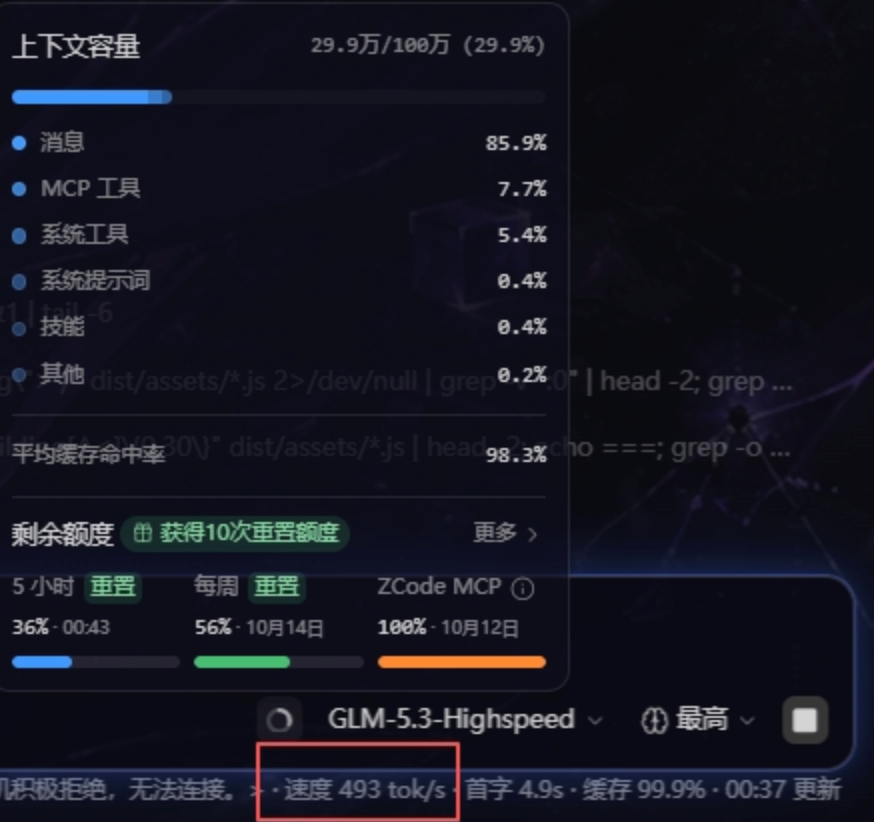
Esse valor está próximo o suficiente do número de 490 TPS no título do artigo para que a diferença não seja relevante.
Ainda assim, é útil ser preciso sobre o que essa captura de tela nos diz e o que ela não diz.
GLM-5.3-Highspeed.O throughput pode depender fortemente de:
Portanto, a conclusão correta por enquanto é:
O GLM-5.3 Highspeed demonstrou throughput de saída muito alto em pelo menos um teste público do ZCode, mas a Z.ai ainda não publicou uma especificação formal de 490 TPS.
O número se destaca porque a família GLM já possui múltiplas opções de serving orientadas à velocidade.
A documentação da Z.ai afirma que o GLM-5.3-FlashX pode alcançar até 200 tokens/s. O FlashX é a variante de serving de alta velocidade do GLM-5.3-Flash.
A documentação do Pi e da Z.ai lista o GLM-5.3-Flash com uma janela de contexto de 1M e saída máxima na classe de 128K, enquanto o FlashX se concentra em menor latência de serving e geração mais rápida.
O artigo original também cita uma medição da Artificial Analysis de aproximadamente 60 tokens/s para o GLM-5.3-Flash na API primária da Z.ai no momento da redação.
Medições independentes de throughput variam ao longo do tempo, e snapshots posteriores apresentaram variações relevantes conforme o provedor e a data. Portanto, um único número não deve ser tratado como permanente.
Uma comparação útil é, assim:
| Modelo / caminho de serving | Velocidade relatada ou documentada | Status |
|---|---|---|
| GLM-5.3 Highspeed no ZCode | ~490–493 tok/s em uma captura de tela de usuário | Observação da comunidade / teste aleatório |
| GLM-5.3-FlashX | Até 200 tok/s | Variante orientada à velocidade documentada publicamente |
| GLM-5.3-Flash na API da Z.ai | Muito menor em snapshots independentes de primeira parte | A medição independente varia conforme data/provedor |
A diferença é grande o bastante para que as pessoas naturalmente queiram saber o que “Highspeed” realmente significa.
glm-5.3-highspeedO nome do modelo não apareceu apenas no ZCode.
O catálogo público de modelos do Pi já tem uma página para GLM-5.3 Highspeed.
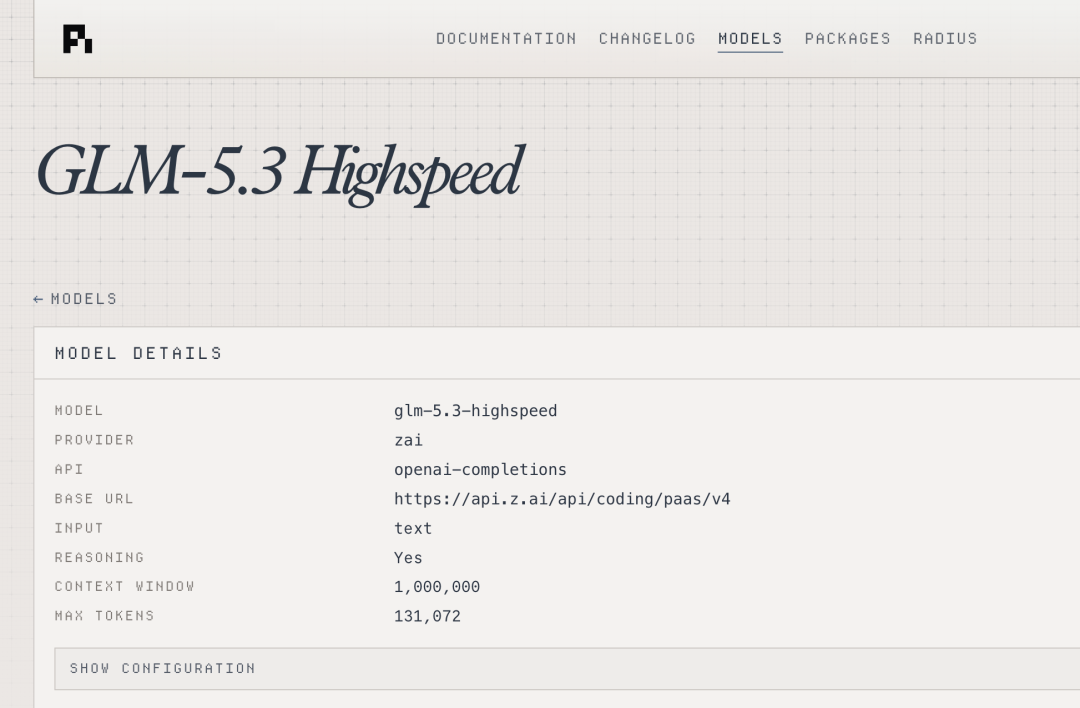
A configuração listada é:
| Campo | Valor |
|---|---|
| ID do modelo | glm-5.3-highspeed |
| Provedor | zai |
| Estilo de API | Completions compatíveis com OpenAI |
| Entrada | Texto |
| Raciocínio | Sim |
| Janela de contexto | 1.000.000 de tokens |
| Saída máxima | 131.072 tokens |
| Níveis de raciocínio | low / high / max |
O endpoint mostrado pelo Pi é:
https://api.z.ai/api/coding/paas/v4
O Pi também mapeia o modelo para o formato de API de programação da Z.ai.
Dois detalhes são especialmente notáveis.
Isso corresponde à configuração de contexto longo observada nas ferramentas atuais da família GLM-5.3.
Para agentes de programação, um contexto de 1M de tokens pode ser útil para:
Isso equivale aproximadamente a 128K tokens.
Novamente, isso é consistente com a configuração atual de saída longa de várias entradas da família GLM-5.3.
Portanto, a listagem do Pi não sugere uma arquitetura de contexto obviamente diferente da linha GLM-5.3 normal.
Ela confirma principalmente que o identificador Highspeed é real o bastante para ter uma configuração estruturada de provedor.
O Pi mapeia três configurações ativas de raciocínio:
low
high
max
O artigo de origem observa que essas configurações também são familiares na configuração regular do GLM-5.3.
Isso nos dá mais um motivo para não presumir que o Highspeed seja um modelo-base inteiramente novo.
Ele poderia ser:
Sem um cartão de modelo da Z.ai, essas possibilidades ainda não podem ser separadas com confiança.
O nome por si só não é suficiente.
É aqui que a história se torna especulativa.
Antes de as capturas de tela do ZCode aparecerem, usuários do Reddit já haviam notado glm-5.3-highspeed no catálogo do Pi e perguntado se ele poderia estar ligado ao Omen Alpha.
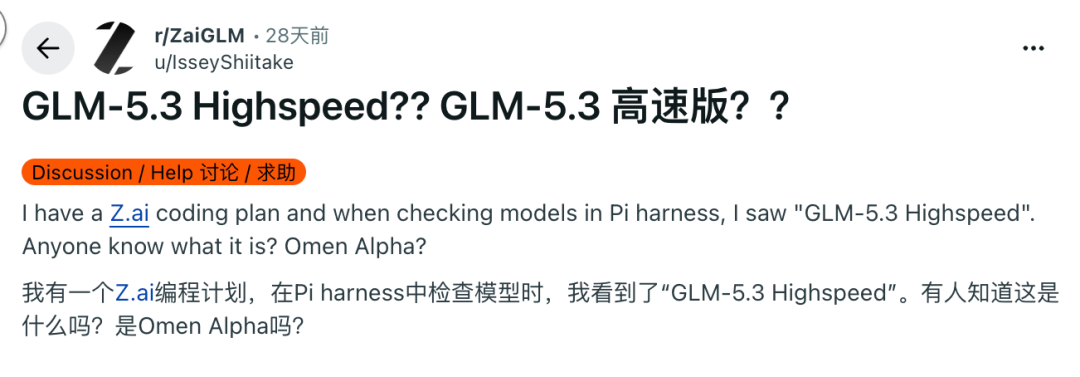
Omen Alpha é um modelo anônimo que surgiu em testes do OpenCode.
Membros da comunidade já o haviam associado à Zhipu/Z.ai com base no comportamento observado e em pistas de infraestrutura.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Uma resposta no Reddit especulou que ele poderia ser uma nova variante GLM de alta velocidade, com qualidade próxima à do GLM-5.3-Flash, mas throughput muito maior.
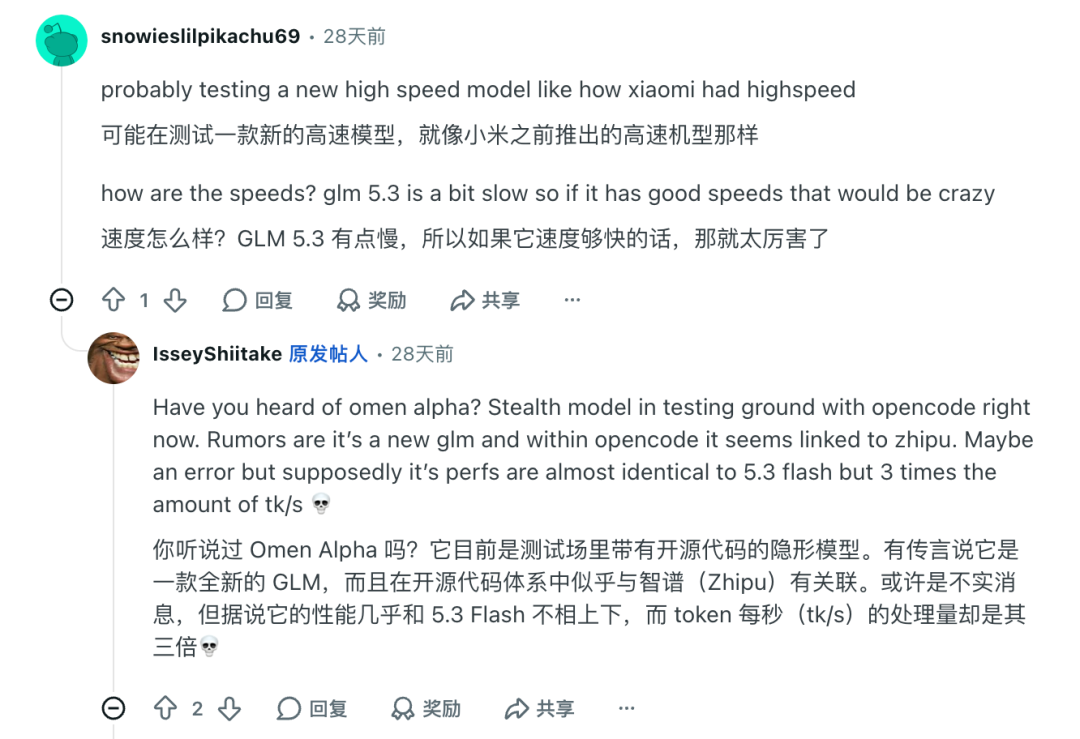
Outra captura de tela de uma fonte mostra uma entrada do modelo omen-alpha conectada a um rótulo de provedor relacionado à Zhipu, o que ajudou a alimentar a teoria.
Mas nada disso estabelece a identidade de forma conclusiva.
O artigo original lista várias hipóteses:
Esses nomes devem permanecer na categoria de especulação da comunidade até que a Z.ai publique um mapeamento oficial.
Dois endpoints podem parecer muito semelhantes mesmo quando não são o mesmo modelo.
O comportamento observado pode ser afetado por:
Assim, a semelhança comportamental é uma evidência, mas não uma prova.
O próprio nome não é incomum para a Zhipu.
A empresa já lançou versões de alta velocidade de modelos GLM anteriormente.
O artigo de origem aponta o GLM-5.1-highspeed, promovido com velocidade de saída em torno de 400 tokens/s em maio de 2026.
A família GLM-5.3 mais recente também possui o FlashX, uma variante pública orientada à velocidade e documentada com até 200 tokens/s.
Isso sugere um padrão de produto mais amplo:
Modelo-base ou modelo principal
        ↓
Caminho de serving de alta velocidade
        ↓
Menor latência / maior throughput para cargas de trabalho interativas
Esse padrão torna um produto GLM-5.3 Highspeed tecnicamente plausível, mesmo sem presumir pesos de modelo novos.
Isso continua sendo uma inferência, e não uma descrição oficial do produto.
Por que se importar com 490 TPS?
Para uma resposta curta de 200 tokens, a diferença entre 100 TPS e 500 TPS é de apenas alguns segundos.
Para saídas longas de agentes, geração de código ou raciocínio detalhado, a diferença se torna muito maior.
Por exemplo:
| Comprimento da saída | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1.000 tokens | 10,0 s | 5,0 s | ~2,0 s |
| 5.000 tokens | 50,0 s | 25,0 s | ~10,2 s |
| 10.000 tokens | 100,0 s | 50,0 s | ~20,4 s |
Esses são apenas cálculos simplificados do tempo de decodificação.
Tarefas reais de agentes também incluem:
Ainda assim, uma decodificação mais rápida pode tornar fluxos de trabalho iterativos longos muito mais responsivos.
Isso é especialmente relevante em agentes de programação como o ZCode, em que uma solicitação de usuário pode gerar várias chamadas ao modelo, e não apenas uma resposta final.
A captura de tela de ~493 tok/s também mostra uma taxa de acerto de cache extremamente alta.
Vale a pena observar isso.
Uma taxa alta de acerto de cache pode reduzir a quantidade de processamento repetido de prompt necessária em sessões longas de agentes.
Uma sessão típica de programação pode carregar repetidamente:
instruções do sistema
+ contexto do repositório
+ definições de ferramentas
+ conversa anterior
+ diferenças recentes
Se grande parte desse contexto for reutilizada de forma eficiente, o sistema poderá gastar menos tempo recalculando o lado de entrada de cada turno.
No entanto, o número exibido de tok/s normalmente se refere ao throughput de geração de saída, e não apenas ao throughput do cache de prompt.
O número de cache ainda importa porque a latência total da sessão pode parecer muito melhor quando a reutilização de prompt e a decodificação rápida funcionam bem juntas.
Esse é mais um motivo pelo qual uma única captura de tela não pode caracterizar totalmente o modelo.
O GLM-5.3-FlashX oferece a comparação pública mais clara porque a documentação da Z.ai já o descreve como um modelo orientado à velocidade.
As informações publicadas atualmente para o FlashX incluem:
glm-5.3-flashx.O FlashX demonstra, portanto, que a Z.ai já está disposta a criar variantes dedicadas de alto throughput sem apresentá-las como gerações de inteligência completamente novas.
O GLM-5.3 Highspeed pode seguir a mesma lógica de produto em uma camada de serving ainda mais rápida.
Isso continua sendo uma inferência, e não uma descrição oficial do produto.
As evidências atuais podem ser separadas em três níveis de confiança.
glm-5.3-highspeed como um modelo da Z.ai.Essa distinção é a maneira mais segura de interpretar o lançamento atual.
GLM-5.3 Highspeed é um identificador de modelo da Z.ai que apareceu no ZCode e no catálogo público de modelos do Pi. O ZCode 3.15.1 confirma oficialmente um teste aleatório de GLM HighSpeed para assinantes, mas a Z.ai ainda não publicou um cartão de modelo independente e completo para o GLM-5.3 Highspeed nas fontes verificadas aqui.
Uma captura de tela pública de um usuário mostra aproximadamente 493 tok/s em uma execução do ZCode, que é a base para o título de 490 TPS. É uma observação útil, mas não uma garantia oficial de throughput sustentado; ela pode variar conforme a carga de trabalho, o comportamento de cache, a região e as condições do servidor.
O Pi atualmente lista uma janela de contexto de 1.000.000 de tokens e uma saída máxima de 131.072 tokens para glm-5.3-highspeed. Esses valores são semelhantes à configuração de contexto longo de outros modelos atuais da família GLM-5.3.
Não. O changelog oficial v3.15.1 do ZCode informa que os assinantes são selecionados aleatoriamente para o teste GLM HighSpeed. Se sua conta não for selecionada, ver o nome do modelo não significa necessariamente que você poderá executá-lo.
Não há confirmação oficial de que sejam o mesmo produto. O FlashX é uma variante pública de alta velocidade do GLM-5.3-Flash, documentada com até 200 tok/s, enquanto o GLM-5.3 Highspeed aparece atualmente por meio de testes do ZCode e do catálogo de provedores de programação do Pi.
Isso continua sendo especulação. Usuários do Reddit e do OpenCode conectaram o Omen Alpha à Zhipu/Z.ai, mas não há fonte oficial confirmando que o Omen Alpha corresponde a glm-5.3-highspeed.
Agentes de programação frequentemente fazem várias chamadas longas ao modelo ao ler arquivos, escrever patches, executar ferramentas e revisar resultados. Um throughput de decodificação maior pode reduzir o tempo de espera entre essas etapas, especialmente quando o modelo produz milhares de tokens por chamada.
Use o cliente atual do ZCode após atualizar para uma versão que inclui o teste. As próprias notas de lançamento do ZCode dizem que o acesso é atribuído aleatoriamente a assinantes, portanto a interface da conta/do cliente é a fonte prática de verdade para a elegibilidade.
glm-5.3-highspeed.O GLM-5.3 Highspeed deixou de ser apenas um nome de modelo isolado: o ZCode 3.15.1 confirma oficialmente um teste aleatório de GLM HighSpeed para assinantes, e o Pi já expõe uma configuração estruturada de glm-5.3-highspeed com uma janela de contexto de 1M de tokens e limite de saída de 131.072 tokens.
O chamativo número de 490–493 tok/s vem de uma captura de tela pública real, mas continua sendo uma observação de usuário, e não uma garantia formal de throughput da Z.ai. A interpretação mais segura é que a Z.ai está testando um caminho de serving de programação muito rápido e ainda não publicou a especificação completa do produto.
A conexão com o Omen Alpha continua sem solução. Ela pode se revelar relacionada, mas as evidências atuais são circunstanciais e orientadas pela comunidade, e não oficiais.
O que está confirmado hoje é o lançamento do teste e o identificador do modelo; o que ainda não está confirmado é a arquitetura exata, o preço público, o throughput sustentado e se o Omen Alpha é o mesmo modelo.
Comece com uma frase e tenha um site completo em minutos.



