For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/google-android-bench-harbor-claude-fable-5.md.
A atualização do Android Bench da Google é mais do que uma renovação do ranking. Ao migrar para o framework Harbor, o benchmark agora enfati...
O Google atualizou seu ranking de codificação Android Bench e migrou o fluxo de trabalho de benchmark para o framework Harbor. Essa atualização é relevante porque o Android Bench não é uma competição de codificação genérica. Ele foi projetado para testar como grandes modelos de linguagem lidam com tarefas reais de desenvolvimento Android, incluindo compreensão de código-fonte, geração de patches, APIs específicas do Android, sistemas de build e validação de testes.
Os novos resultados geram um sinal interessante para desenvolvedores. O Claude Fable 5 agora ocupa o topo do ranking atualizado, seguido pelo GPT 5.5, enquanto os modelos Gemini do próprio Google apresentam um perfil mais misto em termos de precisão, latência e custo. Para equipes que usam agentes de codificação com IA em projetos Android, a principal conclusão não é simplesmente "qual modelo venceu". É como o método de avaliação, o ambiente de sandbox, o custo e a latência juntos mudam a forma como o desempenho do modelo deve ser julgado.
Em 9 de julho, o Google anunciou uma grande atualização no Android Bench, seu benchmark e ranking para desenvolvimento Android assistido por IA. A mudança mais importante é a adoção do Harbor, um framework padronizado para executar tarefas de agentes em ambientes de sandbox.
Anteriormente, o Android Bench usava uma configuração de avaliação baseada no mini-swe-agent v1, adaptada para o desenvolvimento Android. Na nova versão, o Google migrou para o Harbor para tornar a execução do benchmark mais padronizada, isolada e reproduzível. O objetivo é facilitar para desenvolvedores e pesquisadores a realização de avaliações independentes, comparar diferentes configurações de agentes e compartilhar resultados de forma mais transparente.
O Google também disponibilizou as ferramentas do Android Bench como código aberto no GitHub. Isso dá à comunidade uma visão mais clara de como o benchmark funciona e abre portas para feedback, tarefas personalizadas de desenvolvimento Android e uma participação mais ampla na avaliação de modelos.
O framework por trás de um benchmark pode afetar o resultado. Isso é especialmente verdadeiro para agentes de codificação com IA, onde os modelos não apenas respondem perguntas; eles inspecionam repositórios, executam comandos, editam arquivos, chamam ferramentas e tentam satisfazer testes.
O Harbor é construído em torno da avaliação de tarefas de agentes em sandbox. Para o Android Bench, isso significa que as execuções dos modelos podem ser organizadas em um ambiente de execução mais controlado, em vez de depender de configurações locais ad hoc. Isso ajuda a reduzir ambiguidades ao comparar modelos e facilita a reprodução de uma avaliação específica.
A metodologia do Android Bench do Google também enfatiza problemas de desenvolvimento específicos do Android, em vez de tarefas genéricas de programação. O benchmark inclui trabalhos relacionados a áreas como Jetpack Compose, Coroutines e Flows, Room, Hilt, migração de navegação, configuração do Gradle,
Alterações no SDK, mídia, câmera, dispositivos dobráveis, permissões em tempo de execução e outras preocupações comuns da engenharia Android.
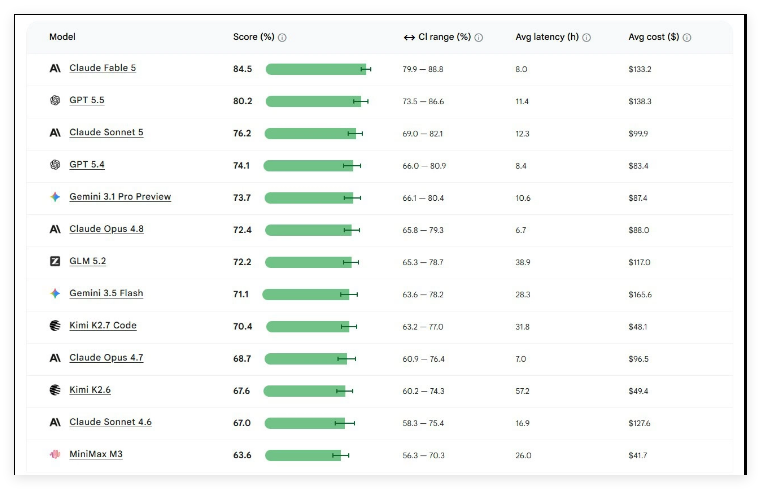
Após a mudança de metodologia, o Google reexecutou o benchmark e atualizou o leaderboard do Android Bench. De acordo com os resultados atualizados, o Claude Fable 5 ocupa o primeiro lugar com 84,5% de pontuação. O GPT 5.5 vem em seguida com 80,2%, e o Claude Sonnet 5 fica em terceiro lugar com 76,2%.
Uma visão simplificada dos principais resultados é a seguinte:
| Classificação | Modelo | Pontuação | Intervalo de Confiança | Latência Média | Custo Médio |
|---|---|---|---|---|---|
| 1 | Claude Fable 5 | 84,5% | 79,9–88,8 | 8,0 h | $133,2 |
| 2 | GPT 5.5 | 80,2% | 73,5–86,6 | 11,4 h | $138,3 |
| 3 | Claude Sonnet 5 | 76,2% | 69,0–82,1 | 12,3 h | $99,9 |
| 4 | GPT 5.4 | 74,1% | 66,0–80,9 | 8,4 h | $83,4 |
| 5 | Gemini 3.1 Pro Preview | 73,7% | 66,1–80,4 | 10,6 h | $87,4 |
| 6 | Claude Opus 4.8 | 72,4% | 65,8–79,3 | 6,7 h | $88,0 |
| 7 | GLM 5.2 | 72,2% | 65,3–78,7 | 38,9 h | $117,0 |
| 8 | Gemini 3.5 Flash | 71,1% | 63,6–78,2 | 28,3 h | $165,6 |
Esses números devem ser interpretados como resultados específicos do benchmark. Eles não provam que um modelo é universalmente melhor em todas as tarefas de codificação. Eles mostram o desempenho de cada modelo no ambiente de avaliação específico e atualizado do Google para Android.
A classificação atualizada é notável porque os próprios modelos do Google não lideram a tabela. O Gemini 3.1 Pro Preview ocupa o quinto lugar com uma pontuação de 73,7%. Seu custo médio relatado é menor que o de vários modelos com melhor classificação, mas sua precisão fica atrás do Claude Fable 5, GPT 5.5, Claude Sonnet 5 e GPT 5.4.
O Gemini 3.5 Flash é ainda mais interessante. Ele é posicionado como um modelo mais leve, mas neste benchmark mostra uma latência média alta de 28,3 horas e um custo médio de $165,6 por execução completa do benchmark. Isso o torna menos atraente nesta avaliação específica, apesar da expectativa geral de que modelos mais leves deveriam ser mais rápidos e baratos.
A lição maior é simples: a seleção de modelos para agentes de codificação não pode ser baseada apenas em marca, família de modelos ou preço por token. Um modelo que parece econômico no uso normal de chat pode se comportar de forma muito diferente quando solicitado a resolver 100 tarefas reais de desenvolvimento Android envolvendo chamadas de ferramentas, edições de repositório e execuções de teste.
O Android Bench foi projetado para avaliar se um LLM pode atuar como um desenvolvedor Android prático. Ele fornece ao modelo descrições de problemas do mundo real e pede que ele gere alterações de código que resolvam o problema. O patch resultante é então verificado em uma configuração de validação.
A metodologia do Google afirma que o benchmark inclui 100 tarefas selecionadas de um conjunto muito maior de pull requests. A seleção foca em repositórios Android e fluxos de trabalho reais de desenvolvimento, incluindo casos envolvendo Kotlin, Java, Jetpack Compose, Views tradicionais, aplicativos, bibliotecas, alterações pequenas e direcionadas e modificações maiores de código.
Isso torna o Android Bench diferente de simples testes de conclusão de código. Ele está mais próximo de uma avaliação de engenharia de software agentiva, onde o modelo precisa entender o repositório, fazer uma alteração apropriada e passar pela verificação automatizada.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Codificação de IA
workflows estão evoluindo de snippets de código baseados em prompts para agentes autônomos ou semiautônomos. Em um projeto Android real, um agente precisa navegar pela estrutura do projeto, entender restrições de compilação, editar vários arquivos com segurança, lidar com mudanças de API e executar testes sem quebrar o comportamento existente.
Um benchmark como o Android Bench ajuda desenvolvedores a avaliar modelos nesse tipo de workflow. Ele também torna visíveis o custo e a latência. Para uso em produção, o melhor modelo nem sempre é o com a pontuação mais alta. Uma equipe pode preferir uma pontuação ligeiramente menor se o modelo for muito mais rápido, mais barato ou mais estável dentro do seu próprio ambiente de desenvolvimento.
A atualização também reforça um ponto mais amplo: a metodologia de benchmark deve evoluir conforme os agentes de IA evoluem. Chamadas de ferramentas, sandboxing, rastreamentos de execução, reprodutibilidade e rastreamento de custos agora fazem parte da avaliação, não são extras opcionais.
O Android Bench é o benchmark do Google para avaliar grandes modelos de linguagem em tarefas de desenvolvimento Android. Ele foca em problemas reais de engenharia Android, em vez de triviais de codificação geral ou questões de algoritmos isoladas.
O Google moveu o Android Bench para o framework Harbor para padronizar a execução de benchmarks em ambientes isolados (sandbox). Isso ajuda a tornar as avaliações mais fáceis de reproduzir, comparar e compartilhar em diferentes configurações de modelo e agente.
No ranking atualizado descrito no artigo fonte e na página do Android Bench do Google, o Claude Fable 5 ocupa o primeiro lugar com 84,5% de pontuação. O GPT 5.5 vem em seguida com 80,2%, enquanto o Claude Sonnet 5 ocupa o terceiro lugar.
Não necessariamente. O Android Bench mede o desempenho de codificação específico para Android sob uma configuração de benchmark definida. Um modelo com melhor desempenho aqui pode não ser a melhor escolha para desenvolvimento web, engenharia de dados, DevOps ou outras tarefas de software.
A latência mostra quanto tempo um modelo leva para concluir as tarefas do benchmark. Para equipes de engenharia reais, uma pontuação alta só é útil se o modelo puder concluir o trabalho dentro de um período de tempo aceitável.
O custo é importante porque a codificação agentiva pode envolver muitas chamadas de ferramentas, contextos longos, inspeção de repositório e execuções repetidas de testes. Um modelo com alta precisão, mas custo muito elevado, pode ser menos prático para uso frequente em produção.
O repositório GitHub do Android Bench fornece ferramentas e instruções de configuração para avaliar modelos. A documentação oficial também orienta os desenvolvedores sobre o conjunto de dados e a metodologia para que possam entender ou reproduzir melhor o benchmark.
tarefas do agente.
A atualização do Android Bench do Google é mais do que uma simples atualização do leaderboard. Ao migrar para o framework Harbor, o benchmark agora enfatiza uma avaliação de agente Android reproduzível, isolada e específica.
O novo ranking coloca Claude Fable 5 no topo, seguido por GPT 5.5 e Claude Sonnet 5. O Gemini continua competitivo, mas não lidera o gráfico atualizado, e o Gemini 3.5 Flash mostra que modelos mais leves não são automaticamente mais rápidos ou baratos em avaliações de codificação agentiva.
Para desenvolvedores e equipes de IA, a principal conclusão é comparar precisão, latência, custo e metodologia de benchmark juntos. O Android Bench é melhor interpretado como um sinal prático para agentes de codificação Android, e não como um ranking universal de todos os modelos de IA.
Comece com uma frase e tenha um site completo em minutos.



