For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gpt-5-6-sol-cerebras-750-tokens-per-second.md.
O pico relatado de 750 tokens por segundo do GPT-5.6 Sol demonstra como a inferência de baixa latência pode transformar o comportamento prát...
O GPT-5.6 Sol está deslocando a conversa sobre modelos de fronteira, deixando de focar apenas em capacidade e passando a algo igualmente importante: a velocidade de resposta.
A OpenAI afirmou que o GPT-5.6 Sol pode ser executado na infraestrutura do Cerebras a até 750 tokens por segundo. Nessa velocidade, um sistema de IA não parece mais uma ferramenta que faz pausas após cada ação. Agentes de codificação, operadores de navegador, assistentes de pesquisa e sistemas de uso computacional podem percorrer fluxos de trabalho com múltiplas etapas com muito menos espera entre as decisões.
O número principal é oficial. Muitos dos detalhes arquitetônicos discutidos ao seu redor, no entanto, não são. As estimativas de que o modelo contém aproximadamente três trilhões de parâmetros, abrange de 70 a 100 sistemas em escala de wafer ou atribui uma camada de rede a cada wafer vêm de análises técnicas externas, e não de uma especificação publicada pela OpenAI.
Este artigo mantém essa distinção clara. Ele explica o que foi confirmado, o que permanece uma teoria de engenharia plausível e por que a combinação do GPT-5.6 com a inferência em escala de wafer é importante para a IA em tempo real.
[Imagem mostrando um anúncio de lançamento do GPT-5.6 Sol. O conteúdo é: "Também estamos lançando o GPT-5.6 Sol no Cerebras a 750 tokens por segundo em julho, trazendo inteligência de ponta para os clientes a uma velocidade sem precedentes. Inicialmente, estará limitado a clientes selecionados e, à medida que a capacidade aumentar, expandiremos o acesso." A imagem está localizada após o contexto que introduz o desempenho do GPT-5.6 Sol, sendo uma explicação adicional sobre a velocidade de execução do GPT-5.6 Sol no Cerebras, enfatizando sua vantagem de velocidade para o acesso do cliente.]
Uma taxa de transferência de 750 tokens por segundo é difícil de apreciar até que seja comparada com a forma como as pessoas realmente usam os sistemas de IA.
Uma resposta longa que antes aparecia linha por linha agora pode ser produzida quase que imediatamente. Mais importante ainda, o modelo pode percorrer raciocínios internos, chamadas de ferramentas, geração de código, ações de interface e decisões de acompanhamento muito mais rapidamente. O benefício não é simplesmente que o texto chega mais cedo. Todo o ciclo do agente se torna mais responsivo.
Essa mudança é importante em fluxos de trabalho como:
Para um chat convencional, um pequeno atraso pode ser aceitável. Para um agente que precisa clicar em um botão, inspecionar o resultado, revisar seu plano e continuar, cada viagem de ida e volta adiciona atrito. A inferência em alta velocidade reduz essa latência acumulada.
O desenvolvedor Caleb Shepherd destacou essa distinção na discussão em torno do GPT-5.6 Sol. O ganho mais importante não é apenas a geração de código mais rápida, mas o uso computacional mais rápido: um agente não deve mais precisar de minutos para concluir uma sequência de ações simples de interface.
[Imagem é um tweet publicado por Caleb Shepherd, datado de 6 de julho. O conteúdo do tweet é: "O que mais me empolga é o GPT-5.6 Sol no Cerebras. Ele não só melhora a velocidade de codificação, mas também a velocidade de uso do computador. Chega de esperar dois minutos para clicar em um botão." Abaixo do tweet, há 1 comentário, 5 compartilhamentos e 1,2K curtidas. A imagem está intimamente relacionada ao contexto, que apresenta o desempenho do GPT-5.6 Sol no Cerebras, e este tweet enfatiza ainda mais sua importante característica de melhorar a velocidade de uso do computador.]
Pergunta sobre o Tamanho do Modelo
A afirmação sobre a velocidade levantou imediatamente uma questão técnica: como um modelo multimodal de ponta pode ser executado tão rapidamente em hardware em escala de wafer?
A documentação pública da OpenAI descreve o GPT-5.6 Sol como o modelo de ponta da família GPT-5.6, com entrada de texto e imagem, uma janela de contexto de 1.050.000 tokens e até 128.000 tokens de saída. Ela não publica a contagem de parâmetros do modelo, a contagem de parâmetros ativos, a contagem de camadas, o design de atenção ou a topologia de implantação física.
Essa informação ausente levou desenvolvedores e especialistas em infraestrutura a raciocinar de trás para frente a partir do que se sabe sobre o hardware da Cerebras.
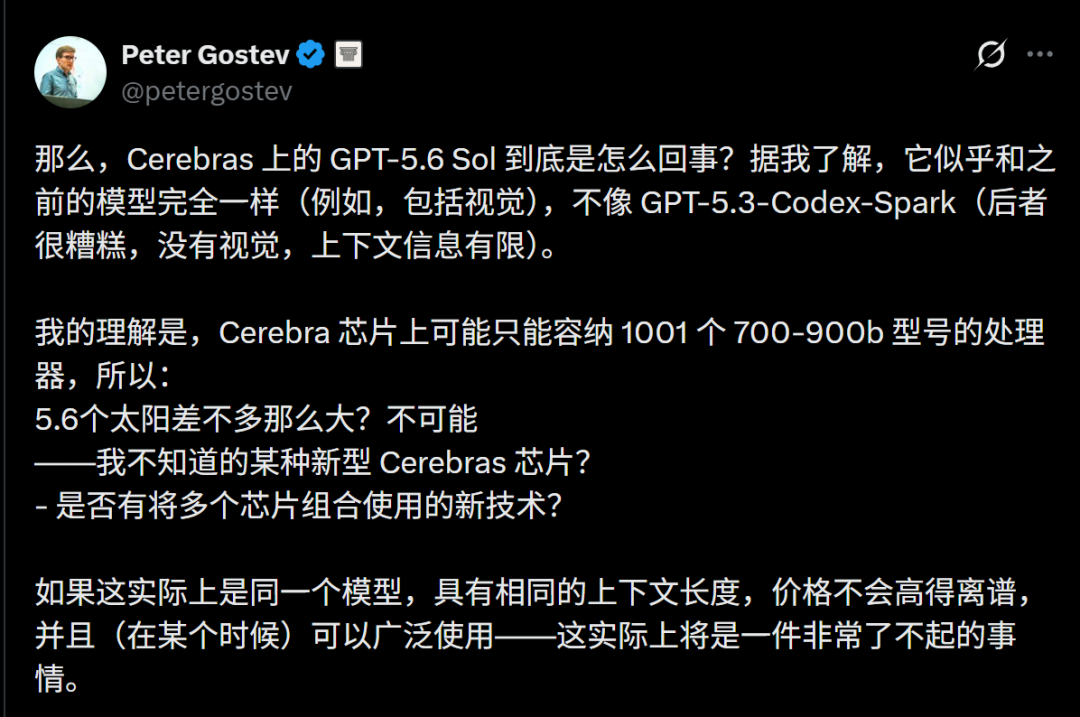
Peter Gostev resumiu o enigma central: se o GPT-5.6 Sol é o modelo multimodal completo, em vez de uma variante reduzida, ele pode ser grande demais para caber em um único sistema em escala de wafer. As possibilidades restantes incluem um modelo menor do que o esperado, uma nova configuração de hardware ou uma arquitetura de serviço com vários sistemas.
Uma estimativa amplamente discutida veio do especialista técnico Bleys Goodson. Sua análise propôs que o GPT-5.6 Sol poderia ter:
Esses números não são uma especificação oficial. São uma estimativa de engenharia baseada em restrições de serviço do modelo, requisitos de memória e na capacidade conhecida dos clusters Cerebras de distribuir modelos muito grandes por vários sistemas.
A parte marcante da teoria não é simplesmente a contagem de wafers. É o mapeamento proposto entre a arquitetura do modelo e o hardware.
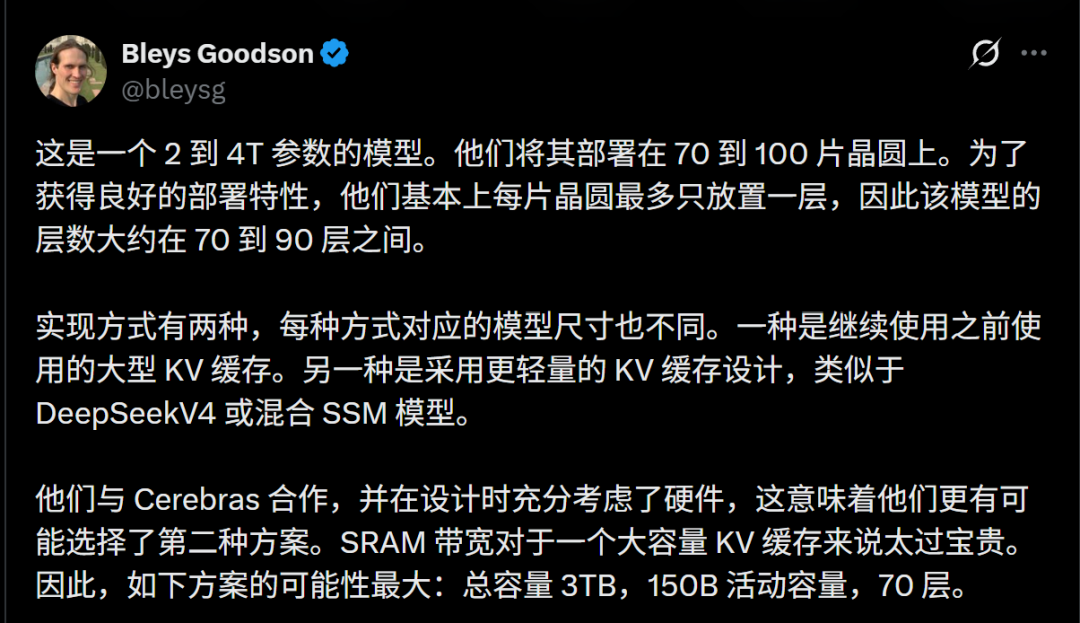
O design proposto dá a cada camada principal da rede seu próprio sistema em escala de wafer. As ativações se moveriam pelos wafers como um pipeline, enquanto cada wafer realiza o cálculo atribuído à sua camada.
Em uma implantação convencional de GPU distribuída, a execução do modelo pode envolver paralelismo de tensor complexo, paralelismo de especialistas e comunicação frequente entre nós. A sobrecarga de comunicação pode se tornar um sério gargalo, especialmente quando o modelo é grande e o alvo é baixa latência, em vez de rendimento máximo de lote.
Um pipeline de camada por wafer adota uma abordagem diferente. Uma vez que o pipeline esteja cheio, múltiplos tokens podem ser processados em diferentes estágios ao mesmo tempo. Adicionar estágios pode aumentar o
atraso antes do primeiro token aparecer, mas isso não reduz necessariamente a taxa de transferência de tokens em estado estacionário na mesma proporção.
Isso ajuda a explicar como um modelo extremamente grande poderia permanecer rápido após o início da geração. Também explica por que a implantação pode ser cara: alcançar alta velocidade sequencial pode exigir a dedicação de uma quantidade muito grande de hardware a uma única réplica do modelo.
O artigo de origem cita uma estimativa externa de tokenomics que modela o GPT-5.6 Sol como um sistema de três trilhões de parâmetros que requer cerca de 70 sistemas em escala de wafer sob um conjunto de suposições.
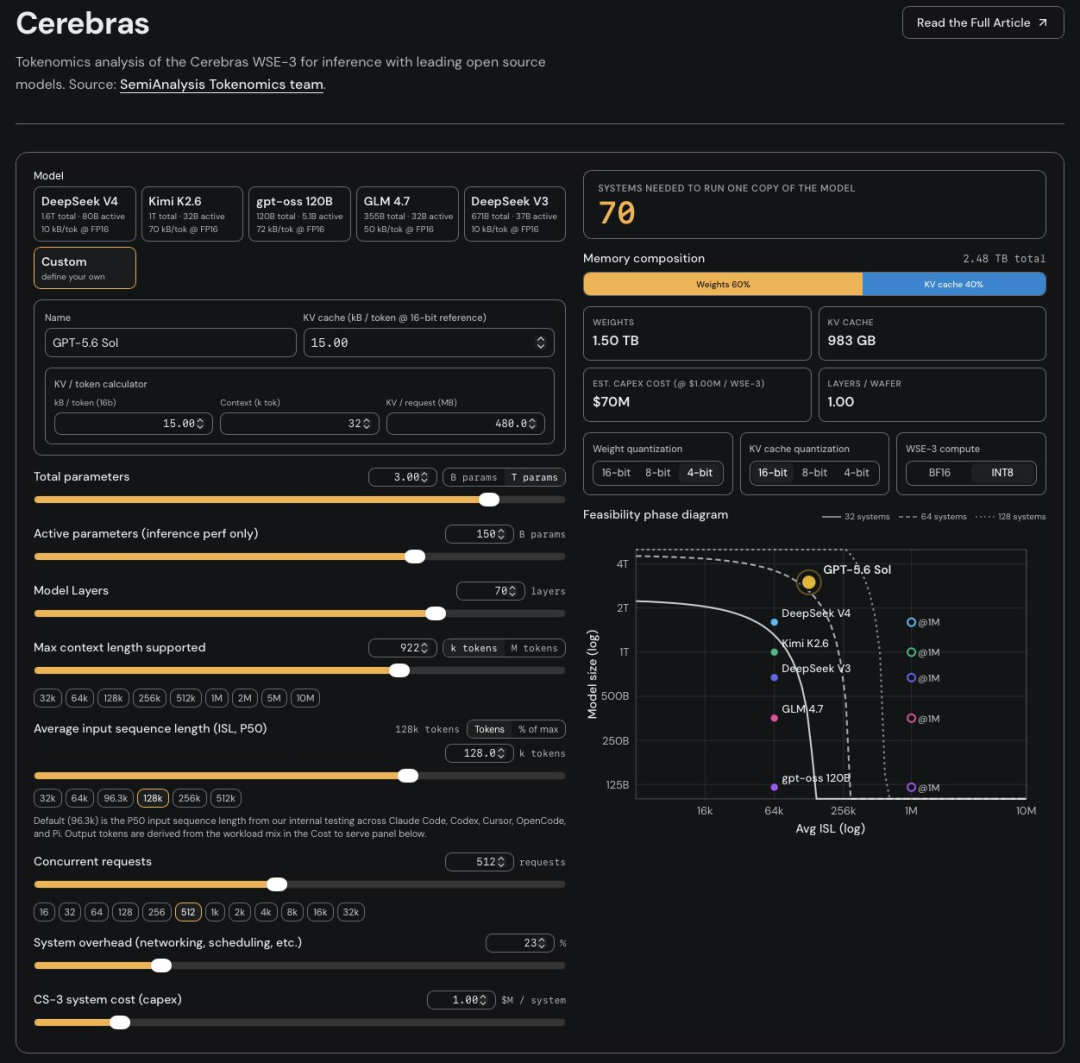
Importante: A estimativa de 70 a 100 wafers e a descrição de "um wafer por camada" permanecem especulações informadas. OpenAI e Cerebras não confirmaram publicamente essa topologia física.
A computação é apenas parte do problema. Modelos autorregressivos também mantêm um cache de chave-valor, comumente chamado de cache KV, para que possam reutilizar informações de tokens anteriores em vez de recomputar toda a sequência.
Para modelos de contexto longo, esse cache pode consumir uma grande quantidade de memória. O desafio se torna mais severo quando o sistema precisa suportar muitas requisições concorrentes.
Os processadores em escala de wafer da Cerebras incluem grandes quantidades de SRAM rápida no chip. Essa memória oferece largura de banda excepcional, mas ainda é um recurso limitado e valioso. Uma arquitetura de atenção convencional com uma grande pegada de cache KV poderia consumir muita capacidade e reduzir as vantagens de manter o trabalho próximo ao processador.
Isso leva à teoria de que o GPT-5.6 Sol pode usar uma arquitetura projetada em torno de requisitos de cache mais baixos. As possibilidades discutidas na fonte incluem:
O design exato é desconhecido. A OpenAI não publicou detalhes arquitetônicos suficientes para determinar qual, se houver, desses métodos é usado.
O que pode ser dito com confiança é que o codesign de hardware e software se torna cada vez mais importante nessa escala. Um modelo otimizado apenas para clusters de aceleradores genéricos pode deixar um desempenho significativo inutilizado em um sistema em escala de wafer.
Outra hipótese é que hardware diferente poderia lidar com partes diferentes do modelo.
A inferência do Transformer é dominada por duas amplas categorias de trabalho:
parâmetros
O desenvolvedor John Lam sugeriu que aceleradores convencionais podem lidar com a atenção, enquanto os sistemas Cerebras processam as camadas da rede feed-forward. Esse tipo de decomposição atenção-FFN poderia atribuir cada carga de trabalho à arquitetura de hardware mais adequada para ela.
[Descrição da imagem: tuíte de John Lam, datado de 6 de julho. O texto do tuíte diz: "Tenho certeza de que a Cerebras é usada para FFN, enquanto GPUs tradicionais são usadas para a 'decomposição atenção-FFN' ou AFD. Por exemplo, veja arxiv.org/html/2605.2830...". O tuíte está relacionado à discussão no documento sobre o GPT-5.6 Sol na Cerebras, levantando a hipótese de que diferentes hardwares podem processar diferentes partes do modelo, ou seja, sistemas Cerebras processariam as camadas FFN, enquanto GPUs tradicionais lidariam com a atenção, ecoando a exploração no documento sobre a classificação do trabalho do Transformer e diferentes hardwares lidando com diferentes cargas de trabalho.]
Novamente, isso é uma hipótese, e não um detalhe de implantação divulgado do GPT-5.6. É tecnicamente relevante porque sistemas de inferência heterogêneos estão se tornando mais práticos. Em vez de esperar que um acelerador execute todas as operações igualmente bem, os provedores podem dividir um modelo entre sistemas especializados de computação, memória e rede.
O custo é uma maior complexidade do sistema. Agendamento, transferência de ativações, tratamento de falhas e controle de latência tornam-se mais difíceis quando uma solicitação atravessa vários tipos de hardware.
A Cerebras já demonstrou que sistemas em escala de wafer podem servir modelos muito grandes de mistura de especialistas em velocidade excepcionalmente alta.
Em seu material oficial sobre o Kimi K2.6, a Cerebras descreve um modelo de peso aberto de um trilhão de parâmetros servido a quase 1.000 tokens por segundo. A empresa afirma que os pesos do modelo podem ser distribuídos por vários wafers enquanto as ativações fluem entre eles. Também descreve o armazenamento de pesos originais em menor precisão enquanto calcula em maior precisão, suportado por kernels personalizados e decodificação especulativa.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Esta é uma evidência importante de que a inferência em múltiplos wafers é real e operacional. Isso não prova que o GPT-5.6 Sol use a mesma configuração, a mesma estratégia de precisão ou o mesmo particionamento de modelo.
[Descrição da imagem: Documento da Cerebras sobre serviço de trilhão de parâmetros. Indica que o Wafer-Scale Engine da Cerebras é construído para escala, configurável para suportar treinamento e inferência de modelos com vários trilhões de parâmetros, e que um grande esforço de engenharia foi investido na otimização da pilha para servir modelos grandes de forma eficiente. O Kimi K2.6 realiza cálculos em ponto flutuante de 16 bits com os pesos originais de 4 bits do modelo para obter precisão ideal. Os pesos são distribuídos em vários wafers, e as ativações são transmitidas entre eles, com comunicação totalmente entre todas as camadas operando inteiramente na arquitetura de rede do wafer, cuja largura de banda é mais de 200 vezes maior que o NVLink no NVL72.]
A implantação do Kimi mostra por que a Cerebras é relevante para a estratégia de latência da OpenAI. Os sistemas em escala de wafer são construídos em torno de largura de banda extremamente alta no dispositivo e dependência reduzida de comunicação entre muitos pacotes de aceleradores separados.
O anúncio de parceria da OpenAI em janeiro de 2026 disse que a empresa planejava adicionar 750 MW de computação Cerebras de latência ultrabaixa. O objetivo era direto: reduzir a latência de inferência e tornar a IA interativa mais imediata.
A OpenAI inicialmente descreveu a versão do GPT-5.6 Sol apoiada pela Cerebras como uma implantação limitada para clientes selecionados enquanto a capacidade se expandia.
Essa limitação é compreensível. Uma implantação que dedica dezenas de sistemas em escala de wafer para cada réplica do modelo seria cara, com capacidade limitada e
difícil de escalar instantaneamente. O acesso de alta velocidade pode, portanto, ser priorizado para cargas de trabalho onde a latência possui valor comercial direto.
Os exemplos incluem:
A documentação atual do GPT-5.6 da OpenAI lista Sol, Terra e Luna entre produtos suportados e acesso via API. A configuração especial de 750 tokens por segundo, apoiada pela Cerebras, ainda pode ter restrições de capacidade, elegibilidade ou roteamento separadas do acesso padrão ao GPT-5.6.
A parceria com a Cerebras está inserida em uma estratégia de infraestrutura mais ampla da OpenAI.
Em junho de 2026, a OpenAI e a Broadcom revelaram oficialmente o Jalapeño, o primeiro Processador de Inteligência da OpenAI. Trata-se de um acelerador personalizado projetado desde o início para inferência moderna de LLMs, e não um processador de uso geral adaptado de cargas de trabalho mais antigas.
Segundo a OpenAI, o chip foi informado pelo roteiro de modelos, kernels, sistemas de atendimento, movimentação de memória, requisitos de rede e necessidades de produto da empresa. A Broadcom contribui com a implementação do silício e expertise em rede, enquanto a Celestica apoia a integração em nível de placa e rack.
A OpenAI também afirma que o primeiro chip passou do design inicial à fabricação (tape-out) em nove meses, com modelos de IA auxiliando partes do processo de design e otimização.
Vários pontos já estão confirmados:
O Jalapeño não torna a parceria com a Cerebras desnecessária. Em vez disso, os dois esforços podem ser entendidos como complementares. A Cerebras dá à OpenAI acesso a uma arquitetura de latência ultrabaixa estabelecida, enquanto o Jalapeño oferece maior controle de longo prazo sobre sua própria pilha de inferência.
A mudança maior é clara: empresas de IA de fronteira não tratam mais o hardware como uma camada neutra abaixo do modelo.
A OpenAI agora trabalha em todos os níveis:
Isso permite que a empresa otimize a pilha em torno de um objetivo compartilhado. Uma mudança na arquitetura do modelo pode reduzir a pressão sobre a memória. Um chip pode ser projetado em torno dos kernels mais comuns do modelo. A rede pode ser escolhida para os padrões de movimento de ativação e parâmetros que mais importam. Os sistemas de atendimento podem então expor esses ganhos como menor latência ou menor custo.
O resultado é um ciclo de feedback:
Modelos capazes criam produtos melhores e geram mais uso.
5. O aumento do uso financia a próxima geração de infraestrutura.
Portanto, a configuração GPT-5.6 Sol de 750 tokens por segundo é mais do que uma demonstração de velocidade. É um exemplo de modelo, hardware, rede e software de servidor sendo projetados como um único sistema.
Tratar essas categorias separadamente é essencial. As ideias especulativas são tecnicamente plausíveis e úteis para entender o problema de design do sistema, mas não devem ser apresentadas como especificações oficiais do GPT-5.6.
O GPT-5.6 Sol é o modelo de fronteira da família GPT-5.6 da OpenAI. A OpenAI o posiciona para trabalho profissional complexo em codificação, pesquisa, uso de computador, ciência, segurança cibernética e outros fluxos de trabalho agentivos exigentes.
A OpenAI anunciou uma configuração do GPT-5.6 Sol com suporte da Cerebras capaz de rodar a até 750 tokens por segundo. A velocidade real de aplicação ainda pode variar com o tamanho do prompt, uso de ferramentas, configurações de raciocínio, latência de rede e capacidade.
Esse número vem de estimativas técnicas externas, não de uma divulgação oficial da arquitetura. A OpenAI e a Cerebras não confirmaram a contagem de wafers do modelo nem seu design exato de implantação física.
Descreve um pipeline onde cada sistema em escala de wafer mantém e computa uma camada principal do modelo, passando ativações para o próximo estágio. O design poderia manter alta taxa de transferência de tokens após o pipeline ser preenchido, mas continua sendo uma teoria sobre o GPT-5.6 Sol, não um fato confirmado.
O cache KV cresce com o comprimento do contexto, arquitetura do modelo, tamanho do lote e usuários concorrentes. Mesmo a memória no chip muito rápida tem capacidade limitada, então reduzir o tamanho do cache e o movimento de memória pode ser essencial para um servidor de baixa latência.
O Cerebras pode ser substancialmente mais rápido para certos workloads de inferência porque sua arquitetura em escala de wafer oferece alta largura de banda no dispositivo e evita alguns custos de comunicação.
encontrado em sistemas multi-GPU. O desempenho ainda depende do modelo, tamanho do lote, precisão, contexto e configuração de serviço.
O Jalapeño é o primeiro processador de inteligência personalizado da OpenAI, desenvolvido em conjunto com a Broadcom para inferência de LLMs. A OpenAI afirma que ele faz parte de uma plataforma de computação full-stack multigeracional e foi projetado para melhorar desempenho, eficiência e escalabilidade.
Sim. A documentação da API da OpenAI lista o GPT-5.6 Sol e identifica gpt-5.6 como um alias que encaminha para a camada Sol. A disponibilidade, limites de taxa, preços e recursos suportados dependem da conta do desenvolvedor e dos termos atuais da API.
O pico relatado de 750 tokens por segundo do GPT-5.6 Sol mostra como a inferência de baixa latência pode alterar o comportamento prático dos agentes de IA. A melhoria mais importante não é apenas um texto mais rápido, mas atrasos menores em loops repetidos de raciocínio, uso de ferramentas, codificação e controle de computador.
A Cerebras já demonstrou que sistemas wafer-scale podem servir modelos de um trilhão de parâmetros a quase 1.000 tokens por segundo. Isso torna uma grande implantação multi-wafer do GPT-5.6 plausível, mas as contagens de parâmetros, contagens de wafers, arquitetura de cache e divisão atenção-FFN amplamente discutidas permanecem estimativas externas.
A parceria da OpenAI com a Cerebras e seu chip personalizado Jalapeño apontam na mesma direção: os próximos ganhos em IA virão cada vez mais do co-design de modelos, memória, redes, aceleradores e serviços.
Sistemas juntos.
O avanço confirmado é a inferência de fronteira de 750 tokens por segundo; a configuração exata do hardware por trás disso ainda não foi divulgada publicamente.
Comece com uma frase e tenha um site completo em minutos.



