For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gpt-5-6-sol-s-1m.md.
A OpenAI ampliou o acesso à janela de contexto de um milhão de tokens do GPT-5.6 Sol no Codex, permitindo que desenvolvedores que entrem com...
A OpenAI expandiu o acesso à janela de contexto de 1 milhão de tokens do GPT-5.6 Sol no Codex, permitindo que desenvolvedores obtenham contexto ampliado ao entrar com contas do ChatGPT, não se limitando mais apenas à autenticação por chave de API.
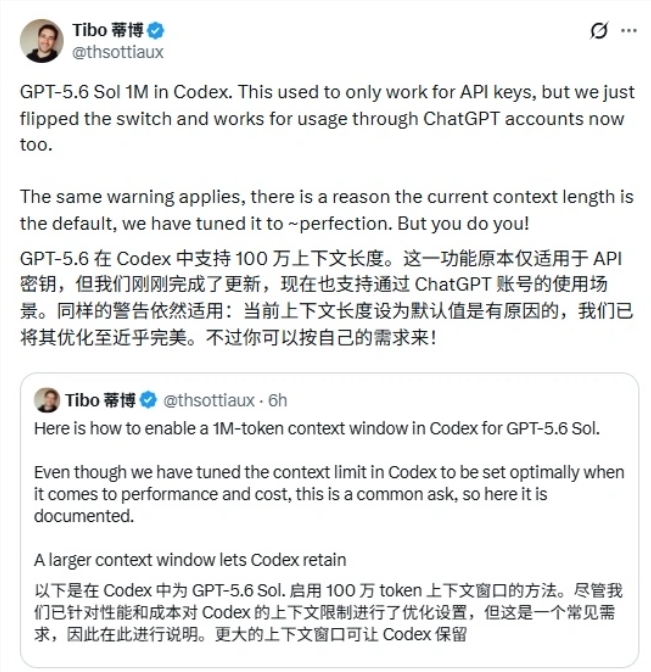
Esta atualização foi destacada por Tibo, engenheiro da OpenAI responsável pelo Codex e ChatGPT. De acordo com o anúncio compartilhado no relatório original da AIBase, o modo de contexto de 1 milhão do GPT-5.6 Sol era anteriormente restrito a usuários com chave de API, mas agora o recurso também foi habilitado para uso com contas ChatGPT.
A documentação atual dos modelos da OpenAI lista o GPT-5.6 Sol com janela de contexto de 1.050.000 tokens e até 128.000 tokens de saída. Isso oferece ao Codex um espaço muito maior para reter mais código-fonte, resultados de ferramentas, instruções e histórico de conversa antes de precisar de gerenciamento de contexto ou compactação.
Para desenvolvedores que lidam com grandes bases de código, sessões longas de depuração, migrações ou refatorações em múltiplas etapas, essa opção é extremamente útil. No entanto, a OpenAI também alerta os usuários para não assumirem que a maior janela de contexto possível é sempre a melhor opção padrão.
A mudança real é que o recurso de contexto longo não está mais limitado a desenvolvedores que autenticam o Codex com chave de API.
O anúncio afirma que o recurso agora também está disponível via conta ChatGPT. A documentação atual de preços do Codex da OpenAI confirma que os planos Plus, Pro, Business, Enterprise e outros planos ChatGPT compatíveis incluem acesso ao Codex, e a família de modelos GPT-5.6 está disponível em planos pagos qualificados.
A janela de contexto oficial do próprio GPT-5.6 Sol é:
| Especificação | GPT-5.6 Sol |
|---|---|
| Janela de contexto | 1.050.000 tokens |
| Saída máxima | 128.000 tokens |
| ID do modelo | gpt-5.6-sol |
| Alias | gpt-5.6 |
Uma janela maior permite que as sessões do Codex retenham mais informações de trabalho de uma só vez.
Isso pode incluir:
Para tarefas menores, esse espaço adicional pode não fazer grande diferença prática. No entanto, para repositórios grandes de produção, reter mais estado do projeto pode reduzir a frequência com que materiais antigos são resumidos ou descartados do contexto ativo.
A documentação oficial de referência de configuração do Codex da OpenAI registra essa configuração:
model_context_window
Ela representa o número de tokens da janela de contexto disponível para o modelo atual.
Os exemplos de configuração da OpenAI também mostram que, quando esse valor não é definido, o Codex geralmente usa o valor padrão do modelo ou predefinição. Em outras palavras, os usuários não precisam forçar manualmente o tamanho máximo de contexto no uso regular.
O anúncio original enfatizou particularmente que a opção de 1 milhão de tokens é algo que os usuários podem
escolher ativar quando necessário.
Essa distinção é importante, porque uma janela de contexto maior é uma capacidade, e não necessariamente a melhor configuração padrão para todas as sessões.
Tibo também lembrou que o comprimento de contexto padrão atual do Codex foi deliberadamente projetado.
De acordo com o anúncio, a OpenAI ajustou as configurações regulares após equilibrar desempenho e custo. Os usuários são livres para escolher um contexto maior, mas a configuração padrão tem o objetivo de manter sessões típicas de codificação eficientes.
Isso está alinhado com o guia oficial de preços do Codex da OpenAI.
A OpenAI aponta que tarefas aparentemente semelhantes podem consumir quantidades muito diferentes da cota do usuário, pois o uso depende dos seguintes fatores:
Isso significa que a janela de 1 milhão de tokens não deve ser entendida como "memória extra gratuita".
Quanto mais contexto a sessão processa ativamente, mais tokens podem precisar ser lidos, armazenados em cache, gerenciados ou compactados. Portanto, para usuários que trabalham dentro dos limites do Codex baseado em planos, um contexto maior consumirá a cota disponível mais rapidamente.
A tabela de tarifas baseada em tokens da OpenAI também trata contextos extremamente longos como cargas de trabalho independentes. Em ambientes Work e Codex compatíveis, entradas que excedem o limite de contexto longo podem incorrer em tarifas de tokens mais altas sob o preço aplicável baseado em tokens.
O Codex já inclui mecanismos de gerenciamento de contexto projetados para manter sessões longas utilizáveis.
Para correções de bugs rotineiras, desenvolvimento de funcionalidades focado, revisões de código ou alterações menores em repositórios, a configuração de contexto padrão pode já ser suficiente.
Desenvolvedores que mantêm o repositório inteiro e todos os resultados anteriores de ferramentas permanentemente na janela ativa não necessariamente obtêm benefícios.
Uma abordagem mais útil é ajustar o tamanho do contexto à tarefa.
O contexto de 1 milhão de tokens é mais atraente quando o trabalho realmente depende de grandes quantidades de informações simultaneamente relevantes, como:
Para tarefas estreitas envolvendo apenas alguns arquivos, o contexto padrão pode ser mais eficiente.
Um dos principais benefícios da janela expandida é que o Codex pode reter mais histórico antes de precisar compactar informações mais antigas.
A compactação de contexto é útil, porque nenhum agente pode carregar histórico infinito para sempre. Mas a compactação necessariamente substitui materiais detalhados anteriores por representações mais curtas.
Uma janela maior adia essa troca.
Por exemplo, uma sessão longa de codificação pode acumular:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Quando o contexto ativo fica congestionado, o Codex pode precisar compactar ou gerenciar de outra forma o histórico mais antigo.
Com a janela completa de 1,05 milhão de tokens do GPT-5.6 Sol disponível, mais informações podem permanecer diretamente acessíveis por mais tempo.
Isso é especialmente útil quando detalhes anteriores ainda são importantes para decisões tomadas mais tarde na tarefa.
No entanto, esse benefício depende da carga de trabalho. Manter informações disponíveis só ajuda se elas continuarem relevantes.
O principal alerta no artigo original da AIBase diz respeito aos limites de uso.
Alguns desenvolvedores relataram que ativar o contexto completo de 1 milhão de tokens pode fazer com que sua cota do Codex diminua mais rapidamente em sessões de alta intensidade.
Do ponto de vista da medição de tokens, esse comportamento não surpreende.
A própria documentação do Codex da OpenAI explica que apenas o comprimento do prompt não determina o uso. Contexto, raciocínio, ferramentas, recuperação e cache afetam todos a quantidade de cota que uma tarefa consome.
Portanto, quando as sessões realmente crescem até esse espaço, um contexto maior torna os turnos potencialmente mais pesados.
Isso não significa que cada solicitação consumirá imediatamente 1 milhão de tokens apenas porque a janela máxima está ativada. Significa que as sessões podem crescer mais e que solicitações suficientemente grandes podem ser mais caras em termos de tokens ou uso do plano do que solicitações semelhantes que usam contextos de trabalho menores.
Portanto, ativar a janela máxima somente quando estiver resolvendo um problema real é uma estratégia padrão mais segura.
A nova opção é mais útil quando o custo de perder contexto é maior do que o custo de carregá-lo.
Considere a janela maior nos seguintes casos:
O Codex precisa entender uma base de código muito grande.
Mantenha a configuração de contexto normal nos seguintes casos:
A mudança importante é que os desenvolvedores agora têm uma escolha.
Antes, a capacidade de contexto completo descrita no relatório de origem era limitada ao uso com chave de API. Usuários de contas ChatGPT agora podem optar pela janela maior quando a carga de trabalho exigir.
A documentação oficial do modelo da OpenAI lista o GPT-5.6 Sol como tendo uma janela de contexto de 1.050.000 tokens. O modelo também oferece suporte a até 128.000 tokens de saída.
Sim. A atualização relatada pela AIBase e anunciada pelo engenheiro da OpenAI, Tibo, indica que o suporte ao contexto de um milhão de tokens do GPT-5.6 Sol foi habilitado para sessões autenticadas do Codex.
O uso é feito por meio de conta ChatGPT, sem se limitar ao método de chave de API.
Para o caminho de conta ChatGPT descrito nesta atualização, não. A autenticação por chave de API continua sendo suportada, mas esta mudança estende especificamente essa capacidade ao cenário de uso com conta ChatGPT.
Não. O anúncio destaca que a configuração de contexto normal do Codex foi ajustada intencionalmente para equilibrar desempenho e custo. A janela maior é uma opção para usuários com necessidades específicas que exigem contexto adicional.
O contexto afeta a quantidade de informações que o modelo processa. A documentação de preços do Codex da OpenAI indica que seleção de modelo, contexto, raciocínio, uso de ferramentas, recuperação e cache influenciam o consumo, portanto sessões longas e intensivas em contexto gastam mais cota.
Não. A janela de contexto é uma capacidade máxima, não um custo fixo de tokens por turno de conversa. O uso real depende da quantidade de conteúdo incluído na sessão e dos dados que o modelo processa.
Refatoração de grandes bases de código, sessões longas de depuração, migrações de arquitetura, análise entre módulos e fluxos de trabalho estendidos de agente são cenários adequados. Correções pequenas e tarefas bem definidas geralmente não exigem a janela máxima.
A OpenAI documenta o model_context_window na referência oficial de configuração do Codex e no guia de configuração avançada. As configurações de exemplo indicam que, se o valor não for definido, o Codex usará os padrões do modelo ou predefinições.
model_context_window e outras configurações de limites do modelo.config.toml de exemplo da OpenAI, incluindo a configuração opcional manual da janela de contexto.O contexto completo de um milhão de tokens do GPT-5.6 Sol não está mais limitado a sessões do Codex autenticadas por chave de API. Usuários de contas ChatGPT agora também podem acessar a opção de contexto maior, oferecendo mais espaço para conteúdo do repositório, saídas de ferramentas e histórico de conversa em sessões longas de codificação.
A janela máxima não foi criada para substituir os padrões regulares do Codex em todas as tarefas. A OpenAI ajustou cuidadosamente as configurações padrão para equilibrar desempenho e custo, e a opção de 1,05 milhão de tokens é mais útil para repositórios realmente grandes e trabalhos de engenharia de longo prazo.
Para correções do dia a dia, o contexto padrão pode continuar sendo mais eficiente. Para projetos complexos em que a perda de detalhes anteriores se torna um gargalo real, a nova opção oferece aos desenvolvedores uma margem significativamente maior.
A atualização importante não é que toda sessão do Codex deva usar um milhão de tokens, mas sim que usuários do ChatGPT agora podem escolher o contexto completo do GPT-5.6 Sol quando o projeto realmente precisar.
Comece com uma frase e tenha um site completo em minutos.



