For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gpt-5-6-sol-vision-benchmark.md.
O GPT-5.6 Sol pode ser um dos maiores saltos recentes da OpenAI em compreensão visual prática. A Roboflow testou a família GPT-5.6 — Sol, Te...
O GPT-5.6 Sol pode ser um dos maiores avanços recentes da OpenAI em compreensão visual prática.
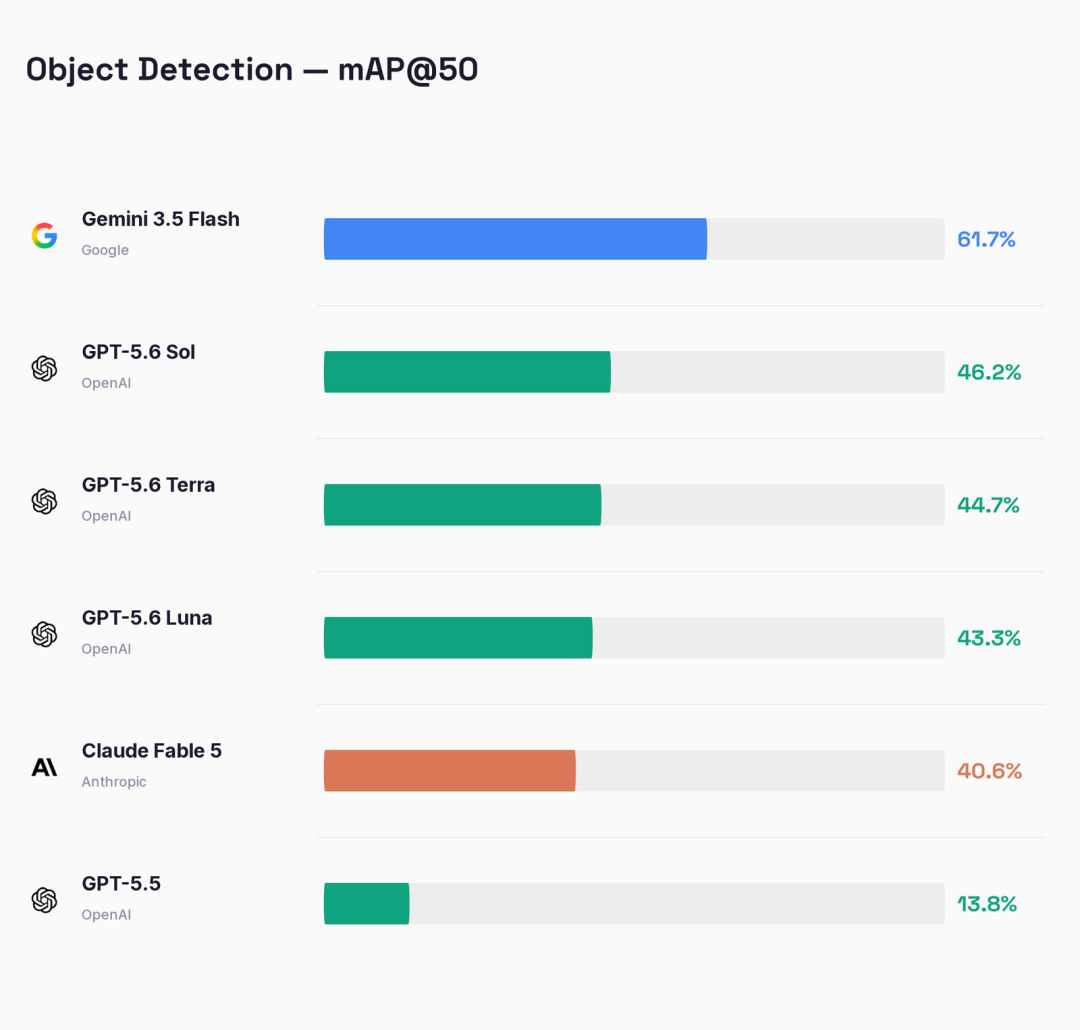
A Roboflow testou a família GPT-5.6—Sol, Terra e Luna—em um benchmark de modelo de visão-linguagem cobrindo detecção de objetos, contagem de objetos, OCR e extração direcionada de dados. O resultado mais impressionante veio da detecção de objetos: o GPT-5.5 havia alcançado apenas 13,8 mAP@50, enquanto o GPT-5.6 Sol chegou a 46,2, mais que triplicando o resultado anterior no benchmark de lançamento da Roboflow.
Terra e Luna também melhoraram significativamente, alcançando 44,7 e 43,3, respectivamente.
Piotr Skalski, da Roboflow, descreveu o Sol como o modelo de visão mais forte que a OpenAI havia lançado até aquele momento. Essa conclusão é específica para a avaliação da Roboflow e não deve ser interpretada como uma classificação universal em todas as cargas de trabalho de visão computacional, mas a melhoria em relação ao GPT-5.5 é substancial.
Os ganhos não são uniformes, no entanto. O Sol melhora fortemente na localização de objetos, contagem, compreensão de restrições espaciais e detecção de regiões de documentos, mas não supera o GPT-5.5 em todas as tarefas de OCR. Ele também apresenta um modo de falha específico em imagens muito grandes, onde as caixas delimitadoras podem se tornar instáveis.
O resultado é um quadro mais útil do que uma simples manchete de "melhor modelo de visão": o GPT-5.6 é muito mais capaz em trabalhos visuais, mas a escolha do modelo ainda depende de precisão, latência, custo, tamanho da imagem e da tarefa exata.
A detecção de objetos tem sido historicamente um ponto fraco para os modelos GPT de propósito geral.
A tarefa parece simples: identificar cada objeto relevante em uma imagem e retornar uma caixa delimitadora ao redor dele. Na prática, um modelo de visão-linguagem deve compreender corretamente a categoria-alvo, localizar cada instância, gerar coordenadas no formato exigido e evitar duplicatas ou caixas mal posicionadas.
No benchmark da Roboflow, o GPT-5.5 teve grande dificuldade nisso.
O GPT-5.6 muda o cenário.
| Modelo | Detecção de Objetos mAP@50 |
|---|---|
| Gemini 3.5 Flash | 61,7 |
| GPT-5.6 Sol | 46,2 |
| GPT-5.6 Terra | 44,7 |
| GPT-5.6 Luna | 43,3 |
| Claude Fable 5 | 40,6 |
| GPT-5.5 | 13,8 |
Estes valores são do snapshot do benchmark da Roboflow discutido no artigo original e na análise da Roboflow de julho de 2026. O benchmark ao vivo da Roboflow pode mudar conforme conjuntos de dados, estruturas de teste, versões de modelos e a metodologia do ranking evoluem.
Um dos exemplos mais úteis é a análise de layout de documentos.
O Sol foi capaz de identificar regiões como:
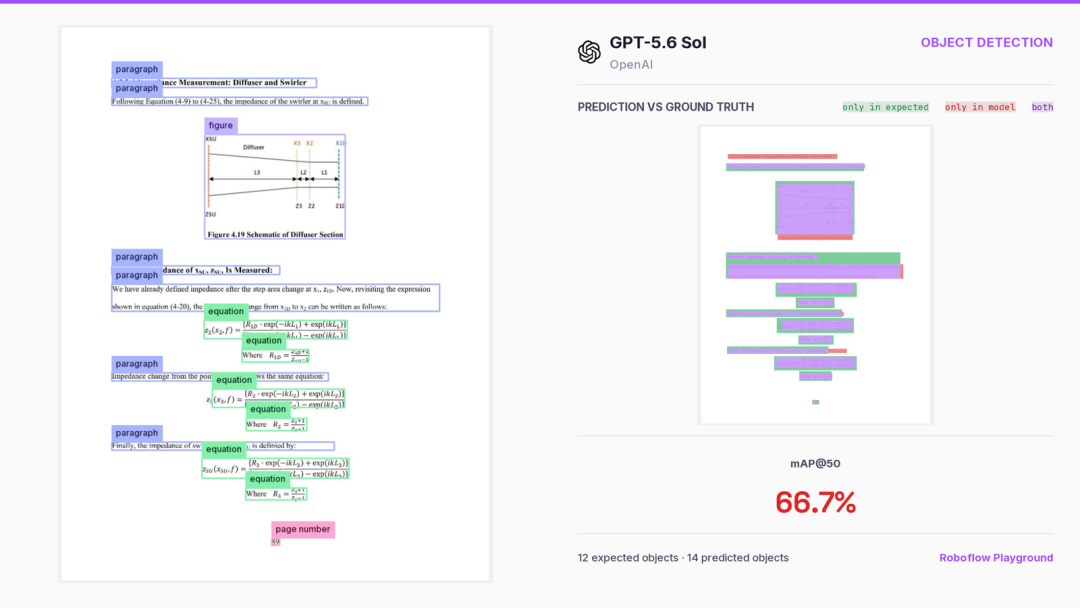
Isso é importante para pipelines de processamento de documentos porque o OCR geralmente não é o primeiro passo.
Um sistema típico primeiro precisa responder:
Onde está o conteúdo relevante nesta página?
Somente então faz sentido transcrever texto, extrair uma data, ler uma tabela ou encaminhar uma região para um parser especializado.
Para contratos, faturas, formulários, relatórios e PDFs digitalizados, uma melhor detecção de regiões pode, portanto, melhorar todo o fluxo de trabalho a jusante.
A Roboflow descobriu que o GPT-5.6 tem o melhor desempenho quando prompts de detecção de objetos solicitam coordenadas absolutas de pixel XYXY.
Esse detalhe é fácil de ignorar.
De acordo com a Roboflow, usar a representação incorreta de coordenadas reduziu o desempenho de detecção do GPT-5.6 em cerca de 15 pontos de mAP em seus testes. O Gemini 3.5 Flash se comportou de maneira diferente e obteve melhor desempenho com coordenadas YXYX normalizadas em uma escala de 0 a 1000.
Isso significa que a qualidade do benchmark — e a qualidade real de produção — podem depender fortemente do formato de saída solicitado.
Uma instrução prática de detecção para o GPT-5.6 deve, portanto, especificar explicitamente a convenção de coordenadas, em vez de pedir vagamente por "bounding boxes".
Imagens densas são difíceis para detecção de objetos baseada em VLM porque o modelo normalmente emite rótulos de objetos e coordenadas como texto.
Quanto mais objetos existirem, mais longa se torna essa saída. Isso cria mais oportunidades para:
A Roboflow testou cenas contendo muitos objetos visualmente semelhantes e compactados, incluindo pílulas e ovos.
O Sol lidou com esses casos muito melhor do que os modelos anteriores da OpenAI.
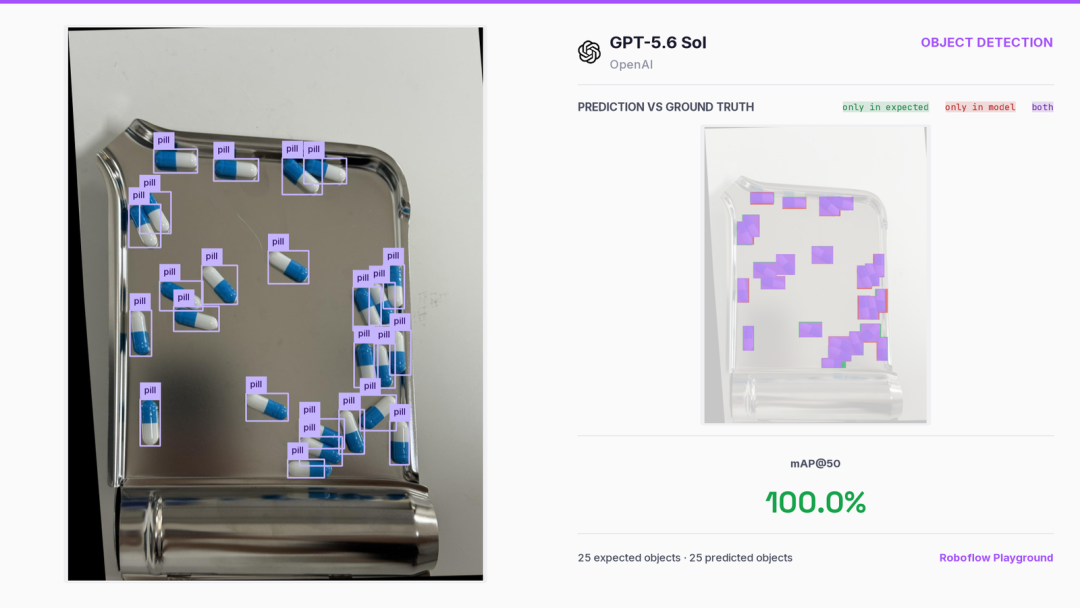
O resultado sugere que o GPT-5.6 está indo além do simples reconhecimento do conteúdo geral de uma imagem e avançando em direção a um trabalho de localização mais estruturado.
Isso não o torna um substituto para todos os detectores especializados. Modelos dedicados de detecção de objetos ainda podem ser mais rápidos, mais baratos, mais fáceis de calibrar ou mais confiáveis em ambientes de produção restritos. Mas a lacuna entre um modelo multimodal de propósito geral e um pipeline de visão dedicado está claramente diminuindo.
A contagem melhorou no Sol, Terra e Luna.
A Roboflow relatou:
| Modelo | Precisão de Contagem |
|---|---|
| GPT-5.6 Sol | 73,0% |
| GPT-5.6 Terra | 67,6% |
| GPT-5.6 Luna | 66,2% |
| GPT-5.5 | 64,9% |
A melhoria é especialmente notável
para Sol, mas até mesmo a Luna—o modelo mais barato da família GPT-5.6—superou o GPT-5.5 neste benchmark.
Alguns dos exemplos da Roboflow exigiam mais do que retornar um número total de objetos visíveis.
Em um teste, a Sol precisava contar apenas os buracos de bala dentro de zonas de pontuação específicas em um alvo. Isso exigia duas camadas de raciocínio visual:
O modelo obteve sucesso no exemplo destacado pela Roboflow.
Isso está mais próximo da automação visual do mundo real do que simplesmente perguntar: "Quantos objetos há nesta imagem?"
As aplicações geralmente contêm regras condicionais, como:
Um modelo multimodal geral que possa combinar detecção com regras em linguagem natural pode ser útil em fluxos de trabalho onde a lógica visual muda com frequência.
O benchmark também inclui exemplos que permanecem difíceis.
Blísteres foram desafiadores porque os slots preenchidos e vazios podem parecer muito semelhantes sob reflexos. Layouts repetidos podem confundir ainda mais o modelo.
A Roboflow também mostrou um exemplo de doce anormal onde a Sol retornou a contagem errada. Não ficou claro se o modelo falhou na contagem ou entendeu mal quais itens pertenciam à categoria solicitada.
Essa distinção é importante em sistemas de produção.
Uma contagem errada pode vir de várias causas diferentes:
Erro de detecção
Mal-entendido de categoria
Mal-entendido de regra espacial
Detecção duplicada
Objeto não detectado
Erro de coordenadas
O número final sozinho não diz em qual etapa ocorreu a falha.
A parte mais contraintuitiva do benchmark é o OCR.
A pontuação de transcrição de texto completo da Sol foi de 90,7%, ligeiramente abaixo do GPT-5.5 com 91,2%.
A diferença é pequena, mas isso significa que o novo modelo principal não melhorou em todas as categorias visuais.
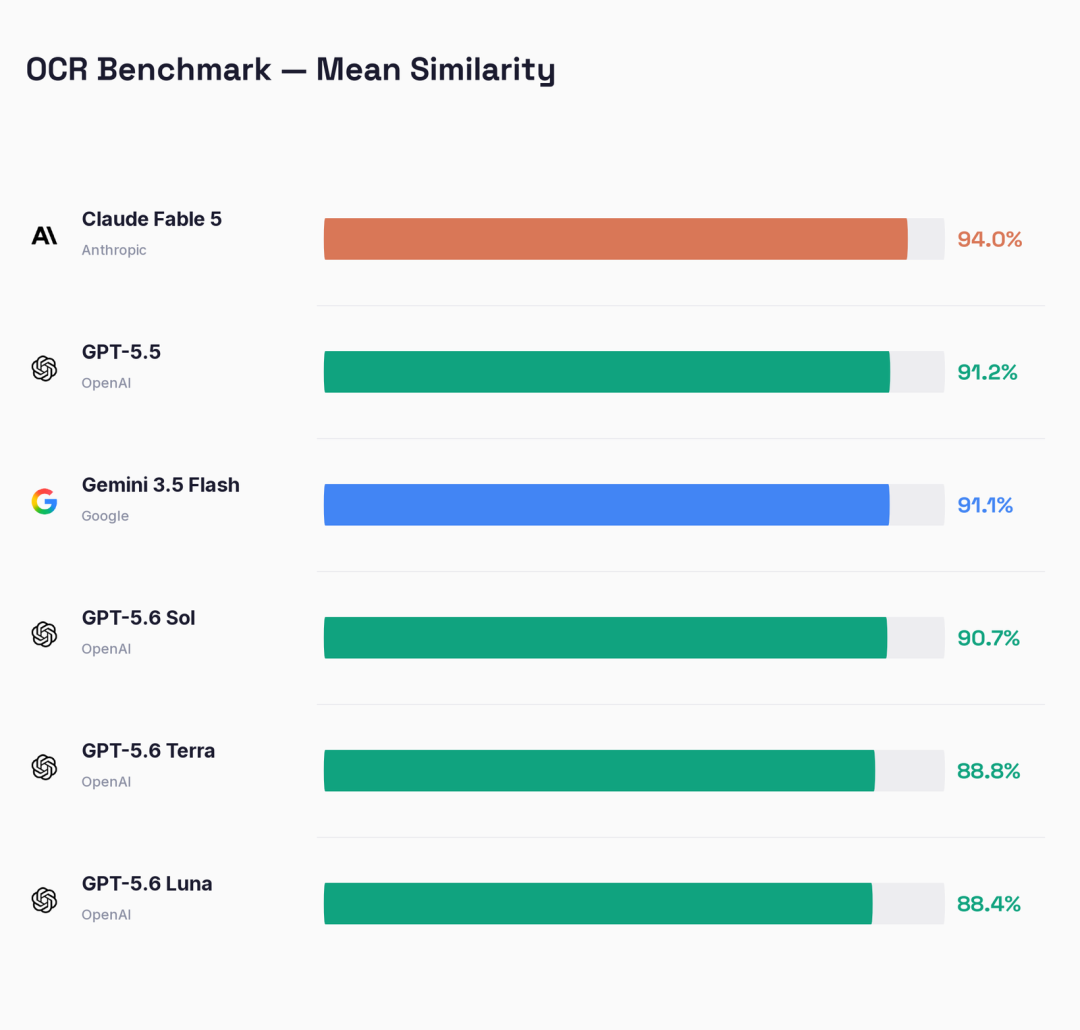
A Roboflow separou duas tarefas relacionadas:
A segunda categoria mostrou uma regressão maior.
| Modelo | OCR | Extração Direcionada de Texto |
|---|---|---|
| GPT-5.5 | 91,2% | 87,6% |
| GPT-5.6 Sol | 90,7% | 82,5% |
| GPT-5.6 Terra | 88,8% | 79,4% |
| GPT-5.6 Luna | 88,4% | 81,4% |
A pontuação de extração da Sol caiu mais de cinco pontos em relação ao GPT-5.5 neste recorte do benchmark.
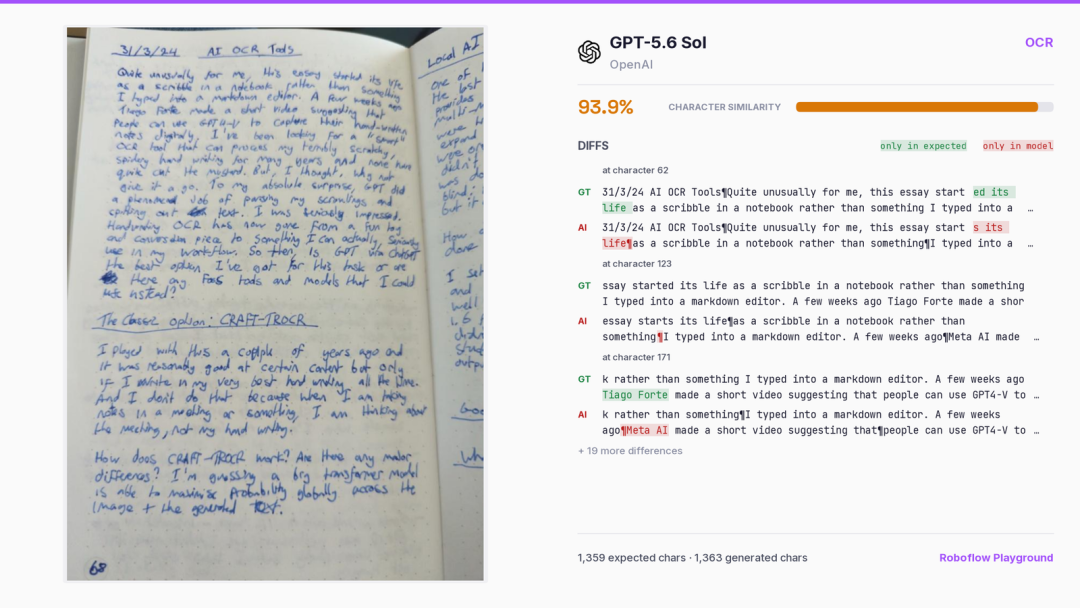
O modelo ainda lidou bem com vários exemplos difíceis.
A Roboflow mostrou a Sol transcrevendo texto manuscrito
notas com alta similaridade de caracteres.
Ele também leu com sucesso texto de cenas visualmente complexas, incluindo uma string do tamanho de um pneu impressa em uma superfície curva suja e um placar ao vivo exibido em uma transmissão de hóquei.
Esses exemplos demonstram que a limitação de OCR do modelo não é simplesmente "texto pequeno é impossível".
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Seu desempenho depende de contraste, orientação, reflexos, tamanho da fonte, poluição visual ao redor e da instrução exata de extração.
Uma das falhas mais claras envolveu uma data de validade impressa em um blister.
O texto era pequeno, orientado verticalmente, com baixo contraste e afetado pela embalagem reflexiva.
O Sol falhou ao extrair corretamente a data solicitada.
Isso é um lembrete útil para fluxos de trabalho documentais e industriais: exemplos impressionantes com escrita manual ou gráficos de transmissão não garantem confiabilidade em embalagens, texto em relevo, materiais reflexivos ou etiquetas pequenas e de baixo contraste.
Para extração de alto risco, a saída do modelo ainda deve ser validada contra um mecanismo de OCR dedicado, um parser determinístico, um sistema de código de barras ou um processo de revisão humana, quando apropriado.
A Roboflow encontrou outro modo de falha importante durante a detecção de objetos.
Em algumas imagens, o Sol retornou caixas delimitadoras em partes da imagem que tinham pouco ou nenhum sobreposição com os objetos reais. As caixas incorretas às vezes apareciam em padrões anormalmente regulares, como linhas ou grupos uniformemente espaçados.
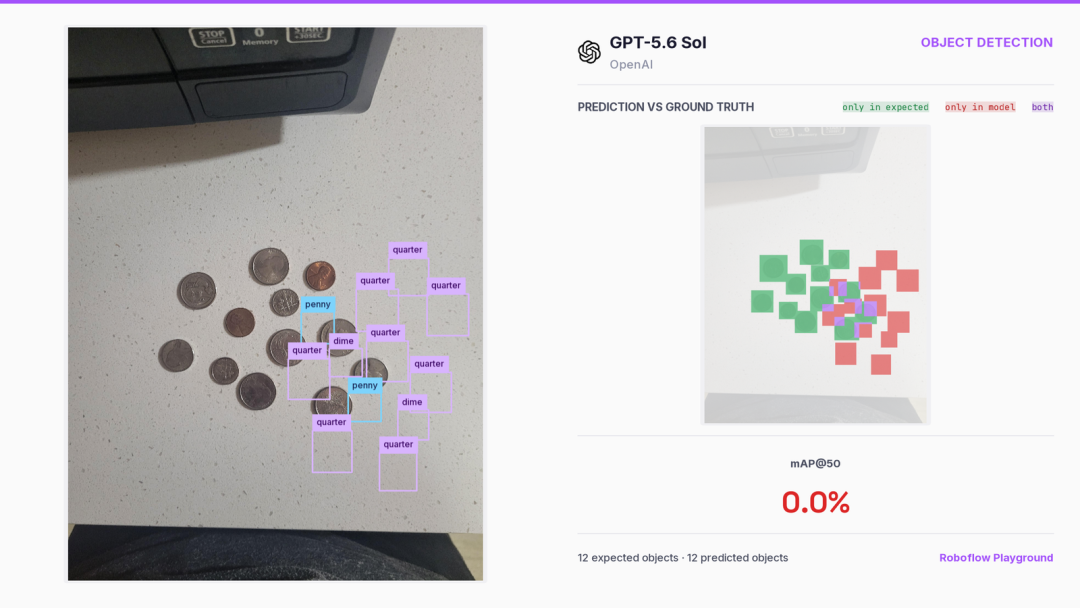
A Roboflow diz que compartilhou esses exemplos com a OpenAI e foi informada de que o Sol se torna menos estável em imagens de aproximadamente 2.000 × 2.000 pixels ou maiores, especialmente com esforço de raciocínio menor.
Esse esclarecimento vem por meio do relatório da Roboflow, em vez de uma página de documentação independente da OpenAI, então é melhor descrito como uma limitação que a Roboflow afirma que a OpenAI confirmou.
Um esforço de raciocínio maior melhorou a estabilidade nos testes da Roboflow.
A troca é direta:
Maior esforço de raciocínio
→ mais tokens
→ maior latência
→ maior custo
Isso pode fazer sentido para análise de imagens de baixo volume e alto valor, onde uma detecção falha é cara.
É menos atraente para lotes muito grandes.
A recomendação mais prática da Roboflow é redimensionar ou cortar imagens grandes antes de enviá-las à API.
Isso pode ajudar de duas maneiras:
Para processamento de documentos, dividir ou cortar uma digitalização grande em regiões significativas também pode tornar o
tarefa mais fácil de avaliar e repetir.
As melhorias visuais vêm com um custo prático.
No benchmark de julho da Roboflow, o custo estimado por imagem e a latência eram aproximadamente assim:
| Modelo | Custo Aprox. por Imagem | Latência Aprox. |
|---|---|---|
| GPT-5.6 Sol | $0,025 | ~10 s |
| GPT-5.6 Terra | $0,01 | ~6 s |
| GPT-5.6 Luna | < $0,005 | ~5 s |
| Gemini 3.5 Flash | $0,008 | Mais rápido que Sol na comparação citada |
Estas são estimativas específicas do benchmark, não preços fixos de API por imagem. O custo por imagem depende das dimensões da imagem, do comprimento do prompt, dos tokens de saída, do esforço de raciocínio, das configurações do provedor e do preço atual dos tokens.
A precificação atual da API da OpenAI também difere substancialmente entre a família GPT-5.6. Sol é o nível principal, Terra é o nível equilibrado, e Luna é otimizada para cargas de trabalho de alto volume e sensíveis a custo.
Isso torna Luna especialmente interessante quando um fluxo de trabalho precisa do comportamento visual aprimorado da geração GPT-5.6, mas não pode justificar o Sol em todas as imagens.
A conclusão do artigo original não é que o GPT-5.6 agora domina todos os benchmarks de visão.
Na comparação de julho da Roboflow, o Gemini 3.5 Flash permaneceu à frente do GPT-5.6 Sol em detecção de objetos e contagem, custando significativamente menos por imagem.
Isso torna o Gemini 3.5 Flash atraente para cargas de trabalho de alta frequência, como:
A documentação oficial do Google descreve o Gemini 3.5 Flash como um modelo multimodal que suporta entrada de imagem, vídeo, áudio, texto e PDF com uma janela de contexto de 1 milhão de tokens. Sua precificação de API também é projetada para uso de produção de alta vazão.
A escolha prática, portanto, depende da carga de trabalho.
O GPT-5.6 Sol pode ser a melhor opção quando:
Terra ou Luna podem ser melhores quando:
Um pipeline em camadas pode frequentemente ser mais econômico do que enviar todas as imagens diretamente para o modelo principal.
A mudança mais importante no GPT-5.6 não é que ele se tornou subitamente um mecanismo perfeito de OCR ou um detector dedicado.
É que as capacidades visuais estão se tornando utilizáveis dentro de fluxos de agentes mais amplos.
O Sol pode cada vez mais combinar:
O próprio lançamento do GPT-5.6 pela OpenAI enfatiza uso de computador mais forte, raciocínio multimodal e fluxos de trabalho de agentes. O benchmark da Roboflow ajuda a mostrar
essas melhorias se manifestam na camada de visão de nível inferior.
Para desenvolvedores, a distinção importa.
Um sistema tradicional de visão computacional pode exigir modelos separados para detecção, OCR, análise de documentos e raciocínio downstream. Um VLM de fronteira pode realizar várias dessas operações por meio de uma única interface, embora modelos especializados ainda possam superá-lo em precisão, custo, velocidade ou previsibilidade.
A próxima etapa da competição de VLMs, portanto, tem menos a ver com a capacidade do modelo de descrever uma imagem e mais com sua capacidade de executar tarefas visuais estruturadas de forma confiável o suficiente para serem úteis em produção.
Os resultados da Roboflow apontam para algumas regras práticas para desenvolvedores que testam o GPT-5.6 em cargas de trabalho visuais.
A Roboflow descreveu o GPT-5.6 Sol como o modelo de visão mais forte da OpenAI que havia testado na época. A OpenAI também posiciona o Sol como o modelo carro-chefe do GPT-5.6 e oferece suporte oficial à entrada de imagens, mas "melhor" ainda depende da tarefa visual e do benchmark.
No benchmark da Roboflow de julho de 2026, o GPT-5.5 obteve 13,8 mAP@50, enquanto o GPT-5.6 Sol alcançou 46,2. Isso representa mais que o triplo na pontuação relatada.
Ele é capaz, mas o benchmark não mostra uma melhoria universal. O Sol obteve 90,7% no teste de OCR da Roboflow, contra 91,2% do GPT-5.5, e sua pontuação de extração de texto direcionada também foi menor do que a do GPT-5.5 nessa avaliação.
A Roboflow recomenda solicitar coordenadas XYXY absolutas em pixels da imagem para tarefas de detecção do GPT-5.6. Seus testes descobriram que o formato de coordenadas teve um efeito significativo no desempenho medido.
A Roboflow afirma que a OpenAI confirmou que o Sol pode se tornar menos estável em torno de 2.000 × 2.000 pixels ou mais, especialmente com menor esforço de raciocínio. Redimensionar ou cortar a imagem, ou aumentar o esforço de raciocínio, melhorou os resultados nos testes da Roboflow.
Sim. O Luna obteve 43,3 mAP@50 para detecção de objetos e 66,2% para contagem no benchmark da Roboflow citado, ambos substancialmente mais fortes do que o resultado de detecção do GPT-5.5. A OpenAI posiciona o Luna como o nível de custo mais baixo do GPT-5.6, tornando-o
relevante para cargas de trabalho de alto volume.
Não universalmente, mas ele permaneceu mais forte nos benchmarks de detecção de objetos e contagem citados pela Roboflow, além de ser mais barato por imagem nesse benchmark. O Sol ainda pode ser preferível quando a visão está integrada a fluxos de raciocínio mais complexos ou a agentes.
Às vezes, mas não automaticamente. Um VLM de uso geral pode simplificar fluxos de trabalho visuais mistos, enquanto detectores dedicados e sistemas de OCR ainda podem oferecer melhor latência, saídas previsíveis, ajuste de domínio ou menor custo para tarefas de produção específicas.
O benchmark da Roboflow mostra uma grande melhoria nas capacidades visuais práticas do GPT-5.6. O resultado de detecção de objetos do Sol subiu de 13,8 mAP@50 no GPT-5.5 para 46,2, enquanto a contagem melhorou para 73%. Terra e Luna também tiveram grandes ganhos, sugerindo que a atualização visual se estende a toda a família, e não apenas ao modelo principal.
A melhoria não é universal. O OCR permaneceu próximo ao GPT-5.5, a extração de texto direcionada diminuiu no benchmark citado, e imagens grandes podem produzir caixas delimitadoras instáveis. Custo e latência também continuam sendo importantes, com o Gemini 3.5 Flash mantendo uma forte
Posição para detecção e contagem de alto volume na comparação da Roboflow.
O GPT-5.6 Sol é um trabalhador de visão de propósito geral muito mais confiável do que o GPT-5.5, mas as equipes de produção ainda devem escolher modelos por tarefa, tamanho da imagem, confiabilidade, latência e custo — não por um único benchmark de destaque.
Comece com uma frase e tenha um site completo em minutos.



