For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
Sessões longas de programação acumulam mais do que mensagens de chat. Um agente também precisa de espaço para arquivos de código-fonte, saíd...
Sessões longas de programação acumulam mais do que mensagens de chat. Um agente também precisa de espaço para arquivos de código-fonte, saída de comandos, falhas de testes e decisões tomadas anteriormente na tarefa. Quando esse contexto de trabalho fica cheio, o agente precisa condensá-lo antes de continuar.
Uma reportagem do veículo chinês de notícias sobre IA Xinzhiyuan, republicada no BAAI Hub, descreve um aumento do contexto padrão do GPT-6.1 Sol no Codex e no ChatGPT Work, de 272K para 500K tokens. A reportagem atribui o anúncio a Thibault Sottiaux, da OpenAI, e afirma que a mudança elimina uma sobretaxa separada por contexto longo para o uso por assinatura. Essa é uma alegação mais específica do que a sugestão da manchete original de que a atualização é simplesmente “gratuita”.
A documentação oficial da OpenAI confirma a disponibilidade do GPT-6.1 Sol e explica como o uso é contabilizado. A mudança exata para 500K e o anúncio sobre a sobretaxa abaixo continuam atribuídos à reportagem citada e à captura de tela do anúncio; as páginas da documentação oficial verificadas não especificaram de forma independente esse novo padrão.
Passar de 272.000 para 500.000 tokens adiciona aproximadamente 84% mais capacidade. A fonte arredonda isso para cerca de 80%. A captura de tela do anúncio também descreve um contexto máximo de um milhão de tokens e diz que os usuários podem substituir o padrão.
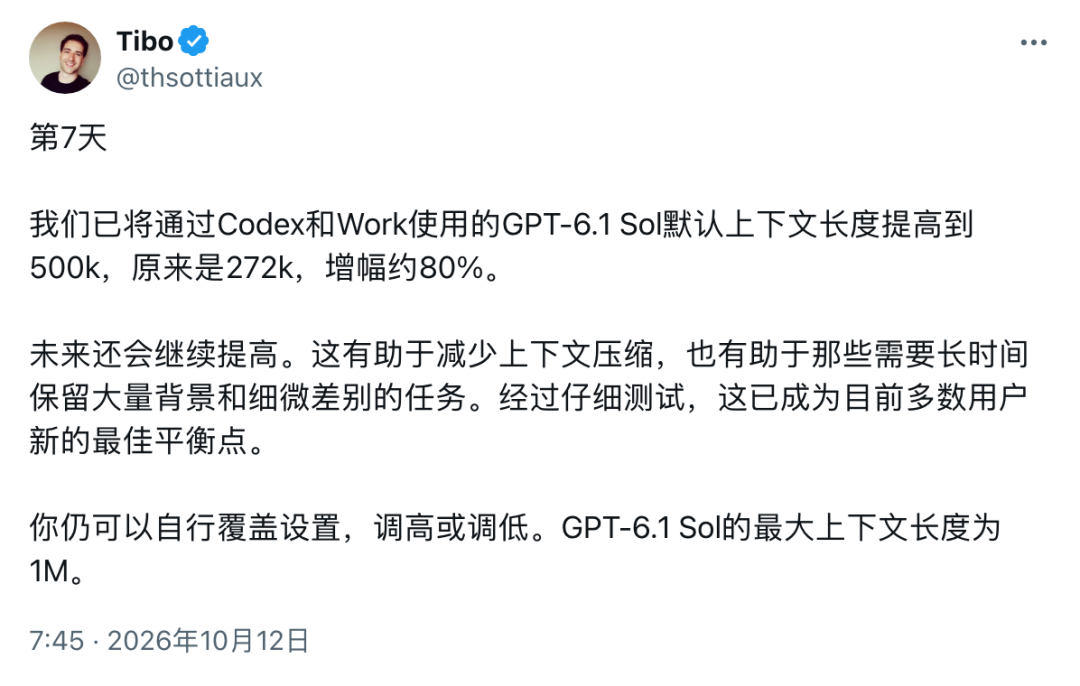
Fonte: uma captura de tela em chinês do anúncio de Thibault Sottiaux, reproduzida pela Xinzhiyuan no BAAI Hub; a descrição em português é editorial.
O benefício prático é ter espaço para manter mais histórico da tarefa disponível antes da compactação. Em uma alteração de repositório, isso pode incluir o requisito de compatibilidade original, arquivos já inspecionados, abordagens que falharam e os resultados mais recentes de testes.
Uma janela maior não garante que um agente se lembrará de todos os requisitos ou fará alterações corretas. Ela muda a quantidade de informação que pode permanecer em seu contexto ativo, enquanto a qualidade de suas decisões ainda precisa ser verificada.
A compactação substitui parte do histórico acumulado por uma representação mais curta. Isso permite que um agente continue trabalhando sem preservar integralmente todas as linhas anteriores de saída de ferramentas.
A contrapartida é que um histórico condensado pode perder detalhes úteis. Uma tarefa de programação pode parecer concluída enquanto deixa de cumprir um requisito anterior, como preservar um formato antigo de resposta de API. Manter mais contexto relevante disponível pode reduzir a frequência dessas transições, embora não elimine a necessidade de testes de regressão.
A referência de configuração da OpenAI documenta model_context_window e model_auto_compact_token_limit. Essas são configurações diferentes: uma descreve o contexto disponível ao modelo, enquanto a outra determina quando a compactação automática é acionada. A existência dessas configurações não estabelece que todos os modelos ou contas tenham suporte aos mesmos valores.
A fonte diferencia uma sobretaxa por contexto longo do consumo normal da assinatura. Uma tarefa ainda pode usar a franquia disponível mesmo quando nenhum multiplicador adicional é aplicado especificamente porque seu contexto é longo.
A documentação oficial de preços da OpenAI sustenta essa distinção mais ampla. Ela afirma que o uso depende da escolha do modelo, do contexto, do raciocínio, do uso de ferramentas, da recuperação de informações e do cache. Tarefas mais longas que retêm mais informações podem consumir substancialmente mais franquia do que solicitações curtas e focadas.
| Conceito | O que descreve |
|---|---|
| Capacidade de contexto | Quanta informação o modelo pode manter durante uma solicitação ou sessão |
| Uso da assinatura | Como uma tarefa consome a franquia ou os créditos incluídos |
| Entrada em cache | Entrada processada anteriormente que pode ser reutilizada com uma tarifa diferente |
| Preços de API | Cobranças separadas ao autenticar e pagar por meio de uma chave de API |
Um acompanhamento curto, como “continue”, pode levar a outra solicitação substancial ao modelo. O agente pode precisar dos arquivos anteriores, requisitos e resultados de ferramentas para decidir o que fazer. A entrada em cache pode ser mais barata de processar, mas não é necessariamente sem medição de uso.
A fonte também descreve um aumento anterior para 372K que foi posteriormente revertido após um consumo de assinatura maior do que o esperado. Esse relato é um contexto útil para o anúncio, mas não deve ser interpretado como uma regra de cobrança atual ou uma promessa sobre quanto qualquer tarefa individual custará.
A fonte compara o novo padrão reportado com configurações de um milhão de tokens no Claude Code. Uma comparação útil exige mais do que o maior número em uma ficha técnica de modelo: padrões, limiares de compactação, acesso da conta, preços e o software de agente ao redor podem ser diferentes.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Os limites específicos de modelo Claude e o limiar de compressão citados pela fonte não foram verificados de forma independente na documentação da Anthropic para este artigo. Portanto, não devem ser tratados como uma recomendação de configuração atual.
Para o trabalho cotidiano, verifique três pontos em conjunto:
A orientação oficial de modelos da OpenAI também condiciona a disponibilidade ao plano, cliente, lançamento gradual e configurações do espaço de trabalho. Um anúncio de capacidade não concede acesso a um modelo que, de outra forma, não está disponível.
GPT-6.1 Sol é um modelo da OpenAI documentado para trabalho complexo com código, aplicações e documentos. A orientação oficial o descreve como oferecendo desempenho próximo ao Astra a um custo menor, com disponibilidade dependente do plano e do cliente do usuário.
Significa que o modelo pode trabalhar com um contexto medido em aproximadamente 500.000 tokens nessa configuração. Os tokens incluem mais do que a mensagem mais recente do usuário, portanto arquivos, histórico da tarefa, saída de ferramentas e respostas podem ser relevantes.
A fonte relata a ausência de uma sobretaxa separada por contexto longo para o uso por assinatura, o que é diferente de acesso ilimitado. A tarefa ainda consome a franquia aplicável, e o acesso ao GPT-6.1 Sol depende do plano e do lançamento gradual.
Ela pode adiar a compactação ao disponibilizar mais espaço. Uma sessão suficientemente longa ainda pode atingir seu limite, e o limiar de compactação configurado também afeta quando a condensação acontece.
Não. A OpenAI afirma explicitamente que os preços de tokens da API são separados do uso da assinatura e não devem ser usados para estimar o número de tarefas incluídas.
Não apenas porque uma configuração maior é mencionada em uma reportagem. Verifique o modelo e a configuração compatíveis e, em seguida, compare qualidade de conclusão, latência e uso em uma tarefa representativa antes de alterar sua configuração habitual.
O padrão reportado de 500K dá ao GPT-6.1 Sol mais espaço para arquivos, requisitos e histórico de trabalho no Codex e no Work. Seu benefício potencial mais claro é haver menos interrupções de compactação durante uma tarefa longa.
Mais capacidade de contexto é útil, mas não elimina os limites da assinatura, as cobranças de API ou a necessidade de verificar o resultado final.
Comece com uma frase e tenha um site completo em minutos.



