O próximo passo da IA incorporada não é apenas mais uma demonstração de braço robótico sobre uma mesa.
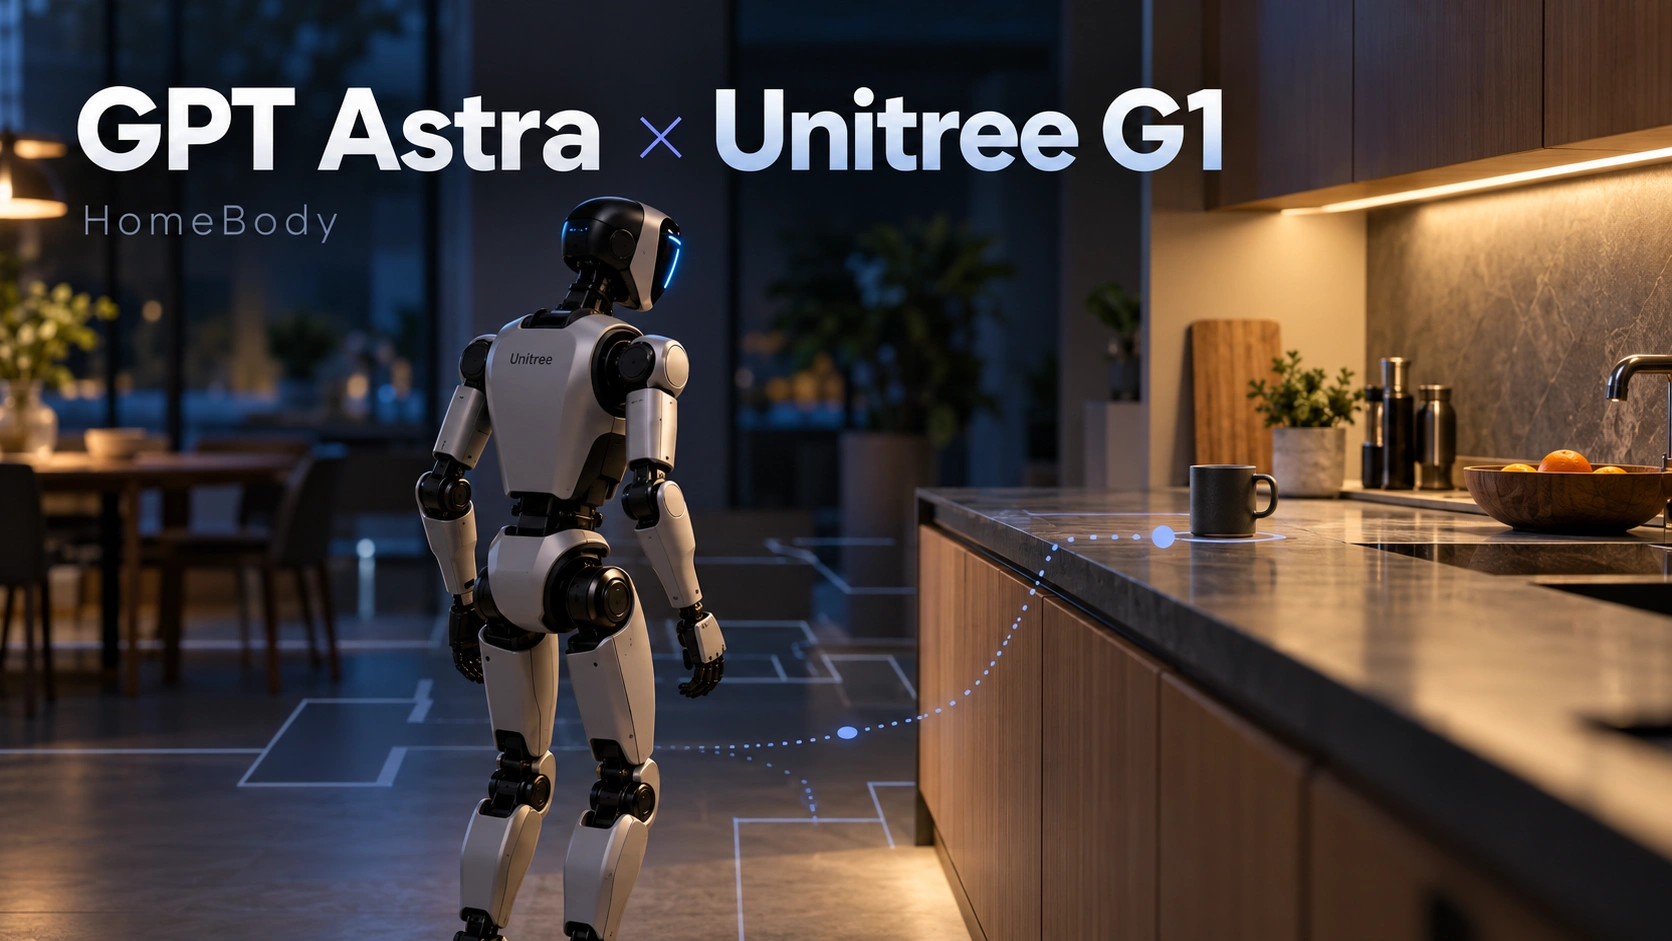
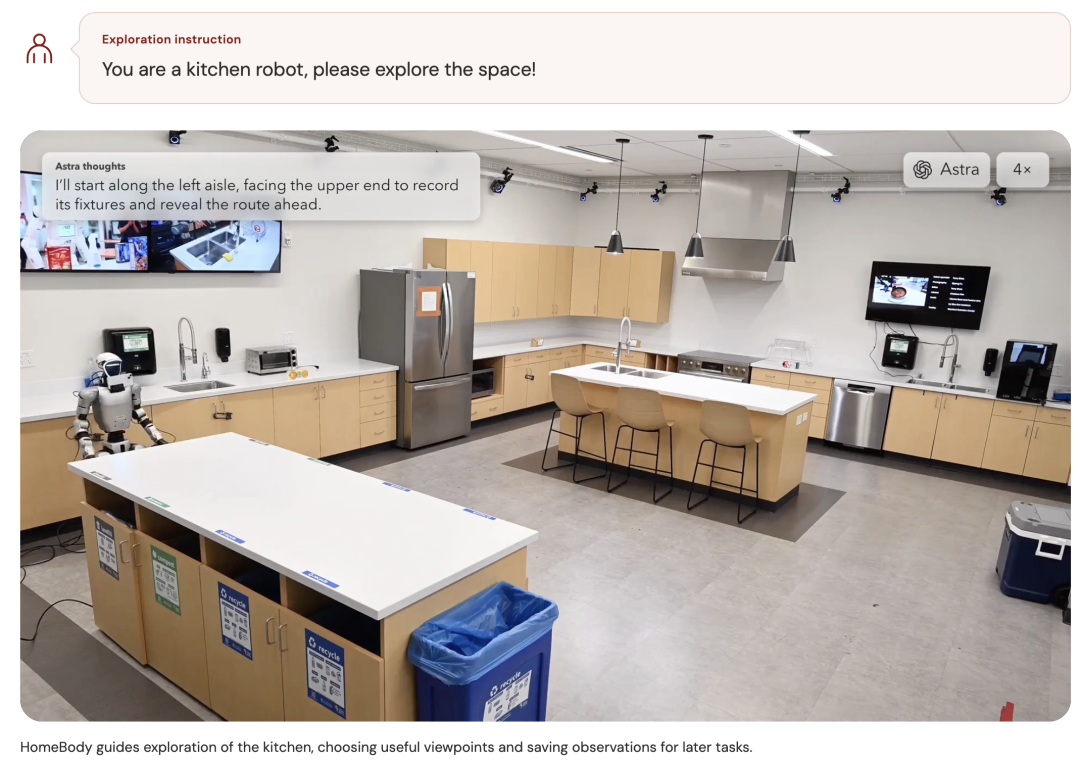
Um humanoide Unitree G1 foi demonstrado explorando uma cozinha desconhecida, lembrando onde os objetos estão, organizando itens espalhados pelo ambiente, abrindo gavetas, recuperando medicamentos que já não estavam visíveis e entregando-os a uma pessoa.
O projeto se chama HomeBody e foi desenvolvido por pesquisadores da Stanford University e do Caltech.
Sua ideia central é surpreendentemente simples:
Permitir que um modelo de visão e linguagem de fronteira trate as habilidades do robô como ferramentas.
Em vez de pedir ao modelo que gere cada comando articular, o HomeBody permite que o GPT Astra compreenda a tarefa, decida o que deve acontecer em seguida e chame habilidades reutilizáveis para navegação, pegar, colocar, abrir gavetas e recuperar objetos.
Isso transforma o modelo em um planejador de alto nível, em vez de um controlador motor de baixo nível.
O resultado é um fluxo de trabalho robótico com horizonte mais longo do que a configuração habitual de “ver o objeto, pegá-lo e parar”.
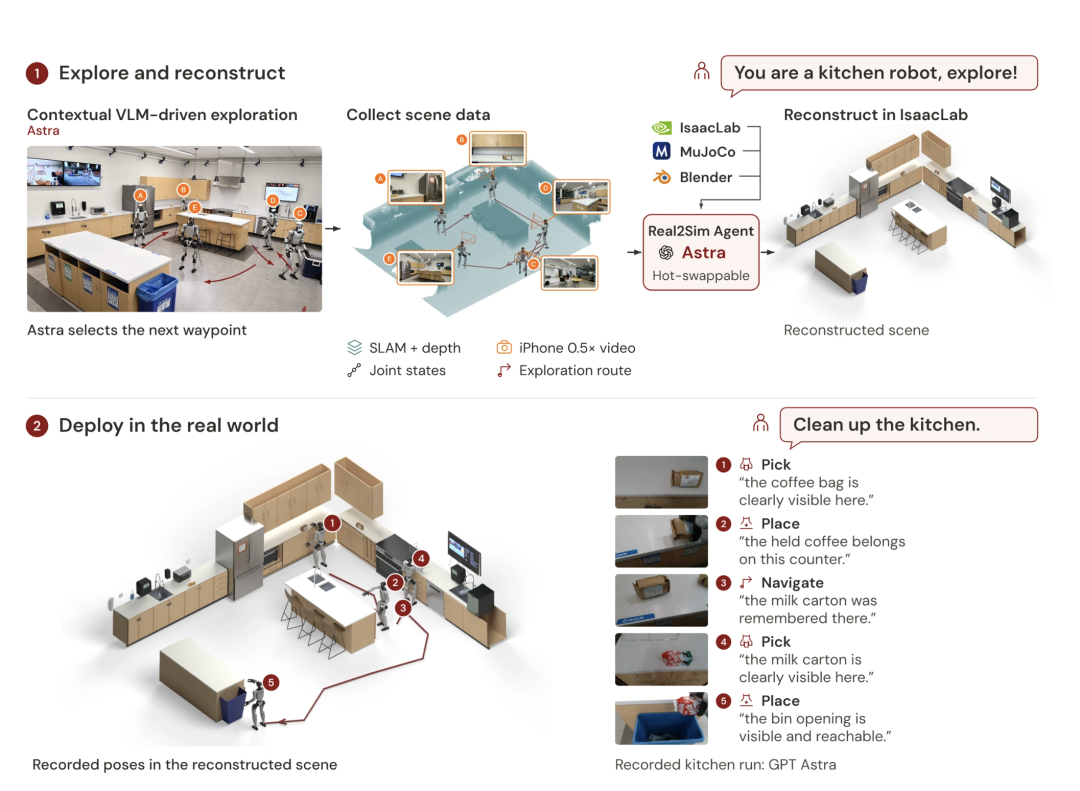
Na demonstração da cozinha, o robô primeiro explora o ambiente e constrói uma memória espacial persistente. Em seguida, reconstrói um gêmeo digital, alinha essa representação com o ambiente real e usa observações armazenadas para concluir instruções posteriores.
Por exemplo, o usuário pode dizer:
“Arrume a cozinha. Coloque os pacotes de café na ilha e jogue fora as caixas estragadas.”
O G1 então se desloca entre diferentes locais, recolhe os pacotes de café e descarta as caixas especificadas.
Uma segunda tarefa é ainda mais reveladora:
“Esqueci meu remédio, você pode buscá-lo para mim? Além disso, jogue fora a caixa estragada enquanto estiver por aí.”
O medicamento não está visível quando o pedido é feito.
O HomeBody pesquisa sua memória espacial armazenada, recorda a gaveta onde o medicamento havia sido observado anteriormente, navega até lá, abre a gaveta, recupera o medicamento, entrega-o à pessoa e ainda conclui a tarefa de descartar a caixa.
Essa é a mudança importante.
O robô já não reage apenas ao que está diante de sua câmera naquele momento. Ele combina percepção atual, observações lembradas, geometria do ambiente, navegação, manipulação e sequenciamento de tarefas em todo o espaço.
Permitir que o GPT trate as habilidades do robô como ferramentas
O design central do HomeBody pode ser resumido em uma frase:
O GPT Astra escolhe e sequencia habilidades robóticas por meio de chamadas estruturadas de ferramentas.
O modelo é responsável por compreender o objetivo do usuário e decidir o que precisa acontecer em seguida.
A pilha robótica cuida dos detalhes físicos.
Uma visão simplificada é a seguinte:
Instrução do usuário
      ↓
GPT Astra / System 2
      ↓
Escolher habilidade + alvo
      ↓
Navegação / Pegar / Colocar / Abrir gaveta / Pegar na gaveta
      ↓
Percepção + planejamento de movimento + controle de baixo nível
      ↓
Resultado da execução
      ↓
Retornar o resultado ao GPT Astra
      ↓
Escolher a próxima ação
Antes que o robô possa buscar algo em uma cozinha desconhecida, porém, ele precisa de mais do que uma biblioteca de habilidades.
Ele precisa saber como é a cozinha e onde estão localizados os objetos lembrados.
O HomeBody constrói esse contexto em três etapas.
Etapa 1: explorar a cozinha e construir uma memória espacial
A primeira instrução é deliberadamente simples:
Você é um robô de cozinha; explore o espaço!
O GPT Astra então seleciona pontos de vista úteis e guia o G1 pelo ambiente.
Durante a exploração, o HomeBody coleta várias formas de dados, incluindo:
- Observações da câmera egocêntrica do humanoide.
- Vídeo de iPhone em 0,5× usado pelo pipeline de reconstrução do projeto.
- Observações da câmera Intel D435i.
- Varreduras LiDAR.
- Geometria de SLAM.
- Poses das articulações.
- Pontos de passagem do robô selecionados durante a exploração.
A câmera mostra o conteúdo do ambiente.
O LiDAR e outros sensores fornecem a estrutura espacial medida.
O SLAM — localização e mapeamento simultâneos — ajuda o robô a construir um mapa enquanto estima sua própria posição dentro dele.
A parte crucial é a persistência.
Quando o G1 se afasta de um objeto, a informação não desaparece junto com a imagem da câmera.
O HomeBody armazena observações e as associa a localizações para que tarefas posteriores possam recuperá-las.
É assim que um pedido como “traga meu remédio” ainda pode funcionar mesmo quando o medicamento está escondido em uma gaveta ou fora do campo de visão do robô.
Etapa 2: reconstruir a cozinha real em simulação
A exploração, por si só, não é suficiente.
Em seguida, o HomeBody usa o GPT Astra como um agente Real2Sim para criar uma reconstrução digital do ambiente no NVIDIA Isaac Sim.
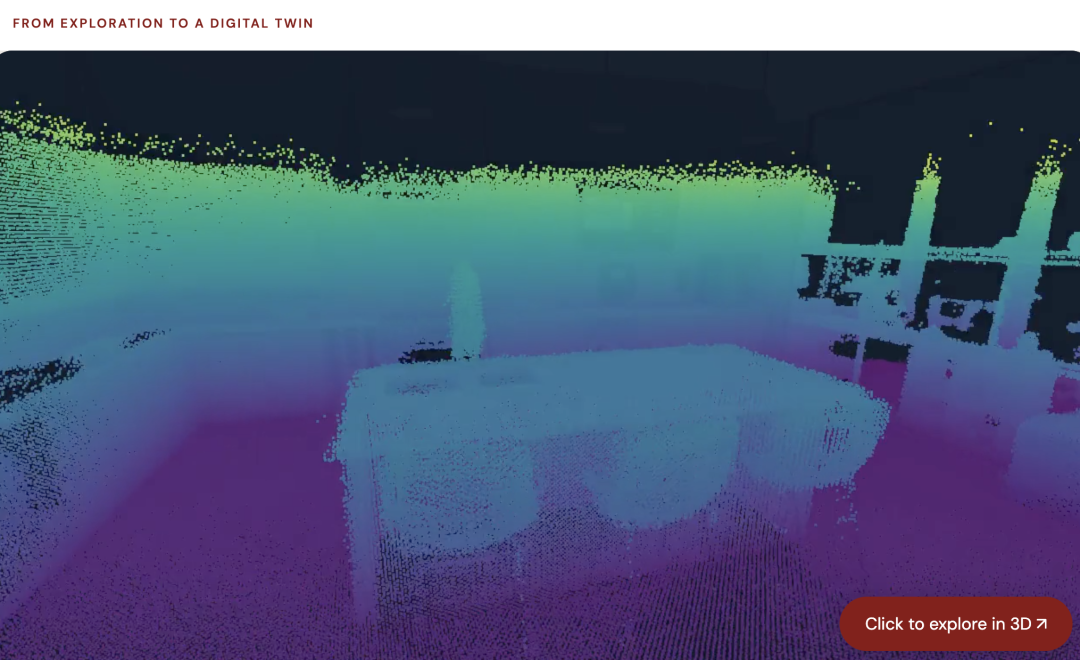
O gêmeo digital funciona como um modelo espacial da cozinha.
Ele fornece ao sistema uma representação estruturada de:
- Layout do ambiente.
- Posições das bancadas.
- Localização das gavetas.
- Espaço navegável.
- Relações entre o robô e os objetos-alvo.
É importante destacar que a reconstrução não se baseia apenas na aparência.
O HomeBody também alimenta o processo Real2Sim com a geometria de SLAM medida.
Isso fornece restrições dimensionais do mundo real à reconstrução.
Isso importa porque uma reconstrução visualmente atraente não é suficiente para a robótica.
O robô precisa saber se uma passagem é realmente larga o bastante para atravessar, se o corpo pode ficar suficientemente próximo de uma gaveta e se um braço consegue alcançar um alvo sem colidir com o ambiente.
O sistema então alinha o mapa de SLAM do mundo real com a simulação reconstruída em um sistema de coordenadas compartilhado.
As observações armazenadas da câmera, as descrições semânticas e as localizações do robô podem ser conectadas a lugares físicos no ambiente.
Assim, em vez de lembrar apenas:
Vi uma garrafa de remédio.
O HomeBody pode preservar algo mais próximo de:
Vi o remédio nesta gaveta,
nesta localização lembrada,
dentro do sistema de coordenadas compartilhado do ambiente.
É isso que torna possível a recuperação posterior.
Etapa 3: dar um objetivo ao robô e permitir que ele sequencie as habilidades
Depois da exploração e da reconstrução, o usuário pode emitir uma tarefa cotidiana.
Por exemplo:
Arrume a cozinha.
Coloque os pacotes de café na ilha
e jogue fora as caixas estragadas.
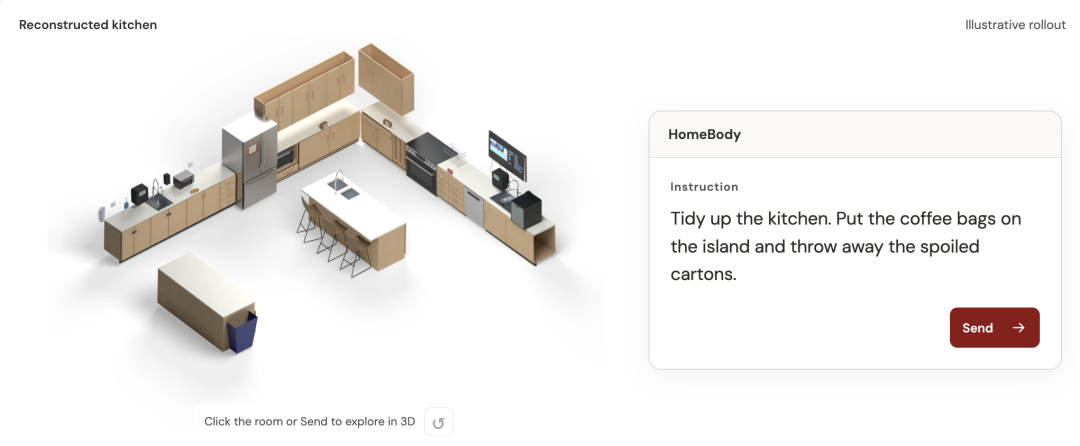
Em cada etapa, o GPT Astra pode considerar:
- A observação atual da câmera.
- O mapa espacial.
- Quadros-chave salvos e objetos lembrados.
- A pose atual do G1.
- Qual mão está segurando um objeto.
- O resultado da habilidade anterior.
- As subtarefas restantes.
Em seguida, ele seleciona a próxima habilidade e o alvo.
A demonstração do medicamento mostra por que isso é útil.
O usuário não especifica a gaveta.
O modelo pode recordar uma observação anterior, navegar de volta à área correta, abrir a gaveta, recuperar o frasco, entregá-lo e continuar com a instrução de limpeza restante.
A tarefa é longa o bastante para que nenhum único quadro da câmera contenha todas as informações necessárias para concluí-la.
É exatamente nesse ponto que a memória espacial persistente se torna valiosa.
O GPT planeja a tarefa — mas quem controla o corpo?
Esse é o detalhe arquitetural mais importante do HomeBody.
É fácil ouvir “o GPT controla um robô humanoide” e imaginar que o modelo de linguagem gera diretamente cada ângulo das articulações.
Não é isso que o sistema faz.
Trabalhos anteriores, como o RoboCurve, demonstraram modelos de fronteira controlando tarefas com braços robóticos ao observar imagens da câmera e o estado do robô, usando então ferramentas que especificam a posição, a orientação e o estado de abertura ou fechamento da pinça.
O HomeBody opera em um nível de abstração mais alto.
O modelo chama habilidades reutilizáveis completas.
O projeto explica a pilha comum de um humanoide com três níveis conceituais:
- System 2: um modelo de visão e linguagem que interpreta observações e instruções e decide o que deve acontecer.
- System 1: frequentemente, um modelo de visão-linguagem-ação aprendido que produz comandos de ação.
- System 0: o controlador de baixo nível que coordena o corpo do robô.
Uma arquitetura convencional de ação aprendida pode ser semelhante a esta:
VLM System 2
     ↓
VLA System 1
     ↓
Controlador de corpo inteiro System 0
O HomeBody modifica o meio dessa cadeia.
Em vez de exigir que um VLA aprendido traduza a intenção de alto nível em ação, o VLM chama diretamente uma biblioteca de habilidades combináveis.
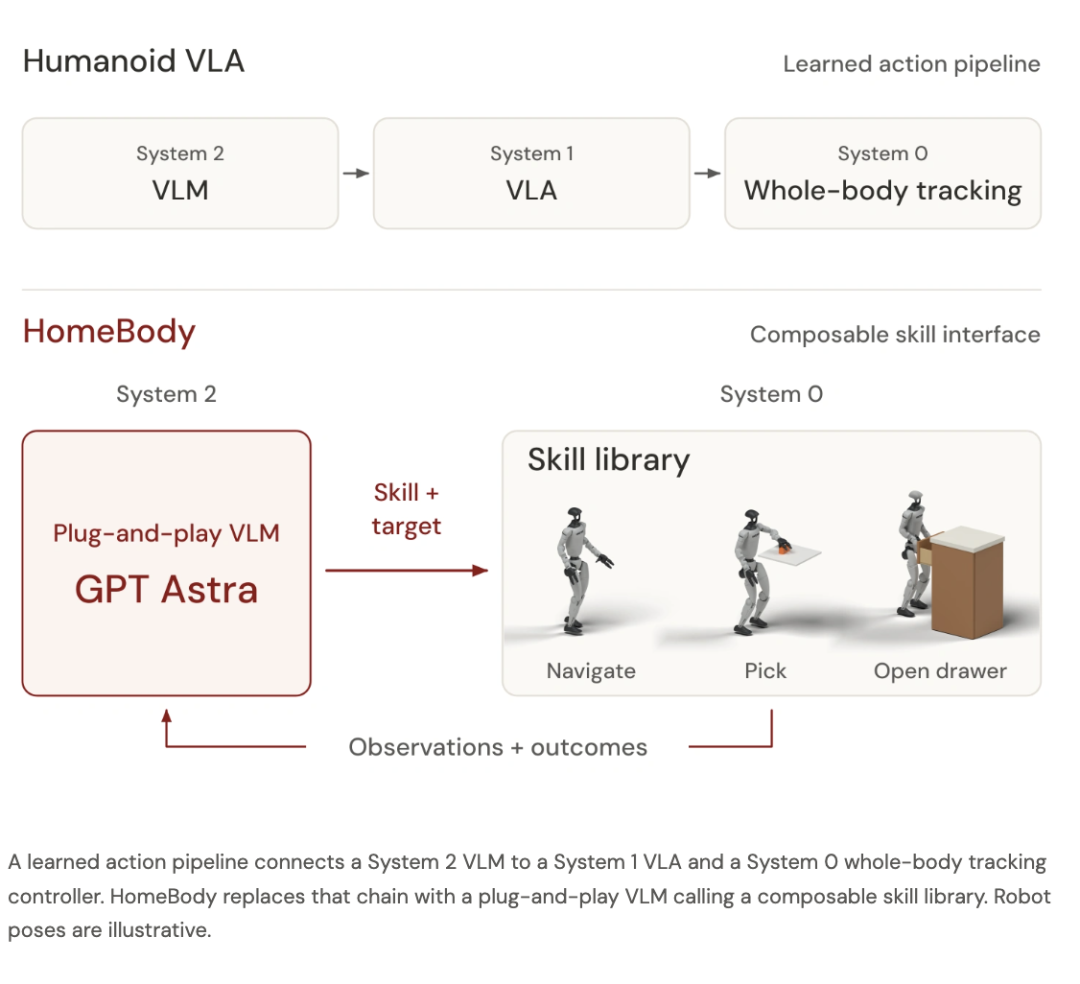
A estrutura resultante é mais próxima de:
VLM System 2
     ↓
Biblioteca de habilidades
     ↓
Planejamento de movimento + percepção
     ↓
Controle de corpo inteiro System 0
A biblioteca de habilidades
O vocabulário atual de habilidades do HomeBody inclui:
| Habilidade | O que o modelo de alto nível fornece | O que a habilidade gerencia |
|---|---|---|
| Navegar | Localização e orientação do alvo | Planejamento da rota e execução da locomoção |
| Pegar | Ponto na imagem e escolha da mão | Segmentação, profundidade, pose de preensão, trajetória do braço e novas tentativas |
| Colocar | Mão e alvo tridimensional de liberação | Levar o objeto segurado até o alvo e soltá-lo |
| Abrir gaveta | Alvo da gaveta ou da alça | Alinhamento, postura de engate e sequência de puxada para trás |
| Pegar na gaveta | Alvo do objeto dentro da gaveta aberta | Alcance, preensão, elevação e lógica de novas tentativas locais |
Todas as habilidades compartilham uma interface para alvos e resultados de execução.
O modelo não precisa compreender a implementação interna de baixo nível de cada habilidade.
Ele precisa apenas decidir qual habilidade deve ser executada e qual deve ser seu alvo.
Como funciona a ação de pegar
Para uma ação de pegar, o GPT Astra seleciona um ponto na imagem da câmera egocêntrica e escolhe qual mão usar.
A partir daí, a pilha de habilidades assume o controle.
De acordo com a implementação do HomeBody:
- O ponto de imagem selecionado inicia a segmentação.
- O Fast-FoundationStereo estima a profundidade a partir de imagens estéreo da D435i.
- A calibração da câmera projeta a geometria segmentada em 3D.
- O sistema prevê analiticamente uma preensão.
- O planejador do braço constrói uma referência de spline com temporização de jerk mínimo.
- A cinemática inversa resolve a trajetória do braço.
- Verificações de colisão são aplicadas ao movimento percorrido.
- O controlador de baixo nível executa o plano.
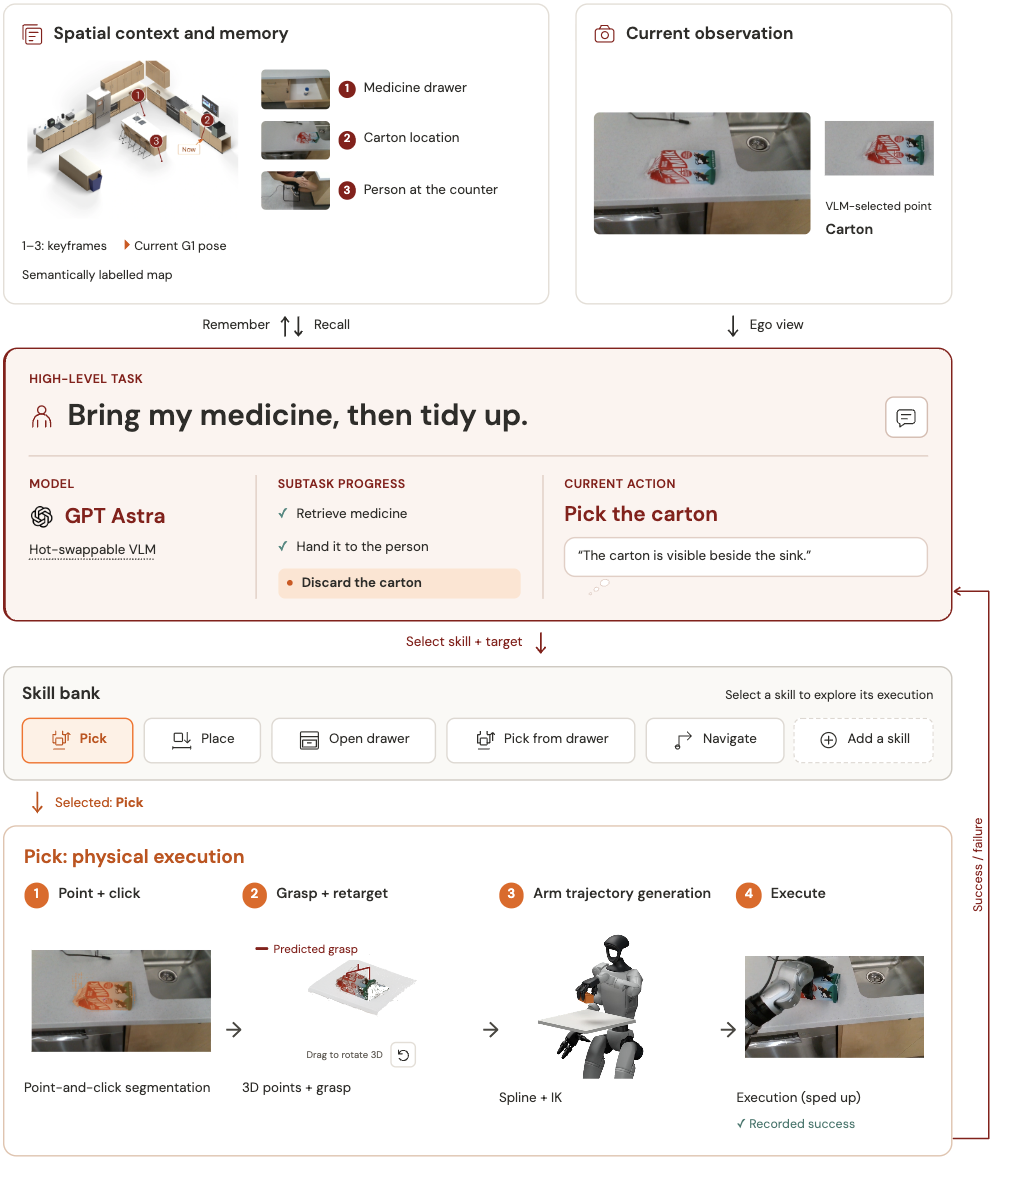
Em outras palavras:
O GPT decide o que pegar
e qual mão usar.

A habilidade robótica decide
como a mão chega fisicamente até lá.
Essa separação mantém o modelo de fronteira concentrado no raciocínio e no sequenciamento de tarefas, em vez de responsabilizá-lo pelo controle motor em tempo real.
Como o robô corrige erros
O mundo físico é ruidoso.
Um objeto pode mudar de posição na imagem da câmera enquanto o robô se aproxima.
Uma preensão pode se fechar sem fazer contato.
O robô pode precisar ajustar sua postura.
Por isso, o HomeBody não exige uma nova decisão do GPT para cada pequena correção.
O projeto usa segmentação e rastreamento SAM 2.1 com seleção de memória no estilo SAMURAI para acompanhar os alvos entre os quadros.
A servoing visual pode então corrigir o alinhamento localmente.
Se uma preensão falhar, a habilidade pode tentar outro candidato de preensão ou reposicionar o robô e refazer o planejamento.
Essas novas tentativas locais são limitadas.
Quando a habilidade local já não consegue se recuperar, ela envia o motivo da falha de volta ao GPT Astra.
O VLM pode então escolher outro alvo, reposicionar o robô ou alterar o plano de alto nível.
O ciclo passa a ser:
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Decidir
  ↓
Executar habilidade
  ↓
Observar o resultado
  ↓
Nova tentativa local, se possível
  ↓
Retornar o resultado ao GPT Astra
  ↓
Refazer o planejamento, se necessário
É assim que várias habilidades podem ser encadeadas em uma sequência mais longa, como:
Navegar até a gaveta
→ Abrir a gaveta
→ Pegar o remédio
→ Navegar até a pessoa
→ Entregar o remédio
→ Encontrar a caixa
→ Jogar a caixa fora
Caminhada e equilíbrio de corpo inteiro continuam sendo um problema de controle separado
Mesmo quando o planejador de alto nível seleciona a habilidade correta, um humanoide ainda precisa manter o equilíbrio ao caminhar e alcançar objetos.
O HomeBody usa o AMO (Adaptive Motion Optimization) pré-treinado para o controle da parte inferior do corpo considerando a parte superior.
O controlador leva em conta os alvos da parte superior do corpo enquanto coordena a locomoção.
Segundo a página do projeto, os comandos do braço e da mão são executados a 250 Hz, enquanto a política AMO é atualizada a cada quinto ciclo de controle, a 50 Hz.
Essa é outra razão pela qual a expressão “sem treinamento adicional” precisa de contexto.
A nova cozinha não exige uma política de ação recém-treinada e específica para o ambiente.
Mas o sistema ainda depende de componentes previamente treinados e projetados sob o VLM.
Não haver novo treinamento para a cozinha não significa não haver uma pilha robótica
Uma das afirmações mais fortes do HomeBody é que ele pode operar em uma cozinha nunca vista antes sem coletar dados de treinamento específicos do ambiente ou aprender uma nova política de ação para aquele espaço.
Isso é relevante.
A implantação tradicional de robôs frequentemente exige demonstrações, treinamento de políticas ou ajustes específicos do ambiente antes que o robô possa agir de forma confiável.
O HomeBody, em vez disso, combina:
- Exploração.
- Memória espacial.
- Reconstrução Real2Sim.
- Raciocínio de fronteira de uso geral.
- Habilidades robóticas reutilizáveis.
- Modelos de percepção existentes.
- Planejamento de movimento.
- Um controlador de corpo inteiro pré-treinado.
Isso transfere parte do esforço de adaptação do retreinamento para raciocínio + mapeamento + ferramentas reutilizáveis.
O fluxo completo do HomeBody pode ser resumido assim:
Explorar um ambiente desconhecido
        ↓
Coletar observações egocêntricas + SLAM + poses
        ↓
Construir um gêmeo digital com Real2Sim
        ↓
Alinhar os sistemas de coordenadas real e simulado
        ↓
Armazenar observações espaciais
        ↓
Receber uma instrução cotidiana
        ↓
GPT Astra escolhe habilidade + alvo
        ↓
A pilha robótica local executa
        ↓
Retornar o resultado
        ↓
Continuar até a conclusão da tarefa
O custo atual de computação e implantação
A demonstração de pesquisa é impressionante, mas não equivale a comprar um G1, inserir uma chave de API e obter um robô doméstico.
A pilha atual do HomeBody ainda precisa de uma infraestrutura robótica significativa.
Os pesquisadores relatam que a percepção, o planejamento de movimento e a execução de habilidades rodam em um único laptop Razer Blade com GPU RTX 4090.
O GPT Astra roda remotamente e envia solicitações de habilidades e alvos para a máquina local.
Isso significa que a arquitetura é dividida entre dois ambientes computacionais:
Modelo de fronteira remoto
→ raciocínio de alto nível e seleção de habilidades

Sistema local com RTX 4090
→ percepção, geometria, planejamento, habilidades e execução
O projeto também lista vários custos e restrições práticas.
Tempo de configuração do Real2Sim
O gêmeo digital precisa ser criado antes que o fluxo completo possa usar sua representação espacial.
Isso acrescenta tempo de preparação.
Custo de API
O modelo de fronteira remoto é chamado durante o planejamento e o trabalho de Real2Sim.
Isso acrescenta despesas de API.
Latência de raciocínio
O Astra não responde instantaneamente.
Os pesquisadores observam pausas entre as habilidades enquanto o raciocínio de alto nível é concluído.
Em tarefas domésticas, essas pausas importam porque as tarefas físicas já levam muito mais tempo do que as puramente digitais.
Durabilidade do hardware
A manipulação humanoide prolongada também enfrenta limites mecânicos.
A página do HomeBody menciona especificamente superaquecimento dos servos dos dedos durante operações prolongadas.
Limitações de manipulação e alcance
O robô só pode executar tarefas compatíveis com suas mãos, alcance, equilíbrio, percepção e conjunto de habilidades implementado.
Portanto, o projeto é uma demonstração de pesquisa sobre autonomia de longo horizonte, e não um assistente doméstico geral já capaz de realizar tarefas arbitrárias.
Modelos grandes estão se tornando planejadores de robôs
O HomeBody faz parte de uma onda mais ampla de trabalhos que conectam modelos de fronteira a robôs físicos.
O artigo-fonte destaca três abordagens cada vez mais comuns.
Rota 1: o modelo de fronteira seleciona diretamente comandos do efetuador final
Em uma configuração no estilo RoboCurve, o modelo recebe imagens e o estado do robô e, em seguida, chama ferramentas que especificam alvos como:
- Posição da pinça.
- Orientação da pinça.
- Estado de abertura/fechamento.
Uma pilha de cinemática inversa ou controle de baixo nível converte esses alvos em movimento robótico.
O modelo permanece em um ciclo frequente de observar-decidir-agir.
Rota 2: VLM System 2 + VLA aprendido + controlador System 0
Uma segunda abordagem usa um modelo de linguagem e visão de fronteira para o raciocínio lento de alto nível e um VLA aprendido para a geração de ações.
Conceitualmente:
Planejador VLM
→ modelo de ação VLA
→ controlador de baixo nível
Isso mantém o modelo de fronteira acima da camada motora, mas ainda usa uma política aprendida para converter planos em ações físicas.
Rota 3: VLM System 2 + biblioteca de habilidades combináveis + System 0
O HomeBody segue um caminho diferente.
Ele remove a exigência de um VLA aprendido no meio da cadeia e permite que o VLM de fronteira invoque diretamente habilidades reutilizáveis.
Essas habilidades podem ser algoritmos clássicos, políticas aprendidas ou outros controladores.
O projeto HomeBody permite explicitamente adicionar novas habilidades por meio da interface compartilhada.
Isso torna a arquitetura modular:
Substitua o VLM
ou
adicione uma nova habilidade
sem redesenhar toda a pilha robótica
A ideia mais profunda não é simplesmente “adicionar outra camada System 0”.
É uma conexão diferente entre raciocínio e execução física.
Combinada à memória espacial, essa conexão permite que o robô trabalhe em um ambiente inteiro, em vez de apenas em torno de uma mesa.
As comparações robóticas mais recentes do RoboCurve
O artigo-fonte termina analisando resultados de avaliações de controle robótico de terceiros do RoboCurve.
Esses resultados devem ser interpretados como medições de benchmarks robóticos específicos de tarefas, e não como afirmações universais sobre a inteligência geral dos modelos.
GPT-6 Sol versus GPT-5.6 Sol
No resultado do RoboCurve compartilhado por Jay Chooi, o GPT-6 Sol teria obtido uma pontuação cerca de 1,6 vez maior que a do GPT-5.6 Sol no conjunto de tarefas robóticas, com custo cerca de 47% menor por teste.
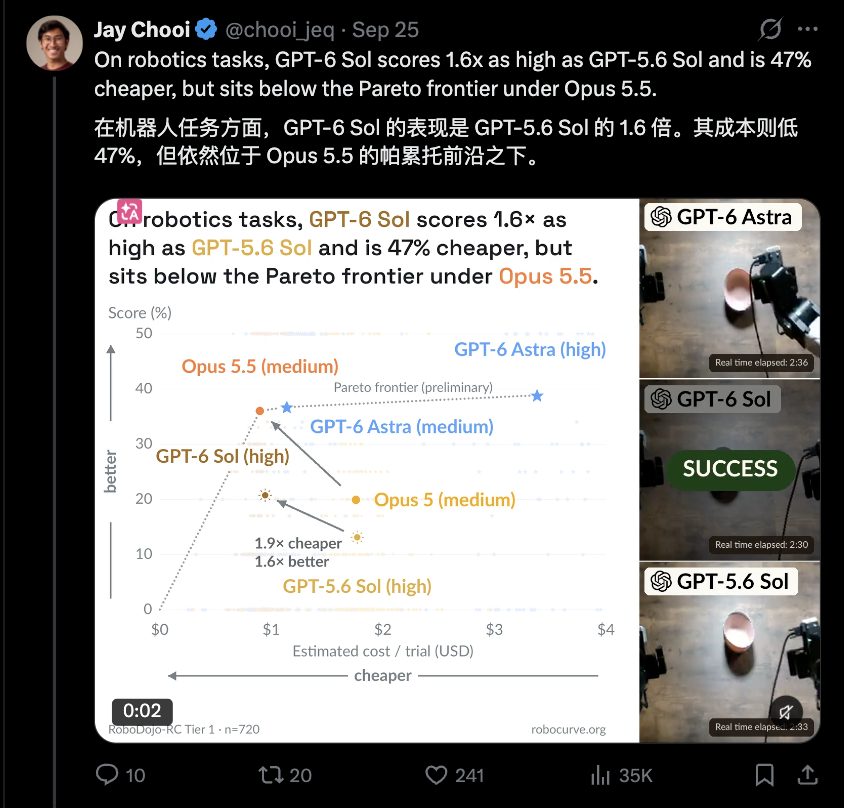
O mesmo gráfico colocou o GPT-6 Sol abaixo da fronteira preliminar de Pareto estabelecida por configurações mais fortes do Opus 5.5 nessa avaliação.
Isso fornece uma evidência útil de que custo e desempenho no controle robótico nem sempre evoluem juntos.
Um modelo mais barato pode ser uma escolha operacional melhor mesmo quando outro modelo ainda alcança uma pontuação mais alta.
Opus 5.5 versus Opus 5 e Astra
Um resultado separado do RoboCurve abrangeu 360 testes robóticos.
A média divulgada mostrou o Opus 5.5 alcançando uma pontuação aproximadamente 1,8 vez maior que a do Opus 5, por cerca de metade do custo, ao mesmo tempo que igualava aproximadamente a pontuação média do Astra com um custo cerca de 21% menor.
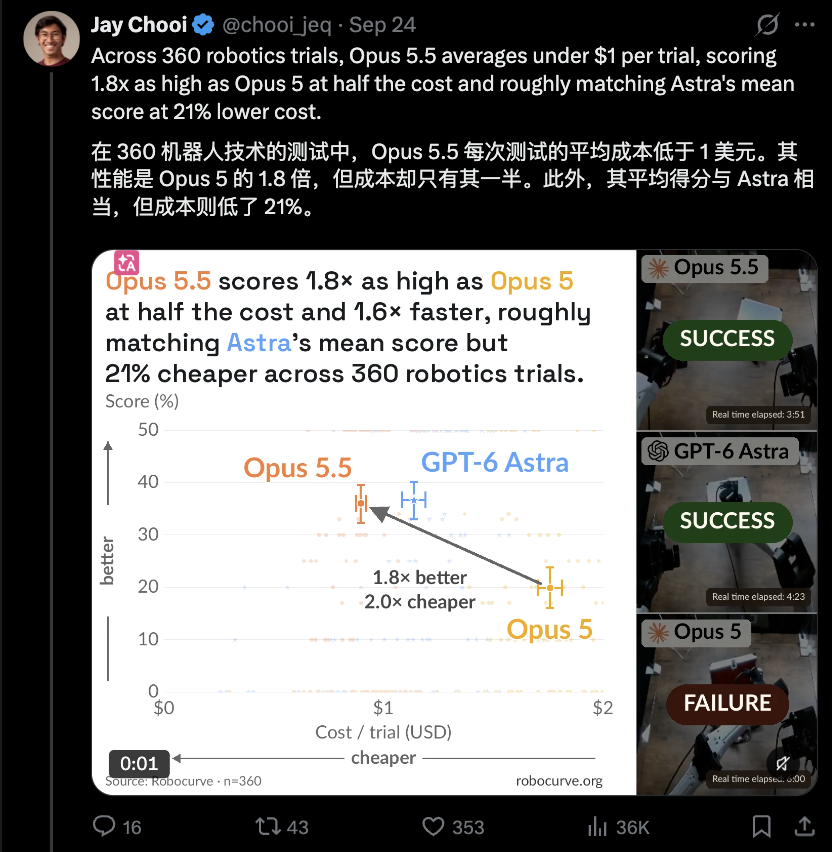
Novamente, esse não é um benchmark geral da Anthropic ou da OpenAI.
É uma avaliação de controle robótico de terceiros realizada em um conjunto específico de tarefas, hardware, prompts e condições de teste.
Essa distinção importa porque o desempenho em IA incorporada depende do sistema inteiro:
Modelo
×
Prompting
×
Hardware robótico
×
Percepção
×
Pilha de controle
×
Design das habilidades
×
Definição da tarefa
Um modelo que apresenta o melhor desempenho em um benchmark de programação pode não ser o modelo com a melhor relação custo/desempenho ao controlar um robô.
Por que o HomeBody é importante
A parte mais interessante do HomeBody não é o fato de um humanoide ter movido um pacote de café.
Robôs manipulam objetos há anos.
A mudança importante é arquitetural.
O HomeBody mostra uma forma prática de combinar:
- Raciocínio multimodal de fronteira.
- Memória espacial persistente.
- Mapeamento do mundo real.
- Simulação.
- Habilidades de manipulação reutilizáveis.
- Controle de locomoção de corpo inteiro.
O modelo de fronteira não precisa aprender todos os detalhes motores.
O robô não precisa de uma nova política de ponta a ponta treinada especificamente para cada cozinha.
Em vez disso, um modelo geral raciocina sobre um ambiente estruturado e orquestra capacidades reutilizáveis.
Isso se assemelha à forma como os agentes de software funcionam cada vez mais:
O modelo raciocina
→ chama ferramentas
→ lê os resultados
→ escolhe a próxima ferramenta
O HomeBody leva o mesmo padrão ao mundo físico.
As ferramentas já não são pesquisa na web, Python ou um banco de dados.
São:
Navegar
Pegar
Colocar
Abrir gaveta
Pegar na gaveta
É por isso que o projeto parece um passo importante para os agentes incorporados.
Perguntas frequentes
O que é o HomeBody?
O HomeBody é um sistema de pesquisa de Stanford e Caltech que fornece a um robô humanoide memória espacial persistente e uma biblioteca de habilidades motoras combináveis. Um modelo de visão e linguagem de fronteira planeja tarefas de longa duração e chama essas habilidades por meio de interfaces estruturadas de ferramentas.
O GPT-6 Astra controla diretamente todas as articulações do Unitree G1?
Não. A página do projeto HomeBody identifica o planejador como GPT Astra e o utiliza como um modelo System 2 de alto nível. Navegação, manipulação, percepção, planejamento de movimento, novas tentativas e controle de corpo inteiro são tratados por módulos robóticos de nível inferior e controladores pré-treinados.
O HomeBody exige treinamento em cada nova cozinha?
Os pesquisadores afirmam que a cozinha desconhecida demonstrada não exige dados de treinamento específicos do ambiente nem aprendizado adicional de políticas. O sistema ainda depende de modelos de percepção pré-treinados, habilidades reutilizáveis, SLAM, software de planejamento e um controlador de corpo inteiro AMO pré-treinado.
Como o robô se lembra de um objeto que já não está visível?
Durante a exploração, o HomeBody armazena observações da câmera egocêntrica junto com o conteúdo semântico e as posições em um sistema de coordenadas espaciais compartilhado. Quando um pedido posterior se refere a um objeto fora do campo de visão, o GPT Astra pode recuperar um quadro-chave armazenado e navegar até a localização lembrada.
Por que o HomeBody constrói um gêmeo digital no Isaac Sim?
A etapa Real2Sim oferece ao planejador de alto nível um modelo espacial estruturado do ambiente. O HomeBody também ancora a reconstrução na geometria de SLAM medida, para que as decisões de navegação e manipulação estejam associadas às dimensões reais, e não apenas à aparência visual.
De qual hardware a implementação atual do HomeBody precisa?
O projeto informa que as habilidades locais, a percepção e o planejamento de movimento rodam em um laptop Razer Blade com GPU RTX 4090, enquanto o GPT Astra roda remotamente. A configuração atual também exige o hardware humanoide, câmeras, componentes de LiDAR/SLAM, rede e a pilha de software robótico do projeto.
O HomeBody está pronto para substituir uma pessoa na realização de tarefas domésticas?
Não. O projeto demonstra uma autonomia relevante de longo horizonte, mas suas próprias limitações incluem o tempo de configuração do Real2Sim, o custo de API, a latência de raciocínio, as limitações de manipulação e problemas de durabilidade do hardware, como o superaquecimento dos servos dos dedos.
Os números do GPT-6 Sol e do Opus 5.5 são benchmarks oficiais dos fornecedores?
Não. Os números discutidos na fonte vêm do RoboCurve, um avaliador independente de terceiros, e se aplicam aos seus conjuntos de tarefas robóticas e às condições dos testes. Eles não devem ser generalizados como rankings gerais de modelos fora desse contexto.
Ferramentas relacionadas
- HomeBody: página oficial do projeto sobre o sistema humanoide de Stanford/Caltech para exploração, memória, Real2Sim e chamada de habilidades.
- Unitree G1: plataforma robótica humanoide usada na demonstração do HomeBody.
- NVIDIA Isaac Sim: framework de simulação robótica usado na reconstrução digital Real2Sim do HomeBody.
- SAM 2: modelo fundamental de segmentação de imagens e vídeos com prompts da Meta, usado na pilha de percepção do projeto.
- Fast-FoundationStereo: sistema da NVIDIA de correspondência estéreo em tempo real e zero-shot, usado para estimar a profundidade a partir de imagens estéreo.
- SAMURAI: sistema de rastreamento visual orientado por movimento, desenvolvido sobre o SAM 2 e referenciado pelo HomeBody para o rastreamento de alvos.
- AMO: controlador pré-treinado de Adaptive Motion Optimization usado na coordenação de corpo inteiro do humanoide.
Links relacionados
- Página oficial do projeto HomeBody: demonstrações completas, arquitetura, detalhes de implementação, perguntas frequentes, limitações e informações de citação.
- Repositório do HomeBody no GitHub: repositório oficial do Stanford-TML para o projeto HomeBody.
- GPT-6 Astra: anúncio oficial da OpenAI sobre o GPT-6 Astra e visão geral de suas capacidades.
- Página do produto Unitree G1: especificações oficiais e notas de segurança da plataforma humanoide G1.
- NVIDIA Isaac Sim: documentação e recursos oficiais da NVIDIA para o framework de simulação usado pelo HomeBody.
- Fast-FoundationStereo: página oficial do projeto do sistema de profundidade estéreo citado pelo HomeBody.
- Página do projeto AMO: detalhes de pesquisa sobre Adaptive Motion Optimization e suas demonstrações com o Unitree G1.
Resumo
O HomeBody mostra como um modelo de fronteira pode se tornar o planejador de alto nível de um humanoide sem gerar diretamente cada comando motor de baixo nível. O GPT Astra explora um ambiente desconhecido, usa uma reconstrução Real2Sim e uma memória espacial persistente e, em seguida, combina habilidades de navegação e manipulação para concluir tarefas de cozinha de longa duração.
A principal escolha de design é a modularidade. O modelo decide o que deve acontecer em seguida, enquanto a percepção, a geometria, o planejamento de movimento, as novas tentativas locais e o controle de corpo inteiro decidem como o robô executará isso fisicamente. Isso permite que o sistema entre em uma nova cozinha sem treinar uma nova política de ação específica do ambiente, embora ainda dependa de uma infraestrutura robótica pré-treinada e projetada de forma significativa.
A implementação atual continua sendo um sistema de pesquisa, e não um robô doméstico pronto para uso: ela precisa de uma máquina local de classe RTX 4090, inferência remota do modelo, configuração de simulação, acesso à API e hardware robótico robusto. Os pesquisadores também documentam limitações de latência e durabilidade que ainda importam em tarefas reais prolongadas.
O passo importante não é simplesmente “o GPT pode controlar um robô”; é que um modelo de uso geral agora pode usar memória espacial e habilidades físicas reutilizáveis de forma semelhante à maneira como um agente de software usa ferramentas.