For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/gpt-6-speed-boost-astra-and-6-1-sol-gain-90356630.md.
A OpenAI iniciou uma sequência de 28 dias de melhorias de produto com uma mudança que os usuários podem sentir imediatamente: **o GPT-6 Astr...
A OpenAI iniciou uma sequência de 28 dias de melhorias de produto com uma mudança que os usuários podem sentir imediatamente: o GPT-6 Astra e o GPT-6.1 Sol agora são aproximadamente 50% mais rápidos por padrão quando usados por meio de assinaturas elegíveis do ChatGPT.
A melhoria se aplica aos produtos da OpenAI e às ferramentas de parceiros compatíveis com Sign in with ChatGPT, incluindo OpenCode, Pi, Amp e Devin.
Nenhuma alteração de código é necessária.
Thibault “Tibo” Sottiaux, líder de engenharia da OpenAI, disse que a velocidade padrão das assinaturas foi otimizada em cerca de 50%. Medições da comunidade indicam, na prática, um salto de aproximadamente 30 tokens por segundo para cerca de 50 tokens por segundo, embora a vazão exata varie de acordo com o modelo, a tarefa, o produto e as condições de execução.
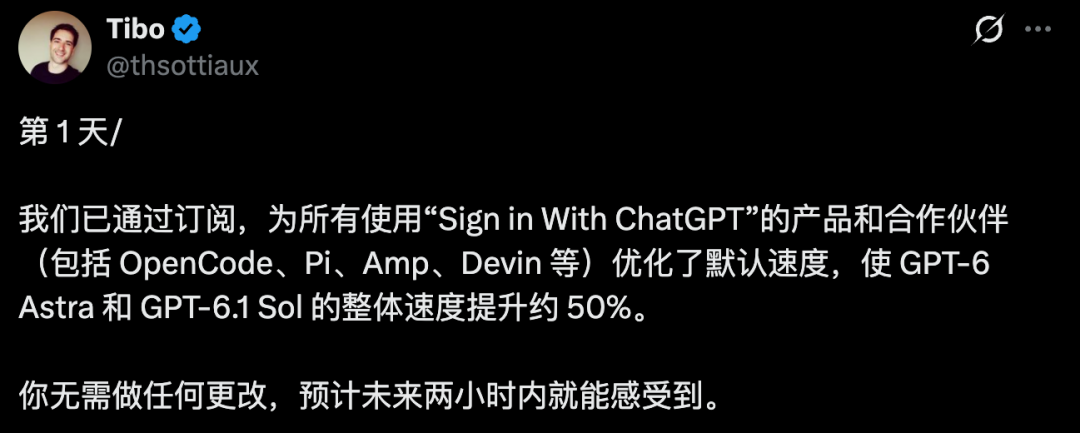
O anúncio de Tibo no Dia 1 afirma que o GPT-6 Astra e o GPT-6.1 Sol estão cerca de 50% mais rápidos por meio do acesso via assinatura.
O momento é relevante porque outra discussão ocorre simultaneamente.
A SemiAnalysis publicou um estudo detalhado de teste de limites comparando assinaturas de IA para consumidores. Sob suas premissas de cargas de trabalho agênticas, as assinaturas do Claude Opus 5.5 fornecem mais de cinco vezes o valor equivalente de API dos planos GPT-6.1 Sol pelo mesmo preço mensal.
Assim, a OpenAI tornou os modelos mais rápidos.
A questão mais difícil é se a economia das assinaturas continua competitiva para usuários que executam fluxos de trabalho longos, autônomos, de programação e de agentes.
A primeira atualização no ciclo de entregas de 28 dias da OpenAI tem como alvo uma das fontes mais evidentes de atrito no trabalho avançado com programação e agentes: a latência de geração.
Tibo escreveu que a OpenAI otimizou a velocidade padrão do GPT-6 Astra e do GPT-6.1 Sol em aproximadamente 50% por meio do acesso via assinatura.
A implementação se aplica a:
O usuário não precisa alterar uma configuração nem trocar um endpoint de API.
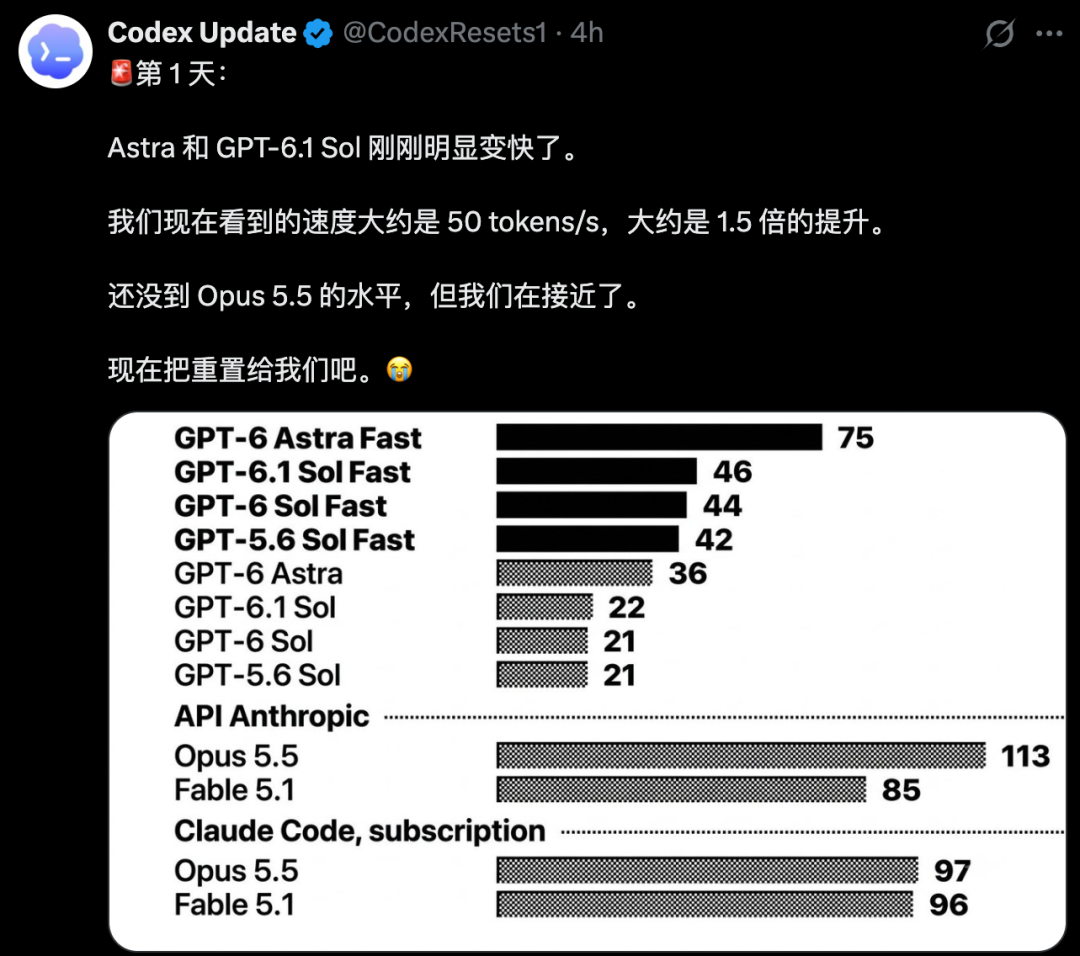
Medições da comunidade mostram um aumento visível de velocidade, embora a vazão difira por modelo e caminho de acesso.
O artigo-fonte resume a alteração como uma passagem aproximada de:
~30 tokens/segundo
        ↓
~50 tokens/segundo
Essa é uma forma útil de resumir a mudança, mas o anúncio oficial é apresentado como “cerca de 50% mais rápido”, e não como um nível de serviço fixo e garantido de 50 TPS.
Testadores diferentes podem observar valores diferentes.
A melhoria de velocidade é a primeira entrada de uma iniciativa mais ampla de 28 dias.
Tibo disse que, nos próximos 28 dias, a OpenAI pretende lançar:
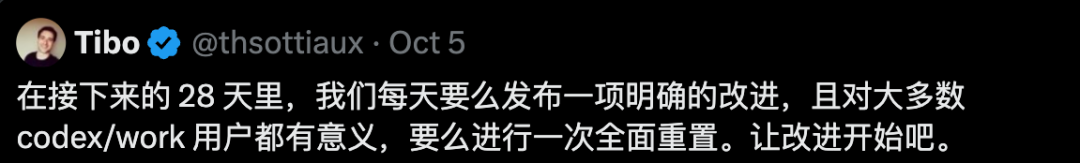
A iniciativa de 28 dias concentra-se em simplificação, eficiência, novas capacidades e melhorias de modelos.
As prioridades declaradas são:
A mensagem é voltada especialmente a usuários de Codex e Work, para os quais tarefas de longa duração tornam a velocidade e os limites de uso muito mais perceptíveis do que em uma conversa curta.
O artigo original afirma que a mudança veio, em parte, de um tokenizador otimizado “agressivo”, que reduz o número de tokens necessários para a mesma tarefa.
Essa afirmação específica deve ser tratada com cautela.
As declarações públicas da equipe da OpenAI analisadas para este artigo descrevem a atualização do Dia 1 como uma otimização de inferência e uma melhoria na velocidade padrão.
Elas não documentam publicamente a implementação de um novo tokenizador para o GPT-6 Astra ou o GPT-6.1 Sol como mecanismo por trás desse ganho específico de 50%.
Essa distinção é importante.
Há diversas maneiras de melhorar a vazão percebida:
Sem uma nota técnica oficial, é mais seguro dizer que a OpenAI otimizou a inferência do que atribuir a melhoria a uma arquitetura específica de tokenizador.
Uma melhoria de 50% na velocidade de geração do modelo não significa que toda tarefa completa será concluída 50% mais cedo.
Os fluxos de trabalho com agentes gastam tempo em mais atividades além da geração de tokens.
Uma tarefa de programação típica pode incluir:
Raciocínio do modelo
      ↓
Chamada de ferramenta
      ↓
Comando de shell ou ação no navegador
      ↓
Leitura/gravação de arquivo
      ↓
Espera de rede
      ↓
Outro turno do modelo
Se ferramentas, sites, compilações, testes ou APIs externas dominarem o tempo de relógio, a geração mais rápida de tokens poderá reduzir apenas parte da duração total da tarefa.
O artigo-fonte também observa que alguns desenvolvedores não perceberam imediatamente uma diferença drástica.
Isso é plausível.
A velocidade percebida depende de:
A atualização é real, mas não deve ser interpretada como uma garantia universal de que toda tarefa de ponta a ponta terminará em dois terços do tempo anterior.
Na mesma semana, a SemiAnalysis publicou uma comparação detalhada dos limites de assinaturas de IA.
Os pesquisadores adquiriram planos de assinatura, executaram cargas de trabalho controladas até que os medidores de uso se movessem ou os limites fossem atingidos e converteram esses limites em um valor em dólares equivalente de API.
A metodologia mede separadamente:
Em seguida, eles combinam essas taxas utilizando uma carga de trabalho agêntica representativa.
A SemiAnalysis testou limites de assinaturas da OpenAI, Anthropic e vários outros provedores de IA.
A comparação principal do artigo-fonte é entre GPT-6.1 Sol e Claude Opus 5.5.
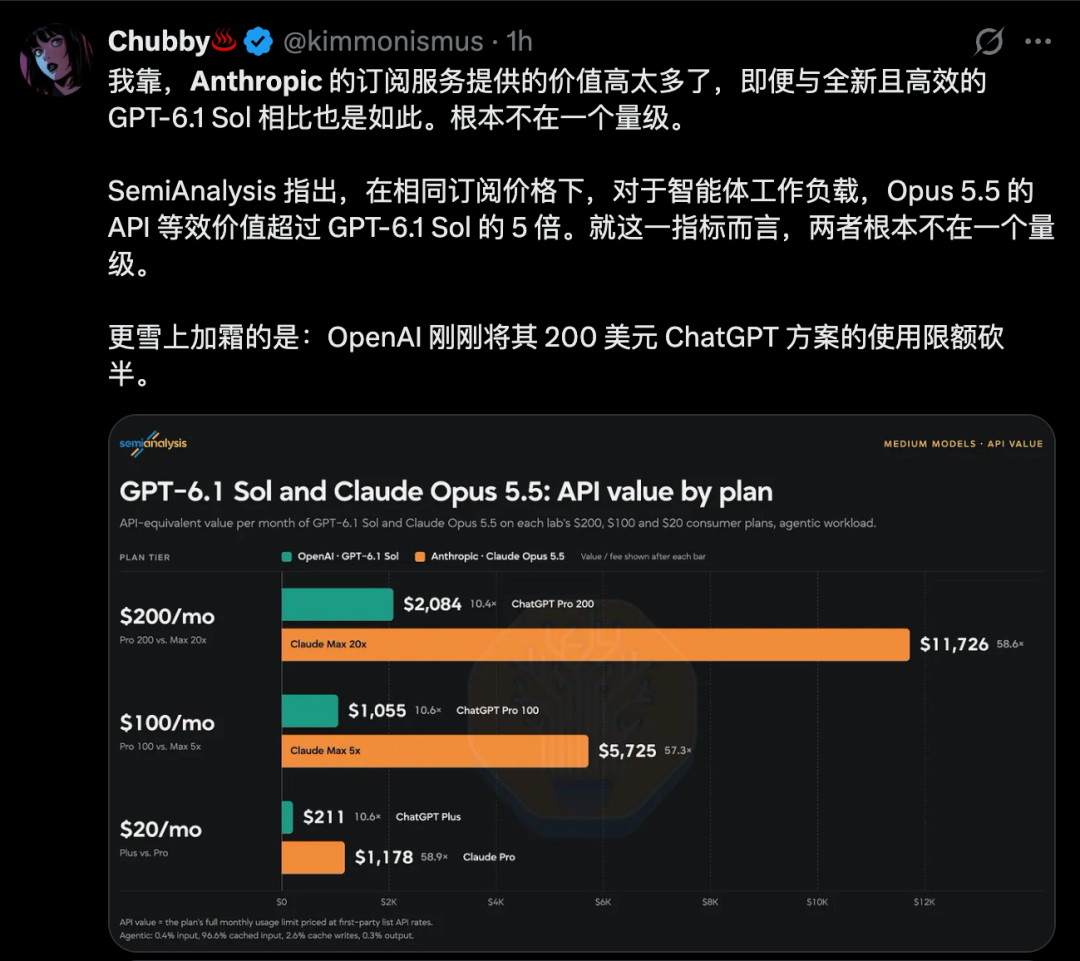
A SemiAnalysis estima uma vantagem superior a cinco vezes para o Claude Opus 5.5 sob suas premissas de carga de trabalho agêntica.
O gráfico publicado apresenta o seguinte panorama:
| Plano mensal | OpenAI / GPT-6.1 Sol | Anthropic / Claude Opus 5.5 | Proporção aproximada |
|---|---|---|---|
| US$ 200 | US$ 2.084 de valor equivalente de API | US$ 11.726 | 5,6× |
| US$ 100 | US$ 1.055 | US$ 5.725 | 5,4× |
| US$ 20 | US$ 211 | US$ 1.178 | 5,6× |
Esses números não significam que uma assinatura Anthropic de US$ 200 paga literalmente US$ 11.726 ao cliente.
Eles significam que, sob os limites medidos pela SemiAnalysis e a combinação de cargas de trabalho assumida, consumir a mesma quantidade por meio dos preços públicos de API custaria, teoricamente, cerca desse valor.
Uma visualização da comunidade da faixa de US$ 200 facilita a percepção da diferença.
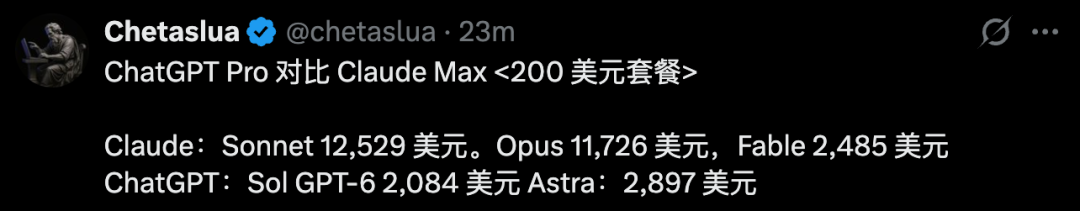
A comparação de US$ 200 varia substancialmente conforme o modelo usado.
A nuance importante é a escolha do modelo.
A SemiAnalysis adverte explicitamente que o valor de uma assinatura não pode ser resumido por um único número universal.
A unidade correta se aproxima mais de:
(plano, modelo, carga de trabalho)
Uma assinatura pode parecer extremamente generosa para um modelo e muito menos generosa para outro.
A SemiAnalysis afirma que a OpenAI fez uma grande mudança nas assinaturas pouco antes do relatório.
Os testes da empresa confirmaram uma redução de aproximadamente 50% nos limites de tokens do plano de US$ 200 da OpenAI para assinaturas recém-adquiridas.
Planos antigos de US$ 200 foram temporariamente mantidos sob os limites anteriores até 29 de outubro.
A SemiAnalysis também observa que a OpenAI introduziu uma nova faixa de US$ 500.
O artigo relata que a faixa de US$ 200 já ofereceu um valor excepcionalmente generoso, sobretudo para usuários intensivos de Codex.
Após a redução, a economia de tokens por dólar das faixas Pro 100, Pro 200 e Pro 500 da OpenAI se tornou muito mais semelhante.
Esse é parte do motivo pelo qual a comparação com a Anthropic parece tão dramática.
O uso tradicional de chat é intermitente.
Uma pessoa faz uma pergunta, lê a resposta, pensa e volta mais tarde.
A programação agêntica pode se comportar de forma muito diferente.
Um único trabalho pode:
Isso gera muito mais atividade de modelo que uma breve troca conversacional.
A SemiAnalysis argumenta que os planos de assinatura são fortemente subsidiados porque a maioria dos usuários não consome sua franquia teórica máxima.
Usuários intensivos de agentes desafiam essa premissa.
O artigo-fonte descreve isso como uma mudança de “a maioria dos usuários não utiliza sua cota completa” para fluxos de trabalho capazes de consumir volumes muito grandes de inferência.
Isso é direcionalmente consistente com a análise mais ampla da SemiAnalysis, embora a utilização exata de equilíbrio dependa de premissas sobre custos de modelo, margens de API, combinação de cargas de trabalho e a economia interna do provedor.
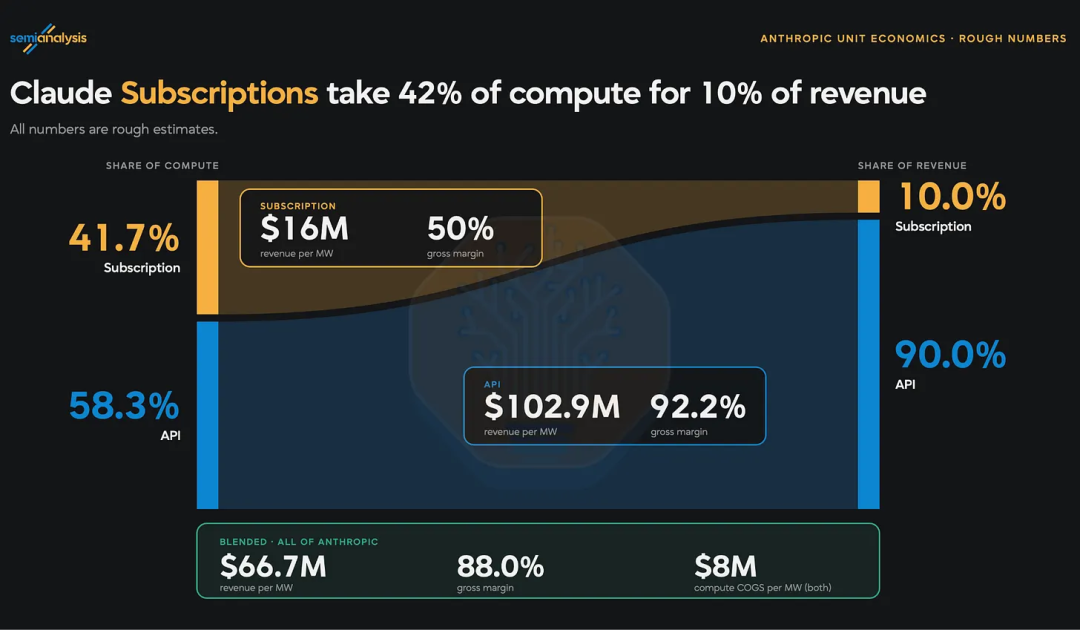
A SemiAnalysis também publicou um modelo aproximado da economia de assinaturas da Anthropic.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A SemiAnalysis estima que assinaturas podem consumir uma parcela muito maior da computação de inferência do que sua participação na receita.
Seus números aproximados sugerem que as assinaturas podem representar apenas cerca de 10% da receita, enquanto consomem mais de 40% da computação de inferência.
Essas são estimativas de modelagem, e não demonstrações financeiras auditadas da Anthropic.
Elas são úteis porque explicam a tensão por trás dos limites de assinaturas.
Empresas de IA querem que seus produtos de assinatura sejam atraentes o suficiente para conquistar usuários, ao mesmo tempo em que evitam que as cargas de trabalho agênticas mais intensivas consumam inferência cara e ilimitada.
Quanto mais autônomos os agentes se tornam, mais difícil fica esse equilíbrio.
O artigo original então passa da velocidade dos modelos e da economia das assinaturas para uma narrativa de produto mais ampla.
Ele cita uma publicação da comunidade que afirma que Chat, Work, Codex e Dots acabarão se fundindo em uma única interface de superaplicativo, com seletores de modelo e controles de raciocínio ocultos dos usuários.
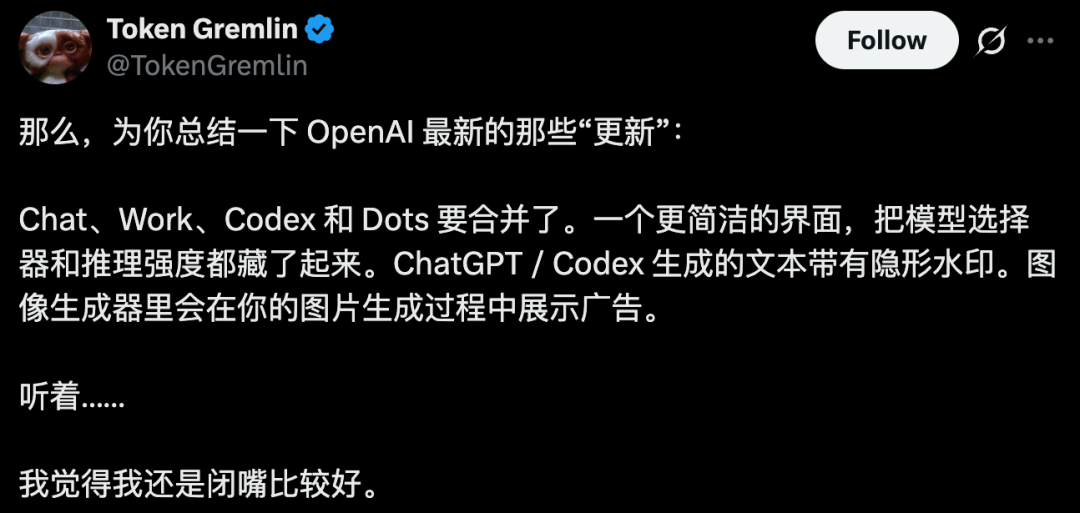
Esta publicação resume alegações da comunidade sobre futura convergência de produtos; nem todas essas alegações são oficiais.
Esta seção exige uma separação clara entre rumor e a realidade atual do produto.
A Central de Ajuda atual da OpenAI informa que:
Portanto, a ideia de uma interface completamente unificada de Chat + Work + Codex + Dots não é um estado de produto atual anunciado.
A OpenAI está claramente simplificando a experiência, mas a alegação mais forte do artigo-fonte de que “tudo está se fundindo” vem de interpretação da comunidade, e não de um roteiro publicado pela OpenAI.
A direção oficial do produto continua significativa.
A OpenAI agora descreve o ChatGPT como incluindo:
Os projetos podem fornecer contexto compartilhado para ambos os modos.
O Work também pode:
Isso significa que o produto já está se afastando de um cenário em que cada recurso vive em uma aplicação separada.
A consolidação é real.
A forma final exata ainda não é pública.
O artigo-fonte sugere que o Codex pode desaparecer em uma interface unificada.
A documentação atual diz o contrário.
O Codex permanece dedicado ao desenvolvimento de software e ao trabalho técnico.
No desktop, os usuários alternam entre ChatGPT e Codex pelo menu no canto superior esquerdo.
O Codex mantém seus próprios fluxos de trabalho e histórico voltados ao desenvolvimento.
Isso pode mudar mais adiante, mas nenhuma fonte oficial analisada para este artigo diz que o Codex está sendo removido como uma experiência distinta.
Dots representam outra parte da estratégia de produto da OpenAI.
Um dot é um agente sempre ativo alimentado pelo GPT-6 Astra.
Ele possui:
Um dot também pode trabalhar por canais de mensagens e, com permissão, conectar-se ao computador local do usuário.
Isso torna os Dots mais próximos de um assistente persistente ou de um trabalhador delegado do que de uma sessão de chat comum.
Também ajuda a explicar por que usuários e observadores esperam que os limites entre produtos se tornem menos nítidos ao longo do tempo.
Chat, Work, Codex e Dots compartilham cada vez mais modelos, ferramentas, arquivos, permissões e infraestrutura de agentes.
Mas infraestrutura compartilhada não é o mesmo que uma fusão confirmada em uma única interface.
O artigo-fonte também relata que o texto gerado pelo ChatGPT e pelo Codex receberá marcas-d'água invisíveis.
Essa afirmação é parcialmente correta, mas o escopo é muito mais restrito do que a redação original sugere.
A OpenAI anunciou oficialmente um sistema de proveniência de texto chamado textGrain.
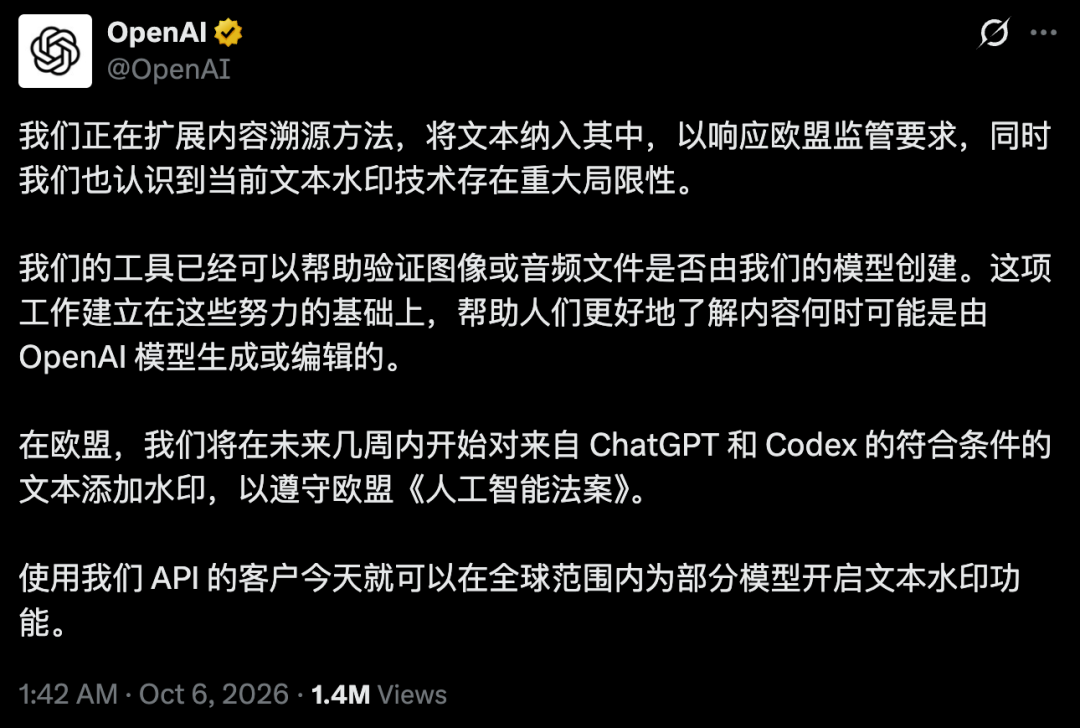
A OpenAI está introduzindo marca-d'água em texto em resposta aos requisitos de proveniência da Lei de IA da União Europeia.
A política atual é:
Portanto, não é correto dizer que todos os textos de ChatGPT e Codex, em qualquer lugar, receberão marcas-d'água obrigatoriamente.
A OpenAI afirma que o textGrain não insere caracteres ocultos nem espaços invisíveis.
Em vez disso, ele altera sutilmente o padrão de probabilidades usado na escolha de palavras ou partes de palavras.
Em uma passagem suficientemente longa, um detector pode procurar esse sinal estatístico.
Essa abordagem tem limitações importantes.
Paráfrase, tradução, edição intensa ou texto muito curto podem enfraquecer o sinal.
A ausência de uma marca-d'água também não prova que um humano escreveu o texto.
A própria OpenAI enfatiza essas limitações.
A publicidade é outra parte da mudança de produto, e esta parte é oficial.
Em 5 de outubro, a OpenAI anunciou um novo formato de anúncio visual no ChatGPT.
A empresa afirma que inicialmente testará o formato durante a geração de imagens.
A primeira implementação é limitada a:
Os anúncios são identificados e permanecem separados da imagem gerada.
A OpenAI também afirma que a publicidade não influencia as respostas do ChatGPT.
Isso é mais específico do que afirmar que “os usuários verão anúncios enquanto aguardam a geração de imagens” em todas as circunstâncias.
Trata-se de um teste limitado vinculado ao plano, à geografia e ao status de implementação.
O artigo combina vários desenvolvimentos reais que ocorreram em datas próximas.
A forma mais clara de separá-los é:
| Alegação | Status |
|---|---|
| A velocidade padrão por assinatura do GPT-6 Astra e do GPT-6.1 Sol melhorou em ~50% | Confirmado |
| A melhoria se aplica aos produtos OpenAI e a parceiros com Sign in with ChatGPT | Confirmado |
| Os usuários precisam alterar código ou configurações | Não; o anúncio oficial afirma que nenhuma mudança é necessária |
| A vazão padrão é garantida exatamente em 50 TPS | Não garantido; 50 TPS é um valor observado/de resumo útil |
| A aceleração veio de um novo tokenizador agressivo | Não confirmado publicamente no material oficial analisado |
| A SemiAnalysis mediu valor equivalente de API >5× para o Opus 5.5 versus o GPT-6.1 Sol | Confirmado para sua metodologia declarada de carga de trabalho agêntica |
| A OpenAI reduziu aproximadamente pela metade os limites de planos de US$ 200 recém-adquiridos | Confirmado pelos testes da SemiAnalysis e pelo anúncio citado |
| Chat, Work, Codex e Dots estão oficialmente se fundindo em uma interface | Não confirmado |
| A seleção de modelos está sendo completamente removida | Não confirmado; a documentação atual de Work/Codex ainda descreve seleção de modelos |
| Todo o texto de ChatGPT/Codex no mundo receberá marca-d'água | Falso como afirmação global |
| Textos elegíveis de ChatGPT/Codex na UE receberão marca-d'água invisível | Confirmado |
| Clientes de API podem optar por marca-d'água em texto | Confirmado |
| Anúncios serão testados durante a geração de imagens | Confirmado |
| Anúncios de geração de imagens têm como alvo inicial usuários Free/Go nos EUA | Confirmado |
Essa distinção torna a história original mais útil.
A atualização genuína já é substancial sem transformar cada rumor de produto em um roteiro consolidado.
Sim. Thibault “Tibo” Sottiaux, líder de engenharia da OpenAI, afirmou que o GPT-6 Astra e o GPT-6.1 Sol foram otimizados para serem aproximadamente 50% mais rápidos por padrão por meio de acesso elegível via assinatura.
Não foi anunciada uma garantia fixa de 50 TPS. Medições e resumos da comunidade usam aproximadamente 30 a 50 TPS para ilustrar a mudança, mas a vazão real varia por modelo, tarefa, produto e condições de execução.
O anúncio do Dia 1 descreve especificamente o acesso via assinatura nos produtos OpenAI e em parceiros que usam Sign in with ChatGPT. Isso não deve ser generalizado como uma afirmação de que todo o tráfego de API recebeu a mesma mudança.
A SemiAnalysis mediu os limites de assinaturas e os converteu em valor teórico equivalente de API usando uma carga de trabalho agêntica representativa. Para Claude Opus 5.5 versus GPT-6.1 Sol, seu panorama de outubro mostrou aproximadamente 5,4× a 5,6× mais valor equivalente de API nas faixas equivalentes de US$ 20, US$ 100 e US$ 200.
A OpenAI está simplificando e conectando essas experiências, mas não há anúncio oficial de que todas as quatro se tornarão uma única interface idêntica. A documentação atual ainda trata o Codex como uma visualização de desenvolvimento separada e Dots como uma capacidade de agente sempre ativo.
Não. A OpenAI afirma que textos elegíveis do ChatGPT e Codex na UE receberão a marca-d'água invisível textGrain, enquanto clientes de API no mundo todo podem optar por isso para modelos selecionados. A marca-d'água da API permanece desativada por padrão.
A OpenAI anunciou um teste de anúncios visuais durante a geração de imagens para usuários Free e Go nos Estados Unidos. O teste inicial começa mais tarde em outubro de 2026, e os anúncios continuam identificados e separados das imagens geradas.
Tibo anunciou um período de 28 dias no qual a equipe planeja lançar diariamente uma melhoria clara relevante para a maioria dos usuários de Codex/Work ou uma redefinição mais ampla. A primeira melhoria anunciada foi o aumento de velocidade do GPT-6 Astra e do GPT-6.1 Sol.
A primeira atualização da OpenAI em sua iniciativa de entregas de 28 dias é direta: o GPT-6 Astra e o GPT-6.1 Sol agora devem parecer aproximadamente 50% mais rápidos por padrão por meio de acesso elegível via assinatura, incluindo ferramentas de parceiros compatíveis que usam Sign in with ChatGPT.
Ao mesmo tempo, os testes de assinatura da SemiAnalysis mostram por que a velocidade é apenas parte da competição. Sob suas premissas de carga de trabalho agêntica, as assinaturas Claude Opus 5.5 oferecem atualmente mais de cinco vezes o valor equivalente de API dos planos GPT-6.1 Sol a preços mensais comparáveis.
A fonte também conecta esse momento às mudanças mais amplas de produto da OpenAI. Algumas são oficiais — marca-d'água de texto na UE, anúncios visuais em testes de geração de imagens, Work, Dots e integração mais profunda de produtos. Outras, como uma fusão completa entre Chat/Work/Codex/Dots e o desaparecimento da seleção de modelos, continuam sendo especulação da comunidade, e não política de produto anunciada.
O GPT-6 está mais rápido, mas a competição maior está migrando para a economia total de agentes: velocidade, limites, eficiência do modelo, acesso a ferramentas e quanto trabalho real uma assinatura pode concluir antes que o medidor se esgote.
Comece com uma frase e tenha um site completo em minutos.



