For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/grok-4-6-released-agentic-performance.md.
A SpaceXAI lançou o Grok 4.6 em 12 de agosto de 2026, posicionando-o como um modelo de ponta para programação, tarefas de agente de longa du...
A SpaceXAI lançou o Grok 4.6 em 12 de agosto de 2026, posicionando-o como um modelo de ponta para programação, tarefas de agente de longa duração e trabalho do conhecimento.
O modelo é construído diretamente sobre o Grok 4.5, mas com um foco mais nítido e pragmático: manter a eficiência em trabalhos contínuos mais longos, usar ferramentas em várias etapas e gerar primeiras versões mais fortes para aplicações interativas e visuais.
De acordo com a SpaceXAI e a Cursor, o Grok 4.6 agora está no mesmo nível do GPT-5.6 Sol no Índice de Inteligência do Artificial Analysis, ao mesmo tempo em que apresenta resultados particularmente notáveis em avaliações de agente do mundo real, como GDPval-AA v2 e AA-Briefcase.
O artigo original da AIBase também destacou o preço e a velocidade de serviço do Grok 4.6. A vantagem de preço é totalmente respaldada pela documentação oficial. Os dados de velocidade exigem uma interpretação mais cuidadosa: a AIBase relatou 80 TPS, enquanto o Artificial Analysis atualmente mede a API de primeira parte do Grok 4.6 em cerca de 68 tokens de saída por segundo. A velocidade em tempo de execução varia conforme a infraestrutura, o comprimento do prompt, a intensidade de raciocínio e a carga do provedor.
O Grok 4.6 é uma geração incremental de modelo, não o lançamento de uma nova arquitetura.
A SpaceXAI afirma que o novo modelo recebeu treinamento suplementar mais longo do que o Grok 4.5. A combinação de conteúdo de treinamento inclui:
A empresa afirma que o Grok 4.5 também foi usado para regenerar trajetórias de ajuste fino supervisionado para tarefas de STEM, engenharia de software e trabalho do conhecimento, com filtros baseados em modelo para remover rastros problemáticos.
O Grok 4.5 já havia concluído o treinamento em escala massiva anteriormente.
A SpaceXAI declarou oficialmente que o treinamento do Grok 4.5 utilizou dezenas de milhares de GPUs NVIDIA GB300. Seus dados de treinamento abrangem programação, ciência, engenharia e matemática, enquanto o aprendizado por reforço se concentrou principalmente em tarefas de engenharia de software de múltiplas etapas e outros trabalhos técnicos de longa duração.
O Grok 4.6 é uma extensão dessa base, não uma substituição.
A mudança mais importante está na ênfase no comportamento contínuo de agente: o modelo não deve apenas resolver problemas de programação isolados, mas manter a coerência ao longo do processo de pesquisa, edição de arquivos, uso de ferramentas, teste do próprio trabalho e iteração com feedback em múltiplas rodadas.
A SpaceXAI afirma que o Grok 4.6 foi treinado em um amplo conjunto de tarefas de aprendizado por reforço de agente.
Esses ambientes incluem:
Isso ajuda a explicar por que o modelo se destaca mais em avaliações que envolvem trabalho estendido, em vez de raciocínio de resposta curta.
A SpaceXAI e a Cursor também destacam
a capacidade do modelo de transformar ideias amplas de produtos em primeiras versões utilizáveis.
Em testes internos, o Grok 4.6 foi capaz de:
Isso não significa que cada aplicativo gerado de uma única vez já esteja em nível de prontidão para produção. Apenas indica que a empresa descobriu que a qualidade de sua saída inicial é melhor do que a do Grok 4.5, especialmente quando a tarefa exige a combinação de código, design, interação e uso iterativo de ferramentas.
O Artificial Analysis atualmente atribui ao Grok 4.6 (versão alta) uma pontuação de 61 no Índice de Inteligência.
Isso corresponde à mesma pontuação total do GPT-5.6 Sol (versão máxima) nas comparações divulgadas pela SpaceXAI.
O índice é um resultado agregado de nove avaliações, não um teste único, portanto é mais adequado como um sinal amplo de comparação do que como evidência de que os dois modelos têm desempenho idêntico em todas as cargas de trabalho.
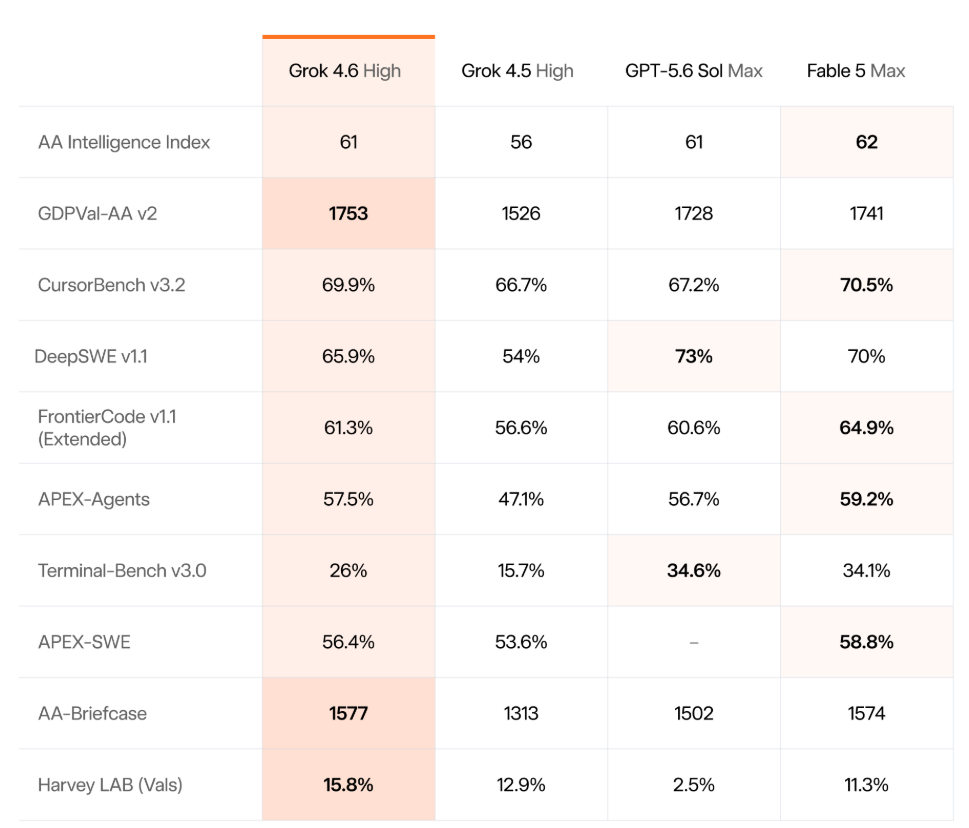
A tabela de benchmarks que acompanha o lançamento inclui os seguintes resultados:
| Benchmark | Grok 4.6 Versão Alta | Grok 4.5 Versão Alta | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| Índice de Inteligência AA | 61 | 56 | 61 | 62 |
| GDPval-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69,9% | 66,7% | 67,2% | 70,5% |
| DeepSWE v1.1 | 65,9% | 54,0% | 73,0% | 70,0% |
| FrontierCode v1.1 Estendido | 61,3% | 56,6% | 60,6% | 63,6% |
| APEX-Agents | 57,5% | 47,1% | 56,7% | 59,2% |
| Terminal-Bench v3.0 | 26,0% | 15,7% | 34,6% | 34,1% |
| APEX-SWE | 56,4% | 53,6% | — | 58,8% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB (Vals) | 15,8% | 12,9% | 2,5% | 11,3% |
Os rankings de benchmarks mudam à medida que modelos, estruturas de teste e versões de avaliação são atualizados. A tabela acima reflete os resultados comparativos do período de lançamento, não um ranking permanente.
No GDPval-AA v2, o Grok 4.6 obteve uma pontuação de 1753 Elo.
O Artificial Analysis descreve o GDPval-AA v2 como uma avaliação de trabalho do conhecimento com agente no mundo real que cobre múltiplas profissões especializadas.
No momento da publicação da análise do Grok 4.6, o Artificial Analysis afirmou que essa pontuação fica atrás apenas da série Claude Opus 5, enquanto o intervalo de confiança se sobrepõe ao de outros modelos líderes, como Claude Fable 5 e Qwen3.8 Max.
Isso é mais rigoroso do que declarar diretamente que o Grok 4.6 está claramente em segundo lugar.
Avaliações baseadas em Elo têm incertezas, e pontuações próximas podem se sobrepor estatisticamente.
O Grok 4.6 também obteve 1577 Elo no AA-Briefcase.
da pontuação. Este é um benchmark privado da Artificial Analysis para trabalho de conhecimento agêntico de longa duração.
Isso coloca sua pontuação—
No snapshot publicado, o desempenho do Grok 4.6 é aproximadamente equivalente ao nível do Fable 5, ficando atrás da linha Claude Opus 5.
Seu desempenho de eficiência também merece atenção.
A Artificial Analysis relatou que o Grok 4.6, ao concluir suas tarefas AA-Briefcase, usou aproximadamente:
Em comparação, o Claude Opus 5 (versão máxima) teria usado aproximadamente:
Isso não significa que o Grok 4.6 seja mais eficiente que o Claude Opus 5 em todos os casos. É apenas uma observação para esse benchmark específico. Ainda assim, para agentes inteligentes de longa duração, menos rodadas e menos contexto acumulado podem reduzir significativamente o custo das tarefas.
O preço padrão da API pública continua sendo uma das maiores vantagens competitivas do Grok 4.6.
Para prompts abaixo do limite de preço de contexto longo, a documentação da SpaceXAI informa:
| Tipo de token | Preço por milhão de tokens |
|---|---|
| Entrada | US$ 2,00 |
| Entrada em cache | US$ 0,50 |
| Saída | US$ 6,00 |
A Artificial Analysis aponta que, apesar do aumento no índice de inteligência de 56 para 61, esse preço público permanece o mesmo em comparação ao Grok 4.5.
Em comparação, no momento em que este texto foi escrito:
Isso torna o Grok 4.6 especialmente atraente para loops de agentes de alta vazão, pois nesses cenários os tokens de saída e o contexto repetido tendem a dominar a maior parte do custo total.
As notas oficiais de lançamento da SpaceXAI incluem um detalhe importante que o breve artigo da AIBase não mencionou.
Para prompts acima de 200 mil tokens, o Grok 4.6 adota um nível de preço mais alto:
| Tipo de token | Preço por milhão de tokens para prompts acima de 200 mil |
|---|---|
| Entrada | US$ 4,00 |
| Entrada em cache | US$ 1,00 |
| Saída | US$ 12,00 |
Portanto, "US$ 2 por entrada / US$ 6 por saída" é o preço inicial, não um valor universal aplicável a todas as solicitações.
A Cursor afirma que a variante rápida tem o preço de duas vezes o valor padrão.
Isso é separado das regras de preço para prompts longos acima. Dependendo da plataforma e da carga de trabalho, os usuários devem confirmar o nível de velocidade e o nível de contexto aplicáveis antes de estimar o custo de produção.
O artigo da AIBase afirma que o Grok 4.6 pode rodar a 80 tokens por segundo.
Esse número deve ser tratado com cautela.
O anúncio oficial do Grok 4.6 da SpaceXAI não publica uma garantia fixa de velocidade de 80 TPS. A Artificial Analysis atualmente mede, em sua carga de trabalho de benchmark, a velocidade de saída do Grok 4.6 (high) na API first-party em cerca de 67,6 tokens de saída por segundo.
Em comparação, a página oficial de lançamento do Grok 4.5 da SpaceXAI afirma explicitamente que o Grok 4.5 é servido a 80 TPS.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Portanto, o artigo de origem curto pode ter repetido o número antigo de 80 TPS ou citado um nível de serviço diferente.
O ponto prático é mais simples:
O Grok 4.6 tem uma velocidade bastante boa para um modelo de raciocínio de fronteira, mas não existe um único número fixo de TPS aplicável a todos os prompts, provedores, níveis de raciocínio ou camadas de velocidade.
A documentação da API da SpaceXAI lista a janela de contexto do grok-4.6 como 500 mil tokens.
O modelo suporta:
A página oficial do modelo também lista a data de corte de conhecimento como 1º de fevereiro de 2026.
A documentação do modelo Grok 4.6 na Cursor lista atualmente uma janela de contexto de 256k dentro da Cursor.
Isso não contradiz a especificação do modelo base. Significa que a integração da plataforma pode expor um limite de contexto menor do que o da API first-party da SpaceXAI.
Ao comparar limites de modelos, verifique sempre o provedor e a integração exatos em uso.
O ID oficial do modelo na SpaceXAI é:
grok-4.6
Uma solicitação mínima à Responses API seria assim:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": "Encontre e corrija o bug e depois explique: function median(a){a.sort();return a[a.length/2]}"
  }'
O mesmo modelo também está disponível via SDK oficial da xAI e clientes de API compatíveis com OpenAI.
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.6")
chat.append(
    user(
        "Encontre e corrija o bug e depois explique: "
        "function median(a){a.sort();return a[a.length/2]}"
    )
)

response = chat.sample()
print(response.content)
Para loops de agentes de longa duração, a SpaceXAI recomenda o uso de cache de prompt e compactação de contexto quando apropriado, a fim de reduzir custos de contexto repetido.
No lançamento, o Grok 4.6 está disponível nas seguintes plataformas:
A SpaceXAI e a Cursor também oferecem 2x o uso incluído na primeira semana na Cursor e no Grok Build.
Essa promoção de lançamento é temporária e não deve ser considerada preço permanente.
A Cursor exibe o Grok 4.6 em quatro níveis de intensidade de raciocínio:
high é a intensidade de raciocínio padrão.
Nos planos elegíveis da Cursor, também está disponível o nível de velocidade rápida.
Dentro da Cursor, o modelo pode usar as ferramentas de agente da plataforma para executar tarefas como:
Essa é uma das razões pelas quais o lançamento do Grok 4.6 deu tanta ênfase a benchmarks de agentes: seu uso pretendido não se limita a conclusões de chat isoladas.
O modo de benchmark indica que o maior avanço do Grok 4.6 não está apenas no raciocínio estático.
Suas melhorias são mais evidentes quando as tarefas envolvem:
Isso o torna especialmente adequado para:
Tarefas de trabalho intensivo em conhecimento e de longa duração
Para prompts curtos e simples, essa vantagem pode não ser evidente.
Os dados divulgados suportam as seguintes conclusões claras:
Mas os dados não provam que o Grok 4.6 é universalmente superior ao GPT-5.6 Sol ou ao Claude em todas as tarefas.
Por exemplo, a mesma tabela de divulgação mostra o GPT-5.6 Sol liderando no DeepSWE v1.1 e no Terminal-Bench v3.0, enquanto o Claude Fable 5 lidera em várias outras avaliações de programação e agentes.
Portanto, a escolha do modelo deve depender da carga de trabalho real, e não de uma única pontuação agregada.
O Grok 4.6 é o modelo de fronteira da SpaceXAI voltado para programação, tarefas de agente e trabalho de conhecimento. Ele adiciona treinamento extra sobre o Grok 4.5, com foco em agentes de longa duração, maior capacidade de construção de aplicativos na primeira tentativa e trabalho multi-etapas mais persistente.
Depende da tarefa específica. Na comparação de lançamento, o Grok 4.6 empata com o GPT-5.6 Sol no Índice de Inteligência da Artificial Analysis e lidera em algumas avaliações de agentes, enquanto o GPT-5.6 Sol ainda é mais forte em certos benchmarks de programação. Os dois modelos também diferem significativamente em preço e comprimento de contexto.
O preço padrão é de US$ 2 por milhão de tokens de entrada, US$ 0,50 por milhão de tokens de entrada em cache e US$ 6 por milhão de tokens de saída. Para prompts com mais de 200 mil tokens, a documentação da SpaceXAI especifica faixas de preço mais altas: US$ 4 / US$ 1 / US$ 12 por milhão para entrada, entrada em cache e saída, respectivamente.
A API proprietária da SpaceXAI suporta uma janela de contexto de 500 mil tokens. O Cursor atualmente oferece uma janela de contexto de 256 mil tokens para sua própria integração com o Grok 4.6, portanto o limite real depende da plataforma.
Sim. A SpaceXAI lista o Grok 4.6 como suportando entrada de texto e imagem, bem como saída de texto. O modelo também suporta ferramentas como chamada de função, busca na web, busca no X e execução de código, disponíveis através da API xAI.
Sim. O Grok 4.6 já está disponível no Cursor e suporta intensidades de raciocínio xhigh, high, medium e low. O Cursor também concede a ele acesso ao conjunto de ferramentas de agente para operações de arquivo, comandos Shell, navegação e outros fluxos de trabalho de programação.
Não. O Grok 4.6 é um modelo proprietário, e a SpaceXAI não divulgou seus pesos ou número de parâmetros.
A AIBase relatou 80 tokens por segundo, mas as medições atuais da Artificial Analysis mostram que a API proprietária do Grok 4.6 gera cerca de 68 tokens de saída por segundo em sua carga de trabalho de referência. A velocidade varia conforme a intensidade de raciocínio, o tamanho do prompt, a carga da infraestrutura e o nível da plataforma.
O Grok 4.6 é uma atualização direcionada ao Grok 4.5, com foco em agentes de longa duração, codificação, trabalho de conhecimento e qualidade de execução na primeira tentativa em projetos interativos. Seus resultados de lançamento o colocam na vanguarda das avaliações atuais de modelos, alcançando 61 pontos no Índice de Inteligência da Artificial Analysis — empatando com o GPT-5.6 Sol na comparação de lançamento.
O ponto mais forte deste lançamento é a combinação de desempenho de agente e preço. O Grok 4.6 começa em US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída, ao mesmo tempo em que obtém pontuações altas no GDPval-AA v2 e no AA-Briefcase. Prompts longos e níveis rápidos podem gerar custos mais altos, portanto estimativas de produção devem usar a configuração exata do provedor.
O dado divulgado de 80 TPS deve ser tratado com cautela: as medições independentes atuais ficam próximas de 68 tokens de saída por segundo, e a velocidade do serviço pode mudar ao longo do tempo.
A principal vantagem não está em ter vencido todos os benchmarks, mas sim em agora oferecer desempenho de agente de nível avançado a um preço extremamente competitivo.
Comece com uma frase e tenha um site completo em minutos.



