For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/guia-do-desenvolvedor-gemini-35-flash-3-armadilhas-de-api-padro-de-agente-mcp-e-lista-de-verificao-de-migrao.md.
Um guia prático para desenvolvedores do Gemini 3.5 Flash que aborda três armadilhas caras na migração de API, a medição 14x do GitHub Copilo...
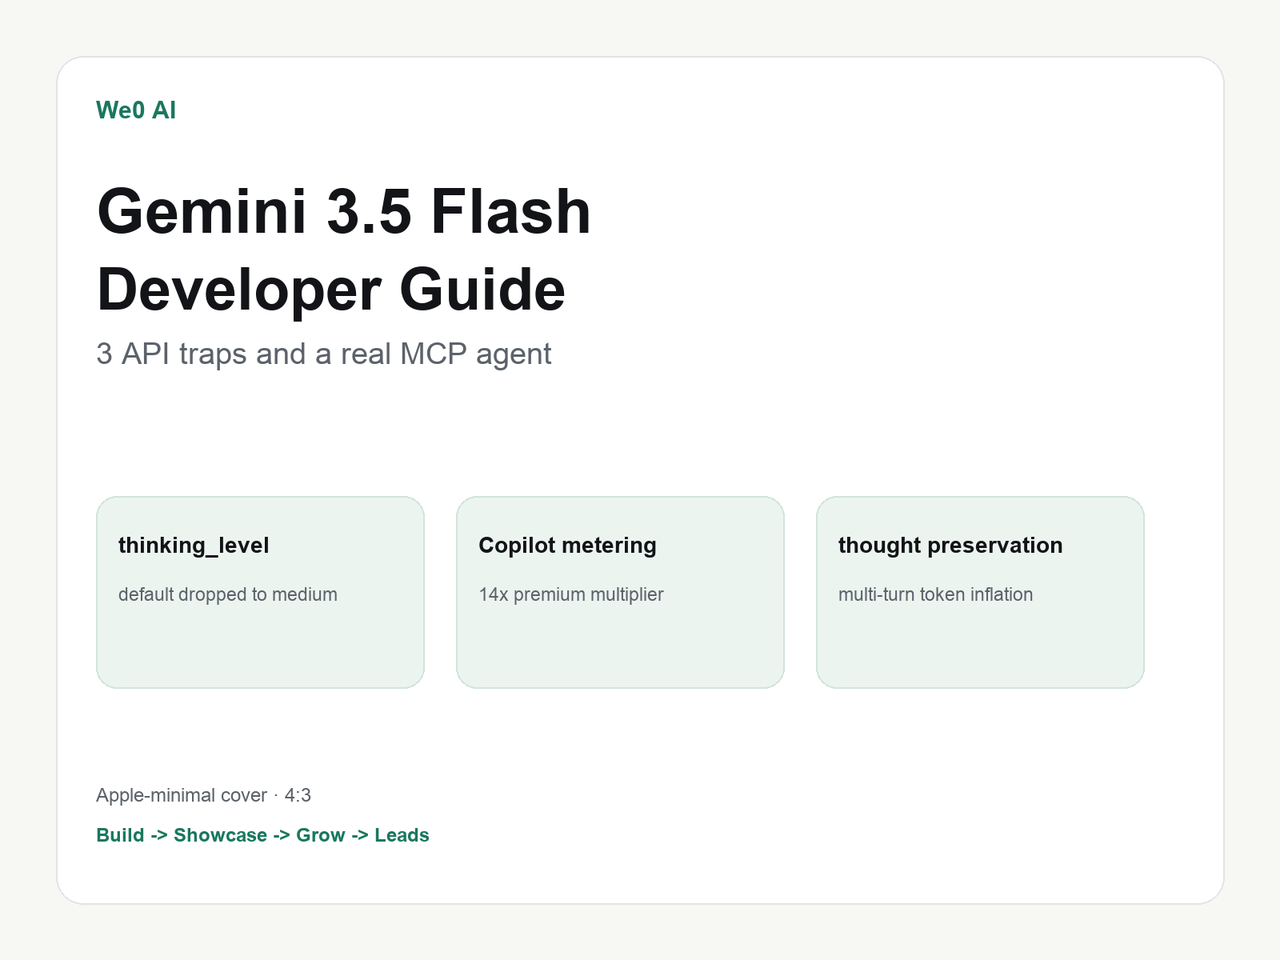
Os erros mais caros do Gemini 3.5 Flash são os padrões silenciosos, não os erros de sintaxe.
Para muitos agentes de programação, low é um padrão melhor do que as pessoas esperam.
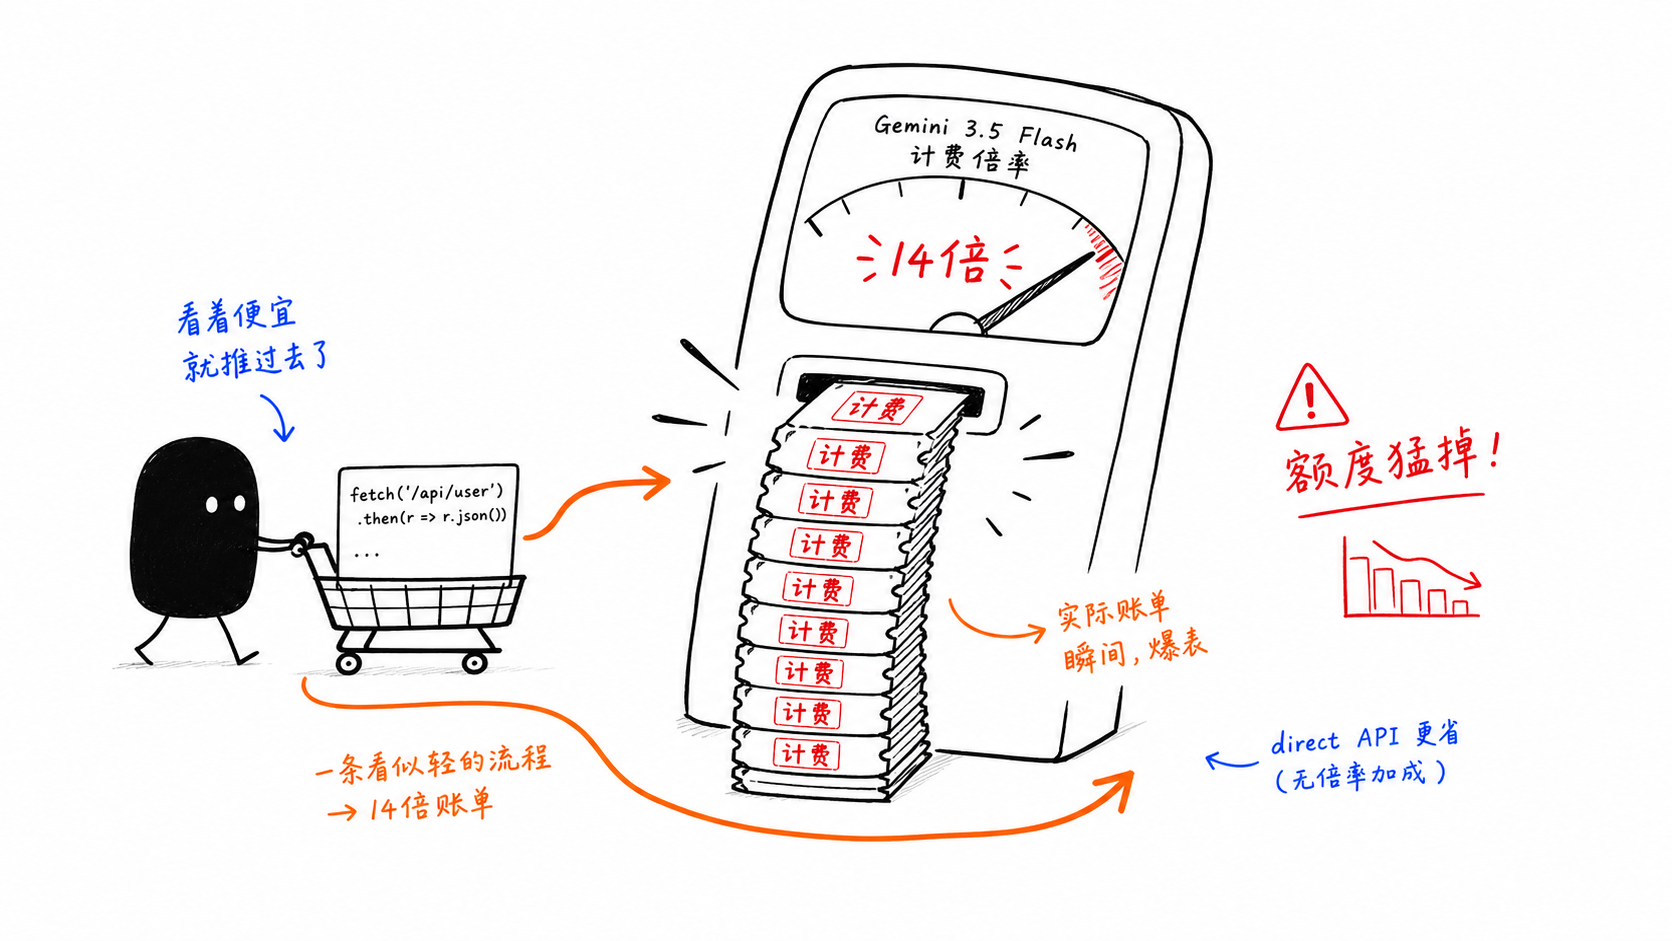
Loops intensivos de agentes através do GitHub Copilot podem se tornar muito mais caros por causa da cobrança 14x.
Na We0 AI, a escolha do modelo é apenas parte do fluxo de trabalho. O restante é como o produto é explicado, apresentado e descoberto.
gemini-3.5-flash parece fácil de chamar.
É exatamente por isso que é fácil subestimá-lo. Uma pequena migração de código da era de pré-visualização ainda pode produzir saídas piores, um perfil de custo diferente e loops de múltiplas interações mais caros, sem jamais gerar um erro visível.
Este guia se concentra nas três armadilhas mais importantes, no formato de código que as evita e em um loop prático de agente no estilo MCP que você pode adaptar rapidamente.
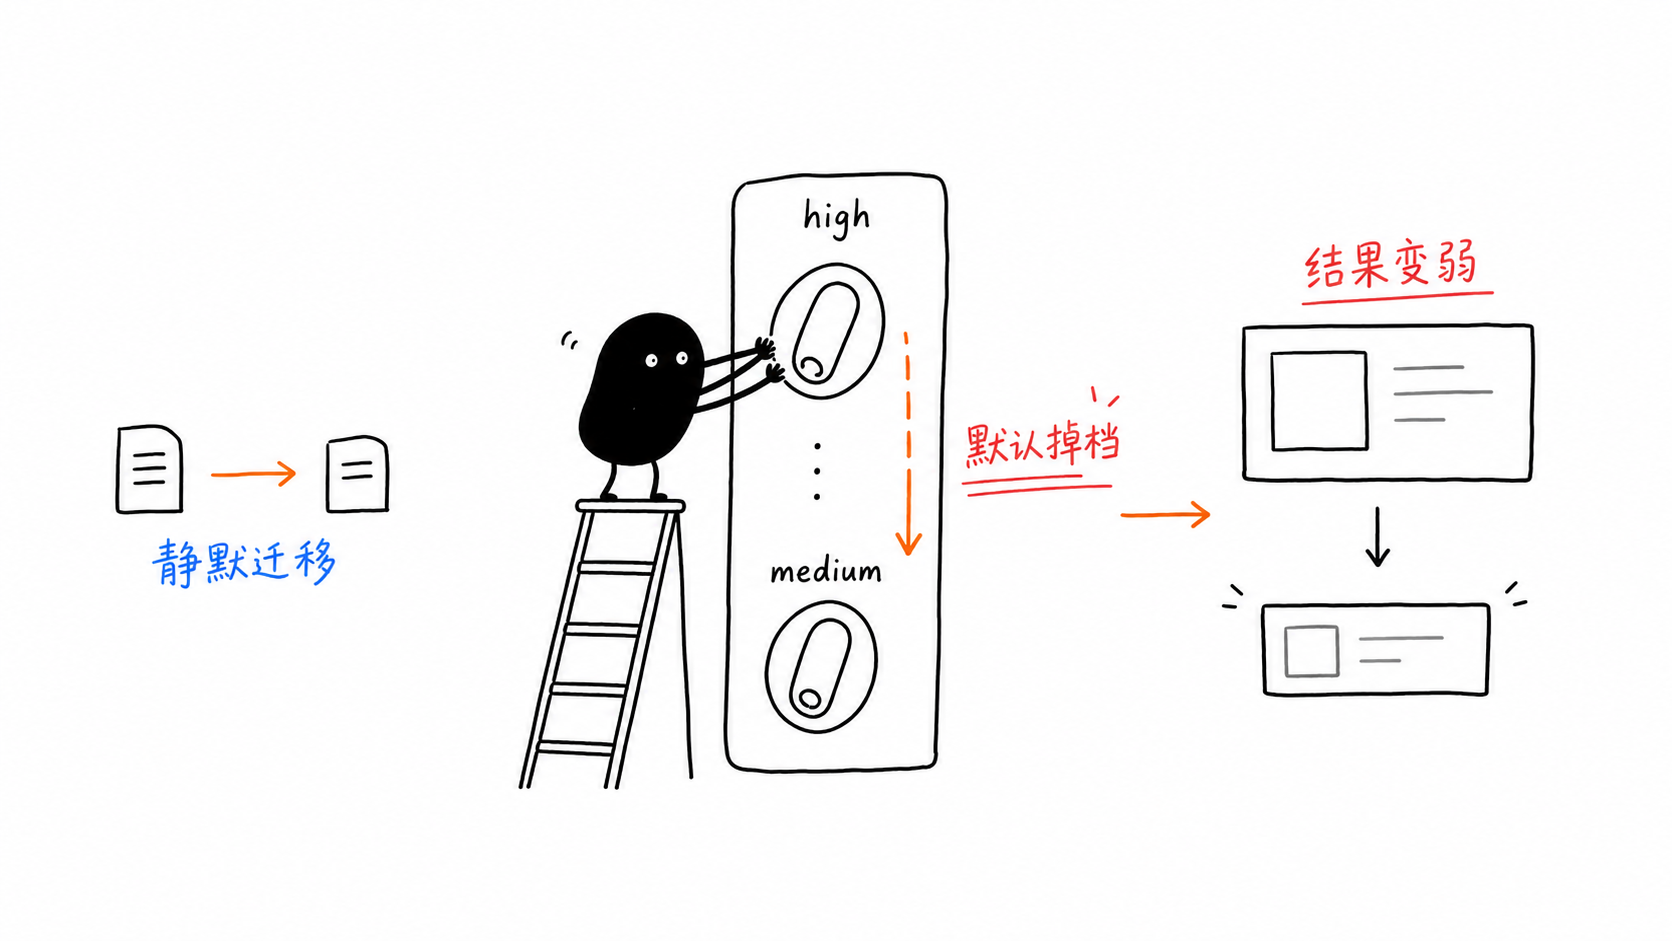
thinking_level caiu de alto para médioIsso é perigoso porque nada falha.
Você porta o código antigo, a solicitação ainda retorna, mas o modelo já não está mais raciocinando no nível que você supunha.
Valor
O que faz
Quando usar
minimal
Raciocínio mínimo indispensável
Autocompletar, classificação, conclusões em uma única tentativa
Agentes de programação, loops de ferramentas MCP, fluxos de trabalho em várias etapas
medium
Chat para consumidores, perguntas e respostas gerais
high
Esforço máximo de raciocínio
Raciocínio difícil, depuração de problemas inéditos, matemática, planejamento
response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents=prompt,
)

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
)
O segundo trecho é executado, mas os padrões já não são mais os mesmos.
from google import genai
import os

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
    config={
        "thinking_config": {
            "thinking_level": "high"  # or "low" for coding agents
        }
    },
)Para muitos fluxos de trabalho com agentes de programação, comece com low, não com high.
O motivo prático é simples:
mais rápido
mais barato
muitas vezes é suficiente ou comparável para loops de programação com uso intenso de ferramentas
O problema não é o preço de tabela do modelo. É o multiplicador de solicitações premium dentro do GitHub Copilot. Quando o Flash é usado de forma agentiva, o perfil de custo muda rapidamente.
o uso interativo leve permanece dentro do Copilot
loops pesados e fluxos de trabalho em estilo batch passam pela API direta
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A arquitetura passa a ser controle de custos.
O Gemini 3.5 Flash carrega adiante o raciocínio interno entre interações.
Isso melhora a coerência, mas também significa que esses pensamentos podem continuar aparecendo na contabilização de tokens posteriores.
Em loops longos de agentes, isso pode aumentar substancialmente o uso de tokens.
redefina os chats em limites limpos entre fases
resuma e leve adiante apenas o que importa
use cache de prompts para instruções estáveis e definições de ferramentas
acompanhe ao longo do tempo a proporção entre tokens de pensamentos e tokens de prompt
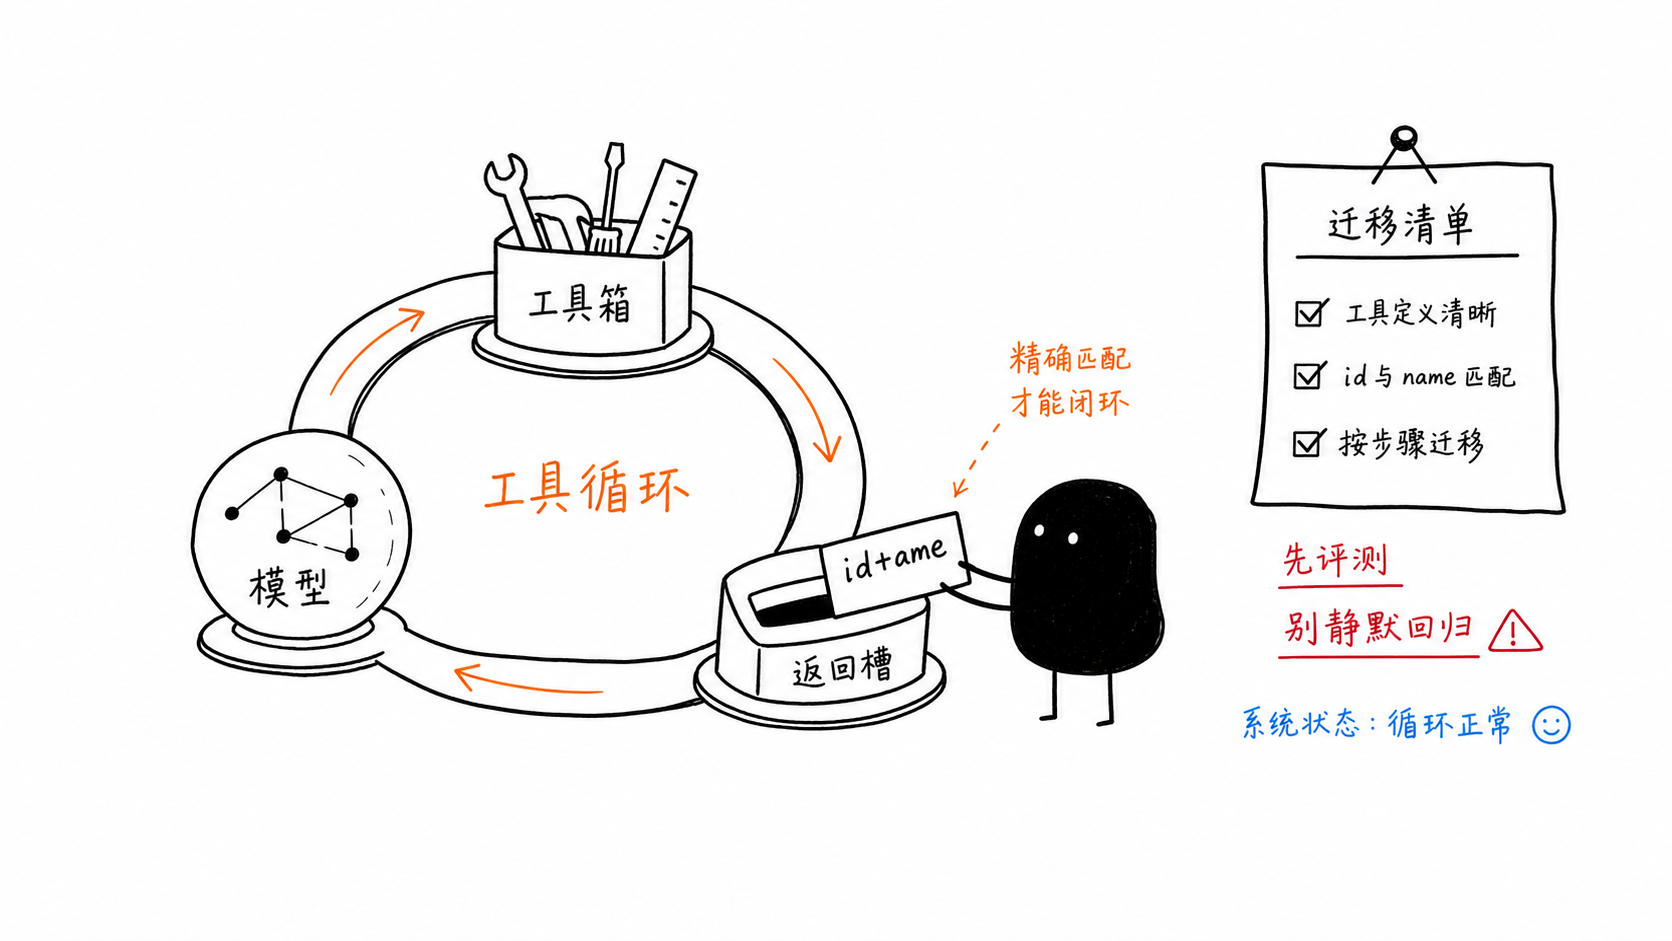
O artigo de origem inclui um padrão de ponta a ponta muito útil: uma ferramenta de leitura de arquivos, uma ferramenta de busca de URL, um formato padrão de declaração de função e um loop que envia as respostas das ferramentas de volta ao modelo.
import os
import httpx
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

read_file = types.FunctionDeclaration(
    name="read_file",
    description="Read a local file and return its contents as text.",
    parameters={
        "type": "object",
        "properties": {
            "path": {
                "type": "string",
                "description": "Absolute path to the file"
            }
        },
        "required": ["path"],
    },
)

fetch_url = types.FunctionDeclaration(
    name="fetch_url",
    description="Fetch a URL and return the response body as text.",
    parameters={
        "type": "object",
        "properties": {
            "url": {
                "type": "string",
                "description": "Fully-qualified URL"
            }
        },
        "required": ["url"],
    },
)tools = types.Tool(function_declarations=[read_file, fetch_url])
def execute_tool(call):
if call.name == "read_file":
return Path(call.args["path"]).read_text(encoding="utf-8")
if call.name == "fetch_url":
return httpx.get(call.args["url"], timeout=15).text[:50000]
raise ValueError(f"Unknown tool: {call.name}")
def run_agent(task: str, max_turns: int = 8):
history = [types.Content(role="user", parts=[types.Part(text=task)])]
for _ in range(max_turns):
response = client.models.generate_content(
model="gemini-3.5-flash",
contents=history,
config=types.GenerateContentConfig(
tools=[tools],
thinking_config=types.ThinkingConfig(thinking_level="low"),
),
)
if not response.function_calls:
return response.text
history.append(response.candidates[0].content)
tool_results = []
for call in response.function_calls:
result = execute_tool(call)
tool_results.append(
types.Part(
function_response=types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": result},
)
)
)
history.append(types.Content(role="tool", parts=tool_results))A regra de migração pequena, mas crucial, é que a resposta da sua função precisa corresponder tanto ao id quanto ao name da chamada original.
Construir loops de ferramentas manualmente é aceitável para protótipos. Em produção, você rapidamente acaba reconstruindo orquestração, cache, roteamento, tentativas, repetição e observabilidade.
É por isso que a pergunta mais importante não é apenas “consigo conectar este modelo?”, mas “quanta infraestrutura de agente estou prestes a assumir por conta própria?”
Se você está migrando de gemini-3-flash-preview para gemini-3.5-flash, verifique explicitamente estes itens:
substitua o ID do modelo com cuidado
defina thinking_level de forma intencional
remova substituições de amostragem obsoletas, a menos que as avaliações as justifiquem
id e name nas respostas das ferramentasinspecione response.usage_metadata.thoughts_token_count
mantenha a versão preview para APIs não compatíveis das quais você ainda depende
execute avaliações antes/depois
compare a medição do Copilot com os custos diretos da API
Se o seu objetivo não é apenas testar prompts, mas conectar arquivos, repositórios, APIs, documentos e fluxos de trabalho de agentes em conjunto, normalmente você precisa de mais do que um endpoint bruto de modelo.
Na We0 AI, esse mesmo princípio vai um passo além: o fluxo de trabalho do agente é apenas metade do trabalho. O restante é tornar o produto compreensível, pesquisável, recomendável e conversível por meio de documentação, FAQs, páginas de produto, conteúdo de vitrine e superfícies de SEO / GEO.
A chamada em si é curta. A parte importante é definir thinking_level explicitamente para que a migração não degrade silenciosamente a qualidade da saída.
thinking_level?minimal para tarefas muito leves
low para codificação e fluxos de trabalho agentivos
medium como padrão no estilo de consumo
high para raciocínio mais difícil e planejamento mais profundo
Porque o multiplicador de medição altera a economia. Para uso intenso de agentes, isso pode pesar mais na estrutura de custos do que o preço base do modelo.
É o modelo carregando o raciocínio interno adiante ao longo dos turnos. Isso ajuda na coerência em múltiplos turnos, mas também aumenta a chance de que os custos de tokens cresçam com o tempo.
Sim, especialmente quando os esquemas de ferramentas, a correspondência de respostas, thinking_level e o gerenciamento do orçamento de tokens são tratados com cuidado.
Comece com uma frase e tenha um site completo em minutos.