For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
A startup de modelos de mundo de Yann LeCun, a **Advanced Machine Intelligence (AMI)**, divulgou um dos seus primeiros grandes resultados de...
A startup de modelos de mundo de Yann LeCun, a Advanced Machine Intelligence (AMI), divulgou um dos seus primeiros grandes resultados de pesquisa.
No artigo H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning, pesquisadores da AMI, da New York University, da INRIA Paris e da Brown University apresentam um modelo de mundo hierárquico construído a partir de vários JEPAs condicionados por ações.
A ideia central é direta: em vez de obrigar uma única representação latente a lidar tanto com o controle motor imediato quanto com o planejamento de longo prazo, o H-JEPA atribui a diferentes níveis da hierarquia diferentes escalas temporais e diferentes espaços de representação.
Os níveis superiores olham mais longe no futuro e planejam em um nível mais abstrato. Seus estados intermediários previstos tornam-se subobjetivos para os níveis inferiores, que os refinam progressivamente até que o sistema alcance ações executáveis.
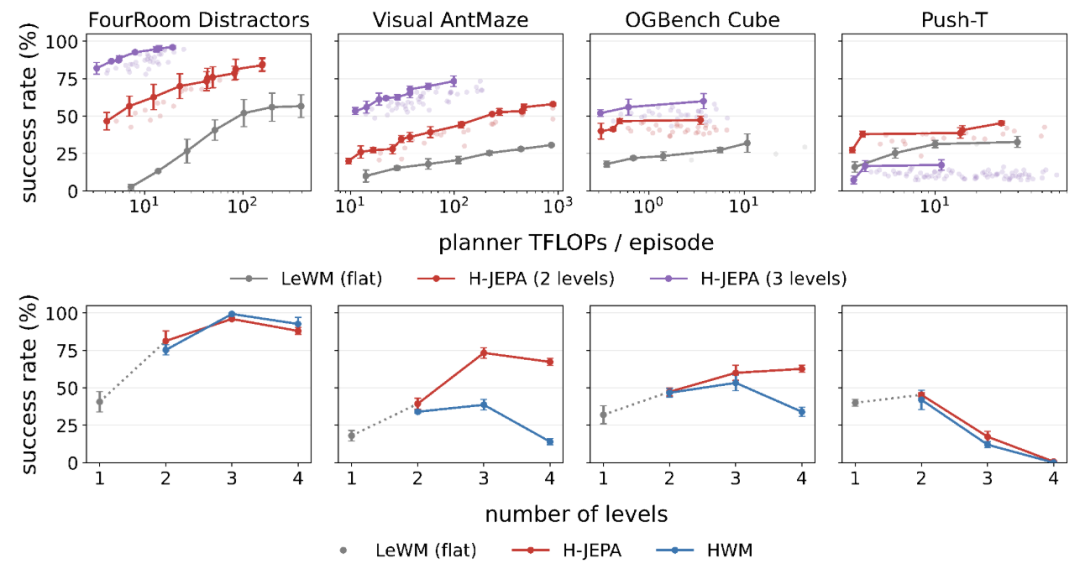
No Visual AntMaze, o H-JEPA de três níveis alcança cerca de 73,3% de sucesso no planejamento, em comparação com 18,0% do modelo de referência plano LeWorldModel, além de operar em uma fronteira mais favorável entre sucesso e custo computacional.
O projeto segue a direção de pesquisa aberta que a AMI vem enfatizando desde o seu lançamento. Os autores disponibilizaram o código de treinamento e avaliação, checkpoints pré-treinados e conjuntos de dados de apoio.
O repositório oficial no GitHub é disponibilizado sob a licença MIT. O repositório publicado dos checkpoints do H-JEPA no Hugging Face também está marcado como MIT, enquanto o repositório do conjunto de dados correspondente foi lançado sob a licença CC BY 4.0.
LeCun defende o planejamento hierárquico há anos.
A intuição subjacente é semelhante à forma como as pessoas planejam tarefas complexas do mundo real.
Imagine estar sentado em um escritório na New York University e decidir viajar para Paris.
No nível mais alto, as informações importantes são o destino, o voo e o horário. Depois que isso é decidido, o nível seguinte se torna mais concreto: sair do escritório, descer, chegar ao aeroporto e embarcar no voo.
No nível mais baixo, o foco muda novamente. Descer uma escada exige informações sobre o chão, o próximo degrau e o movimento do corpo. Detalhes que eram irrelevantes ao escolher um voo transatlântico tornam-se subitamente essenciais.
O mesmo problema aparece na robótica.
Um planejador de alto nível precisa compreender o objetivo da tarefa, as relações espaciais e a direção de longo prazo do deslocamento. Um controlador de baixo nível precisa de informações precisas sobre o movimento imediato e a configuração do corpo.
Se uma única representação tiver de preservar todos os detalhes em todas as escalas temporais, o planejamento se torna desnecessariamente difícil.
Por exemplo, um quadrúpede pode já estar na localização correta, enquanto a posição das suas pernas é diferente da imagem de destino. Uma representação que dê ênfase excessiva aos detalhes das pernas que mudam rapidamente pode tratar incorretamente o robô como se estivesse longe do alvo, mesmo que a sua posição relevante para a tarefa já esteja correta.
O artigo do H-JEPA aborda esse problema fazendo uma pergunta mais específica:
Cada nível pode aprender as informações que importam na sua própria escala temporal, permitindo ainda que o plano de alto nível seja traduzido em ações de baixo nível?
O H-JEPA atribui três componentes principais a cada nível da hierarquia:
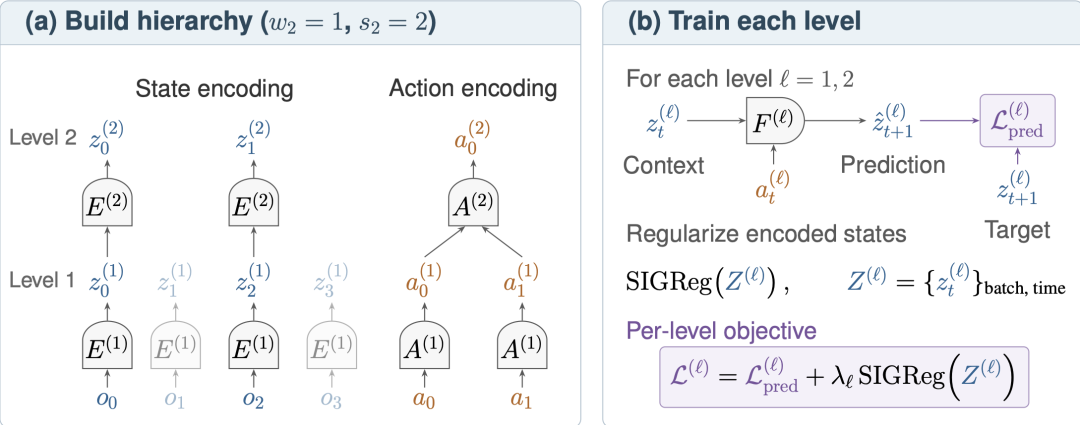
O codificador de estado extrai uma representação latente do ambiente.
No nível mais baixo, o codificador opera diretamente sobre observações visuais. Os níveis superiores recebem representações dos níveis inferiores e aprendem versões progressivamente mais abstratas do estado.
Isso permite que os níveis superiores descartem detalhes que mudam rapidamente, são difíceis de prever em horizontes longos ou são irrelevantes para o planejamento de longo prazo.
Nos experimentos do Visual AntMaze, os níveis superiores suprimem progressivamente as informações sobre a posição das pernas da formiga, preservando as informações sobre a posição da formiga e a configuração do labirinto.
Esse é exatamente o tipo de abstração que a hierarquia pretende aprender.
O codificador de ação descreve o efeito das ações em cada escala temporal.
No nível mais baixo, as ações correspondem a mudanças de controle relativamente concretas. Nos níveis superiores, várias ações de baixo nível são comprimidas em uma representação mais abstrata de como o estado muda ao longo de um período mais extenso.
Isso dá a cada camada uma resolução temporal diferente.
Na configuração apresentada, um passo de previsão de nível superior abrange mais passos do ambiente do que o nível imediatamente abaixo.
O preditor combina o estado latente atual e a ação codificada para estimar o estado latente futuro.
Assim, cada nível aprende o seu próprio modelo de mundo condicionado por ações.
A principal diferença em relação a um modelo de mundo plano é que o H-JEPA não exige que todos os níveis façam previsões dentro de um único espaço latente compartilhado.
Em vez disso, cada nível pode desenvolver uma representação adequada ao seu próprio horizonte.
Durante a inferência, o planejamento avança do topo da hierarquia para baixo.
O nível superior primeiro procura um caminho abstrato até o objetivo final.
O seu estado intermediário previsto torna-se então um subobjetivo para o nível abaixo. Esse nível inferior procura um plano mais detalhado que alcance o subobjetivo atribuído, e o processo continua até que o nível mais baixo produza ações primitivas.
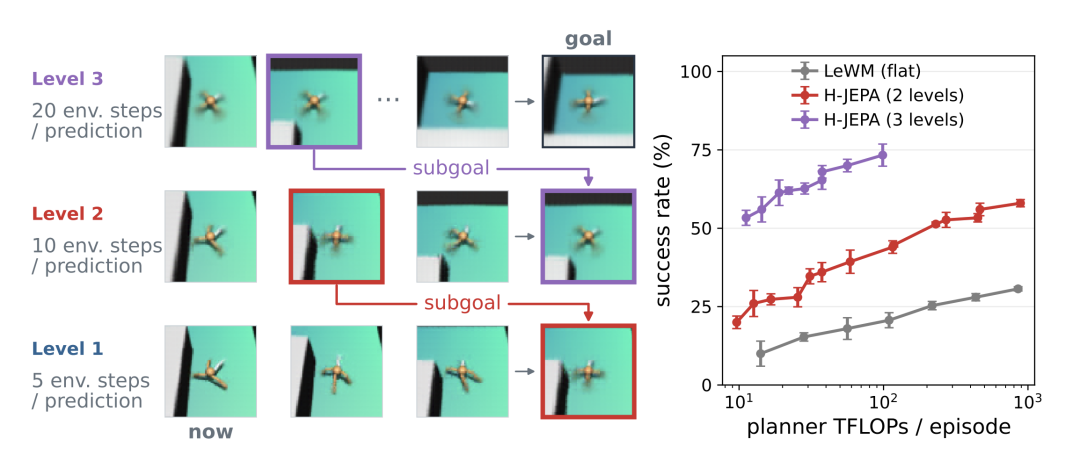
Isso produz um processo de planejamento do abstrato ao concreto:
Depois de executar um prefixo de ações, o sistema observa o novo estado e planeja novamente.
Esse replanejamento repetido permite que a hierarquia responda ao ambiente real, em vez de se comprometer com um único plano de longo horizonte em malha aberta.
A hierarquia é treinada de ponta a ponta.
Isso significa que os níveis não são treinados como módulos isolados. Os objetivos dos níveis superiores podem influenciar os codificadores dos níveis inferiores, permitindo que a hierarquia geral de representações se desenvolva de forma conjunta.
No entanto, o treinamento de modelos de mundo tem um modo clássico de falha: o colapso da representação.
Se um codificador mapear todos os estados de entrada para o mesmo vetor latente, um preditor poderá produzir trivialmente esse mesmo vetor e obter um erro de previsão baixo sem aprender nada útil sobre o ambiente.
O H-JEPA aborda esse problema usando o SIGReg, ou Sketched Isotropic Gaussian Regularization, introduzido no trabalho anterior LeJEPA, de Randall Balestriero e Yann LeCun.
O SIGReg restringe a distribuição latente para que diferentes observações não entrem em colapso na mesma representação.
O LeWorldModel anterior aplicou esse tipo de regularização ao treinamento de modelos de mundo de ponta a ponta a partir de pixels. O H-JEPA utiliza o LeWorldModel como base do nível mais baixo e acrescenta níveis JEPA adicionais acima dele.
Isso mantém intacto o princípio básico do JEPA: prever representações úteis do futuro, em vez de reconstruir todos os pixels futuros.
O artigo avalia o H-JEPA em quatro ambientes simulados de navegação e manipulação:
Também avalia o planejamento offline em trajetórias de robôs reais do conjunto de dados DROID.
O Visual AntMaze mostra a vantagem hierárquica mais clara.
Segundo o repositório oficial, um H-JEPA de três níveis alcança 73,3% de sucesso no planejamento, em comparação com 18,0% do modelo de referência plano LeWorldModel.
A hierarquia também melhora o equilíbrio entre a taxa de sucesso e o custo computacional do planejador.
Isso é importante porque um planejador hierárquico só é útil se os níveis adicionais não tornarem o planejamento proibitivamente caro.
A hierarquia também supera o modelo de referência plano em outros ambientes simulados, mas mais profundidade nem sempre é melhor.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O artigo de origem destaca o Push-T como um contraexemplo importante: o modelo de dois níveis apresenta desempenho superior ao modelo de referência plano, enquanto adicionar um terceiro ou quarto nível pode reduzir o desempenho.
O artigo atribui isso parcialmente à duração das tarefas. Trajetórias mais curtas fornecem menos amostras significativas para níveis muito altos que operam em horizontes longos.
Isso sugere uma limitação importante:
A hierarquia é útil quando a tarefa contém uma estrutura genuína em várias escalas temporais. Adicionar níveis mecanicamente não garante um desempenho melhor.
Os dados de robôs reais criam outro problema de representação.
Em vídeos diversos, um objetivo puramente preditivo pode se concentrar excessivamente nas informações estáveis do fundo, porque o fundo é fácil de prever. O robô em movimento, que é realmente importante para o controle, pode receber menos capacidade de representação.
Para resolver isso, os pesquisadores acrescentam supervisão de dinâmica inversa nos experimentos com o DROID.
O modelo é treinado não apenas para prever estados latentes futuros, mas também para inferir a ação que conecta estados latentes consecutivos.
Isso incentiva a representação a preservar informações sobre o movimento e o estado controlável do robô.
A página do projeto H-JEPA informa que o segundo nível aprendido melhora a fidelidade do planejamento offline em relação ao modelo de referência plano, ao mesmo tempo que reduz o custo computacional do planejador.
A avaliação com o DROID é offline: o artigo compara as trajetórias previstas do efetuador final com trajetórias de especialistas, em vez de afirmar sucesso em tarefas com robôs reais em malha fechada.
Essa distinção é importante ao interpretar os resultados.
Os autores publicaram a implementação do H-JEPA no GitHub.
O repositório oficial inclui código de treinamento e planejamento para:
Também fornece scripts para reproduzir figuras e tabelas selecionadas do artigo.
O repositório de checkpoints no Hugging Face atualmente inclui modelos pré-treinados para o LeWorldModel plano, variantes H-JEPA de dois, três e quatro níveis e modelos de referência HWM com espaço compartilhado para as tarefas de simulação, além de checkpoints do DROID.
O repositório correspondente do conjunto de dados H-JEPA contém os dados de simulação, tarefas de avaliação de planejamento, conjuntos de dados de sondagem e os dados relacionados ao DROID necessários para o lançamento.
Isso torna o trabalho mais do que uma demonstração publicada apenas em um artigo: os pesquisadores podem inspecionar a implementação, carregar modelos treinados e tentar reproduzir os resultados de planejamento relatados.
O H-JEPA segue a mesma direção de pesquisa mais ampla que LeCun promove há anos.
JEPA significa Joint-Embedding Predictive Architecture, ou Arquitetura Preditiva de Incorporação Conjunta.
Um modelo de linguagem convencional aprende prevendo tokens futuros. Um JEPA visual, por outro lado, aprende representações das observações e prevê representações-alvo no espaço latente.
Em modelos de mundo como o H-JEPA, as ações são adicionadas ao processo para que o modelo possa prever como a sua representação interna do mundo muda depois de executar uma ação.
Um planejador pode então comparar as consequências previstas de diferentes ações e procurar um caminho até o objetivo.
Isso reflete a visão de longa data de LeCun de que a inteligência exige mais do que geração de linguagem. Na sua agenda de pesquisa, os sistemas precisam compreender o mundo, prever as consequências das ações, lembrar estados relevantes e planejar ao longo do tempo.
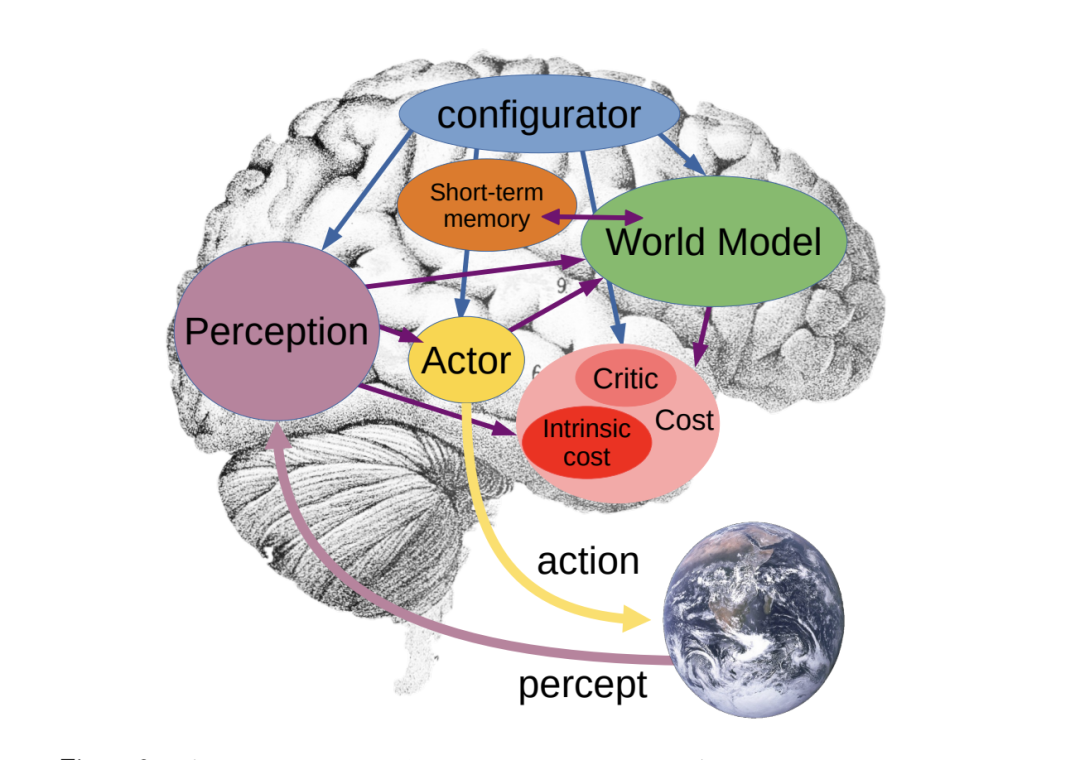
O artigo original também aponta para as críticas recorrentes de LeCun à ideia de que ampliar apenas os LLMs levará necessariamente a uma inteligência de nível humano. Ao mesmo tempo, ele reconhece que as ferramentas baseadas em LLM são extremamente úteis na prática.
O H-JEPA deve, portanto, ser entendido não como uma tentativa de substituir todos os modelos de linguagem atuais, mas como um experimento concreto na arquitetura alternativa que LeCun vem defendendo.
Essa direção de pesquisa agora faz parte da estratégia empresarial da AMI.
A AMI captou US$ 1,03 bilhão em março de 2026, com uma avaliação pré-investimento de US$ 3,5 bilhões, segundo a Reuters e outras reportagens contemporâneas.
A empresa é liderada por uma equipe que inclui:
Michael Rabbat também é um dos autores do artigo do H-JEPA.
A AMI descreve o seu objetivo como a construção de sistemas que compreendam o mundo, mantenham memória persistente, raciocinem e planejem, permanecendo controláveis e seguros.
No momento do artigo de origem do BAAI, a empresa ainda se apresentava principalmente por meio da sua pesquisa, equipe e oportunidades de contratação, em vez de um produto público amplamente disponível.
O H-JEPA é significativo, portanto, em parte porque fornece um resultado técnico concreto da tese da startup sobre modelos de mundo.
O texto de origem encerra comparando a AMI com outra empresa de modelos de mundo de grande destaque: a World Labs, de Fei-Fei Li.
Em 28 de setembro de 2026, a AMD anunciou um acordo definitivo para adquirir a World Labs.
O documento protocolado pela AMD junto à SEC avalia a transação totalmente em ações em aproximadamente US$ 8,2 bilhões, sujeita aos ajustes habituais.
As duas empresas seguem caminhos organizacionais diferentes, mas ambas refletem a importância crescente dos modelos de mundo, da inteligência espacial, da robótica, da simulação e da IA física.
A AMI continua desenvolvendo o seu próprio programa de pesquisa em torno de modelos preditivos hierárquicos, enquanto a World Labs avança em direção à integração com uma grande empresa de computação para IA.
Para o H-JEPA, a questão imediata é mais técnica do que corporativa: até que ponto o planejamento hierárquico latente pode avançar do controle simulado e dos vídeos offline de robôs para sistemas mais ricos e reais em malha fechada?
Esse é o próximo teste da arquitetura.
O H-JEPA é um modelo de mundo hierárquico de ponta a ponta para planejamento visual. Ele empilha vários JEPAs condicionados por ações, de modo que os níveis superiores prevejam mais longe no futuro e transmitam subobjetivos latentes aos níveis inferiores.
Um modelo de mundo plano utiliza uma única representação e uma única escala temporal de planejamento. O H-JEPA aprende espaços latentes separados em várias escalas temporais, permitindo que os níveis superiores se concentrem em estruturas lentas e relevantes para a tarefa, enquanto os níveis inferiores preservam os detalhes necessários para o controle.
O repositório oficial no GitHub informa cerca de 73,3% de sucesso no planejamento para um H-JEPA de três níveis, contra 18,0% do modelo de referência plano LeWorldModel. A hierarquia também alcança uma relação melhor entre sucesso e custo computacional do planejador.
SIGReg significa Sketched Isotropic Gaussian Regularization. O método foi introduzido no LeJEPA para restringir as distribuições latentes e evitar o colapso da representação, situação em que um codificador mapeia muitos estados diferentes para embeddings quase idênticos.
Sim. O lançamento oficial do código no GitHub utiliza a licença MIT, e os checkpoints pré-treinados estão disponíveis no Hugging Face. O repositório associado do conjunto de dados H-JEPA foi publicado sob a licença CC BY 4.0.
O artigo estende a abordagem a vídeos diversos de robôs reais do DROID usando supervisão de dinâmica inversa. Esses experimentos avaliam a fidelidade do planejamento offline, e não o sucesso completo de tarefas robóticas em malha fechada. Portanto, o resultado não deve ser apresentado de forma exagerada como uma implantação autônoma no mundo real.
Não. O artigo mostra que hierarquias mais profundas ajudam quando a tarefa contém uma estrutura significativa em várias escalas temporais, mas hierarquias muito profundas podem prejudicar tarefas mais curtas, como Push-T, porque os níveis superiores podem receber poucos sinais de treinamento úteis.
Ele segue a tese de LeCun sobre JEPA e modelos de mundo: aprender representações compactas do mundo, prever estados latentes futuros em vez de cada pixel e usar essas previsões para o planejamento. O H-JEPA acrescenta uma hierarquia explícita para que diferentes níveis operem em diferentes escalas temporais e níveis de abstração.
O H-JEPA transforma a ideia de modelo de mundo JEPA em uma hierarquia explícita de planejamento. Os níveis superiores operam em horizontes mais longos e com representações mais abstratas, enquanto os níveis inferiores traduzem esses planos em subobjetivos e ações progressivamente mais concretos.
O resultado mais forte aparece no Visual AntMaze, onde um H-JEPA de três níveis alcança aproximadamente 73% de sucesso no planejamento, contra 18% do modelo de referência plano LeWorldModel, ao mesmo tempo que melhora a eficiência do planejamento. O trabalho também mostra que a hierarquia não é útil automaticamente: a escala temporal da tarefa e a disponibilidade de dados determinam se os níveis adicionais ajudarão.
O projeto é excepcionalmente reproduzível para um lançamento de pesquisa recente, com código, checkpoints e conjuntos de dados já públicos.
A principal contribuição do H-JEPA não é simplesmente uma pontuação melhor no labirinto; é uma demonstração concreta de que os modelos de mundo podem se beneficiar do aprendizado de diferentes representações para diferentes horizontes de planejamento.
Comece com uma frase e tenha um site completo em minutos.



