For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness², também escrito Harness2, explora uma forma prática de melhoria recursiva: alterar o software ao redor de um modelo de linguagem co...
Harness², também escrito Harness2, explora uma forma prática de melhoria recursiva: alterar o software ao redor de um modelo de linguagem congelado. Seu ambiente de execução editável inclui prompts, proteções, memória, habilidades, orientações para ferramentas, scripts, subagentes e middleware.
A pesquisa vem do Google Cloud AI Research e da Northwestern University. Em vez de treinar um novo modelo após cada falha, o sistema estuda a execução de um agente, testa alterações em seu harness e mantém evidências sobre quais mudanças ajudaram.
Os autores relatam que uma etapa de melhoria eleva a pontuação média do GLM-5 no WorkBuddy-Bench de 64,2 para 75,7 usando o OpenCode. Isso representa um ganho de 11,5 pontos em uma avaliação específica, e não uma melhoria garantida para qualquer modelo ou aplicação.
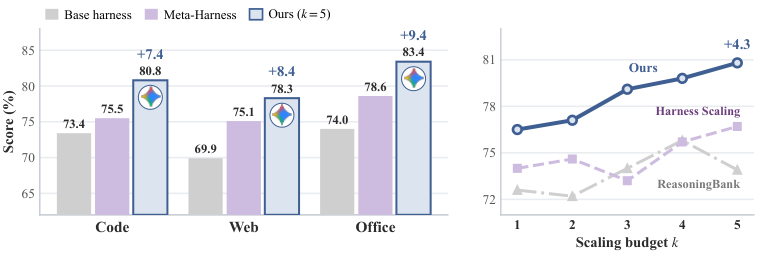
Figura da equipe de pesquisa, reproduzida no relatório da QbitAI/BAAI.
Dois problemas motivam o trabalho.
O Harness2 separa o harness de execução da tarefa atual do processo que o aprimora. Uma tarefa posterior começa com o harness-base comum; o sistema de melhoria recupera seletivamente evidências anteriores em vez de transportar cegamente todas as regras anteriores.
Primeiro, o sistema registra uma execução de referência usando o harness inicial. Em seguida, utiliza esse rastreamento para identificar pontos fracos e testar possíveis reparos.
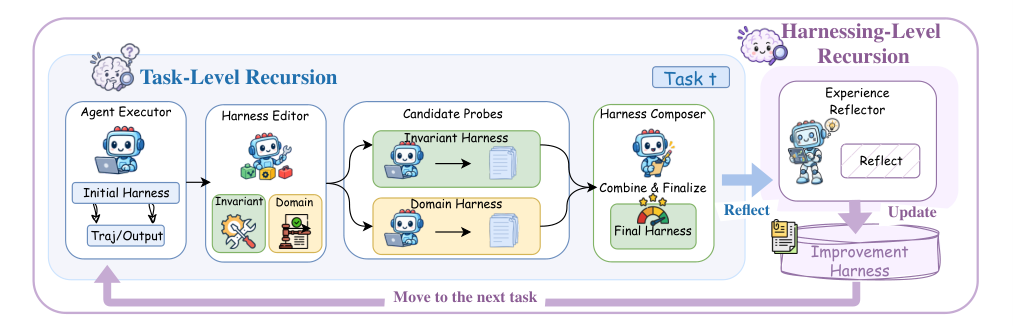
A etapa de melhoria tem três fases:
A comparação comportamental substitui o feedback de verdade fundamental indisponível durante a adaptação. Ela não é um juiz infalível da correção final. A avaliação externa de benchmarks continua sendo importante para medir se o método funciona.
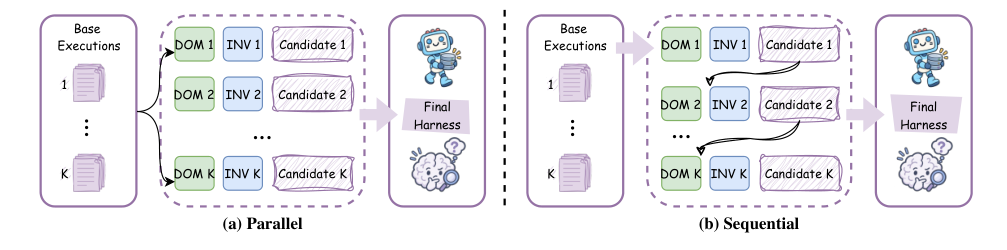
O método pode explorar mais amplamente por meio da recursão paralela ou fazer revisões sucessivas por meio da recursão sequencial. Com um orçamento paralelo k, ele testa k candidatos gerais e k candidatos de domínio e, em seguida, produz k composições. Mais candidatos exigem mais computação.
Após uma tarefa, um refletor de experiências examina o rastreamento de referência, as edições propostas, as evidências dos testes e as decisões de composição. Ele registra componentes reutilizáveis e aprendizados, incluindo notas no arquivo EXPERIENCE.md.
A tarefa seguinte recebe o harness-base de execução, mas o processo de edição pode recuperar esses aprendizados anteriores. O que persiste é o conhecimento sobre quando um reparo é útil, e não a suposição de que a configuração completa da última tarefa deve se tornar permanente.
Os parâmetros do modelo permanecem fixos. Trata-se de adaptação em tempo de execução por meio de arquivos e evidências de execução, e não de uma demonstração de treinamento autônomo dos pesos do modelo.
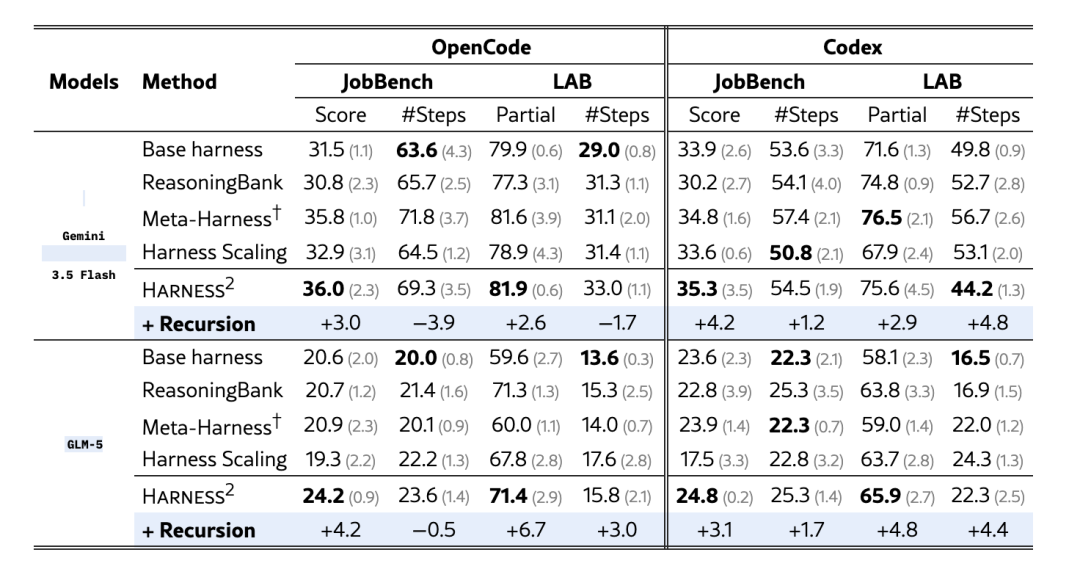
O estudo avalia os entregáveis de programação, web e escritório do WorkBuddy-Bench, as tarefas profissionais do JobBench e o Harvey's Legal Agent Benchmark. Ele usa o GLM-5 e o Gemini 3.5 Flash com o OpenCode e o Codex como harnesses de execução.
O editor padrão é o Claude Opus 4.8 no OpenCode. Consequentemente, os resultados principais envolvem um sistema de melhoria ao redor do executor; eles não devem ser descritos como um aumento gratuito de capacidade proveniente apenas do executor.
| Modelo executor | Harness inicial | Média-base do WorkBuddy | Uma etapa do Harness2 | Ganho |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64,2 | 75,7 | 11,5 pontos |
| GLM-5 | Codex | 64,4 | 75,3 | 10,9 pontos |
| Gemini 3.5 Flash | OpenCode | 72,4 | 77,5 | 5,1 pontos |
| Gemini 3.5 Flash | Codex | 74,5 | 77,5 | 3,0 pontos |
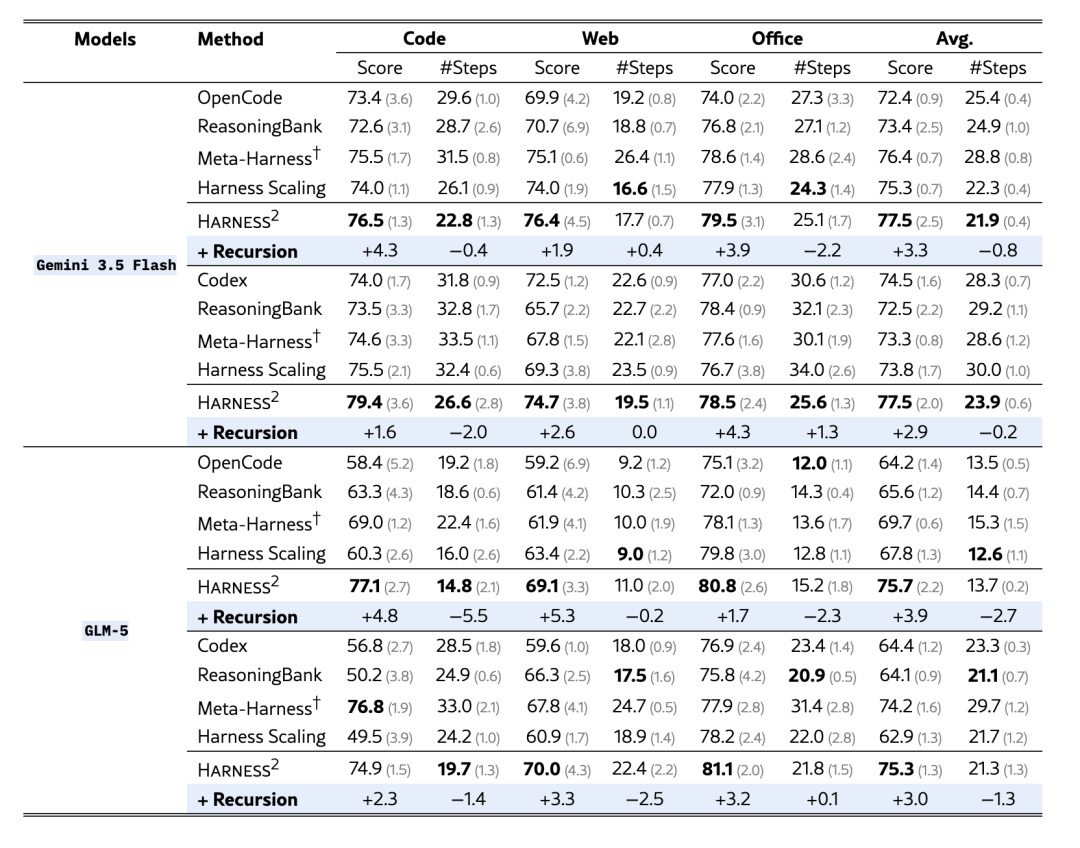
O GLM-5 com o harness aprimorado supera a linha de base correspondente e não modificada do Gemini nessa comparação. Isso ilustra como o design do ambiente de execução pode afetar a classificação dos modelos; não demonstra que o GLM-5 seja mais forte em todas as tarefas.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O artigo relata ganhos de uma etapa de até 4,5 pontos no JobBench e 11,8 pontos percentuais no LAB Partial, a taxa de aprovação por critério. Partial é diferente da proporção de tarefas que atendem a todos os critérios.
Aumentar o orçamento paralelo para k=5 acrescenta até 3,9 pontos no WorkBuddy, 4,2 pontos no JobBench e 6,7 pontos percentuais no LAB Partial além de uma etapa. As tabelas principais relatam médias e desvios-padrão de três execuções com a ordem das tarefas embaralhada.
O experimento de transferência também é útil. Uma biblioteca acumulada no JobBench melhora o refinamento de uma etapa do WorkBuddy em 0,6 ponto em programação, 0,5 em web e 2,9 em escritório, sem testes adicionais nessa comparação.
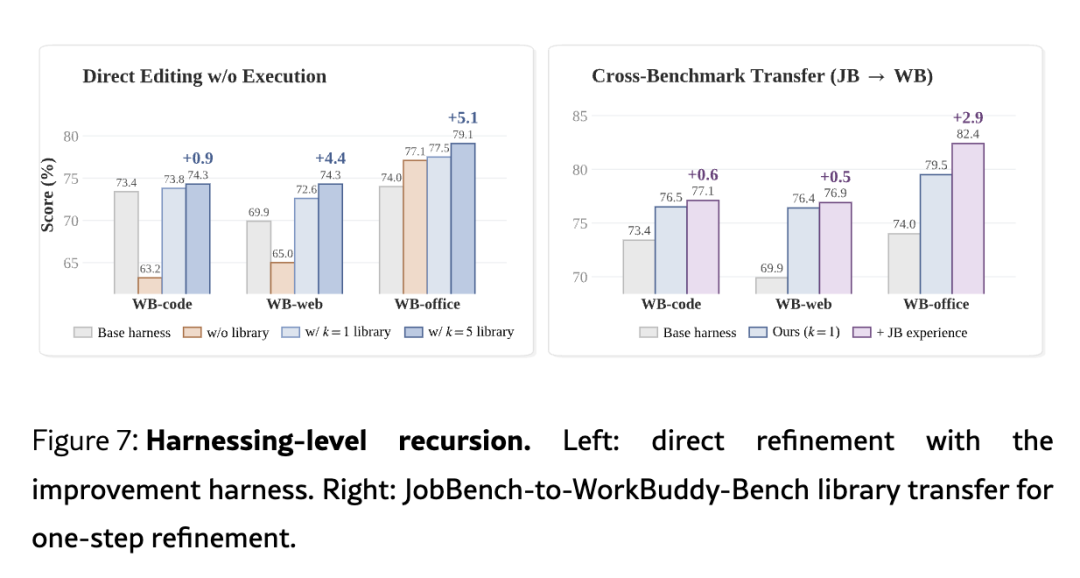
Esses resultados apoiam a reutilização seletiva de experiências de melhoria. Eles não mostram que toda regra acumulada seja transferida nem eliminam a necessidade de verificar um harness adotado na distribuição real de tarefas.
O artigo lista nove autores: Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee e Tomas Pfister. A fonte apresenta Xu, doutorando da Northwestern, e os pesquisadores do Google Cloud Chen e CuiZhu.
O repositório público oferece suporte aos dois harnesses de execução e aos dois modos de recursão. Ele especifica Linux, Python 3.12 e uv; os benchmarks baseados em modelos têm dependências adicionais e custos de API. O WorkBuddy exige Docker, enquanto o LAB precisa de ferramentas como Pandoc e Poppler.
O README também alerta que o acesso do executor à rede é irrestrito e que o sandbox de execução do Codex está desativado nessa configuração. Os usuários dos benchmarks precisam configurar restrições contra o acesso a respostas e rubricas antes de avaliar os resultados. As melhorias de execução do artigo devem ser analisadas em conjunto com essas condições de execução e avaliação.
Ele modifica o ambiente de execução ao redor de um modelo de linguagem, incluindo prompts, ferramentas, memória e habilidades. Os pesos do modelo subjacente permanecem congelados.
A recursão no nível da tarefa testa e compõe reparos para a tarefa atual. A recursão no nível do harness retém evidências e aprendizados reutilizáveis para melhorar decisões de edição posteriores.
Seu método de adaptação usa contrastes entre rastreamentos de execução, em vez de um verificador de verdade fundamental. Isso disponibiliza evidências quando os rótulos estão ausentes, mas não garante que o artefato resultante esteja correto.
Não. Esse é o aprimoramento médio relatado no estudo para GLM-5/OpenCode no WorkBuddy. Outras combinações de modelo, harness e benchmark apresentam ganhos diferentes.
Ele acrescenta execuções de candidatos e trabalho de melhoria. O artigo analisa o desempenho junto com a computação total, incluindo tokens de execução e de melhoria.
O repositório lista o Docker para o WorkBuddy-Bench. A demonstração determinística local e os outros benchmarks têm requisitos diferentes; portanto, siga as instruções do fluxo de trabalho selecionado.
Harness2 combina experimentação específica para cada tarefa com uma biblioteca de aprendizados sobre como melhorar ambientes de execução de agentes. Os ganhos relatados mostram que prompts, tratamento de ferramentas e estrutura de execução podem alterar materialmente os resultados mesmo quando os pesos do modelo permanecem fixos.
As evidências apoiam uma engenharia melhor de harnesses em condições testadas, mantendo visíveis os limites de computação, verificação e transferência.
Comece com uma frase e tenha um site completo em minutos.



