For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
Levar uma carga de trabalho de IA para um dispositivo local exige mais do que um acelerador capaz. Os desenvolvedores precisam de uma forma ...
Levar uma carga de trabalho de IA para um dispositivo local exige mais do que um acelerador capaz. Os desenvolvedores precisam de uma forma de preparar modelos, executá-los com eficiência, conectar vários componentes e manter o produto final.
O mais recente anúncio de ecossistema da Houmo aborda essa camada de software. Segundo o relatório fornecido, a empresa planeja lançar sua pilha de software de IA em etapas, com 15 projetos previstos para serem disponibilizados até janeiro de 2027. Vários repositórios já são públicos, incluindo exemplos de modelos, ferramentas de quantização e adaptações de frameworks conhecidos de inferência.
A distinção entre o roteiro e o código disponível hoje é importante. Um plano para abrir toda a pilha não significa que todos os componentes já foram publicados nem que todas as dependências de runtime deixaram de existir.
O relatório organiza a pilha em quatro camadas:
| Camada | Papel em uma implantação |
|---|---|
| Preparação de modelos | Quantização, compilação, verificações de precisão e conversão para um formato compatível |
| Framework de inferência, operadores e runtime | Execução e agendamento no hardware Houmo |
| Kits de domínio, pipelines e middleware | Coordenação entre modelos e componentes da aplicação |
| Implantação e operações | Atualizações, monitoramento e gerenciamento entre dispositivos implantados |
Um assistente de reuniões ilustra por que essas camadas precisam estar integradas. O reconhecimento de fala deve alimentar um modelo de linguagem, o modelo de linguagem deve produzir um registro útil, e a aplicação precisa salvá-lo ou exibi-lo. Cada etapa tem seus próprios requisitos de memória, latência e compatibilidade.
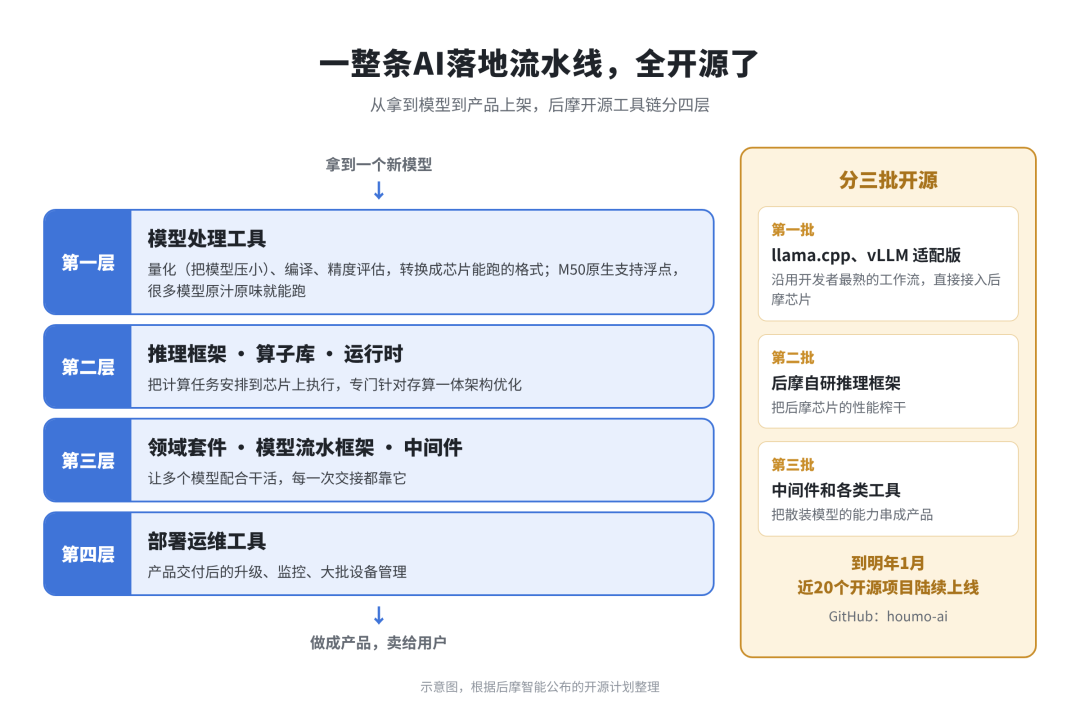
Diagrama da pilha de software do relatório Xinzhiyuan/BAAI; os rótulos originais estão em chinês.
A sequência de lançamento relatada começa com adaptações de llama.cpp e vLLM, seguidas pelo framework de inferência da própria Houmo e, depois, por middleware e outras ferramentas. O roteiro mais amplo também inclui infraestrutura para gerenciamento de aceleradores e clusters.
O repositório público postmo-modelzoo descreve exemplos que abrangem quantização, compilação, avaliação de precisão, medição de desempenho e implantação de aplicações. Suas categorias de modelos incluem reconhecimento de fala, geração de fala, modelos de linguagem, modelos de visão e linguagem, embeddings, OCR, segmentação e geração de imagens.
Outros repositórios visíveis incluem postmo-quantflow, postmo-gptqmodel, vllm-postmo e forks da Houmo de llama.cpp e vLLM. Os desenvolvedores devem verificar o README e a ramificação atual de cada repositório, em vez de pressupor procedimentos de instalação ou níveis de suporte idênticos.
O README dos exemplos de modelos apresenta várias restrições concretas:
houmo-tcim-runtime e houmo-drv.Esses requisitos são importantes para o planejamento. Um repositório aberto de exemplos fornece código de integração que pode ser examinado, mas não é um ambiente de execução independente de hardware.
A fonte afirma que mais de 100 clientes e mais de 150 produtos terminais planejados estão associados ao M50. Esses números descrevem o pipeline do ecossistema relatado, e não remessas auditadas.
O relatório descreve o P7 da Lenovo como um computador de IA de aproximadamente 300 gramas, com potência máxima do sistema de 30 W. Ele relata a operação local de um modelo de 122 bilhões de parâmetros a 50 tokens por segundo, com suporte a um contexto de 128K.
Esses números devem ser considerados juntamente com as condições de teste ausentes. O artigo não fornece detalhes suficientes sobre arquitetura do modelo, precisão, carga de trabalho e configuração de medição para tratá-los como uma garantia geral de desempenho. Em especial, a contagem de parâmetros por si só não informa ao leitor quanta memória uma implantação exige.
O próprio M50 é descrito como oferecendo 160 TOPS de desempenho INT8, um consumo típico de 10 W e suporte para até 48 GB de memória LPDDR5/5X. A potência do acelerador, a potência total do sistema, a taxa de transferência teórica e a velocidade de geração de tokens medem aspectos diferentes.
Outros produtos relatados incluem uma versão M50 do Truffle 1 da Deepshard, o HomeAgent HA100 Pro da Ugreen e o ClawHouse X1. Seus exemplos se concentram em memória local, processamento de mídia doméstica e interfaces de agentes pessoais. Serviços conectados, como e-mail, ainda dependem de autenticação e acesso à rede, mesmo quando um modelo é executado localmente.
O relatório descreve um laptop Great Wall N90 Pro executando Kylin V11 e um modelo de 35B offline a 30 tokens por segundo. Também discute um robô companheiro que usa processamento local para percepção e memória, além de um dispositivo educacional baseado em placas aceleradoras LM5040, cada uma integrando quatro chips M50.
Os valores relatados de computação e memória do sistema educacional se aplicam à máquina montada, não a um único M50. Leitores que comparam produtos devem solicitar a contagem real de placas, a topologia de memória, a precisão e a carga de trabalho medida.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A discussão sobre arquitetura distingue modelos de mistura de especialistas de modelos densos. Um modelo MoE pode ativar um subconjunto de especialistas para um token, embora ainda exija armazenamento para seu conjunto mais amplo de parâmetros. Modelos densos normalmente usam uma fração maior de seus parâmetros por etapa, tornando o tráfego de memória uma consideração importante.
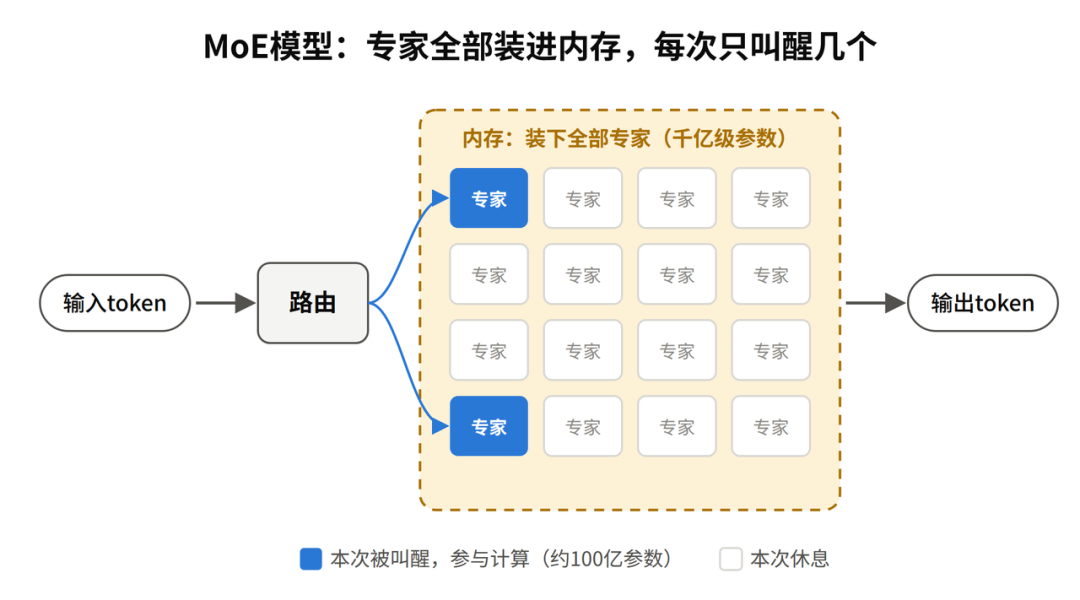
Ilustração de MoE do relatório de origem; os rótulos originais explicam os especialistas armazenados e ativados.
A Houmo apresenta dois caminhos de desenvolvimento: computação em memória 2D, com ênfase em capacidade e computação com memória externa, e computação em memória 3D, com ênfase em largura de banda por meio de um design empilhado. O relatório descreve a computação baseada em SRAM na camada lógica como uma característica distintiva desta última.
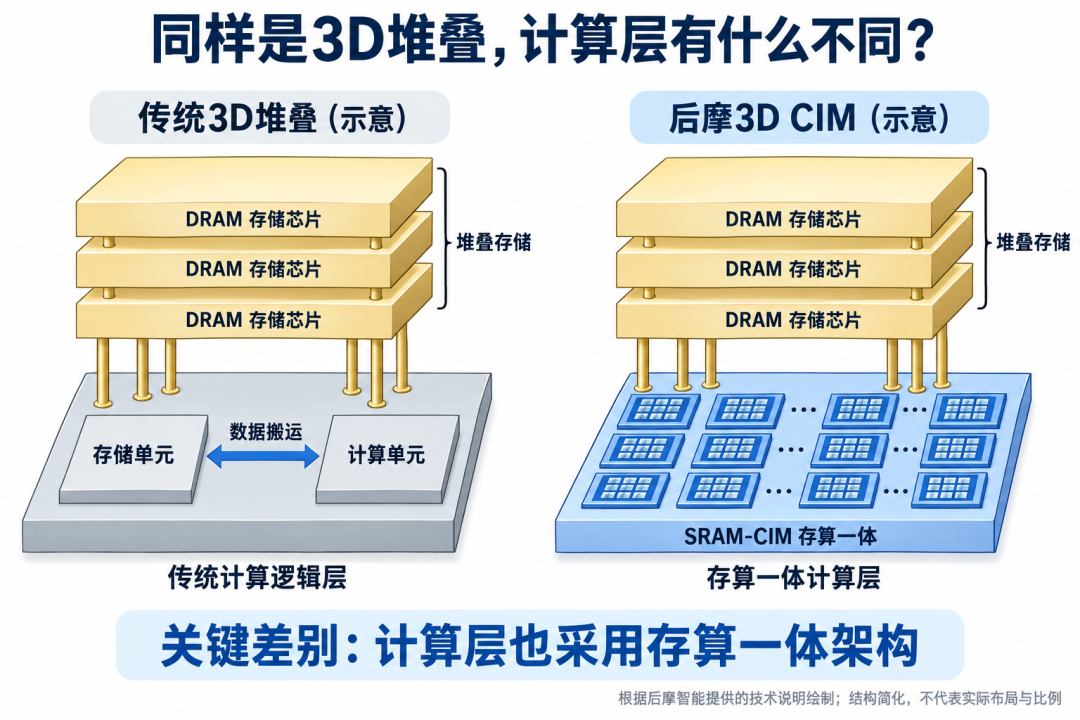
Comparação de arquitetura reproduzida no relatório Xinzhiyuan/BAAI, e não um benchmark independente.
As comparações de área e consumo de energia da empresa dependem do que está sendo comparado. Elas não devem ser aplicadas a todos os chips ou modelos sem uma configuração de medição divulgada. Referências futuras a Flash ou RRAM também descrevem uma direção de desenvolvimento, não uma garantia de disponibilidade atual de produtos.
A fonte relaciona esse anúncio ao trabalho anterior do fundador e CEO Qiang Wu com GPGPU e OpenCL. De forma mais prática, publicar ferramentas permite que os desenvolvedores examinem o comportamento de integração, adaptem exemplos e contribuam com correções.
Esse acesso pode reduzir o trabalho repetido entre fabricantes de dispositivos. Ele não elimina a necessidade de testar qualidade, comportamento térmico, uso de memória, licenciamento, operação offline e comportamento de recuperação no produto final. Um exemplo reproduzível no hardware pretendido é um ponto de partida melhor do que uma contagem de parâmetros de destaque.
O M50 é um acelerador de IA de borda utilizado nos cenários de dispositivos locais descritos pelo relatório. Os exemplos incluem computadores agentes, laptops, sistemas domésticos, robôs e dispositivos de inferência de borda.
O relatório descreve um plano de lançamento gradual que se estende até janeiro de 2027. Vários repositórios já são públicos, mas os desenvolvedores devem verificar o status real de lançamento e a licença de cada componente.
O repositório inclui ferramentas de preparação e avaliação com diferentes requisitos de plataforma. Seus exemplos de inferência exigem o hardware Houmo compatível e as bibliotecas de runtime; a quantização de modelos grandes também requer uma GPU.
A inferência local pode funcionar sem um serviço de modelo em nuvem quando os recursos necessários estão instalados. Tarefas que envolvem e-mail ativo, mensagens ou outros serviços online ainda exigem conectividade e autorização.
Não. TOPS é uma métrica de taxa de transferência de operações sob uma precisão especificada, enquanto a velocidade de tokens depende da arquitetura do modelo, do tráfego de memória, da precisão e do comportamento do software. Compare resultados medidos para o mesmo modelo e a mesma carga de trabalho.
Não. O README informa que a maioria dos conjuntos de dados de terceiros deve ser obtida separadamente e usada conforme seus próprios termos. A licença do repositório não concede direitos comerciais sobre todos os dados ou ativos de modelos referenciados.
O anúncio da Houmo busca tornar mais reutilizável o caminho entre a preparação de modelos e um produto de borda em operação. Os repositórios públicos já fornecem exemplos úteis, enquanto a pilha mais ampla continua sendo um plano de lançamento gradual.
Os dispositivos M50 relatados mostram diversos formatos possíveis de implantação, mas a decisão prática ainda depende dos modelos exatos, do hardware e dos requisitos de runtime. Comece com um exemplo compatível e meça a carga de trabalho completa do produto.
Comece com uma frase e tenha um site completo em minutos.
