A Safe Superintelligence passou mais de dois anos revelando pouco sobre o que está construindo. Esse silêncio pode estar prestes a mudar. Ga...
A Safe Superintelligence Inc. passou mais de dois anos mantendo em sigilo aquilo em que está trabalhando.
Esse silêncio pode estar prestes a mudar.
Gavin Baker, sócio-gerente e diretor de investimentos da Atreides Management, disse em uma conversa recente com o investidor e apresentador de podcast Patrick O'Shaughnessy que a SSI afirmou que planeja lançar um modelo em agosto.
A declaração chamou atenção imediatamente, porque a SSI nunca havia anunciado publicamente uma data específica para o lançamento de um modelo.
Fundada em 2024 por Ilya Sutskever, ex-cientista-chefe da OpenAI, juntamente com Daniel Gross e Daniel Levy, a SSI foi construída em torno de uma missão excepcionalmente focada. Seu site oficial ainda descreve a empresa como um laboratório em "linha reta", com um objetivo e um produto: superinteligência segura.
Isso torna qualquer discussão sobre seu primeiro modelo particularmente significativa.
No entanto, desde o início, é preciso deixar clara uma distinção crucial:
Até 7 de agosto de 2026, a própria SSI não havia publicado nenhum anúncio oficial em seu site confirmando o lançamento de um modelo em agosto.
O cronograma de agosto vem da declaração de Baker, não de um comunicado oficial da SSI.
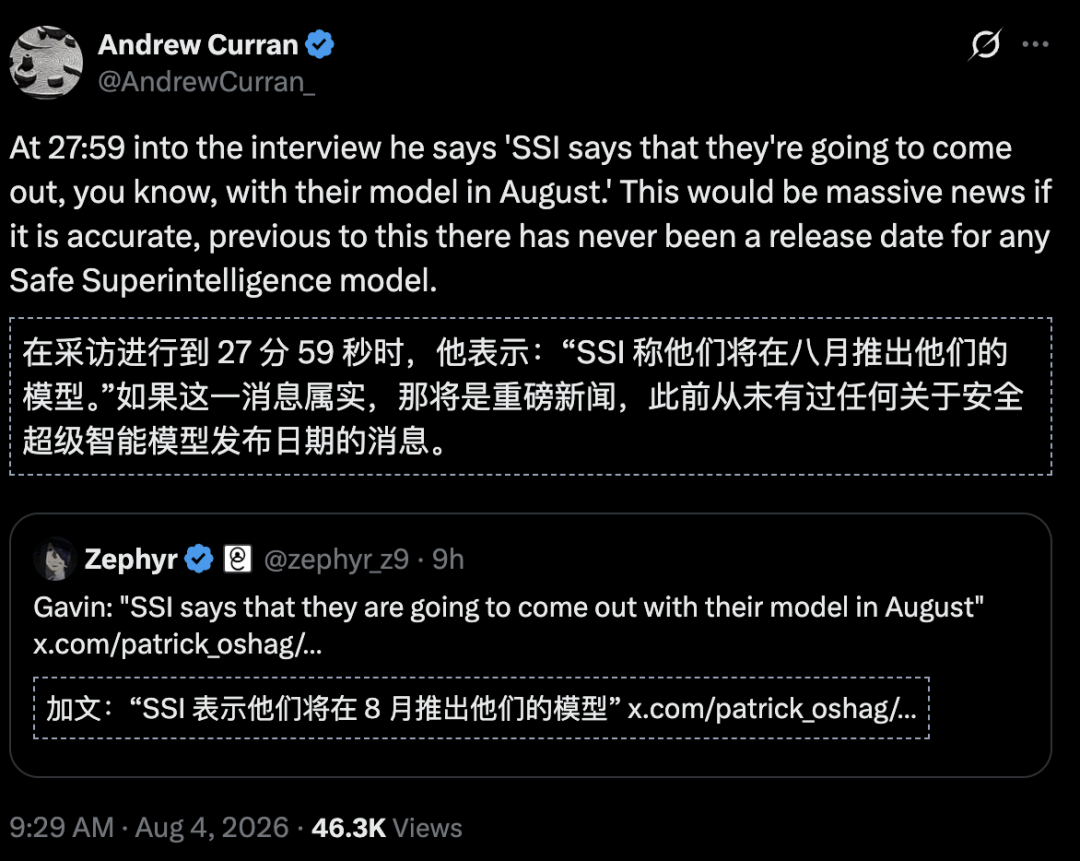
Se a informação de Baker estiver correta, esta será a primeira vez que o mundo terá um vislumbre dos avanços tecnológicos de um dos laboratórios de IA de fronteira mais misteriosos e mais observados.
A declaração crucial surgiu quase de forma casual em meio a uma discussão mais ampla sobre infraestrutura de IA, demanda por semicondutores, aprendizado contínuo e aprendizado eficiente em termos de amostras.
Baker argumentou que, se os modelos puderem aprender de forma eficiente após a implantação, em vez de depender principalmente de pré-treinamento em larga escala, o cenário econômico da IA de fronteira poderia mudar significativamente.
Ao explicar essa possibilidade, ele afirmou que a SSI indicou que "lançará" um modelo em agosto.
Essa declaração deixa muitas perguntas em aberto.
Ela não nos diz:
O artigo de origem interpreta essa declaração como o primeiro lançamento de modelo da SSI.
Essa é uma interpretação razoável, mas a forma exata do lançamento permanece desconhecida.
A declaração de missão oficial da SSI é excepcionalmente direta.
A empresa afirma ter sido fundada para buscar a superinteligência segura, sem interferência de:
Seu roteiro público não é uma série de chatbots, ferramentas de programação, produtos de busca ou serviços empresariais.
Seu roteiro declarado é a própria superinteligência segura.
É por isso que a declaração sobre agosto gerou tanta especulação.
Se a SSI lançar um modelo tradicional de fronteira antes de alcançar a superinteligência, isso pode indicar que a estratégia de produtos da empresa mudou.
Se o modelo for apenas uma demonstração da pesquisa em que a SSI vem trabalhando, o lançamento pode ter a intenção de mostrar progresso, em vez de apresentar uma plataforma comercial ampla.
Por enquanto, ambas as interpretações ainda são especulativas.
A frase sobre o lançamento do modelo surgiu durante a discussão de Baker sobre aprendizado contínuo e aprendizado eficiente em termos de amostras.
Esses dois tópicos de pesquisa podem ser mais importantes para a economia da IA do que qualquer resultado de benchmark.
Um modelo de base típico é treinado em grandes estágios.
O processo simplificado é o seguinte:
Um modelo já implantado pode usar informações de sua janela de contexto ou de memória externa, mas seus pesos subjacentes geralmente não são atualizados continuamente a partir de cada interação.
O aprendizado contínuo busca um objetivo muito mais ambicioso.
Um sistema de aprendizado contínuo adquire continuamente habilidades ou conhecimentos úteis ao longo do tempo, sem precisar ser reconstruído do zero e sem esquecer catastroficamente o conhecimento já adquirido.
Isso exige resolver vários desafios:
Portanto, um modelo capaz de aprender continuamente no mundo real seria muito mais do que um chatbot com memória de longo prazo.
Eficiência de amostras é a capacidade de aprender com menos exemplos.
Os humanos geralmente entendem uma nova regra após ver uma ou duas demonstrações.
Os modelos de fronteira atuais muitas vezes exigem quantidades extremamente grandes de dados de treinamento e poder computacional para alcançar melhorias amplas de capacidade.
Um modelo com maior eficiência de amostras pode extrair mais valor de aprendizado de cada item:
Se o aprendizado contínuo e a eficiência de amostras melhorarem juntos, o papel do pré-treinamento pode mudar.
Em vez de construir quase todas as capacidades antes da implantação, os laboratórios poderiam treinar um modelo de base robusto e depois permitir que ele se aprimorasse continuamente por meio da experiência.
Baker conectou essa direção de pesquisa à demanda por semicondutores.
Sua ideia básica é:
Pré-treinamento único em larga escala
        ↓
Implantação do modelo
        ↓
O modelo aprende eficientemente com experiências do mundo real
        ↓
Redução da necessidade de re-treinamentos massivos repetidos
Nesse cenário, o pré-treinamento tradicional de fronteira poderia se tornar uma parcela menor do total de computação de IA.
Inferência e aprendizado contínuo poderiam se tornar mais importantes.
com/cms-assets/image/2026/08/978abe63-4b06-4c22-b491-72bdbd9f94ed-39b95ad5-109d-47b5-b0a1-c1c78a939098.png)
Baker descreveu isso como uma possível descontinuidade nas necessidades de treinamento.
Este é um argumento de investimento, não uma conclusão técnica confirmada.
Para que esse cenário se torne realidade, várias condições precisam ser atendidas:
Mesmo assim, a demanda computacional total não necessariamente cairia.
Um modelo que se torna significativamente mais útil após a implantação pode gerar mais demandas de inferência, atividades de agentes, simulações, geração de dados e cargas de trabalho de aprendizado por reforço.
A estrutura da capacidade computacional pode mudar, mas o mercado total não precisa necessariamente encolher.
O artigo de origem repete uma comparação numérica marcante da discussão de Baker: exemplos de modelos iniciais com cerca de dezenas de bilhões de tokens, enquanto as escalas de treinamento modernas já alcançam centenas de trilhões.
Essa comparação não deve ser interpretada como dados históricos verificados do treinamento do Llama.
A documentação oficial da Meta indica:
O próprio Baker também apresentou os números menores como informações ouvidas, e não como estatísticas formais de ficha técnica de modelo.
Da mesma forma, os laboratórios de fronteira não divulgam a contagem completa de tokens de treinamento de cada modelo proprietário atual.
Mesmo sem depender da comparação precisa de "20 bilhões contra 300 trilhões", o ponto central permanece válido:
O desenvolvimento de modelos de fronteira depende cada vez mais de conjuntos de dados massivos e grandes quantidades de computação. Portanto, se um avanço permitir que sistemas implantados aprendam de forma eficiente a partir de uma quantidade muito menor de novas experiências, isso pode alterar substancialmente a economia da infraestrutura de IA.
A NVIDIA
se beneficia de vários tipos diferentes de cargas de trabalho de IA:
A redução em uma categoria não significa automaticamente uma queda na demanda total por aceleradores.
É por isso que Baker descreve o aprendizado contínuo como um cenário que merece teste de estresse, e não como uma previsão que ele considera definitiva.
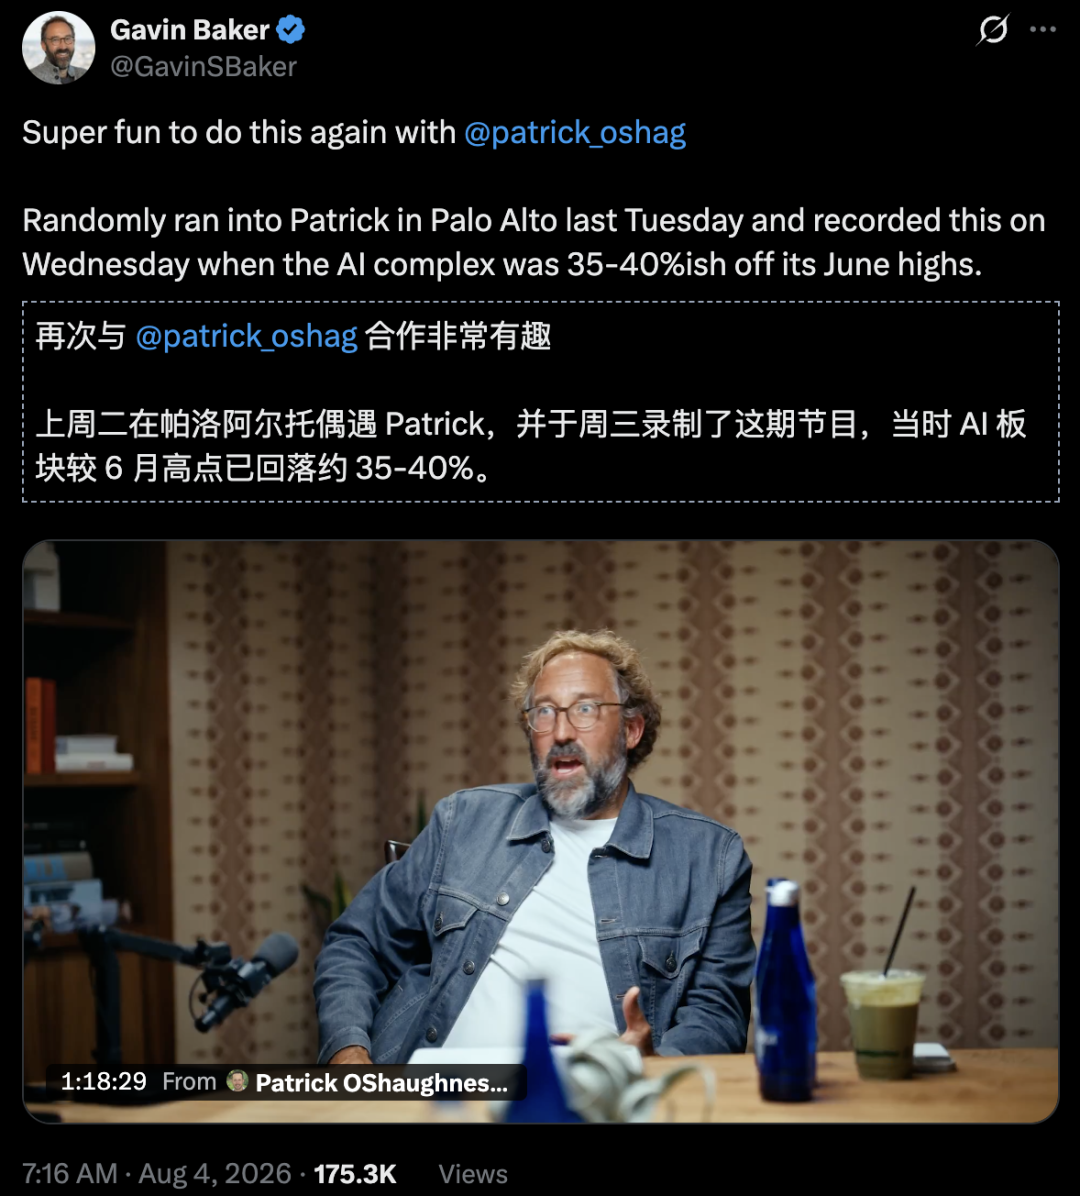
Baker gravou essa conversa durante um período de fraqueza significativa nas ações relacionadas à IA.
Em sua postagem nas redes sociais promovendo a entrevista, ele afirmou que, no momento da gravação, o "setor de IA" havia caído cerca de 35% a 40% em relação ao pico de junho.
Fontes da BAAI compararam a velocidade dessa correção a comprimir o mercado baixista de 2022 em um período muito mais curto.
O objetivo de Baker na conversa era buscar evidências para avaliar se a lógica subjacente do investimento em IA já havia se deteriorado.
Ele discutiu os seguintes indicadores:
Seu argumento não é que o mercado não possa cair ainda mais.
Mas sim que uma verdadeira descontinuidade técnica — como o aprendizado contínuo eficiente — pode ser mais importante para a lógica computacional de longo prazo do que as flutuações de preço das ações no curto prazo.
As fontes gastaram um tempo considerável explicando por que os comentários de Baker sobre a SSI chamaram tanta atenção.
Baker não é funcionário nem porta-voz oficial da SSI.
Ele é um investidor de mercado público.
Atualmente, atua como sócio-executivo e diretor de investimentos da Atreides Management, empresa que fundou em 2019.
Anteriormente, trabalhou na Fidelity Investments de 1999 a 2017.
Suas posições lá incluíram:
Sua experiência de longo prazo no setor de semicondutores é especialmente relevante para esta discussão, porque Baker tem acompanhado a NVIDIA ao longo de várias eras da computação.
Essas eras incluem:
Na conferência GTC da NVIDIA em 2026, Jensen Huang apresentou publicamente Baker como o primeiro grande investidor institucional da NVIDIA.
Essa afirmação pode ser verificada de forma independente nos registros do discurso principal da GTC da própria NVIDIA.
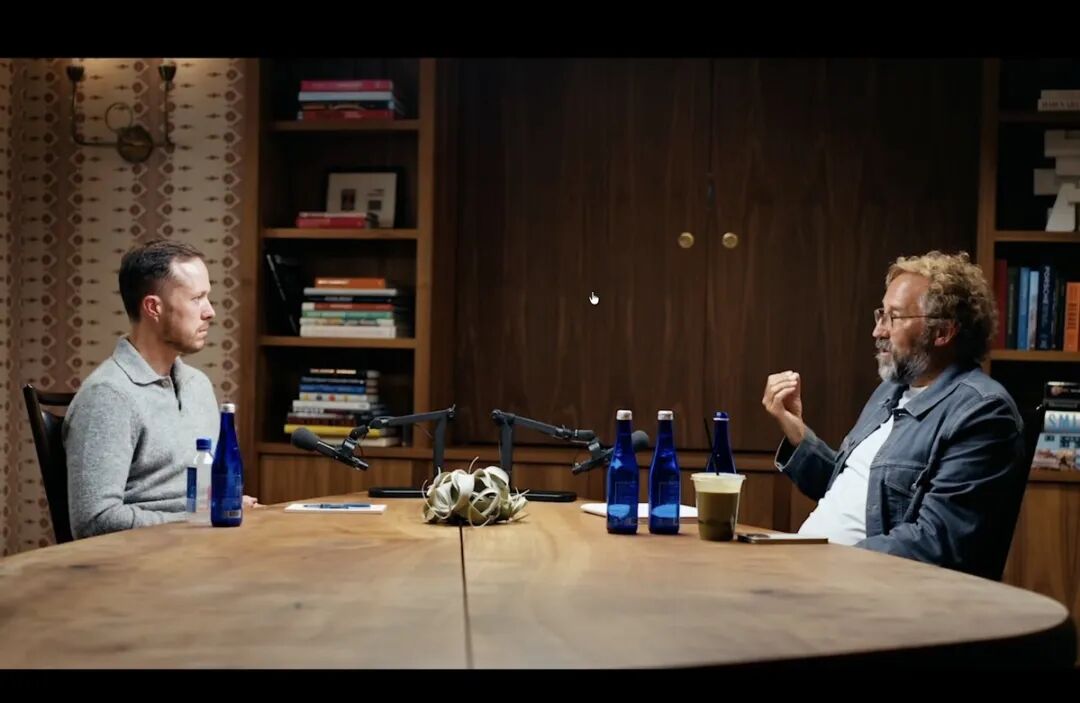
As fontes também destacaram a extensa rede de contatos de Baker em empresas de tecnologia, fundadores, investidores e no ecossistema de semicondutores.
Esse acesso pode explicar por que participantes do mercado levam a sério um comentário casual sobre a SSI.
Mas isso ainda não significa que a declaração equivalha a um anúncio oficial da empresa.
A hierarquia correta de evidências é:
| Fonte | Confiabilidade sobre a data de lançamento da SSI |
|---|---|
| Anúncio oficial da SSI | Máxima |
| Declaração direta de Ilya Sutskever ou da liderança da SSI | Muito alta |
| Anúncio conjunto da NVIDIA mencionando o lançamento | Alta, se específico |
| Gavin Baker descrevendo o que a SSI disse | Declaração de segunda mão confiável |
| Repercussão nas redes sociais dos comentários de Baker | Segunda mão |
| Especulação anônima | Baixa |
Até 7 de agosto, a evidência permanece no nível de "declaração de segunda mão confiável".
O secretismo da SSI é uma das razões pelas quais as expectativas externas são extraordinariamente altas.
A empresa foi fundada em junho de 2024 por:
Sutskever cofundou a OpenAI anteriormente e atuou como cientista-chefe.
A SSI levantou inicialmente cerca de US$ 1 bilhão.
De acordo com relatos, uma rodada no final de 2025 levantou mais US$ 2 bilhões, com valuation de aproximadamente US$ 32 bilhões.
Em julho de 2026, a NVIDIA e a SSI anunciaram uma nova parceria estratégica.
A Reuters, citando fontes, reportou que o investimento da NVIDIA foi de cerca de US$ 5 bilhões, embora as duas empresas tenham dito apenas que o investimento era substancial, sem divulgar valores financeiros específicos no anúncio oficial.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Essa combinação é incomum no setor:
O resultado é que o valor percebido da empresa depende amplamente da confiança em sua equipe de pesquisa e da possibilidade de que seus métodos sejam substancialmente diferentes do caminho dominante dos modelos de fronteira.
O anúncio NVIDIA–SSI de 27 de julho forneceu um dos sinais públicos mais fortes de que a SSI acredita ter entrado em uma nova fase.
A NVIDIA afirmou que entrou na parceria após obter acesso raro à pesquisa estritamente confidencial da SSI.
As duas empresas anunciaram:
Sutskever afirmou que a SSI possui pesquisas que "merecem ser escaladas".
O anúncio ainda não revela:
Mas ele confirma que a SSI passou de exploração pura para escalar uma direção de pesquisa que considera promissora.
A plataforma Vera Rubin da NVIDIA é a próxima arquitetura de computação de IA da empresa.
A NVIDIA afirma que a Rubin melhora:
Especificamente em relação à SSI, o anúncio oficial da parceria afirma que a combinação do investimento com o acesso à Vera Rubin aumentará a capacidade computacional da empresa em uma ordem de magnitude.
É daí que vem a alegação amplamente divulgada de "10x computação".
A escolha das palavras importa.
A NVIDIA não disse que a SSI receberá exatamente 10 vezes mais GPUs.
Ela disse que a parceria
aumentará a capacidade computacional geral da SSI em uma ordem de magnitude.
O momento naturalmente gera especulação.
A linha do tempo é a seguinte:
| Data | Evento |
|---|---|
| Junho de 2024 | SSI é fundada |
| 2024–2025 | SSI levanta bilhões de dólares |
| 27 de julho de 2026 | SSI e NVIDIA anunciam parceria estratégica de longo prazo |
| 27 de julho de 2026 | NVIDIA afirma que a SSI terá acesso à Vera Rubin e aproximadamente 10x mais capacidade computacional |
| 4 de agosto de 2026 | Comentários de Gavin Baker sobre um modelo de agosto começam a se espalhar amplamente |
| 7 de agosto de 2026 | Nenhum anúncio público de lançamento de modelo pela SSI |
A parceria com a NVIDIA pode apoiar um próximo lançamento de modelo ou uma futura fase de expansão.
Atualmente, não há evidência pública de que o acordo de hardware tenha sido assinado especificamente para apoiar o lançamento de agosto.
Uma conclusão mais defensável é:
A parceria forneceu à SSI infraestrutura significativamente ampliada ao mesmo tempo em que um investidor influente sugeriu que a empresa poderia lançar um modelo, mas a conexão entre esses eventos ainda não foi oficialmente explicada.
Em seguida, a fonte mudou da SSI para uma observação mais ampla de Baker sobre IA e mercados financeiros.
Ele comparou o Claude a Walter Cronkite — o influente jornalista de TV americano associado a um alto nível de confiança pública durante a era da transmissão televisiva.
O ponto de Baker não é que o Claude realmente determine a verdade do mercado.
Ele descreve uma possível perda de diversidade na análise financeira.
Um relatório de lucros complexo, um documento de política de semicondutores ou um anúncio regulatório poderiam ser interpretados de forma independente por:
Essas pessoas divergiriam.
Premissas diferentes produziram visões de mercado diferentes.
Agora, muitos participantes do mercado podem enviar o mesmo documento para o mesmo pequeno grupo de modelos de ponta.
Eles fazem perguntas semelhantes:
O que isso significa?
É otimista ou pessimista?
Quais empresas se beneficiam?
Quais são os efeitos de segunda ordem?
O que mudou em relação às expectativas?
Se muitas pessoas dependerem fortemente do mesmo modelo, elas podem obter estruturas analíticas semelhantes e conclusões semelhantes.
Isso pode criar um consenso mediado por modelo.
Os mercados financeiros dependem da divergência.
Compradores e vendedores têm diferentes:
Se uma grande parte da análise se padronizar por meio do mesmo sistema de IA, várias coisas podem acontecer:
Baker descreve isso como um declínio na diversidade analítica.
É uma hipótese interessante, não uma regra empírica comprovada dos mercados modernos.
Existe outra possibilidade.
As ferramentas de IA podem
permitir que um analista teste mais cenários, revise mais documentos, traduza mais fontes e questione o consenso mais rapidamente.
Os usuários também podem comparar as saídas de modelos ou ferramentas como:
Se a IA aumenta ou diminui a diversidade do mercado depende de como as pessoas a utilizam.
O risco está em terceirizar o julgamento para o mesmo modelo sem verificação independente.
Se a SSI realmente lançar um modelo em agosto, as perguntas mais interessantes podem não ser as questões padrão de benchmarks.
Naturalmente, as pessoas vão comparar em termos de:
Mas a missão declarada da SSI torna várias perguntas mais profundas ainda mais importantes.
Os comentários de Baker surgiram em uma discussão sobre aprendizado contínuo.
Isso não prova que o modelo da SSI demonstrará aprendizado contínuo.
Se demonstrar, os pesquisadores vão querer saber:
Se a SSI encontrou uma maneira de aprender mais com menos exemplos, isso pode afetar a economia do treinamento.
Evidências sólidas exigem avaliações transparentes, não anedotas.
A SSI afirma que segurança e capacidade devem progredir juntas.
Um lançamento criaria uma oportunidade para mostrar o que isso significa na prática.
As áreas possíveis incluem:
A SSI ainda não divulgou publicamente quais desses mecanismos definem sua abordagem.
Uma API pública indicaria uma direção de produto.
Um artigo, demonstração, benchmark ou lançamento de pesquisa limitado significaria algo diferente.
Até que a própria SSI se manifeste, o termo "lançamento de modelo" é ambíguo demais para responder a essa pergunta.
A SSI é um dos poucos laboratórios de ponta cuja premissa fundacional é explicitamente evitar a competição comum de produtos até que seu objetivo central de pesquisa esteja pronto.
Isso torna um lançamento mais do que um teste de qualidade do modelo.
Será um teste de várias crenças que circulam em torno da empresa desde 2024:
A parceria com a NVIDIA elevou as expectativas porque a NVIDIA afirmou ter visto os resultados de pesquisa da SSI antes de comprometer capital significativo e poder computacional de próxima geração.
Os comentários de Baker adicionaram um cronograma possível.
Nenhum dos dois nos diz exatamente o que é esse modelo.
Sutskever, Daniel Gross e Daniel Levy em 2024.
A Safe Superintelligence Inc. lançará um modelo em agosto de 2026?
Gavin Baker afirmou em uma entrevista recente que a SSI disse que lançará um modelo em agosto. Até 7 de agosto de 2026, a SSI não publicou nenhum anúncio oficial em seu site confirmando essa data.
Se um modelo for lançado, este será o primeiro modelo ou sistema de nível de produto a ser apresentado publicamente pela SSI. Desde sua fundação, a empresa opera de forma majoritariamente sigilosa, sem ter lançado uma linha regular de modelos.
Não. A missão oficial da SSI é construir superinteligência segura, mas não há informações públicas confirmando que o suposto modelo de agosto tenha atingido esse nível. As capacidades, arquitetura, benchmarks e formato de lançamento do modelo permanecem desconhecidos.
Aprendizado contínuo é a capacidade de um sistema continuar aprendendo com novas experiências ao longo do tempo, sem precisar ser retreinado repetidamente do zero e sem esquecer capacidades anteriores. O aprendizado contínuo confiável ainda é um tópico de pesquisa ativo, especialmente para modelos grandes já implantados.
Se modelos puderem eventualmente aprender de forma eficiente após a implantação, parte da computação pode migrar de pré-treinamento periódico em larga escala para inferência, aprendizado online, simulação e pós-treinamento. Isso mudaria a composição da demanda por aceleradores, mas não necessariamente reduziria a demanda total por computação em IA.
Sim. A NVIDIA e a SSI anunciaram formalmente uma parceria estratégica de longo prazo e um investimento significativo em julho de 2026. A Reuters reportou que o valor do investimento é de aproximadamente US$ 5 bilhões, mas as duas empresas não divulgaram os valores financeiros em seus anúncios oficiais.
A NVIDIA afirmou que a SSI terá acesso à sua próxima plataforma Vera Rubin e que a parceria aumentará a capacidade computacional da SSI em aproximadamente uma ordem de magnitude. As duas empresas também colaborarão no desenvolvimento de futuras plataformas de computação.
Gavin Baker é sócio-gerente e diretor de investimentos da Atreides Management.
Anteriormente, trabalhou na Fidelity Investments por quase duas décadas. Na conferência GTC da NVIDIA em 2026, Jensen Huang o descreveu como o primeiro grande investidor institucional da NVIDIA.
Gavin Baker deu a primeira indicação pública confiável sobre o cronograma de lançamento da Safe Superintelligence, afirmando que a SSI planeja lançar um modelo em agosto de 2026. Até 7 de agosto, a própria SSI não confirmou publicamente esse cronograma, portanto a data ainda deve ser tratada como uma alegação da imprensa e não como um anúncio oficial.
Esse comentário é importante em parte por causa de seu contexto. Baker falava sobre aprendizado contínuo e aprendizado eficiente em termos de amostras — direções de pesquisa que podem deslocar a computação de IA de pré-treinamentos em larga escala para sistemas que continuam aprendendo após a implantação.
Hoje, o campo de modelos é dominado por pré-treinamentos cada vez maiores e está se movendo em direção a sistemas que podem continuar aprendendo após serem implantados.
A SSI também acaba de firmar uma grande parceria estratégica com a NVIDIA. Esse acordo formal dá à empresa acesso aos sistemas Vera Rubin, com um aumento esperado de aproximadamente uma ordem de magnitude na capacidade computacional, e a NVIDIA afirma que decidiu fechar a parceria após obter acesso especial à pesquisa privada da SSI.
O fato-chave de hoje não é que a SSI confirmou o lançamento de uma superinteligência, mas que um investidor excepcionalmente bem conectado afirma que seu primeiro modelo pode finalmente estar próximo — e que a empresa agora tem recursos computacionais significativamente maiores para escalar o que vem construindo.
Comece com uma frase e tenha um site completo em minutos.



