For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
Em apenas algumas semanas, a TypeSafe AI passou de uma relativa obscuridade a uma das startups de infraestrutura mais observadas do setor de...
Em apenas algumas semanas, a TypeSafe AI passou de uma relativa obscuridade a uma das startups de infraestrutura mais observadas do setor de IA.
A empresa anunciou uma rodada Série A de US$ 870 milhões, com uma avaliação pós-investimento de US$ 7,5 bilhões.
Isso seria notável em qualquer circunstância. O que torna a história incomum é o produto por trás desse impulso: o Jev, um modelo que não tenta ser um chatbot, não gera textos longos e não foi projetado principalmente para escrever código.
Sua função é muito mais específica.
Ele toma decisões.
Uma solicitação típica ao Jev se parece mais com:
Dado este estado,
qual opção o software deve escolher?
do que com:
Escreva uma explicação detalhada para mim.
A TypeSafe chama o Jev de modelo System One: um modelo criado para decisões rápidas, limitadas e estruturadas que o software pode usar diretamente.
Em vez de texto livre, o Jev retorna elementos como:
Esse foco específico tornou o Jev barato e rápido o suficiente para funcionar em fluxos de software de alto volume, nos quais um LLM de fronteira convencional seria desnecessariamente lento ou caro.
E a reação do mercado foi extrema.
A TypeSafe AI foi fundada em 2024, em São Francisco.
Antes do lançamento do Jev, a empresa passou aproximadamente dois anos operando em modo furtivo.
Sua estreia pública ocorreu em 15 de setembro de 2026, quando a TypeSafe apresentou seu primeiro modelo System One e explicou a abordagem de treinamento por trás dele: Reinforcement Learning for Calibrated Decisions, ou RLCD.
A fonte original observa que a TypeSafe havia anunciado anteriormente uma rodada seed de US$ 40 milhões por volta do lançamento do Jev. Menos de um mês depois, a empresa anunciou a rodada Série A, muito maior.
A publicação oficial sobre o financiamento da TypeSafe confirma:
| Item | Detalhe confirmado |
|---|---|
| Série A | US$ 870 milhões |
| Avaliação pós-investimento | US$ 7,5 bilhões |
| Investidor líder | Andreessen Horowitz |
| Outros participantes nomeados | Sequoia Capital, DCVC e investidores-anjo |
| Novo membro do conselho | Martin Casado |
A empresa afirma que usará o novo capital para:
O ponto importante é que os investidores não estão apostando apenas em mais um modelo de fronteira de uso geral.
Eles estão apostando em uma categoria diferente de modelo.
A ideia central do Jev é simples: muitos sistemas de software não precisam de parágrafos.
Eles precisam de uma decisão.
Exemplos incluem:
Os LLMs tradicionais conseguem responder a essas perguntas, mas normalmente fazem isso por meio da geração autorregressiva de texto.
A TypeSafe argumenta que isso é ineficiente quando a aplicação já conhece o formato da resposta.
O design do Jev funciona assim:
Estado estruturado
      ↓
Perguntas tipadas
      ↓
Computação paralela da decisão
      ↓
Probabilidades + saídas limitadas
      ↓
A aplicação segue um ramo com base no resultado
A TypeSafe descreve isso como inteligência “nativa para máquinas”: o modelo é otimizado para ser integrado ao código, em vez de produzir linguagem para leitura humana.
Atualmente, a TypeSafe lista o Jev com os seguintes preços:
Entrada: US$ 0,042 / 1 milhão de tokens
Saída: gratuita / não contabilizada
Esse preço é muito inferior ao da maioria dos modelos de fronteira de uso geral.
A razão é arquitetural.
O Jev não gera texto arbitrário token por token. A TypeSafe afirma que seu amostrador retorna as saídas limitadas de uma decisão em paralelo.
A empresa declara uma latência ponta a ponta na faixa aproximada de 70–500 ms para seu serviço e afirma que o Jev pode ser 40–200 vezes mais rápido em cargas de trabalho comparáveis no formato System One.
Esses números vêm da avaliação publicada pela própria TypeSafe e devem ser interpretados como afirmações do fornecedor para o formato de tarefa ao qual o Jev se destina.
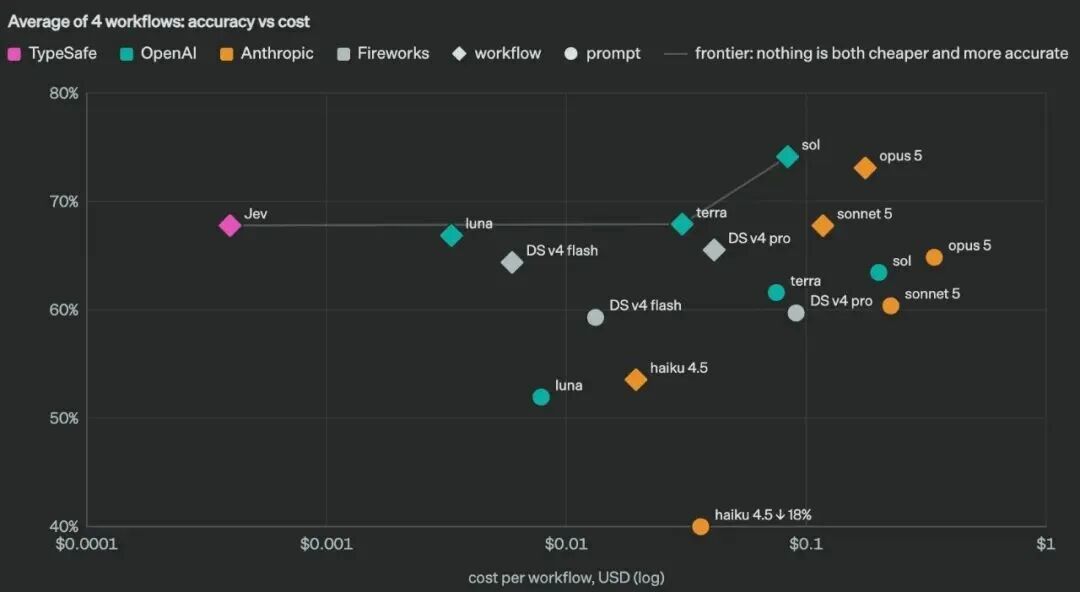
Uma das afirmações mais fortes da TypeSafe é que o Jev não produz erros de tipo.
Isso exige uma interpretação precisa.
Significa que, se a aplicação declarar um esquema de saída limitado, o Jev retornará um valor em conformidade com esse contrato de saída.
Por exemplo:
Resposta permitida:
- aprovar
- revisar
- rejeitar
O Jev não deveria retornar de repente:
Aqui está um ensaio de cinco parágrafos sobre meu raciocínio...
Essa é uma propriedade importante de confiabilidade para software de produção.
Mas a segurança de tipos não significa que a decisão semântica estará sempre correta.
Um modelo pode retornar um valor válido de rejeitar e ainda assim tomar a decisão de negócio errada.
Por isso, o Jev também retorna probabilidades e informações de confiança, permitindo que a aplicação defina limites como:
confiança >= 0,95
→ automatizar

0,70 <= confiança < 0,95
→ verificação secundária

confiança < 0,70
→ análise humana
A utilidade do modelo depende, portanto, tanto da qualidade da classificação quanto da calibração.
O sinal mais forte de adoção independente no artigo original vem da Vercel.
A Vercel adicionou o Jev ao AI Gateway pouco depois do lançamento e acompanhou a velocidade com que as equipes pagantes começaram a usá-lo.
Segundo a Vercel, o Jev alcançou quase 13% das equipes pagantes em 24 horas.
Naquele momento, isso representava mais do que o dobro do alcance de qualquer lançamento anterior de modelo na história do AI Gateway.
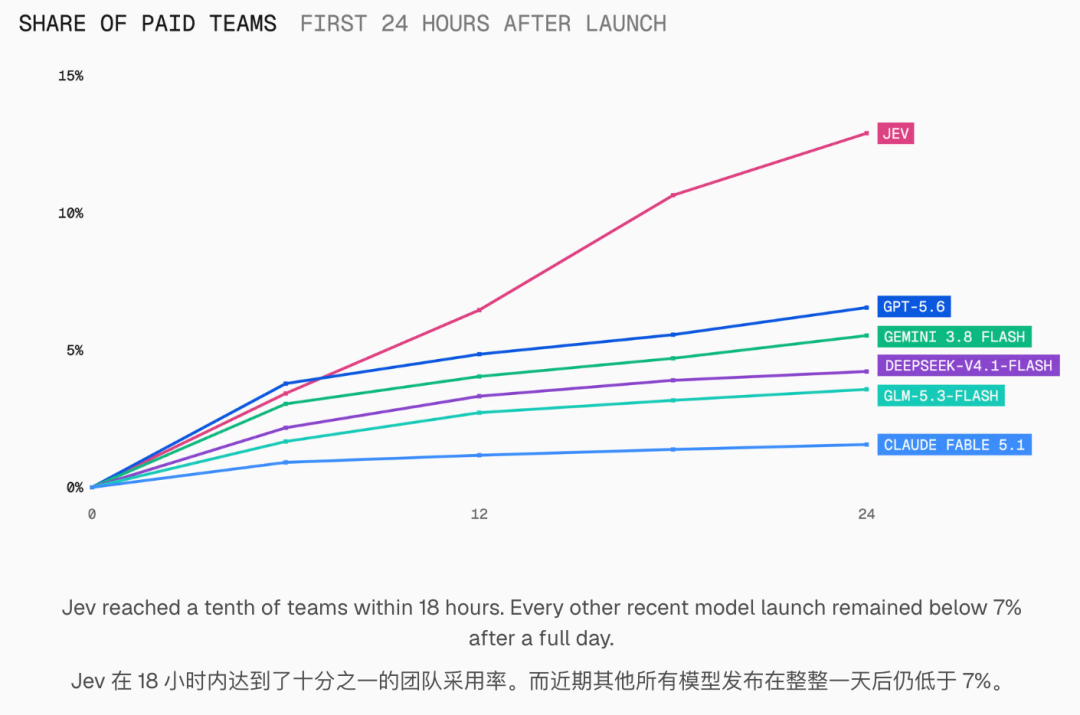
A Vercel também observou que o Jev superou todos os modelos de comparação nas primeiras 12 horas e continuou ampliando sua liderança no primeiro dia.
Isso importa porque o uso do Jev é diferente da adoção casual de chatbots.
Uma pessoa pode experimentar um novo chatbot algumas vezes e depois parar.
Um modelo incorporado ao software pode continuar recebendo solicitações continuamente.
Isso cria um padrão de uso muito diferente:
Chatbot usado por uma pessoa:
usuário abre o aplicativo
→ envia uma mensagem
→ espera
→ fecha o aplicativo

Modelo de decisão no software:
solicitação chega
→ modelo de decisão é executado
→ a aplicação segue um ramo
→ repete-se durante todo o dia
O artigo-fonte resume isso com uma observação simples:
As pessoas dormem. O código, não.
O artigo original também cita a TypeSafe e investidores afirmando que o Jev alcançou aproximadamente um trilhão de tokens processados nos três primeiros dias após o lançamento.
Posteriormente, a TypeSafe descreveu o tráfego como sustentado, e não como um pico isolado.
A publicação da Série A da empresa afirma agora que aproximadamente um terço das empresas da Fortune 500 está usando ou integrando o Jev e declara que os clientes já economizaram milhões de dólares em custos de produção.
Essas são métricas de negócio da própria TypeSafe, e não números auditados de forma independente, mas ajudam a explicar por que os investidores trataram o Jev como algo maior do que uma demonstração viral para desenvolvedores.
O padrão de uso sugere uma demanda entre máquinas.
Quando o Jev é incorporado a:
ele pode ser chamado sempre que o software ao redor alcançar aquele ramo.
Esse é exatamente o tipo de carga de trabalho para o qual a TypeSafe projetou o produto.
A origem do Jev é excepcionalmente simétrica.
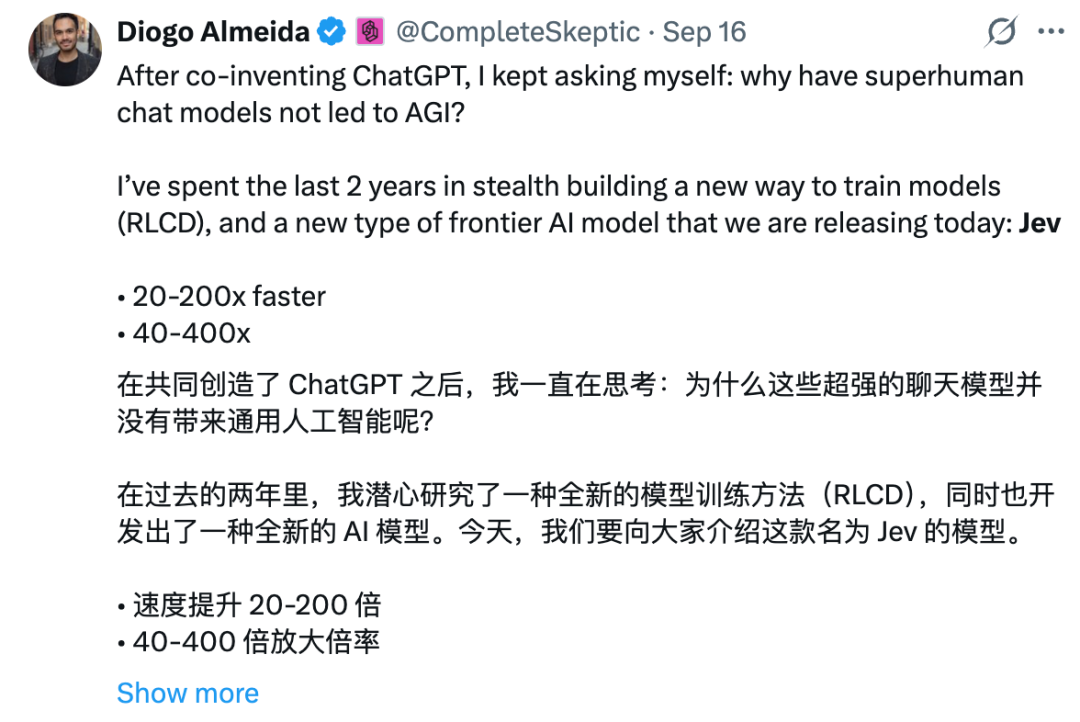
O cofundador e CEO da TypeSafe, Diogo Almeida, trabalhou anteriormente no Google Brain e na OpenAI.
A própria página da equipe da TypeSafe o descreve como coinventor do RLHF e do InstructGPT, trabalhos que ajudaram a levar ao ChatGPT e ao GPT-4.
Na OpenAI, Almeida trabalhou nos métodos que ajudaram a transformar modelos de linguagem brutos em sistemas capazes de seguir instruções e interagir naturalmente com as pessoas.
Depois de deixar a OpenAI, ele se tornou cada vez mais cético em relação à ideia de que o chat deveria ser a interface padrão para a inteligência dentro do software.
Ele resumiu essa mudança na publicação de lançamento do Jev pela TypeSafe: se os modelos haviam se tornado extremamente capazes de conversar, por que a automação não havia avançado no mesmo ritmo?
Um chatbot é otimizado para a flexibilidade.
Essa flexibilidade é valiosa quando uma pessoa está lendo a saída.
Mas o software de produção frequentemente quer o oposto:
A posição da TypeSafe é que a geração de linguagem de uso geral costuma ser uma abstração desnecessariamente poderosa para essas tarefas.
Em vez de pedir a um modelo de fronteira que escreva uma resposta estruturada e depois validar o texto, o Jev foi projetado para tomar diretamente a decisão limitada.
O slogan da empresa resume essa filosofia:
Crie para produção, não um deus.
A formulação é deliberadamente provocativa, mas a ideia subjacente é prática: otimizar para software que funcione de forma confiável em produção, em vez de tratar cada produto de IA como um passo em direção a um modelo universal.
A TypeSafe chama seu método de treinamento de Reinforcement Learning for Calibrated Decisions (RLCD).
A empresa o contrasta com duas abordagens conhecidas:
| Direção do treinamento | Principal objetivo de otimização |
|---|---|
| RLHF | Respostas preferidas por humanos |
| RLVR | Resultados de raciocínio verificáveis |
| RLCD | Decisões estruturadas calibradas |
No caso do Jev, a calibração é central.
Se um modelo diz 0,90, o objetivo é que os eventos que recebem aproximadamente esse nível de confiança estejam realmente corretos em torno de 90% das vezes em uma distribuição de avaliação adequada.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Isso é muito mais útil para projetar fluxos automatizados do que um rótulo não calibrado isoladamente.
A aplicação pode então transformar a incerteza do modelo em uma política:
confiança alta
→ automatizar

confiança média
→ consultar outro modelo ou aplicar mais regras

confiança baixa
→ encaminhar para uma pessoa
Essa é uma das razões pelas quais os modelos de decisão são atraentes para sistemas de alto volume.
Eles não eliminam a incerteza.
Eles tornam a incerteza mais fácil de ser consumida pelo software.
O artigo original também destaca o ceticismo de Almeida em relação à competição baseada em benchmarks públicos.
A TypeSafe publica avaliações, mas seu material de lançamento dedica um esforço incomum à documentação das ressalvas.
Por exemplo, a empresa observa explicitamente que:
Essa é uma distinção útil.
A TypeSafe ainda promove seu modelo de forma agressiva, mas não afirma que o Jev deve substituir os LLMs de fronteira em todos os contextos.
A própria documentação da empresa posiciona os produtos de forma diferente:
LLM generativo
→ escrever, raciocinar, explicar, programar, conversar

Modelo de decisão
→ classificar, rotear, pontuar, verificar, controlar, priorizar
Os dois podem trabalhar juntos no mesmo sistema.
A liderança da TypeSafe vai além de Almeida.
A página oficial da equipe lista:
A equipe mais ampla inclui pessoas de empresas como OpenAI, Google Brain, Meta/FAIR, Stripe, Airbnb, Plaid e Docker.
Esse histórico ajuda a explicar a ênfase do produto.
O Jev tem menos relação com a criação de uma nova interface para consumidores e mais com a criação de algo que os desenvolvedores possam incorporar profundamente à infraestrutura.
A rápida adoção do Jev também produziu um segundo efeito.
Ela validou a categoria com rapidez suficiente para que grandes empresas de infraestrutura e de modelos começassem a lançar produtos concorrentes em poucas semanas.
O artigo original termina exatamente com essa mudança.
A Microsoft anunciou o Microsoft-Decision-1, um modelo criado especificamente para pontuação de decisões estruturadas.
O modelo é baseado no Qwen3.5-9B e está disponível no Microsoft Foundry em prévia pública.
Ele oferece suporte a tarefas como:
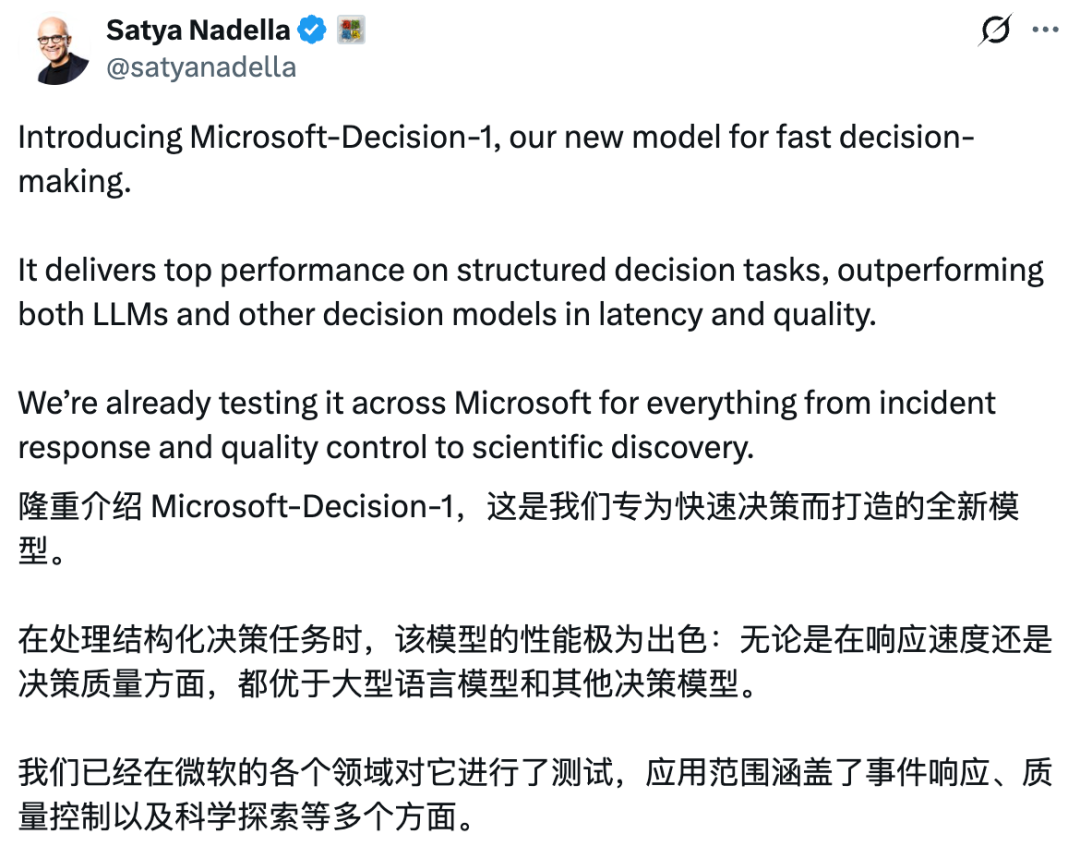
Quando recebe um conjunto fixo de opções, o Microsoft-Decision-1 retorna pontuações de probabilidade calibradas para essas opções.
A Microsoft informa que o modelo alcançou a maior precisão em sua comparação com 36 benchmarks, abrangendo quase 150 mil perguntas, e afirma que ele foi substancialmente mais rápido que o GPT-6 Sol em sua avaliação interna.
Esses números são resultados de benchmarks da própria Microsoft, portanto os desenvolvedores devem validar o modelo com suas próprias cargas de trabalho antes de tratá-los como classificações universais de desempenho.
A OpenAI avançou na mesma direção com sua API de Decisions, lançada em beta público em 6 de outubro de 2026.
A API é baseada no GPT-6 Luna e aceita texto, imagens ou ambos.
Ela oferece suporte a três tipos de perguntas estruturadas:
| Tipo | Resultado |
|---|---|
| Predicado | Probabilidade de uma condição ser verdadeira |
| Escolha | Uma seleção entre as opções fornecidas, acompanhada de probabilidades |
| Pontuação | Pontuação ponderada por probabilidade em níveis ordenados |
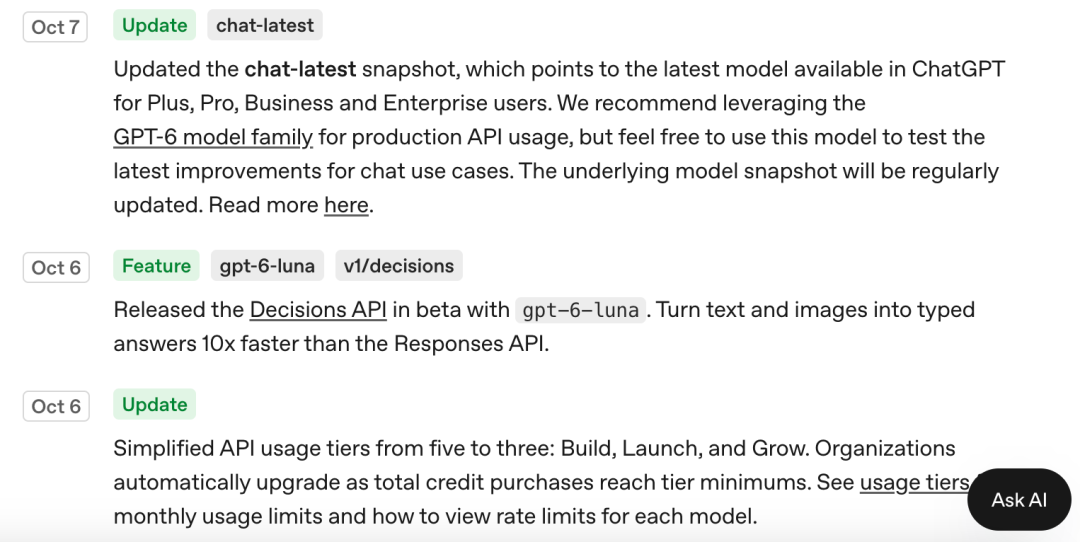
A OpenAI afirma que a API dedicada pode retornar decisões aproximadamente 10 vezes mais rápido do que o uso do GPT-6 Luna por meio da Responses API para o formato de tarefa relevante.
O preço do beta é excepcionalmente simples:
Entrada: US$ 0,10 / 1 milhão de tokens
Saída: sem cobrança por tokens de saída
Leitura de cache: sem cobrança
Gravação de cache: sem cobrança
A principal diferença em relação ao Jev é arquitetural.
O Jev é a família de modelos System One criada especificamente pela TypeSafe.
A API de Decisions da OpenAI, por outro lado, expõe uma interface especializada de decisão em torno do GPT-6 Luna.
Do ponto de vista do desenvolvedor de aplicações, no entanto, ambas atendem a uma necessidade semelhante:
entrada de estado
→ saída de decisão tipada e limitada
A Cloudflare entrou ainda mais cedo, anunciando o Clef e o Clef-flash em 1º de outubro.
Ambos são modelos de decisão disponíveis no Workers AI, e a Cloudflare também tornou seus pesos abertos sob a licença Apache 2.0.
Eles seguem um formato de API compatível com o Jev, facilitando sua substituição em fluxos de trabalho criados em torno de solicitações de decisão no estilo System One.
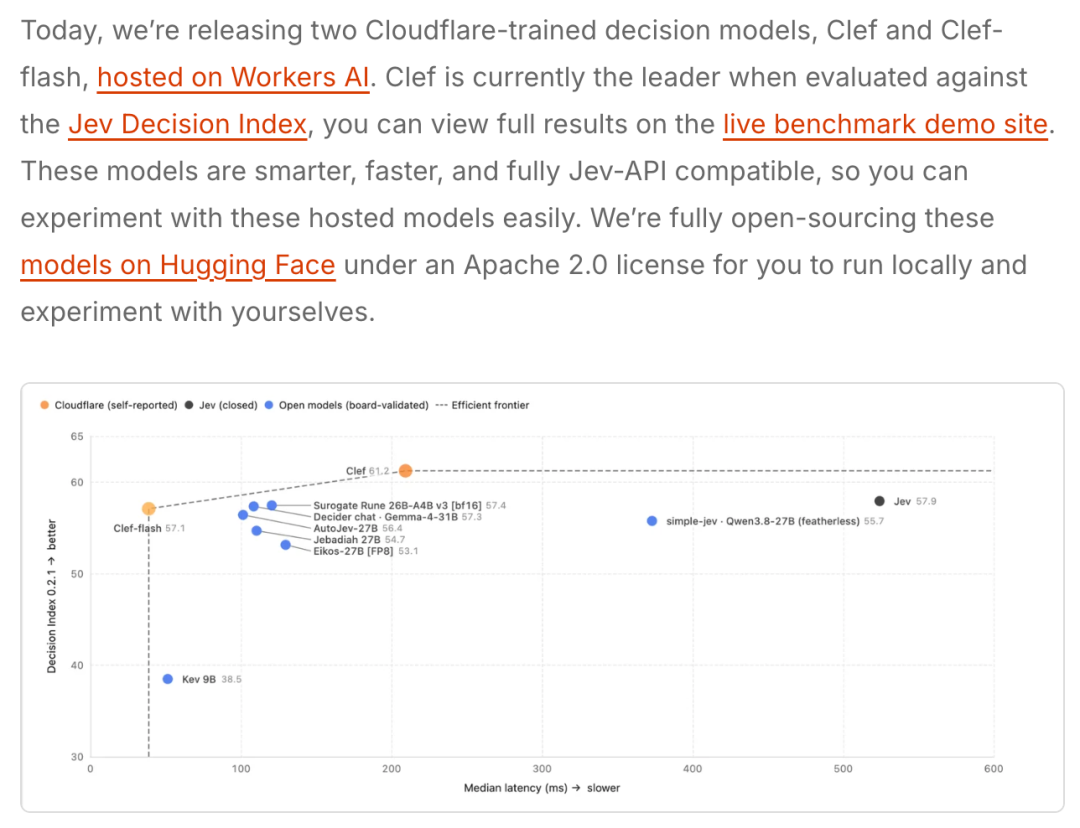
A Cloudflare informa:
| Modelo | Tamanho | Contexto | Foco pretendido |
|---|---|---|---|
| Clef | 27B | 64K | Maior qualidade de decisão |
| Clef-flash | 9B | 64K | Latência muito baixa |
Na própria suíte de testes da Cloudflare, o Clef ou o Clef-flash liderou 7 dos 10 benchmarks de decisão destacados, enquanto o Jev continuou mais forte em algumas tarefas individuais, como When2Call e BRIGHT.
A Cloudflare também informou as seguintes latências medianas:
Clef:       209,3 ms
Clef-flash: 38,8 ms
Jev:        524,1 ms
Novamente, esses números vêm do ambiente de avaliação da Cloudflare.
Eles são evidências competitivas úteis, mas não constituem uma garantia universal de latência para toda implantação.
O ponto central do artigo-fonte não é apenas que o Jev captou uma rodada enorme.
É que uma categoria de modelos passou de incomum a concorrida quase imediatamente.
Em poucas semanas, o mercado passou a contar com:
Cada implementação é diferente, mas todas compartilham uma percepção comum:
Nem toda solicitação de IA precisa de texto generativo.
Muitas tarefas de produção se parecem mais com instruções if inteligentes.
Por exemplo:
se probabilidade_de_fraude > 0,98:
    bloquear()
elif probabilidade_de_fraude > 0,70:
    revisar()
caso_contrário:
    permitir()
A parte difícil não é escrever o ramo.
É produzir uma probabilidade útil e calibrada a partir de um contexto real desorganizado.
Os modelos de decisão tentam tornar essa capacidade barata o suficiente para funcionar em qualquer lugar.
À primeira vista, modelos de decisão especializados parecem uma ameaça aos LLMs de uso geral.
Na prática, eles podem aumentar o consumo total de IA.
Um agente de uso geral pode usar um modelo de decisão em pontos de controle de alta frequência:
Solicitação do usuário
→ o modelo de decisão escolhe a rota
→ o LLM cuida do raciocínio complexo somente quando necessário
→ o modelo de decisão avalia a saída
→ o fluxo de trabalho continua ou é escalado
Isso permite que os desenvolvedores reservem o raciocínio caro para as partes que realmente precisam dele.
Todo o restante pode ser tratado por modelos limitados mais baratos.
O resultado pode ser um número maior de chamadas de IA, e não menor.
Essa ideia é consistente com o nome Jev, que, segundo a TypeSafe, faz referência ao economista William Stanley Jevons e ao paradoxo de Jevons: melhorar a eficiência pode aumentar o consumo total porque o custo menor libera novos casos de uso.
Na infraestrutura de IA, a mesma lógica poderia ser:
decisões mais baratas
→ mais decisões se tornam economicamente viáveis
→ mais softwares ganham pontos de controle de IA
→ o uso total de inteligência de máquina aumenta
O Jev é o primeiro modelo System One da TypeSafe AI, projetado para decisões rápidas e estruturadas, em vez de geração de texto livre. Ele recebe o estado da aplicação e perguntas tipadas e retorna respostas limitadas com probabilidades e informações de confiança.
Atualmente, a TypeSafe lista o Jev a US$ 0,042 por milhão de tokens de entrada e não contabiliza tokens de saída. Esse preço se aplica à interface de decisão estruturada do Jev, e não a um modelo de geração de texto de uso geral.
A afirmação formal mais forte da TypeSafe diz respeito à segurança do tipo de saída: um esquema limitado impede que o modelo emita uma saída arbitrária e malformada. Isso não significa que toda decisão semântica esteja correta, razão pela qual calibração, limites, avaliação e análise humana continuam sendo importantes.
A Vercel afirma que quase 13% das equipes pagantes usaram o Jev nas primeiras 24 horas após o lançamento no AI Gateway. A Vercel o descreveu como o modelo adotado mais rapidamente na história do AI Gateway até aquele momento.
A API de Decisions é um endpoint da OpenAI em beta público, baseado no GPT-6 Luna. Ela aceita evidências em texto e imagem e retorna probabilidades de predicados, escolhas ou pontuações, com a OpenAI afirmando uma latência aproximadamente 10 vezes menor que o uso do GPT-6 Luna por meio da Responses API para essas tarefas de decisão.
O Microsoft-Decision-1 é um modelo de decisão estruturada disponível em prévia pública no Microsoft Foundry. Ele é baseado no Qwen3.5-9B e foi projetado para classificação, roteamento, ranking, avaliação, verificação e controle de fluxos de trabalho.
A Cloudflare descreve o Clef e o Clef-flash como modelos de decisão de código aberto ou com pesos abertos e os disponibilizou sob a licença Apache 2.0. Eles também são hospedados pelo Workers AI e usam um estilo de API System One compatível com o Jev.
Em geral, não. Os modelos de decisão são mais adequados para decisões limitadas e de alto volume, enquanto os LLMs de uso geral continuam sendo melhores para geração, explicação, raciocínio complexo e uso aberto de ferramentas. Muitos sistemas de produção usarão os dois.
A rodada Série A de US$ 870 milhões da TypeSafe AI importa porque valida mais do que uma única startup. Ela valida uma categoria de modelos: sistemas de decisão rápidos, limitados e legíveis por máquinas, projetados para operar profundamente dentro de softwares de produção.
A rápida adoção do Jev na Vercel, seu baixo preço de entrada, suas saídas estruturadas e seu design focado em calibração mostram por que os desenvolvedores estão interessados. Mas suas afirmações de desempenho mais fortes ainda precisam ser interpretadas em contexto: algumas vêm diretamente da TypeSafe, enquanto Vercel, Cloudflare, Microsoft e OpenAI publicam suas próprias medições sob condições diferentes.
O sinal mais importante do mercado é a velocidade com que os concorrentes apareceram. Em questão de semanas, Microsoft, OpenAI e Cloudflare já tinham produtos voltados ao mesmo problema básico.
A maior conquista do Jev talvez não seja um benchmark ou uma rodada de financiamento — pode ser provar que uma grande parte da IA de produção não precisa falar absolutamente nada.
Comece com uma frase e tenha um site completo em minutos.



