
O lançamento do M3.1 Flash pela MiniMax em 19 de outubro também revelou a identidade do Space Bunny, um modelo anônimo anteriormente disponível por meio de plataformas para desenvolvedores. Vários provedores introduziram acesso gratuito temporário, enquanto a MiniMax anunciou tarifas pagas normais por token e informou que os pesos do modelo seriam disponibilizados posteriormente.
Essas ofertas têm prazos e condições diferentes. A inferência hospedada gratuita não equivale ao lançamento de pesos para uso local, e um comando que contenha :cloud envia o trabalho para um modelo hospedado pelo provedor.
Acesso ao lançamento: prazos, preços e hospedagem na nuvem
O relato fornecido cita um anúncio do OpenRouter às 12:01 UTC de 19 de outubro e um anúncio do OpenCode 16 minutos depois. Ambos descrevem um período de lançamento gratuito de aproximadamente três dias.
A página do modelo no OpenRouter apresenta um prazo mais preciso do que uma estimativa baseada no horário da publicação nas redes sociais: 22 de outubro às 12:00 UTC, ou 20:00 em Xangai. O banner informa que a variante :free será retirada após a promoção e orienta os usuários a utilizar o identificador básico do modelo para evitar interrupções.
| Rota | Informações sobre o período gratuito | Horário de Xangai | Limite de verificação |
|---|---|---|---|
| OpenRouter | 22 de outubro de 2026, 12:00 UTC. | 22 de outubro, 20:00. | Prazo explícito na página do modelo consultada. |
| OpenCode | Três dias a partir do anúncio de 19 de outubro. | Aproximadamente 22 de outubro, 20:17, se calculado a partir do horário da publicação. | Estimativa derivada da fonte, não um prazo de serviço verificado. |
| Ollama Cloud | 22 de outubro de 2026, 23:59 UTC. | 23 de outubro, 07:59. | Prazo explícito na página do modelo consultada. |
O OpenRouter lista o identificador do período de lançamento como minimax/minimax-m3.1-flash:free e a rota paga posterior como minimax/minimax-m3.1-flash. O acesso gratuito continua sujeito às restrições da plataforma; não deve ser descrito como ilimitado ou permanente.
O anúncio oficial da MiniMax apresenta os seguintes preços por milhão de tokens, também refletidos no aviso pós-promoção do OpenRouter:
| Categoria de token | Preço listado em USD por milhão de tokens |
|---|---|
| Entrada | US$ 0,15. |
| Saída | US$ 0,60. |
| Entrada em cache | US$ 0,015. |
Comandos e contexto do Ollama Cloud
A página do modelo no Ollama verifica este comando:
ollama run minimax-m3.1-flash:cloud
Ele exige uma configuração adequada do Ollama e acesso ao serviço de nuvem. Trata-se de uma chamada hospedada; o comando não demonstra que os pesos do modelo foram baixados para inferência offline.
A mesma página fornece atualmente estes exemplos de inicialização de aplicações:
ollama launch claude --model minimax-m3.1-flash:cloud
ollama launch opencode --model minimax-m3.1-flash:cloud
A fonte fornecida também menciona a integração com o Codex em uma publicação social do Ollama, mas a página do modelo consultada não apresenta um comando de inicialização correspondente para o Codex. Nenhum comando é inventado aqui.
O Ollama lista 428 bilhões de parâmetros e um contexto de 976 mil tokens para sua entrada hospedada, com entradas de texto e imagem. A documentação própria da MiniMax descreve o contexto nativo do modelo como de um milhão de tokens. Esses são valores publicados específicos de cada provedor, e os materiais consultados não explicam a diferença; use o limite do endpoint que estiver sendo chamado.
A fonte atribui à publicação do Ollama as alegações de hospedagem nos Estados Unidos e retenção zero de dados. A página do modelo, por si só, não estabelece o escopo contratual completo dessas alegações; portanto, não se deve presumir que a retenção seja idêntica no Ollama, no OpenRouter e em outras rotas.
O relato fornecido também cita acesso de lançamento pelo Cline, GMI Cloud e CommandCode, com diferentes condições promocionais ou de assinatura. Esses avisos não estabelecem que todas as rotas compartilhem a mesma cota, os mesmos termos de privacidade ou o mesmo horário de encerramento.
Registros de uso do Space Bunny em duas plataformas
A AREX cita o OpenRouter como tendo reportado 56,7 trilhões de tokens e 10 dias consecutivos no topo de seu ranking de uso. Também cita o OpenCode como tendo reportado 106 trilhões de tokens e 12 dias no topo de seu próprio ranking.
A soma aritmética é de 162,7 trilhões, mas isso não representa uma contagem verificada de tráfego distinto. As definições das plataformas podem ser diferentes, e o tráfego pode se sobrepor quando uma aplicação chama um modelo por meio de outro provedor. Nenhum conjunto de dados deduplicado foi fornecido.
O anúncio oficial da MiniMax afirma separadamente que o Space Bunny processou mais de 200 trilhões de tokens durante seu período anônimo. Esse número mais amplo não precisa coincidir com a soma de dois anúncios de plataformas. Trata-se de uma alegação de uso da empresa, não de uma contagem de pessoas únicas nem de uma prova da qualidade do modelo.
A fonte também cita mudanças no serviço do OpenRouter durante os testes anônimos:
| Métrica de serviço reportada | Valor anterior | Valor posterior |
|---|---|---|
| Tempo até o primeiro token | 1,95 segundo. | 1,22 segundo. |
| Vazão de saída | 70 tokens por segundo. | 100 tokens por segundo. |
| Taxa de erro | 1,4%. | 0,7%. |
Essas são métricas históricas do provedor citadas pela fonte. Elas não devem ser usadas como substitutas de garantias atuais de desempenho ou das alegações de velocidade apresentadas separadamente pela MiniMax. A MiniMax chama o Space Bunny de uma versão inicial; portanto, não se deve presumir um comportamento idêntico em todas as sessões anônimas e na versão final.
Os pesos estavam planejados para depois do período gratuito
O blog oficial da MiniMax informa que os pesos serão disponibilizados posteriormente. A fonte cita o OpenRouter descrevendo um lançamento mais tarde naquela semana e a VentureBeat indicando a data de 23 de outubro.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Essas são previsões e reportagens, não um artefato de pesos verificadamente disponível para download. As evidências disponíveis não estabelecem uma licença final, uma configuração local compatível ou a memória necessária para uma quantização específica.
Se 23 de outubro for a data de lançamento, os períodos gratuitos informados pelo OpenRouter e pelo OpenCode terminam antes; o prazo em UTC do Ollama também antecede essa data. Essa observação de timing não estabelece quão rapidamente uma implantação funcional auto-hospedada estaria disponível após o lançamento.
Para garantir continuidade, a distinção prática está entre migrar para uma rota hospedada paga elegível e avaliar um lançamento posterior dos pesos. Permanecer em um identificador programado para ser retirado pode interromper um fluxo de trabalho, mesmo que exista um modelo básico pago.
Pontuações independentes e o significado de “93% de alucinação”
A fonte cita um snapshot da Artificial Analysis durante o período de lançamento com um Índice de Inteligência de aproximadamente 42, acima dos 29 do M3, e custos médios de tarefas do índice próximos de US$ 0,22, contra US$ 0,51. A página do OpenRouter consultada agora reproduz um valor mais preciso da AA, de 42,7, além de HLE em 48,0% e CritPt em 22,3%.
Essas são medições de avaliação. A média de US$ 0,22 não é uma tarifa por token nem uma promessa de que tarefas arbitrárias custarão esse valor.
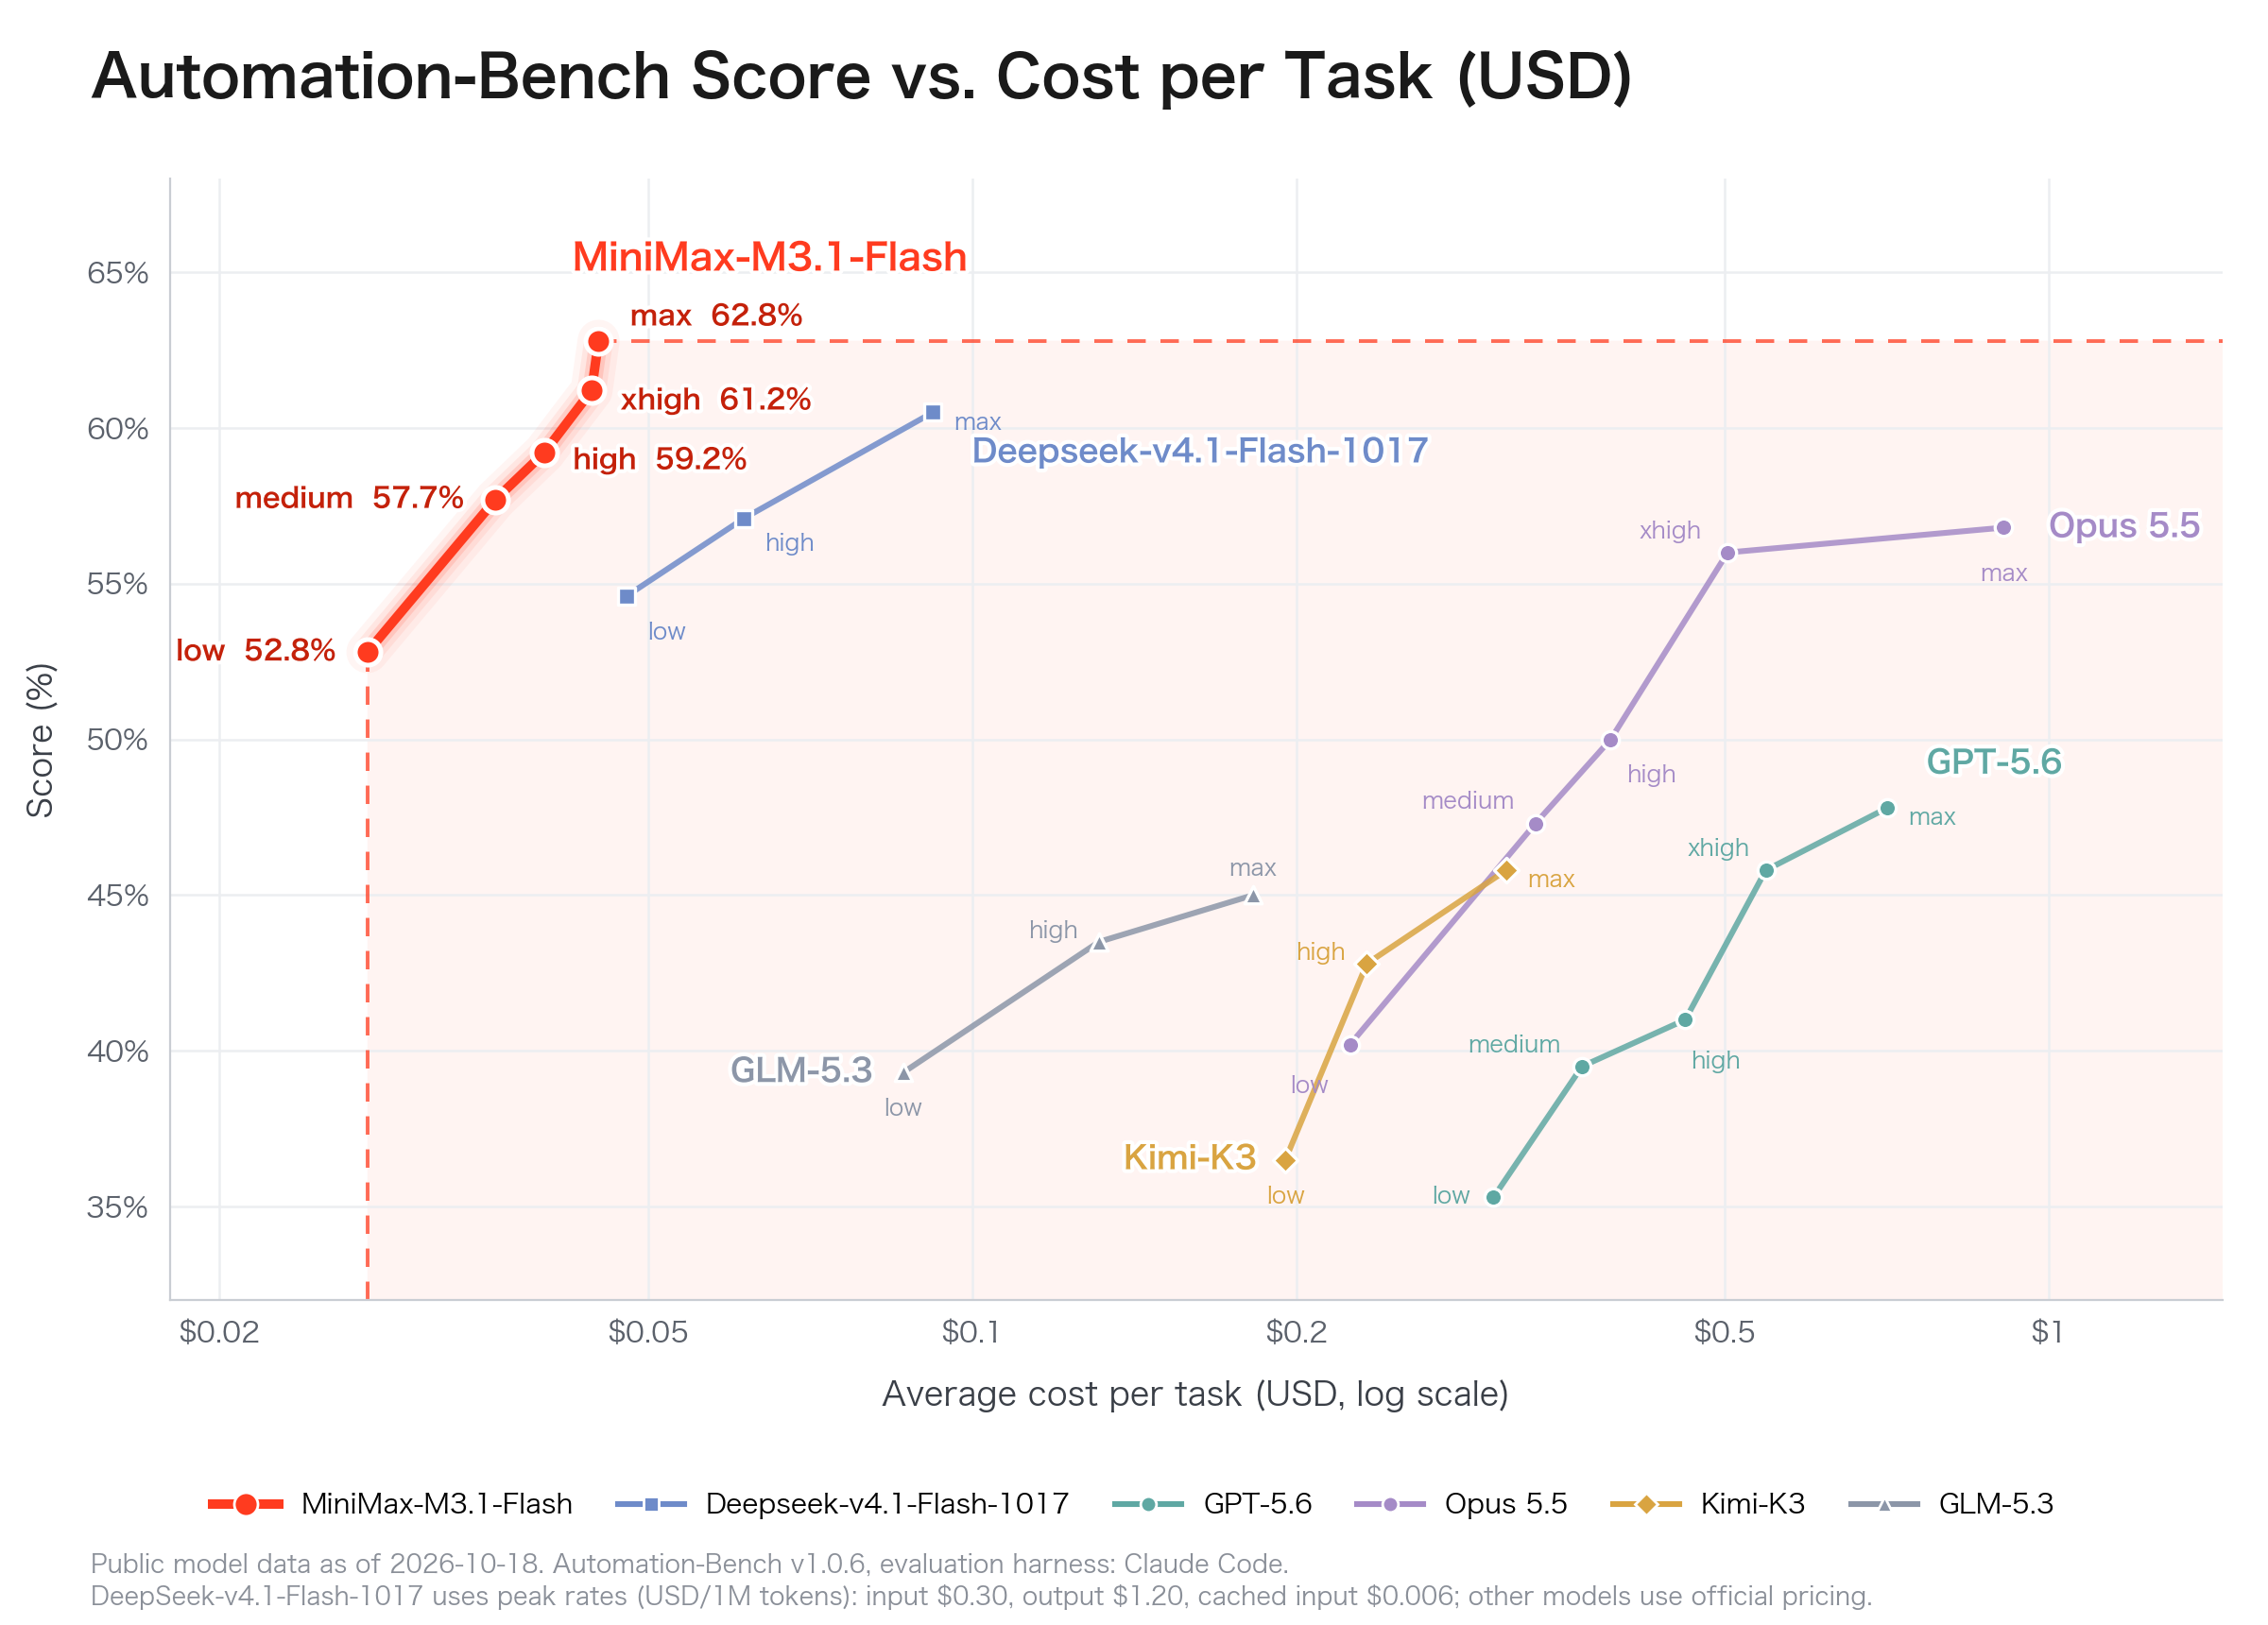
Comparação do Automation-Bench reportada pela empresa; seu cálculo de custo por tarefa difere da média do Índice de Inteligência da Artificial Analysis.
A cifra de “93% de alucinação” do artigo precisa de um denominador. A Artificial Analysis define a métrica usando respostas incorretas divididas por todas as respostas não corretas, incluindo respostas parciais e não tentativas. Não é a fração de todas as respostas que está errada.
Os dados da AA reproduzidos pelo OpenRouter listam 56,2% de precisão e uma taxa de não alucinação de 7,2%, consistentes com uma taxa de alucinação de aproximadamente 92,8% sob essa medida condicional. O índice Omniscience reportado, próximo de 16, é uma métrica diferente, que penaliza respostas erradas e atribui crédito às corretas.
Por fim, reduzir US$ 0,51 para US$ 0,22 representa aproximadamente uma queda de 57% sob essa estimativa de custo de tarefas do índice. A alegação de redução de 70% da MiniMax se refere à sua própria comparação de uso em tarefas de agentes. Diferentes cargas de trabalho e métodos contábeis significam que os percentuais não devem ser tratados como medições concorrentes da mesma coisa.
Perguntas frequentes
Quando termina o período de lançamento gratuito do OpenRouter?
A página do modelo consultada informa 22 de outubro de 2026, às 12:00 UTC. Isso corresponde às 20:00 em Xangai e é mais preciso do que uma estimativa baseada no horário do anúncio.
O comando do Ollama executa o M3.1 Flash offline?
O comando documentado seleciona a variante :cloud. Ele utiliza inferência hospedada e não comprova que os pesos locais estejam disponíveis.
Por que o Ollama mostra 976 mil em vez de um milhão de tokens?
Esses são valores publicados diferentes para a entrada hospedada e para a especificação nativa do modelo. Os materiais consultados não explicam a diferença; portanto, use o limite documentado para o endpoint selecionado.
As contagens de tokens do OpenRouter e do OpenCode podem ser somadas?
A soma numérica é direta, mas não é possível estabelecer o uso único com base nesses anúncios. Diferenças nas definições e sobreposições de roteamento podem impedir que os totais das plataformas representem solicitações distintas.
A taxa de alucinação reportada de 93% significa que 93% de todas as respostas estão erradas?
Não. A AA usa uma taxa condicional entre as respostas não corretas. O denominador difere da precisão geral, que é reportada separadamente.
O lançamento dos pesos em 23 de outubro já foi concluído?
O relato fornecido o descreve como uma data futura reportada. O anúncio consultado da MiniMax informa que os pesos serão disponibilizados posteriormente; portanto, não se deve presumir que o lançamento tenha sido concluído nem que seus termos de implantação já estejam definidos.
Ferramentas relacionadas
- M3.1 Flash no OpenRouter: A página do modelo hospedado com o aviso do período de lançamento e os identificadores do modelo.
- M3.1 Flash no Ollama: A entrada na nuvem com os comandos documentados de execução e inicialização de aplicações.
- OpenCode: O projeto de agente de programação citado no relatório de uso durante o período anônimo.
- Plataforma de API da MiniMax: O ponto de entrada da API hospedada do desenvolvedor do modelo.
Links relacionados
- Artigo da AREX fornecido no BAAI Hub: A fonte da compilação sobre o acesso ao lançamento e das referências às redes sociais.
- Anúncio oficial de lançamento da MiniMax: Preços da empresa, identificação do Space Bunny e informações sobre o lançamento dos pesos.
- Página do modelo no OpenRouter: O prazo de promoção verificado e o aviso sobre o modelo após a promoção.
- Página do modelo no Ollama: O comando de nuvem, as especificações do modelo hospedado e o horário de encerramento do período gratuito.
- Rankings do OpenRouter: Rankings de uso da plataforma, distintos de um ranking de qualidade.
- Definições de Omniscience da AA: Definições oficiais de precisão, taxa de alucinação e índice.
- Anúncio do Space Bunny listado como fonte pelo OpenRouter: A referência social citada para o uso durante o período anônimo.
Resumo
O lançamento do M3.1 Flash torna a experimentação hospedada temporariamente mais barata, mas o prazo e o identificador do modelo de cada provedor são importantes. A etiqueta de nuvem do Ollama indica uma rota hospedada, enquanto um lançamento posterior dos pesos é um evento separado que exige verificação própria.
Totais de uso, preços por token, custos de tarefas de benchmark e métricas de alucinação respondem a perguntas diferentes; manter suas definições separadas evita comparações enganosas.


