For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/matrix-game-4-0-rtx-5090-neural-rendering-59d3cc6b.md.
O Matrix-Game 4.0 da Skywork AI separa duas funções que podem ser facilmente confundidas em um jogo gerado por IA. Um motor executável manté...
O Matrix-Game 4.0 da Skywork AI separa duas funções que podem ser facilmente confundidas em um jogo gerado por IA. Um motor executável mantém as regras e o estado físico; um modelo de vídeo causal transforma as imagens low-poly do motor em frames mais detalhados.
Essa separação é a ideia central do projeto. Se um personagem coleta um escudo, recebe dano ou conclui uma missão, o motor decide o que aconteceu. O renderizador neural é responsável pela aparência, em vez de tornar os pixels gerados a autoridade final sobre a pontuação ou a vida do jogador.
A versão também inclui um caminho de inferência em uma única GPU RTX 5090. As questões importantes são o que as demonstrações medem, quais capacidades estão realmente presentes no código lançado e quão especializados permanecem os modelos disponíveis para download.
Um modelo de vídeo pode gerar movimentos convincentes sem fornecer uma representação confiável de cada regra do jogo. Um frame visualmente plausível não determina necessariamente onde está um inimigo, quem possui um item ou se uma colisão deve encerrar o jogo.
O Matrix-Game 4.0 mantém esses fatos no código. O motor processa a entrada, evolui o mundo e produz uma visão RGB low-poly comparativamente econômica. Em seguida, o modelo de vídeo gera a apresentação visual final a partir dessa entrada estruturada.
O repositório oficial chama essa abordagem de jogabilidade fundamentada no motor e renderização neural em streaming. Trata-se de um sistema híbrido, não da alegação de que o modelo aprendeu e executa de forma confiável todos os aspectos de um motor de jogo geral internamente.
Portanto, um erro visual não altera diretamente a colisão subjacente nem o estado da jogabilidade. Ainda assim, ele pode confundir o jogador; essa arquitetura separa dois modos de falha, em vez de eliminar todos os erros.
A página do projeto apresenta uma estrutura que combina um agente de programação e um motor de jogo. As instruções do usuário podem ser transformadas em novas regras ou prompts, enquanto o motor fornece o estado necessário para manter a coerência do mundo.
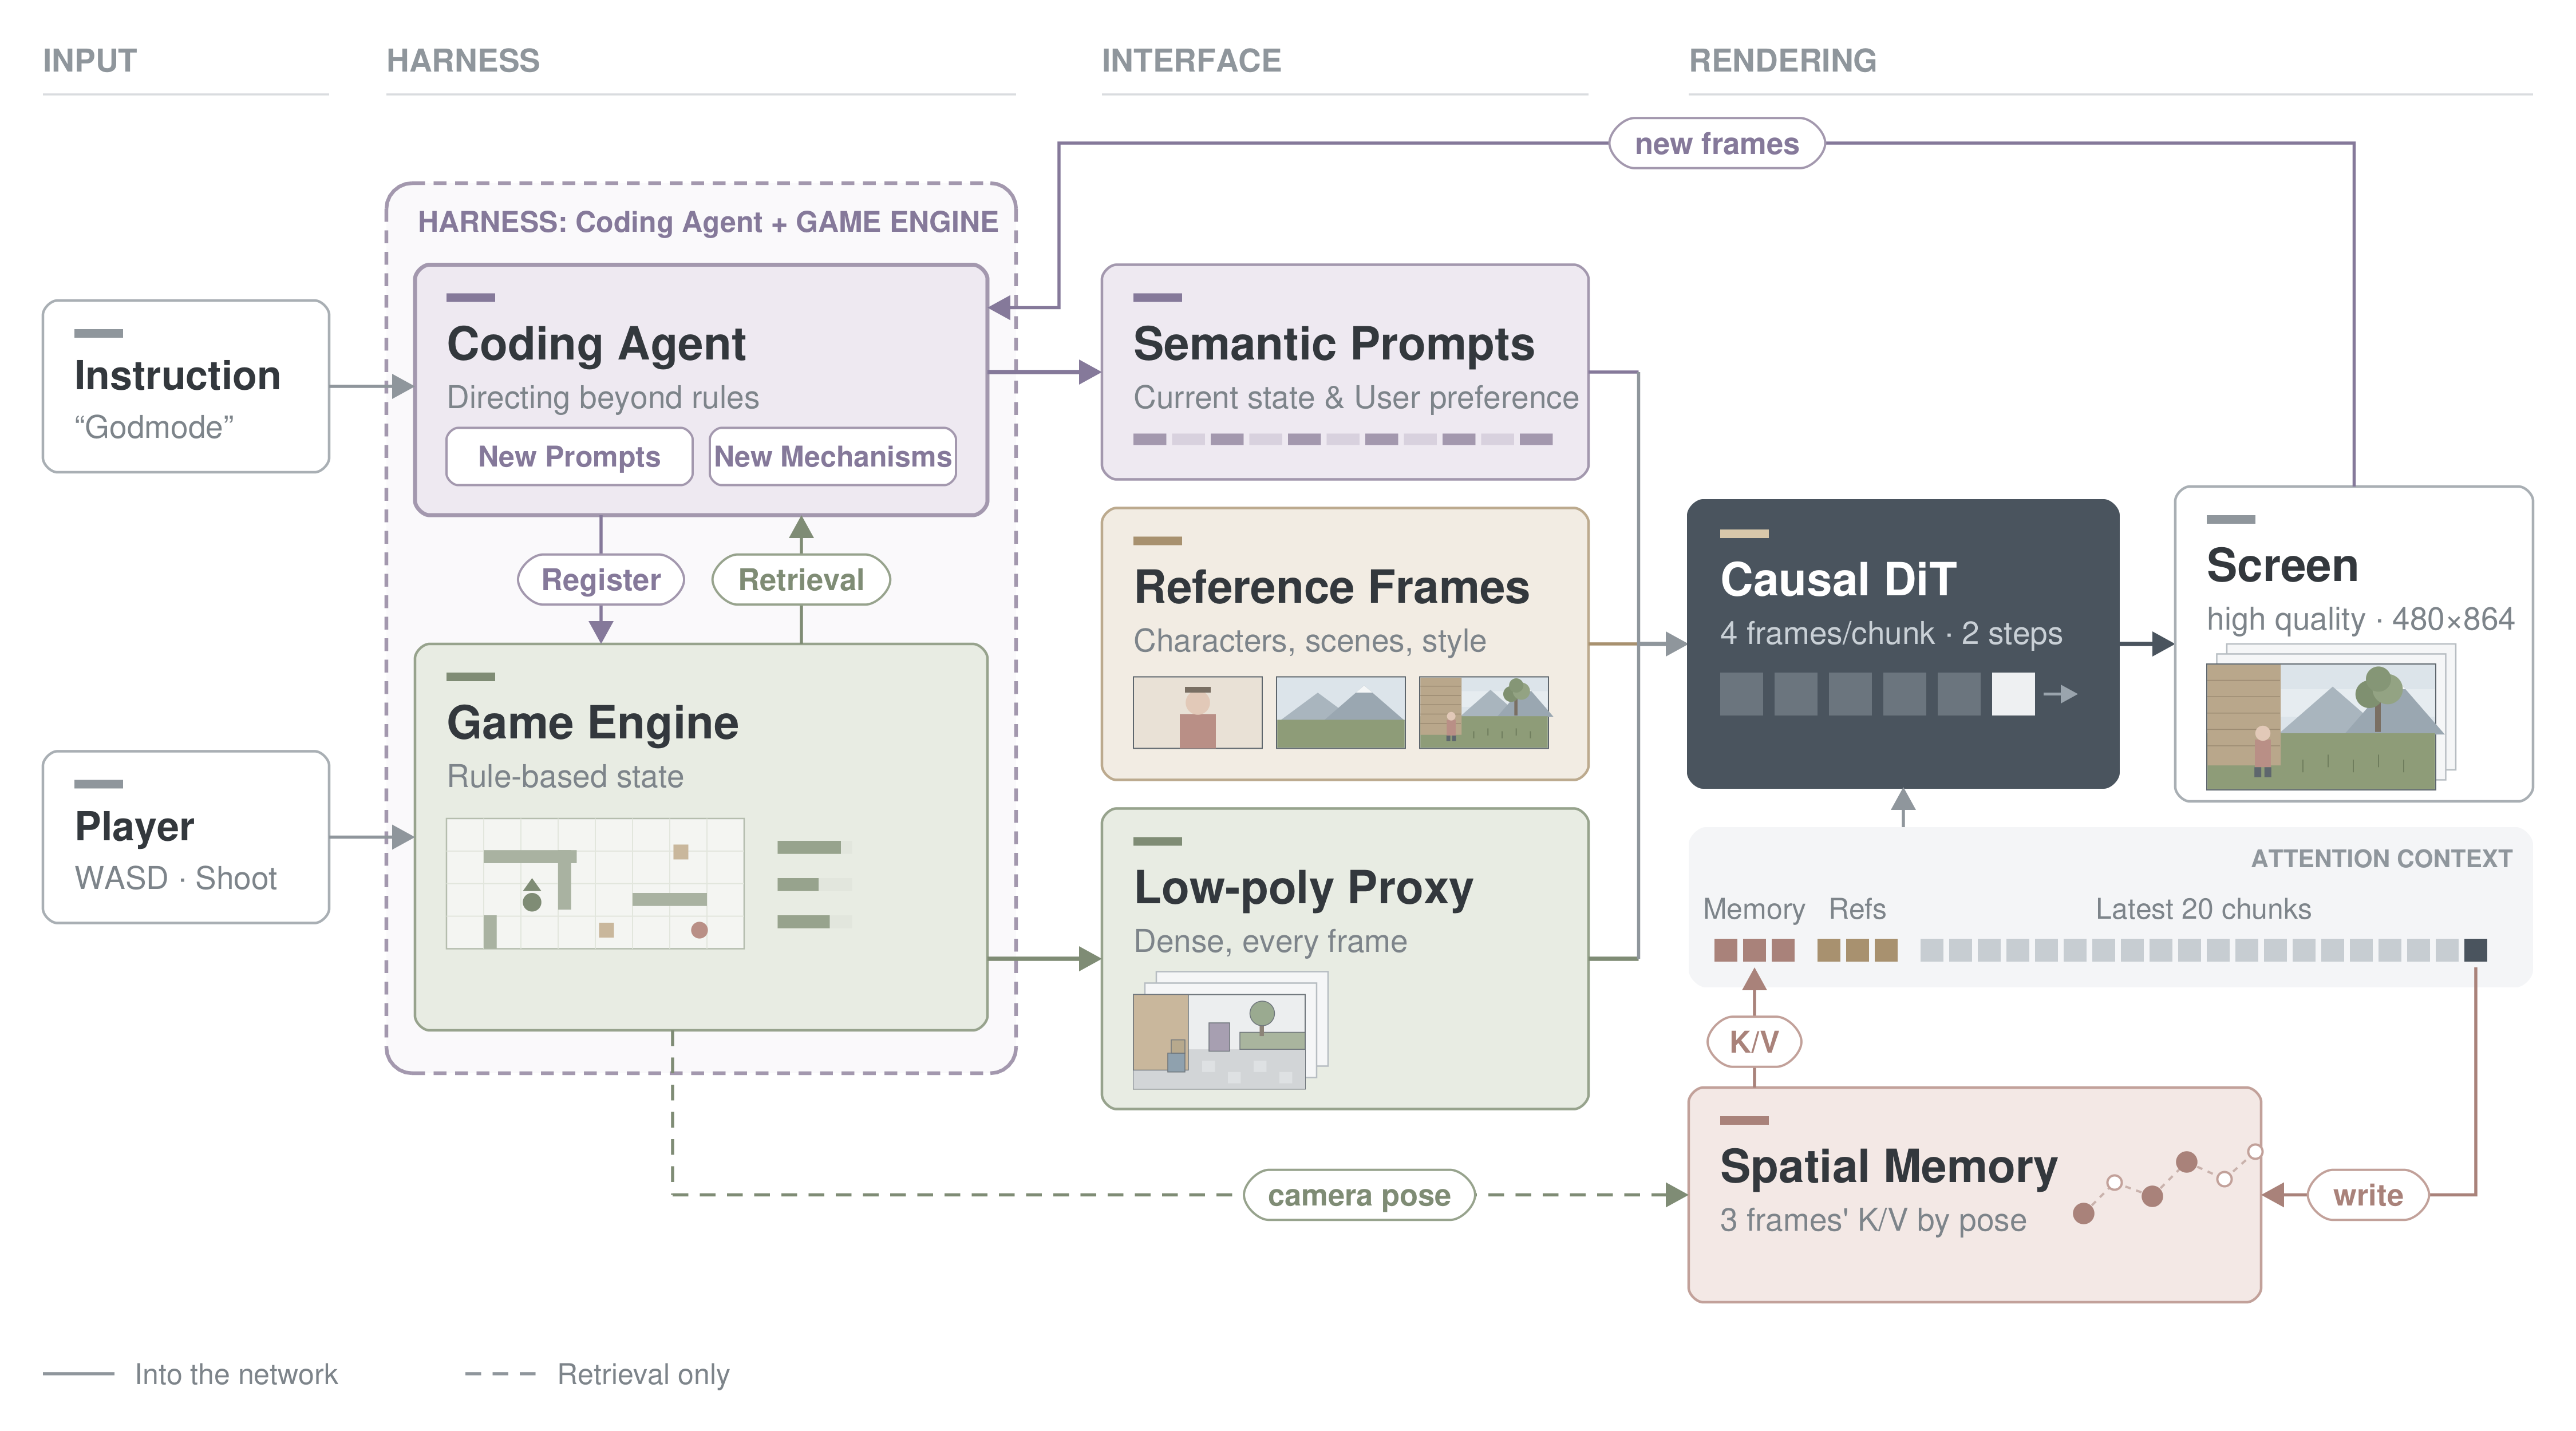
Fonte: página do projeto Matrix-Game 4.0, Skywork AI. Esta figura conceitual inclui recuperação de memória espacial; o runtime do shooter lançado tem um comportamento mais restrito, descrito abaixo.
Em alto nível, o fluxo de trabalho é:
Os exemplos da QbitAI incluem a durabilidade de um escudo antes da perda de vida e uma tarefa de corrida alterada de contrarrelógio para perseguição. Eles ilustram o benefício de regras explícitas: modificar a jogabilidade significa alterar e testar o código, não apenas pedir ao modelo de vídeo que represente um resultado diferente.
O cartão de modelo do Hugging Face descreve três renderizadores especializados por cena: Medieval Castle, Ancient Egypt e City Racing. Cada checkpoint tem cerca de cinco bilhões de parâmetros BF16 e requer o código-fonte de inferência do Matrix-Game 4.0.
Esses pesos não são pipelines Diffusers prontos para uso direto. A versão fornece código de inferência, uma demonstração no navegador, código-fonte nativo do jogo, modelos e ativos do jogo, enquanto o cartão de modelo declara explicitamente que o código de treinamento e os dados de treinamento não estão incluídos.
A saída é RGB de 480 por 864. Após a inicialização, um bloco latente corresponde a quatro frames RGB; o bloco de inicialização contém um frame. Os recursos compartilhados fornecidos e as políticas específicas de cada cena importam, portanto codecs arbitrários ou a configuração de referência de outra cena não são substituições equivalentes.
Os elementos de HUD e o áudio permanecem camadas de apresentação separadas e alinhadas aos frames. O modelo não gera todos esses componentes apenas porque eles aparecem juntos em uma demonstração finalizada.
A ilustração do projeto inclui memória espacial recuperada por pose da câmera e descrições semânticas dinâmicas. O atual contrato de runtime é mais específico: a configuração de shooter lançada usa um prompt de cena fixo e um cache limitado, e lista explicitamente a ausência de memória recuperada ou geração dinâmica de prompts nessa configuração.
A corrida oferece suporte a legendas dinâmicas fixas ou alinhadas a blocos, fornecidas pelo motor. O condicionamento dinâmico mantém o codificador de texto e atualiza as entradas de cache relacionadas ao texto quando a legenda muda, o que tem um custo de throughput.
Essa distinção impede que um diagrama de pesquisa atraente se torne uma lista imprecisa de recursos para a demonstração disponível para download. Verifique a cena e o preset utilizados antes de presumir que um mecanismo apresentado funciona naquele caminho.
O relatório de origem agrupa a engenharia em reduzir o que o modelo precisa inferir, lembrar e calcular. O material oficial sustenta os principais mecanismos: condicionamento visual low-poly, informações de referência, um cache limitado de histórico recente e geração causal em poucas etapas.
Em vez de sintetizar uma cena apenas a partir de texto, o modelo recebe uma estrutura renderizada pelo motor. Objetos e movimento de câmera chegam, portanto, como restrições visuais. O condicionamento de texto adiciona semântica à cena, com o modo lançado variando conforme a cena.
Para inferência, o caminho em tempo real usa o codec TAEHV, uma etapa de denoising, execução DiT otimizada e grafos CUDA. O preset de qualidade usa codificação e decodificação Wan, duas etapas de denoising e DiT nativo. A documentação alerta que esses modos têm custos diferentes de qualidade e computação.
Na RTX 5090, os presets dedicados convertem os pesos lineares dos blocos DiT para FP8 no carregamento e quantizam ativações durante a inferência. Os embeddings e a camada de saída permanecem em BF16. O rtx5090 simples usa PyTorch SDPA; o rtx5090-sage exige uma compilação adicional corrigida do SageAttention.
A página do projeto apresenta uma demonstração de uma etapa na RTX 5090 com os números a seguir. Eles descrevem a configuração demonstrada, não uma garantia de taxa de frames para todas as cenas ou computadores.
| Número da página do projeto | O que mede ou descreve |
|---|---|
| 83 FPS | Demonstração de denoising em uma etapa na RTX 5090. |
| 48 ms | Denoising de um bloco, correspondente a quatro frames RGB após a inicialização. |
| 112 ms | Da tecla pressionada ao primeiro frame reativo na demonstração reportada. |
| 480p | Categoria de resolução da saída em streaming. |
| Uma GPU | Codificador de texto, DiT e VAE residentes na configuração demonstrada. |
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A QbitAI também reporta cerca de 57 FPS com denoising em duas etapas, aproximadamente 18,5 GiB de pico de memória GPU e jogabilidade apresentada a 60 FPS. Esses são números reportados pela fonte; eles não devem ser combinados como se todos os modos alcançassem todos eles simultaneamente.
Os exemplos de navegador do README atual usam --fps 40, mas o definem explicitamente como uma cadência-alvo de captura do jogo, não como uma garantia medida de throughput de renderização ou latência. A inicialização e o aquecimento também diferem da inferência em estado estável.
Codificação de vídeo, buffering, transporte e decodificação no navegador acrescentam trabalho além do tempo de denoising do modelo. Por isso, uma medição de inferência por bloco, o throughput do pipeline no servidor e a latência entre ação e exibição são métricas diferentes.
A fonte também compara o sistema com uma configuração de pesquisa diferente da NVIDIA. Sem hardware, resolução, qualidade e definições de latência equivalentes, esses números não estabelecem uma classificação universal justa.
O README da v4 documenta Linux com uma GPU NVIDIA e Python 3.12 para inferência, além do ambiente compatível de PyTorch, CUDA e driver. Uma demonstração no navegador também precisa do jogo nativo e das dependências de mídia no host. O cliente de navegador não precisa de sua própria GPU de inferência.
Antes da primeira execução:
Matrix-Game-4/, e não do diretório pai.O downloader mapeia as pastas de cena do Hub para caminhos de runtime; por isso, o nome de uma pasta no Hugging Face não é suficiente para inferir o layout do diretório local. Os manifestos oficiais verificam o tamanho dos arquivos e o SHA256 antes de instalar um recurso.
A versão prevê apenas uma sessão ativa e um modelo de cena por processo de servidor. Seu README a chama de demonstração confiável para um único usuário, com padrões de loopback, e não de serviço público autenticado de jogos em nuvem. Não exponha diretamente à internet seus serviços HTTP, RTSP e WebRTC.
O código-fonte da v4 é Apache-2.0. O cartão de modelo também identifica os pesos de cena do projeto, imagens sink e ativos do jogo como Apache-2.0, enquanto recursos compartilhados e materiais de terceiros mantêm seus próprios termos. O TAEHV tem um aviso MIT, e o áudio de corrida inclui exigências de atribuição para alguns ativos.
Trata-se de uma quantidade substancial de material disponível para download, mas não de uma versão completa de treinamento. Mantenha as licenças aplicáveis e os créditos de áudio ao redistribuir trabalhos baseados no projeto.
Os modelos são especializados para as cenas e os perfis de câmera fornecidos. O cartão de modelo lista deriva de aparência e erros de geometria com geometrias não vistas, movimento rápido, oclusão e sessões longas, e evita explicitamente garantir taxa de frames, compatibilidade de memória ou reconstrução exata de cenas.
O Matrix-Game 4.0 é, portanto, uma plataforma concreta para testar renderização neural fundamentada no motor. Ele não deve ser descrito como um gerador universal de jogos, um serviço multiplayer comprovado ou um sistema que elimina a necessidade do desenvolvimento convencional de jogos.
A versão oficial inclui um caminho de inferência otimizado para RTX 5090 e reporta demonstrações em uma única GPU. O desempenho e a compatibilidade com a memória dependem da configuração documentada, e o cartão de modelo não os garante para todas as cargas de trabalho.
Não. O motor de jogo executável controla a jogabilidade e o estado físico. A saída neural pode conter erros visuais sem alterar diretamente os cálculos de colisão ou de regras do motor.
O cartão de modelo afirma explicitamente que não. Ela inclui checkpoints de cena e ativos usados com a inferência lançada e o código-fonte do jogo, o que tem um escopo diferente de reproduzir o treinamento do modelo.
--fps 40 garante 40 frames por segundo exibidos?Não. O README o define como uma cadência-alvo de captura. Codificação, transporte, buffering, decodificação no navegador e inferência podem afetar a apresentação final e a latência.
O diagrama conceitual do projeto inclui esse mecanismo, mas o contrato de runtime atual informa que a configuração de shooter lançada não usa memória recuperada. O modo de legendas dinâmicas da corrida também é separado do caminho de prompt fixo do shooter.
A versão documenta uma sessão ativa por processo de servidor e descreve uma demonstração confiável para um único usuário. Seus serviços não devem ser expostos diretamente à internet como se autenticação e proteções de serviço público já fossem fornecidas.
O Matrix-Game 4.0 usa um motor executável para manter o jogo, enquanto um modelo de vídeo causal renderiza sua aparência. A versão para uma única GPU oferece uma forma prática de examinar essa divisão, com cenas, código de inferência e ativos disponíveis para download.
Suas demonstrações são promissoras, mas a configuração lançada, a especialização por cena e as métricas de desempenho separadas importam tanto quanto o FPS destacado.
Comece com uma frase e tenha um site completo em minutos.
