For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
A Meta apresentou o **Muse Wonder** e o **Muse Wonder Full** em 12 de outubro de 2026. O lançamento é voltado a agentes pessoais e profissio...
A Meta apresentou o Muse Wonder e o Muse Wonder Full em 12 de outubro de 2026. O lançamento é voltado a agentes pessoais e profissionais: sistemas que devem lembrar contextos úteis, superar obstáculos e concluir projetos que exigem mais de uma resposta.
O anúncio oficial confirma que o Wonder está disponível pela API de modelos da Meta e pelo Muse Code, enquanto o Full está disponível para assinantes do Muse Code. A Meta também planeja levar o Wonder ao seu assistente Muse, inicialmente para assinantes.
O cartão do modelo lista um contexto de inferência de um milhão de tokens e entradas que abrangem texto, imagens, vídeo e áudio. A modalidade de saída listada é texto. Portanto, a compreensão multimodal não deve ser confundida com uma promessa de que o próprio modelo gera todos os meios de entrada.
A Meta afirma que os modelos foram treinados em seu data center Prometheus de escala de gigawatts, após uma reconstrução mais ampla de sua infraestrutura de IA. A infraestrutura de treinamento explica o contexto do lançamento; ela não demonstra que toda aplicação terá o mesmo desempenho de uma demonstração de benchmark.
O relatório fornecido descreve o Wonder Full com pontuação de 56 no Artificial Analysis Intelligence Index, em comparação com 52 para o Wonder e 48 para o Muse Spark 1.3. A avaliação da própria Artificial Analysis confirma esses números com esforço máximo de raciocínio. Eles se referem ao retrato da avaliação informado, e não a uma classificação permanente.
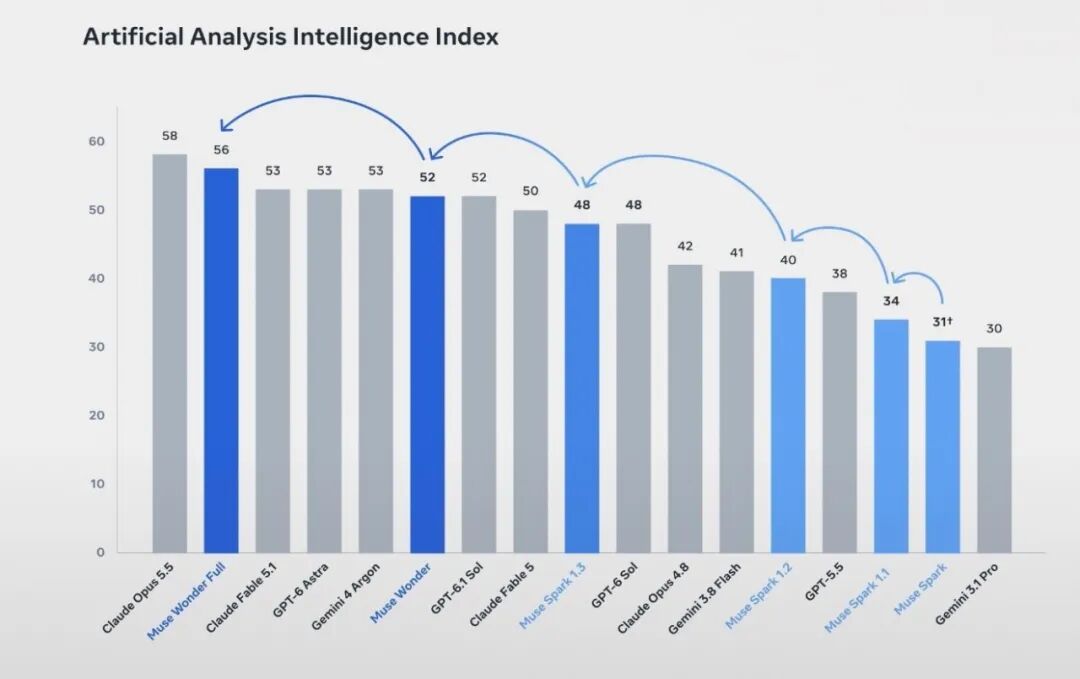
Gráfico reproduzido no relatório da Xinzhiyuan no BAAI; avaliação atribuída ali à Artificial Analysis.
Para trabalho de software contínuo, a fonte informa:
| Avaliação | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57,5% | 53,1% | 46,3% | 42,5% |
| DeepSWE v1.1 | 79,0% | 78,8% | 74,2% | 74,1% |
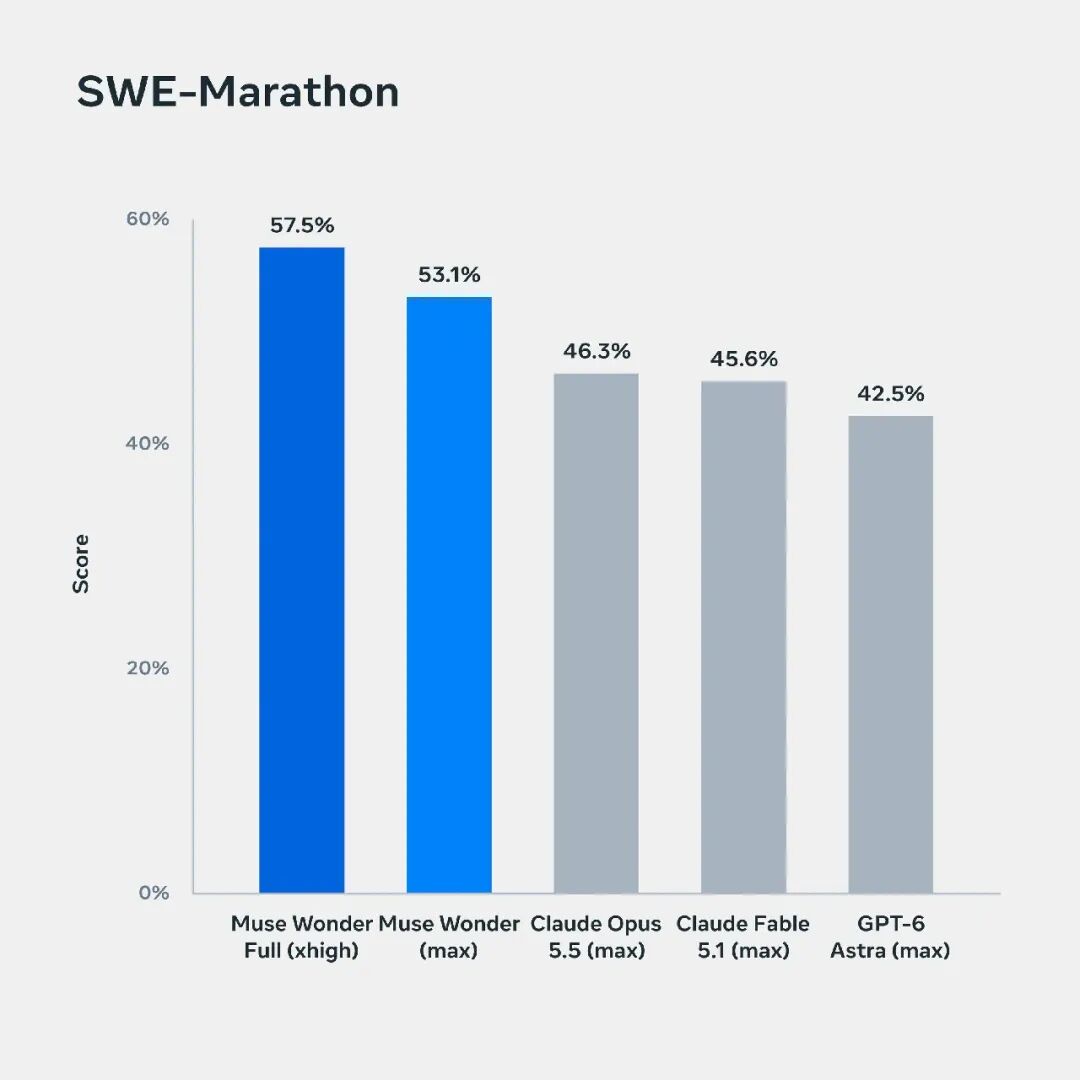
Gráfico de benchmark da Meta, reproduzido pela fonte.
O cartão do modelo traz uma ressalva útil: o SWE-Marathon não é uma comparação controlada que utiliza um único ambiente comum. Alguns resultados de concorrentes usam Codex ou Claude Code, e o resultado informado do Wonder Full usa esforço de raciocínio xhigh. O DeepSWE também combina resultados especificados de terceiros e resultados informados pelos provedores, portanto os leitores devem consultar a metodologia de cada benchmark.
O panorama mais amplo é misto, e não uma vitória completa. O artigo informa que o Full supera o GPT-6 Astra no ProgramBench, mas fica atrás do Opus 5.5 e atrás de ambos na comparação de programação em terminal listada. A seleção de modelo ainda depende do trabalho real, do ambiente de ferramentas, do orçamento e da taxa de falha aceitável.
A Meta usa Active Memory para transportar contexto importante entre conversas e recuperar detalhes relevantes quando necessário. Ela usa Active Focus para trabalho contínuo: tentar outra abordagem, adaptar-se a novas informações e prosseguir diante de bloqueios.
Essas capacidades resolvem problemas diferentes. Lembrar um requisito não garante, por si só, que um agente consiga concluir uma implementação difícil; a persistência não ajuda se o agente perdeu uma restrição essencial.
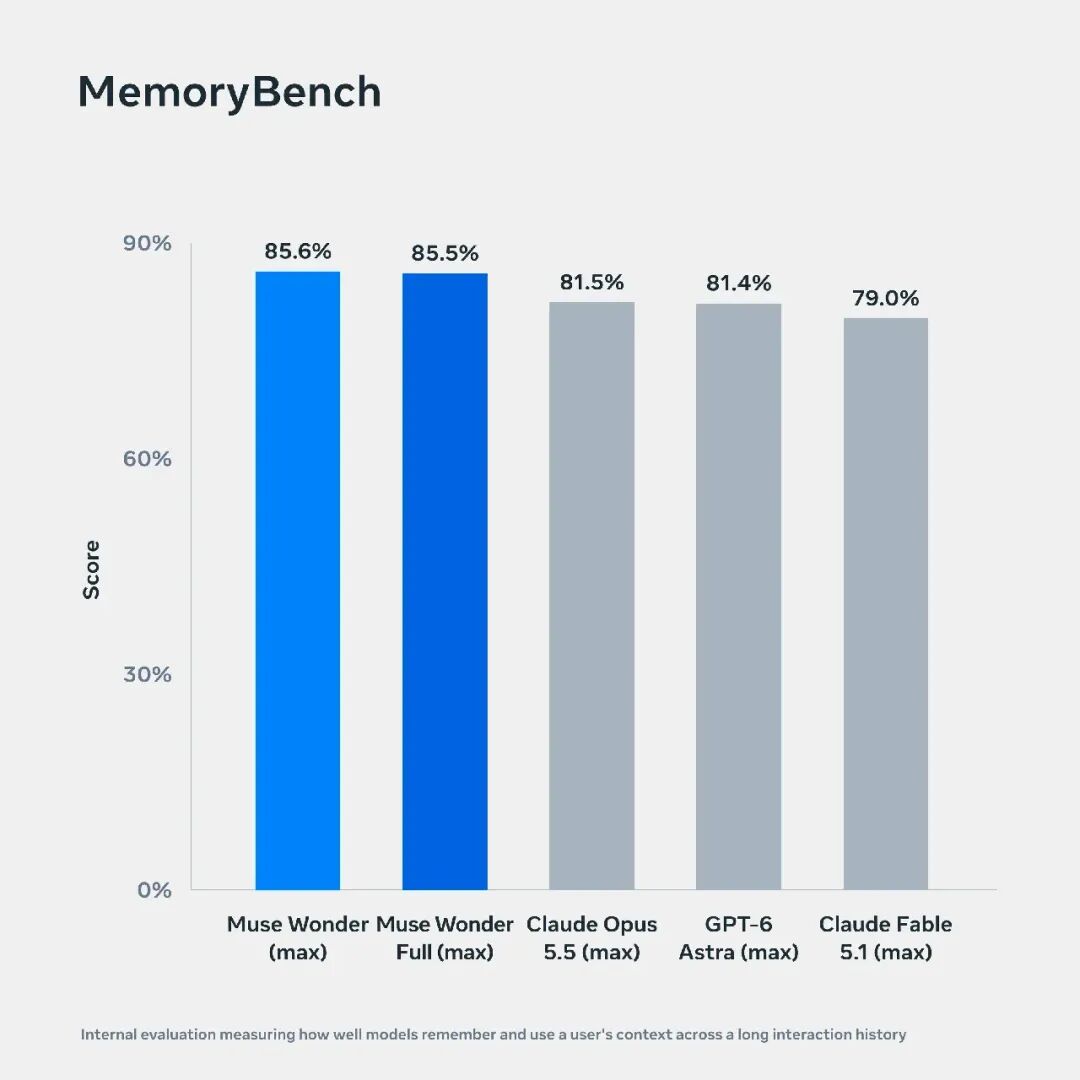
Gráfico de avaliação da Meta, reproduzido por meio do relatório-fonte.
O cartão do modelo descreve o MemoryBench como uma avaliação interna que usa conversas de 64.000 a 100.000 tokens, incluindo informações distrativas ou conflitantes. O FocusBench também é uma avaliação interna. Essas são descrições úteis do que foi testado, mas não garantem recordação sem falhas ou autonomia ininterrupta em um serviço implantado.
A Meta avalia os modelos em tarefas envolvendo direito, finanças, saúde e documentos profissionais, além de programação. Esses testes dizem respeito a produtos de trabalho e regras de avaliação específicos; uma pontuação não deve ser tratada como uma qualificação profissional.
O relatório chinês também destaca uma distinção entre responder de forma seletiva e saber mais. Ele informa uma medida menor de alucinação para o Full, acompanhada de um índice de conhecimento menor do que o dos modelos Opus e Astra comparados. Nessa discussão, a porcentagem de alucinação é condicional a itens incorretos ou não respondidos no teste de conhecimento; ela não representa a porcentagem de todas as respostas do mundo real que são falsas.
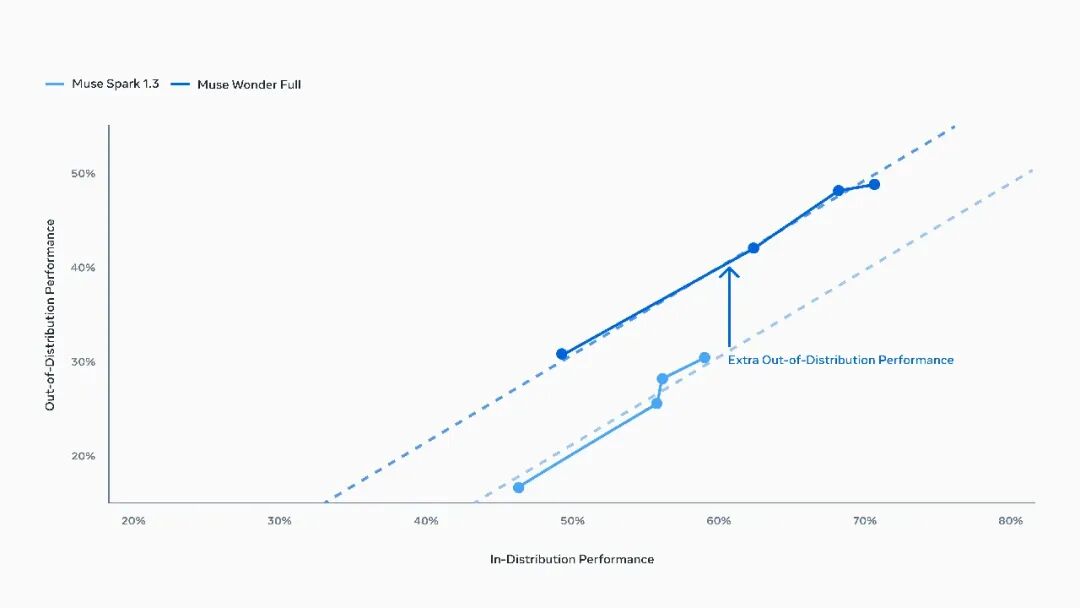
Para tarefas desconhecidas, a Meta apresenta evidências de que o Full generaliza melhor do que o modelo Spark anterior, com desempenho comparável em distribuição. A conclusão refere-se ao cenário de avaliação medido, não sendo prova de autoaperfeiçoamento irrestrito.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Gráfico de generalização da Meta, reproduzido na fonte.
A fonte lista os seguintes preços no momento de seu relatório:
| Produto | Preço informado | Acesso informado |
|---|---|---|
| Entrada da API Wonder | US$ 4 por milhão de tokens | API baseada em uso |
| Saída da API Wonder | US$ 20 por milhão de tokens | API baseada em uso |
| Entrada em cache do Wonder | US$ 0,20 por milhão de tokens | Entrada em cache |
| Full: Power Usage | US$ 50 por mês | Assinatura do Muse Code |
| Full: Maximum Usage | US$ 200 por mês | Assinatura do Muse Code |
O relatório descreve as duas assinaturas Full como oferecendo 20 e 80 vezes o uso básico, respectivamente. Esses multiplicadores não correspondem a uso ilimitado, e a fonte não estabelece uma quantidade universal de tarefas por mês.
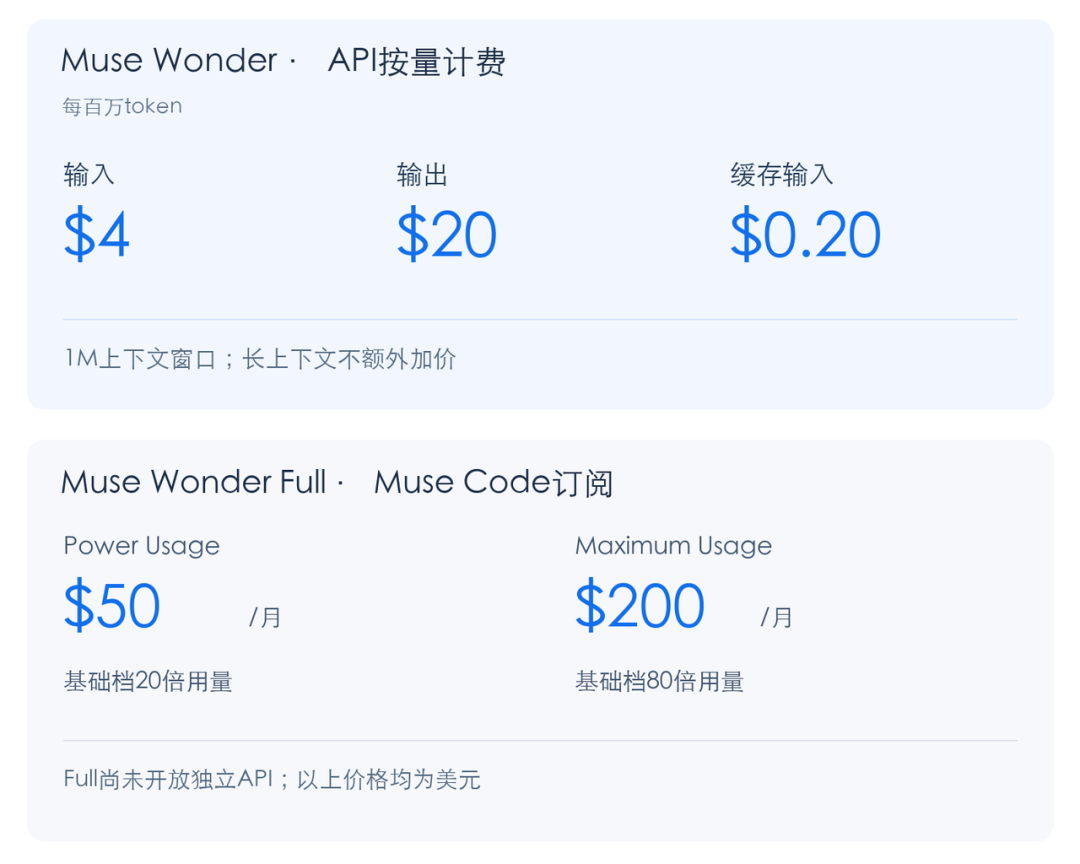
Gráfico de preços creditado ao relatório-fonte; os termos de cobrança atuais não estavam acessíveis de forma independente.
No momento do anúncio, o Full era oferecido por assinaturas do Muse Code, e não por uma API pública separada anunciada. As equipes que considerarem qualquer um dos produtos devem verificar o acesso e os preços atuais em sua própria conta antes de se comprometerem com uma carga de trabalho.
O Muse Wonder é um modelo da Meta lançado em 12 de outubro de 2026 para tarefas de agentes pessoais e profissionais. A Meta descreve pontos fortes em memória, execução contínua de tarefas, programação e trabalho específico de domínio.
O Full é a variante de maior desempenho em muitas das avaliações informadas. O anúncio oficial disponibiliza o Wonder pela API e pelo Muse Code, enquanto o Full está disponível para assinantes do Muse Code.
O cartão do modelo da Meta lista um milhão de tokens na inferência. A capacidade de contexto é separada da recordação confiável, dos limites de saída e da quantidade de material utilizável que uma aplicação específica pode fornecer.
O cartão do modelo lista texto, imagem, vídeo e áudio como entradas. Ele lista texto como saída, portanto o suporte a entrada multimodal não deve ser interpretado como geração nativa de áudio ou vídeo.
Não; as pontuações informadas se aplicam a tarefas, configurações de agentes e parâmetros de raciocínio específicos. A Meta observa explicitamente que os resultados do SWE-Marathon não usam um ambiente comum controlado em todos os sistemas comparados.
O Active Memory diz respeito a reter e recuperar contexto relevante entre conversas. O Active Focus diz respeito a persistir diante de obstáculos e adaptar-se durante uma tarefa, com esclarecimento ou confirmação quando apropriado.
O anúncio de 12 de outubro descreve o Full como disponível para assinantes do Muse Code. Ele não anuncia uma API pública separada para o Full, e a disponibilidade deve ser verificada em comunicados oficiais posteriores.
O Muse Wonder e o Full ampliam a oferta de agentes da Meta com um contexto de um milhão de tokens, entradas multimodais, memória e capacidades contínuas de programação. O anúncio confirma rotas distintas de acesso por API e assinatura, enquanto a fonte informa melhorias substanciais em relação ao Muse Spark 1.3.
A comparação mais útil combina as pontuações de benchmark com seus ambientes de teste, o acesso à conta e o custo para concluir suas próprias tarefas.
Comece com uma frase e tenha um site completo em minutos.



