A Microsoft relata que a nova configuração de seu sistema multimodelo e multiagente MDASH alcançou uma taxa de sucesso de 95,95% no CyberGym...
A Microsoft informou que sua nova configuração do sistema multimodelo e multiagente MDASH alcançou uma taxa de sucesso de 95,95% no CyberGym. O sistema é usado para identificar, verificar, priorizar e corrigir vulnerabilidades de software.
O número é impressionante. O artigo original do CyberGym relatou que a combinação mais forte testada — OpenHands com Claude 3.7 Sonnet — reproduziu apenas 11,9% das vulnerabilidades do benchmark na avaliação inicialmente publicada.
O resultado mais recente da Microsoft é muito superior. No entanto, a parte mais importante deste anúncio não é apenas que os novos modelos são mais capazes.
A pontuação de 95,95% foi produzida por um sistema de segurança completo que combina:
A Microsoft resumiu essa abordagem em três palavras:
Modelo
Dados
Estrutura
O modelo contribui com inteligência. Os dados dão contexto de segurança à inteligência. A estrutura transforma as saídas do modelo em fluxos de trabalho repetíveis e verificáveis.
Essa distinção é importante porque as equipes de segurança empresarial não compram respostas de benchmark. Elas precisam de um sistema capaz de operar continuamente, controlar falsos positivos, comprovar que as descobertas são reais e ajudar a converter resultados em correções de segurança.
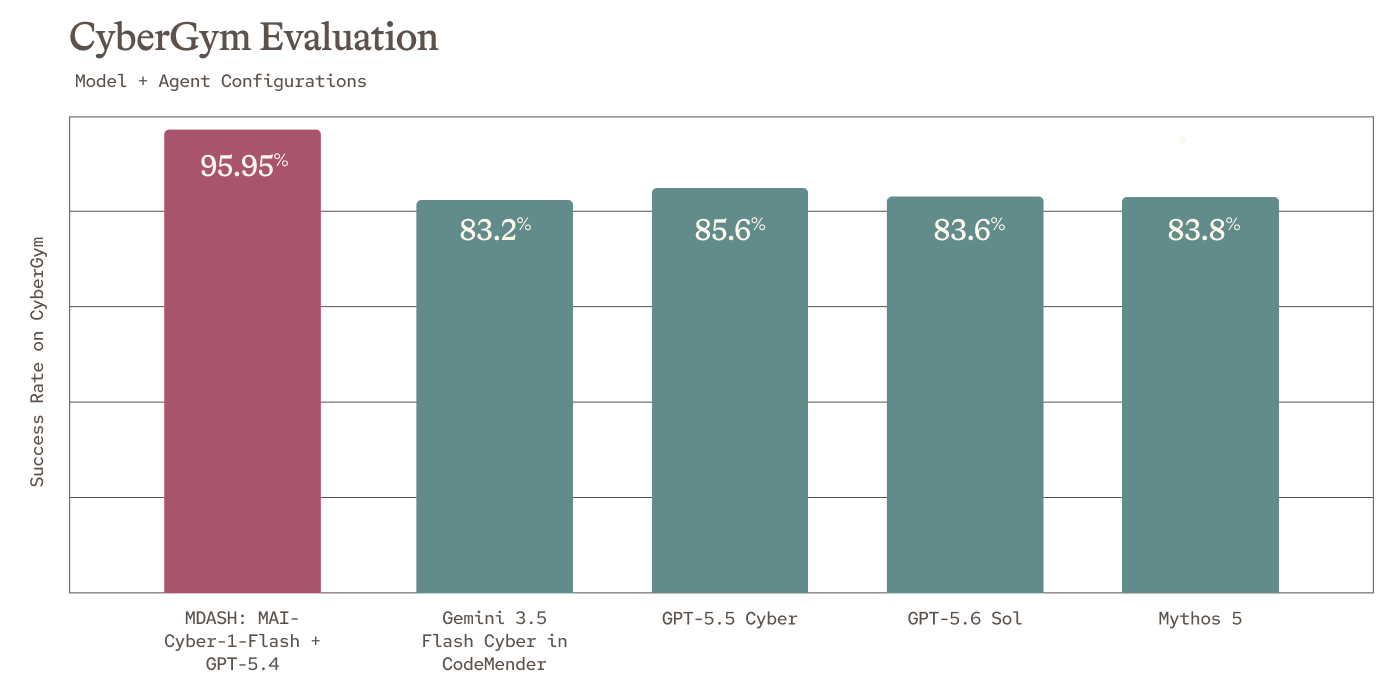
O gráfico do CyberGym publicado pela Microsoft compara cinco configurações de modelos e agentes:
| Sistema ou configuração de modelo | Taxa de sucesso no CyberGym reportada pela Microsoft |
|---|---|
| MDASH: MAI-Cyber-1-Flash + GPT-5.4 | 95,95% |
| GPT-5.5 Cyber | 85,6% |
| Mythos 5 | 83,8% |
| GPT-5.6 Sol | 83,6% |
| Gemini 3.5 Flash Cyber no CodeMender | 83,2% |
A configuração MDASH lidera o gráfico da Microsoft com mais de dez pontos percentuais de vantagem sobre o segundo colocado.
A Microsoft também informou que essa configuração tem um custo cerca de 50% menor em comparação com a configuração MDASH mais forte anterior (que usava GPT-5.4, GPT-5.4 mini e GPT-5.3 Codex).
Portanto, a comparação envolve duas dimensões:
A varredura de segurança não é um problema de uma única execução. Grandes organizações podem precisar examinar milhões de linhas de código, repetir varreduras após cada alteração, verificar vulnerabilidades suspeitas, testar novamente correções e monitorar um portfólio de software em constante mudança.
Uma configuração extremamente capaz, mas cara demais para execução frequente, pode gerar menos proteção real do que um modelo menor integrado a um sistema melhor de roteamento e verificação.
atingir 90%
A Microsoft afirma que o MAI-Cyber-1-Flash foi projetado para lidar com até 90% das tarefas no fluxo de trabalho do MDASH.
Os 10% mais difíceis das tarefas podem ser roteados para um modelo maior, identificado pela Microsoft como GPT-5.4 na configuração publicada.

Essa estratégia pode ser descrita da seguinte forma:
Tarefas de segurança comuns e frequentes
→ MAI-Cyber-1-Flash

Tarefas excepcionalmente difíceis
→ GPT-5.4
Isso não significa que o MAI-Cyber-1-Flash corrige 90% das vulnerabilidades sozinho.
O número de 90% refere-se à parcela de tarefas que o modelo pequeno foi projetado para cobrir no fluxo de trabalho roteado. O resultado completo do MDASH ainda depende do roteador de tarefas, de modelos maiores, agentes especializados, verificação, geração de provas, deduplicação, ferramentas de segurança, ambiente de execução e controles de nível de sistema.
O modelo pequeno reduz o custo médio do fluxo de trabalho, mas não elimina a necessidade de modelos mais fortes nos casos mais difíceis.
A Microsoft descreve o MAI-Cyber-1-Flash como seu primeiro modelo dedicado à cibersegurança.
A ficha técnica oficial do modelo lista:
| Especificação | MAI-Cyber-1-Flash |
|---|---|
| Arquitetura | Transformer esparso de mistura de especialistas |
| Parâmetros totais | 137B |
| Parâmetros ativos | 5B |
| Comprimento do contexto | 256K |
| Entrada | Texto |
| Saída | Texto |
| Modelo base | MAI-Code-1-Flash |
| Ambiente principal | MDASH (codinome da Microsoft) |
| Data de lançamento | 27 de julho de 2026 |
| Disponibilidade | Prévia privada no Azure AI Foundry, para clientes aprovados do MDASH |
O modelo é uma versão ajustada especificamente para cibersegurança do MAI-Code-1-Flash.
Ele foi projetado para fluxos de trabalho como identificação de vulnerabilidades, verificação, priorização, classificação, suporte à correção e varredura de código em escala empresarial.
Não é um modelo geral de rede voltado ao público.
A ficha técnica da Microsoft indica que o acesso é restrito a clientes selecionados do MDASH e sujeito a revisão adicional, pois capacidades avançadas de cibersegurança são consideradas tecnologia de uso duplo.
O modelo também foi projetado especificamente para integração com o MDASH, e não como um modelo independente para download ou uma API pública sem restrições.
O MAI-Cyber-1-Flash tem 137 bilhões de parâmetros no total, mas ativa apenas cerca de 5 bilhões de parâmetros por token.
Esse design esparso de mistura de especialistas permite que o modelo acesse uma capacidade total maior, mantendo um custo de inferência relativamente baixo por ativação.
No entanto, a otimização mais importante está na especialização.
Modelos gerais de fronteira precisam suportar escrita, matemática, pesquisa, codificação, conversação, planejamento, trabalho multimodal e uso de ferramentas. Um modelo especializado pode concentrar mais treinamento e pós-treinamento em um único domínio de atuação.
Para o MAI-Cyber-1-Flash, esse domínio inclui ambientes de segurança executáveis e fluxos de trabalho
de gerenciamento de vulnerabilidades.
Quando um modelo encontra repetidamente tarefas semelhantes ao seu ambiente de treinamento e avaliação, a especialização pode melhorar a relação custo-benefício.
O sistema ainda precisa de um plano reserva, pois tarefas difíceis ou incomuns podem exceder as capacidades do modelo especializado.
Isso dá origem a uma arquitetura multimodelo prática:
Modelo especializado de baixo custo cobre a amplitude
+
Modelo de fronteira cuida das exceções
+
Sistema de verificação garante a confiança
A ficha técnica do modelo traz uma comparação particularmente útil em nível de sistema.
A Microsoft afirma que a configuração anterior do MDASH alcançou 88,4% no CyberGym.
Após substituir 80% das chamadas de modelo existentes no fluxo de trabalho pelo MAI-Cyber-1-Flash, o resultado subiu para 95,95%.
O custo também caiu cerca de metade em relação à configuração mais forte anterior.
Esse resultado desafia uma suposição comum:
Modelos mais baratos necessariamente reduzem a qualidade.
Isso pode ser verdade quando um modelo é comparado isoladamente na mesma tarefa. Mas dentro de um sistema de roteamento, nem sempre é o caso.
Um modelo especializado pode apresentar desempenho mais consistente em tarefas comuns por ter sido treinado especificamente para elas. O roteador pode reservar o modelo caro de fronteira para os cenários onde ele cria mais valor.
O resultado final depende de responder corretamente a três perguntas:
O roteamento de modelos passa a ser parte da qualidade do produto.
A ficha técnica da Microsoft também relata
MAI-Cyber-1-Flash em avaliações independentes em outras avaliações de segurança cibernética.
Esses resultados apenas do modelo não equivalem à pontuação da MDASH no CyberGym.
O card do modelo é listado a seguir:
| Benchmark | Resultado independente do MAI-Cyber-1-Flash |
|---|---|
| CVEBench | 0.314 |
| CyberSecEval4 Inteligência de Ameaças | 0.553 |
| CyberSecEval4 Análise de Malware | 0.33 |
| CRSBench | 0.651 (POV=1200) |
| ExploitGym Kernel | 0 |
| ExploitGym Userland | 0 |
| ExploitGym Navegador | 0 |
Esses dados ilustram a importância da distinção em nível de sistema.
O modelo pequeno não lidera de forma abrangente em todos os benchmarks de segurança cibernética. Seus resultados publicados mais fortes são obtidos quando opera em coordenação dentro da MDASH com outros modelos, agentes, ferramentas, dados e fases de validação.
Isso confirma a mensagem central da Microsoft:
Modelos são componentes.
Sistemas são produtos.
A MDASH é a estrutura da Microsoft para identificação e correção de vulnerabilidades com múltiplos modelos e múltiplos agentes.
A Microsoft afirma que seus especialistas em segurança criaram mais de 100 agentes especializados no sistema.
Diferentes agentes são responsáveis por diferentes etapas do fluxo de trabalho, incluindo localização de código, descoberta de candidatos, raciocínio sobre vulnerabilidades, validação, construção de provas, classificação, deduplicação, correção, trabalho relacionado a patches e comparação entre descobertas.
O fluxo simplificado do sistema é aproximadamente o seguinte:
Contexto de código e segurança
        ↓
Agente de descoberta de candidatos
        ↓
Agente de validação
        ↓
Debate e comparação
        ↓
Deduplicação
        ↓
Geração de prova de conceito
        ↓
Suporte a patches ou correções
Revisão humana e operações controladas
A implementação interna específica é proprietária, mas a Microsoft já articulou vários princípios de design importantes.
A Microsoft afirma que a MDASH separa as várias partes do pipeline (como direcionamento, validação, deduplicação e prova) de qualquer modelo único.
Isso torna mais fácil substituir ou comparar modelos.
Quando um novo modelo fica disponível, o sistema pode executar testes A/B comparando-o com o conjunto atual de modelos.
Os investimentos anteriores da organização permanecem válidos:
Isso reduz a dependência de um único fornecedor ou checkpoint de modelo.
Também possibilita melhoria contínua. O melhor modelo para um estágio não é necessariamente o melhor para outro.
A descoberta de certas vulnerabilidades exige mais do que apenas ler o código-fonte.
O sistema pode precisar compilar o projeto, criar entradas de acionamento, executar a versão vulnerável, executar a versão corrigida, verificar crashes, consultar bancos de dados de análise de código, comparar fluxos de controle e verificar se o comportamento é reproduzível.
A Microsoft afirma que a MDASH pode usar plugins de domínio especializados e sistemas de análise de código.
Seu anúncio de maio discutiu um plugin de validação para vulnerabilidades do sistema de arquivos de log genérico e observou que bancos de dados CodeQL também podem ser usados.
O modelo não precisa executar todas as operações por meio de texto de formato livre.
Para tarefas mais adequadas ao software, as ferramentas podem fornecer capacidades determinísticas.
Modelos de segurança podem produzir descrições de vulnerabilidades plausíveis, mas incorretas.
Se o sistema encaminhar cada resultado especulativo para os desenvolvedores, isso criará fadiga de alertas.
O valor operacional reside em provar que a descoberta é real.
Evidências úteis podem incluir:
É por isso que benchmarks como o CyberGym são relevantes.
Ele não apenas avalia a persuasão de explicações escritas.
Ele verifica se a prova gerada realmente reproduz o comportamento-alvo.
O CyberGym é um benchmark em larga escala criado por pesquisadores associados à Universidade da Califórnia, Berkeley.
O projeto público atual contém 1.507 instâncias reais de vulnerabilidades em 188 projetos de software.
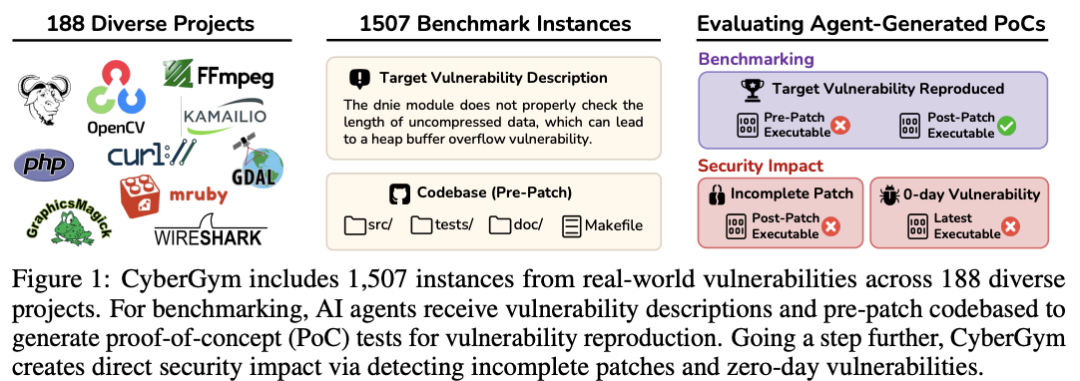
Em sua configuração principal de geração de PoC, o agente recebe:
O agente deve gerar uma prova de conceito capaz de acionar a vulnerabilidade.
O benchmark então avalia o comportamento
em relação à versão vulnerável e à versão corrigida.
Uma reprodução bem-sucedida geralmente deve satisfazer o contraste esperado:
Versão anterior ao patch:
A PoC acionou a vulnerabilidade-alvo.

Versão após o patch:
A mesma PoC não aciona mais a vulnerabilidade.
O CyberGym usa vulnerabilidades reais de projetos open-source importantes, incluindo projetos do ecossistema OSS-Fuzz.
Sua arquitetura baseada em execução o torna mais rigoroso do que benchmarks que apenas exigem que o modelo classifique código ou escreva explicações.
O número de 95,95% precisa ser interpretado com cuidado.
A configuração principal do CyberGym fornece ao agente a descrição da vulnerabilidade.
O agente não começa necessariamente a partir de um código-base totalmente desconhecido, sem nenhuma pista da existência da vulnerabilidade.
Portanto, o benchmark mede uma forma de reprodução de vulnerabilidades conhecidas.
Isso não implica diretamente:
O benchmark ainda exige trabalho árduo. O agente deve navegar por código-base real, localizar o comportamento relevante, construir um acionador válido, compilar ou executar o software e verificar o resultado.
A descrição correta é:
A pontuação relatada é a taxa de sucesso de reprodução de vulnerabilidades na configuração de avaliação do CyberGym usada pela Microsoft.
A primeira versão do artigo original do CyberGym relatou que a combinação de teste mais forte — OpenHands com Claude 3.7 Sonnet — alcançou uma taxa de reprodução de 11,9%.
Revisões posteriores do benchmark, estruturas de agentes, gerações de modelos e design de sistemas melhoraram drasticamente os resultados.
Os 95,95% relatados pela Microsoft demonstram a rapidez com que a combinação de modelos e estruturas de ferramentas está avançando.
No entanto, essa comparação não deve ser interpretada como uma melhoria puramente modelo a modelo.
Esses sistemas diferem em gerações de modelos, estruturas de agentes, prompts, ferramentas, validação, orçamentos computacionais, custos, roteamento de tarefas, versões de benchmark, infraestrutura e estratégias de nova tentativa.
O avanço é real, mas é um avanço em nível de sistema.
O artigo de origem observa que, no momento da publicação, o resultado de 95,95% da Microsoft ainda não havia sido refletido no ranking público do CyberGym.
A configuração anterior de maio da Microsoft, relatada em cerca de 88,4%–88,45%, já havia sido publicada anteriormente como líder de benchmark.
O novo número de 95,95% foi divulgado pela Microsoft no anúncio do MAI-Cyber-1-Flash, no card do modelo e no anúncio do Project Perception da Microsoft.
Até que uma entrada em ranking externo ou uma reprodução independente esteja disponível, ele deve ser descrito como um resultado relatado pela Microsoft.
Isso não torna o resultado sem valor. Significa que os leitores devem distinguir entre:
Avaliações relatadas pelo fornecedor
e
Resultados públicos reproduzidos de forma independente
Essa distinção é especialmente importante em comparações de benchmarks que evoluem rapidamente.
A Microsoft
considera seus dados históricos de segurança sua vantagem mais profunda.
A empresa afirma processar mais de 100 trilhões de sinais de segurança por dia e ter insights operacionais de 1,6 milhão de clientes.
Sua visibilidade de segurança abrange identidade, endpoints, nuvem, rede, dados, navegador e aplicativos.
O valor não está apenas no volume de eventos.
A empresa consegue conectar ações de segurança a resultados:
Quais patches resolveram o problema.
Isso forma um ciclo de feedback fechado.
Incidente de segurança
→ Investigação
→ Verificação
→ Correção
→ Resultados observados
→ Melhores dados e retorno
→ Modelos e agentes aprimorados
Concorrentes podem obter modelos de base semelhantes.
Mas não conseguem reproduzir da noite para o dia décadas de histórico operacional validado.
Os dados só têm valor quando grandes volumes são transformados em contexto de treinamento, avaliação e operação.
Sinais brutos de segurança podem ser repetitivos, ruidosos, incompletos, específicos do cliente, sensíveis, mal rotulados, enviesados para ataques visíveis ou carentes de resultados finais.
Os pipelines de dados precisam conectar eventos a rótulos e resultados confiáveis.
Por exemplo:
Alerta disparado
→ Investigação do analista
→ Vulnerabilidade confirmada
→ Patch implantado
→ A exploração não funciona mais
Essa sequência é mais valiosa do que o alerta isolado.
O fosso defensivo vem dos dados somados à organização dos dados, feedback, avaliação e acesso às operações de segurança.
A estrutura em três partes da Microsoft oferece uma abordagem útil para avaliar qualquer sistema empresarial de IA de segurança.
As perguntas incluem:
As perguntas incluem:
As perguntas incluem:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Um sistema com modelo forte, mas dados fracos e sem validação, pode gerar relatórios impressionantes, porém não confiáveis.
Um sistema bem projetado pode tornar modelos menores mais úteis ao atribuir tarefas corretas e verificar seu trabalho.
A Microsoft acredita que, quando a varredura de segurança é executada continuamente, o custo por token se torna uma restrição central.
Considere uma carga de trabalho simplificada:
10 milhões de tarefas de análise de código por mês
Se cada tarefa usar o modelo mais caro e de ponta, o sistema pode não conseguir manter cobertura completa.
Um design de roteamento muda o custo médio:
90% de modelos especializados de baixo custo
+
10% de modelos caros de ponta
A economia real também depende do tamanho da entrada, tamanho da saída, chamadas de ferramentas, novas tentativas, execução em sandbox, indexação de código, validação, revisão humana, infraestrutura e armazenamento de dados.
A taxa por token do modelo é apenas um dos componentes.
Ainda assim, o mecanismo de roteamento cria uma forte oportunidade de otimização, pois modelos caros são usados seletivamente.
Benchmarks podem comparar modelos individuais sob uma estrutura de teste unificada.
Produtos precisam otimizar o fluxo de trabalho completo.
O melhor sistema pode usar um modelo que não fica em primeiro lugar em rankings individuais, se esse modelo oferecer melhor velocidade, custo, especialização, previsibilidade, uso de ferramentas, eficiência de contexto, calibração de segurança e compatibilidade com a estrutura de testes.
Isso é semelhante a outros sistemas de produção.
Um banco de dados não escolhe o mesmo algoritmo para cada consulta. Um agendador de nuvem não coloca toda carga de trabalho na maior máquina. Um sistema de segurança não deveria enviar toda tarefa para o modelo mais caro.
Modelos de cibersegurança trazem riscos especiais.
A mesma capacidade que ajuda defensores a validar vulnerabilidades também pode ajudar atacantes a explorá-las.
Por isso, a Microsoft restringiu o acesso ao MAI-Cyber-1-Flash.
A ficha do modelo indica:
A Microsoft afirma que o modelo foi calibrado com uma abordagem de segurança em primeiro lugar, avaliado pelo time vermelho de IA da Microsoft, testado por meio de exercícios adversariais automatizados, testado por especialistas em segurança e avaliado por terceiros independentes.
A avaliação independente, segundo a empresa, não encontrou problemas de nível crítico.
Isso não prova que o modelo não tenha riscos. Explica por que a empresa começa com uma implantação restrita em vez de um lançamento público irrestrito.
A ficha do modelo da Microsoft lista várias limitações.
O modelo é treinado e avaliado principalmente em inglês. Em outros idiomas, o desempenho pode ser menor.
Como outros modelos de linguagem, ele pode gerar código e texto imprecisos, incompletos ou incorretos. As saídas exigem revisão e validação.
O modelo foi deliberadamente calibrado para agir com cautela. Quando solicitações defensivas legítimas são ambíguas ou se assemelham a atividades prejudiciais, as salvaguardas podem ser acionadas.
O modelo foi projetado especificamente para o MDASH. Resultados isolados não representam a capacidade do sistema completo.
Não há suporte para uso fora das operações defensivas aprovadas.
O anúncio do MDASH pela Microsoft em maio incluiu exemplos de pesquisa real em segurança.
A empresa relatou ter testado a estrutura em um driver de exemplo não publicado, com 21 vulnerabilidades propositalmente inseridas. Ela afirmou que, em testes controlados, o MDASH identificou todas as 21 vulnerabilidades, com zero falsos positivos.
A Microsoft também relatou que o MDASH ajudou a identificar 16 CVEs divulgados em maio.
Durante a terça-feira de patches do Windows de 2026.
Essas são declarações de produtos e pesquisas da própria Microsoft.
Elas têm maior relevância para implantação do que pontuações de benchmark, pois envolvem código privado, fluxos de trabalho reais de engenharia, validação de vulnerabilidades, processos de patch e revisão por equipes de segurança.
Ao mesmo tempo, estudos de caso selecionados não estabelecem taxas universais de falsos positivos ou sucesso em todos os repositórios de código.
A Microsoft lançou o Project Perception como um sistema de segurança de agentes em maior escala.
O objetivo é passar de uma IA que auxilia defensores para uma IA capaz de assumir mais fluxos de trabalho de segurança, mantendo os julgamentos críticos sob controle humano.
O Project Perception coordena três categorias de agentes:
| Categoria de agente | Responsabilidade principal |
|---|---|
| Agente vermelho | Simula o raciocínio do atacante, identifica possíveis caminhos de invasão |
| Agente azul | Conduz investigações, raciocina com base no contexto, detecta e faz triagem de riscos significativos |
| Agente verde | Corrige, fortalece sistemas e reduz a superfície de exposição |
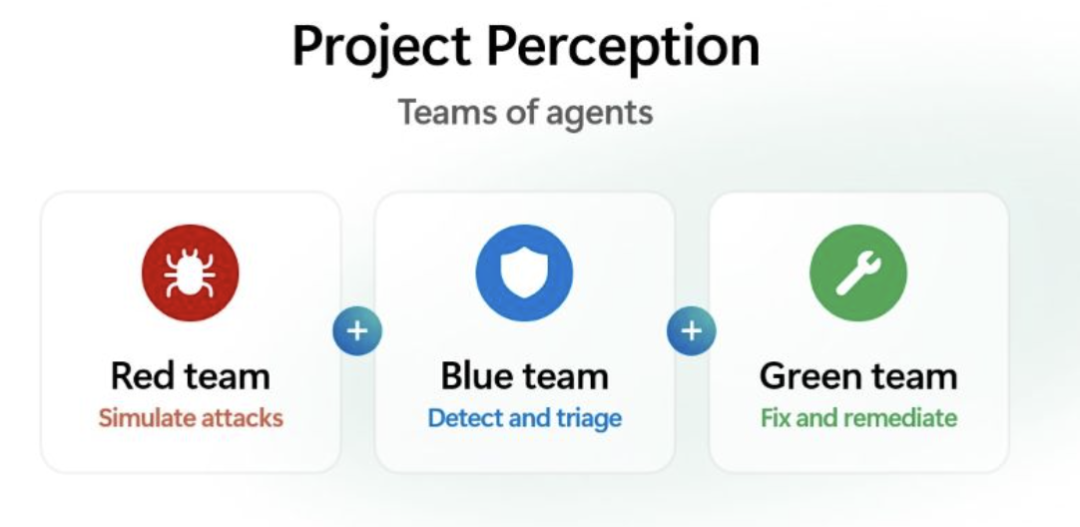
Esses três papéis formam um ciclo:
Agente vermelho descobre caminhos
→ Agente azul valida e prioriza
→ Agente verde realiza a correção
→ O sistema observa os resultados
→ As defesas futuras são aprimoradas
A Microsoft afirma que o Project Perception entrou em pré-visualização pública em 3 de agosto de 2026.
A Microsoft descreve o sistema como múltiplas camadas interconectadas.
O sistema observa endpoints, identidades, nuvem, aplicativos e outras partes dos ativos digitais.
Sinais brutos são convertidos em uma representação correlacionada de ativos, identidades, relacionamentos, políticas, riscos, atividades e eventos históricos.
A plataforma adota uma estratégia de múltiplos modelos, incluindo modelos especializados em rede como o MAI-Cyber-1-Flash.
A estrutura de orquestração coordena modelos, agentes, ferramentas, fluxos de trabalho, testes, permissões e controles.
Agentes vermelhos, azuis e verdes executam trabalhos especializados de segurança.
Executores convertem decisões em ações concretas nos produtos de segurança integrados.
A arquitetura é mais ampla do que um chatbot. Ela foi projetada para formar um sistema operacional de segurança em execução contínua.
Os humanos continuam responsáveis pelas decisões críticas
A Microsoft deixa claro que os humanos ainda controlam as operações de alto impacto.
A sua página do Project Perception descreve a divisão de responsabilidades da seguinte forma:
Os agentes fazem o trabalho.
Os humanos fazem os julgamentos.
Os defensores definem objetivos, estratégias, limites de proteção, requisitos de aprovação, âmbitos e prioridades de resposta.
Operações de alto impacto ainda exigem aprovação humana.
Isto é necessário porque a própria correção de segurança pode causar danos.
Sistemas automatizados podem desativar contas legítimas, bloquear tráfego de produção, apagar arquivos críticos,
isolar um sistema de negócios, implementar correções defeituosas ou interromper operações.
O custo de uma ação errada pode ser maior do que o custo de um falso negativo.
A Microsoft descreve o Security Copilot como uma interface conversacional assistida por IA.
O Project Perception é posicionado como um sistema de agentes mais amplo.
| Conceito do produto | Papel |
|---|---|
| Security Copilot | IA que oferece assistência através de uma interface generativa |
| Project Perception | Agentes de IA que raciocinam e agem continuamente em fluxos de trabalho de segurança |
Estes dois produtos foram concebidos para trabalhar em conjunto.
Os humanos podem usar o Copilot para compreender e orientar o trabalho, enquanto os agentes do Perception assumem mais processos operacionais contínuos.
A Microsoft afirma que o Project Perception utiliza preços baseados no consumo, medidos em Unidades de Computação de Segurança (SCUs).
Diferentes agentes consomem recursos diferentes consoante a intensidade das tarefas.
Isto torna a eficiência dos modelos e dos fluxos de trabalho economicamente crucial.
Simulações de red team, tarefas de triagem rápida e fluxos de trabalho de remediação de longo prazo podem consumir recursos diferentes.
A estratégia de roteamento multi-modelo utilizada no MDASH alinha-se com este modelo de preços mais amplo.
Se o trabalho rotineiro puder ser tratado por modelos especializados mais pequenos, o mesmo orçamento pode cobrir mais proteções de segurança.
O acesso a modelos de ponta está a tornar-se menos escasso.
As organizações conseguem cada vez mais chamar modelos públicos poderosos através de APIs.
O que pode ser escasso é o sistema capaz de determinar se as alegações de segurança de um modelo são verdadeiras.
Este sistema necessita de ambientes executáveis, infraestrutura de construção, controlo de versões, geração de provas, comparação de correções, conhecimento de segurança, sandboxes, deduplicação, revisão humana e rastreio de evidências.
No domínio da segurança, explicações bonitas sem evidências muitas vezes não são suficientes.
A fortaleza passa de:
Acesso a modelos poderosos
para:
Processos confiáveis que validam e implementam o trabalho dos modelos
Não use automaticamente o modelo mais caro para todas as operações.
Crie conjuntos de avaliação para determinar quais tarefas podem ser tratadas de forma fiável por modelos especializados mais pequenos.
Um agente ou modelo pode gerar resultados candidatos. Outro agente, ferramenta ou teste determinístico deve validá-los.
Sempre que possível, exija testes reproduzíveis em vez de aceitar afirmações textuais.
Priorize a automatização da recolha, análise e validação. Mantenha operações destrutivas ou que afetem a produção atrás de portões de aprovação.
O preço do token por si só não é a métrica correta.
Um modelo barato que gera muitos falsos positivos pode ser mais caro a nível operacional.
Métricas úteis incluem custo por vulnerabilidade confirmada, tempo de validação, taxa de falsos positivos, tempo de revisão humana, taxa de aceitação de correções e taxa de regressão.
As gerações de modelos mudam rapidamente.
Mantenha as definições de tarefas, ferramentas, validação e controlos de segurança reutilizáveis quando o modelo subjacente é substituído.
Registe os resultados, não apenas os alertas.
O sistema deve aprender quais descobertas são reais e quais medidas de correção são eficazes.
O repositório do CyberGym alerta para não expor os seus serviços à internet pública.
A Microsoft também descreveu ambientes de sandbox e isolamento de rede para testes.
A reprodução de vulnerabilidades deve ocorrer em infraestrutura controlada.
Uma avaliação séria não deve incluir apenas uma pontuação principal.
A pontuação de 95,95% é importante, mas não deve ser generalizada para além do âmbito das evidências.
O resultado é produzido pelo MDASH, vários agentes, dois níveis de modelos, ferramentas e dados.
O resultado foi publicado pela Microsoft. A validação por reprodução independente continua a ser valiosa.
O CyberGym mede uma tarefa bem definida de reprodução de vulnerabilidades.
O comportamento de falsos positivos em ambientes de produção precisa de ser medido separadamente.
A Microsoft mantém a aprovação humana para operações críticas.
O MAI-Cyber-1-Flash está limitado a clientes aprovados do MDASH em pré-visualização privada.
Os resultados podem variar consoante a linguagem, categoria de vulnerabilidade, base de código, ferramentas e estrutura de benchmark.
O MDASH é o sistema multi-modelo e multi-agente da Microsoft para identificar, validar, priorizar e corrigir vulnerabilidades de software. Combina agentes especializados, múltiplos modelos, ferramentas de análise de código, geração de provas de validação, verificação e controlos de segurança empresariais.
O MAI-Cyber-1-Flash é o modelo MoE esparso especializado em cibersegurança da Microsoft. A ficha oficial do modelo mostra 137 mil milhões de parâmetros totais, 5 mil milhões de parâmetros ativos, um contexto de 256K e acesso controlado.
Está disponível através do MDASH na pré-visualização privada do Azure AI Foundry.
Não. O resultado de 95,95% pertence à configuração completa do MDASH, que utiliza MAI-Cyber-1-Flash, GPT-5.4, agentes, ferramentas, dados e processos de validação. Os resultados independentes da ficha do modelo da Microsoft em outros benchmarks de rede são diferentes e mais baixos.
A Microsoft afirma que o MAI-Cyber-1-Flash foi concebido para lidar com até 90% das tarefas em fluxos de trabalho roteados do MDASH. Isso não significa que o modelo descubra ou corrija sozinho 90% de todas as vulnerabilidades.
O CyberGym avalia principalmente se o agente consegue gerar uma prova de conceito (PoC) reproduzível de uma vulnerabilidade real conhecida, com base na descrição da vulnerabilidade e no código-fonte anterior à correção. Esta PoC é testada contra a versão vulnerável e a versão corrigida.
A pontuação foi publicada pela Microsoft no seu anúncio e ficha do modelo. No momento descrito no artigo original, o resultado ainda não tinha aparecido como resultado atualizado em rankings públicos de benchmarks, pelo que deve ser descrito como dados autorreportados pela Microsoft.
Não há registo de transferência pública do modelo. A Microsoft afirma que o modelo está disponível apenas através da pré-visualização privada do Azure AI Foundry para MDASH selecionados.
Fornecido pelo cliente e sujeito a revisão e aprovação.
O Project Perception é o sistema de segurança agêntica mais amplo da Microsoft. Ele coordena agentes vermelhos, agentes azuis e agentes verdes, cobrindo fluxos de trabalho de detecção, investigação, correção e fortalecimento, enquanto mantém as decisões críticas sob responsabilidade humana.
com/en-us/security/blog/2026/05/12/defense-at-ai-speed-microsofts-new-multi-model-agentic-security-system-tops-leading-industry-benchmark/: Visão geral técnica da Microsoft sobre a estrutura, arquitetura de validação, pesquisa de segurança e resultados iniciais do CyberGym.
A Microsoft relatou que, após integrar o MAI-Cyber-1-Flash e rotear os casos mais difíceis para o GPT-5.4, o MDASH alcançou uma taxa de sucesso de 95,95% no CyberGym. A empresa também relatou uma redução de 50% nos custos em comparação com a configuração de modelo mais forte anterior.
O resultado não pertence a um único modelo. Ele vem de um sistema de segurança multi-modelo que inclui mais de 100 agentes, dados históricos de segurança, ferramentas dedicadas, geração de provas, validação, deduplicação, sandboxes e orquestração projetada por humanos.
O CyberGym testa principalmente a capacidade de reproduzir vulnerabilidades conhecidas a partir de descrições e código anterior ao patch. Portanto, a pontuação demonstra um forte desempenho de reprodução de vulnerabilidades nesse benchmark, e não descoberta genérica de vulnerabilidades de dia zero ou taxas de correção autônoma.
O Project Perception estende a mesma filosofia de sistema para além da varredura de código: agentes vermelhos expõem riscos, agentes azuis investigam riscos, agentes verdes corrigem riscos, enquanto as decisões críticas permanecem sob controle humano.
A principal conclusão é que a vantagem em segurança cibernética de ponta está se deslocando da obtenção de um único modelo poderoso para a capacidade de rotear, validar e operar múltiplos modelos dentro de um sistema de segurança confiável.
Comece com uma frase e tenha um site completo em minutos.



