For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
O MiniCPM-V 4.7 leva um modelo de mistura de especialistas de 35 bilhões de parâmetros a dispositivos locais, incluindo celulares. A ModelBe...

O MiniCPM-V 4.7 leva um modelo de mistura de especialistas de 35 bilhões de parâmetros a dispositivos locais, incluindo celulares. A ModelBest e a OpenBMB relatam mais de 13 tokens gerados por segundo com cerca de 3 GB de memória em um iPhone 17 Pro Max, usando uma pilha de implantação otimizada.
Esse número precisa de contexto. Ele não significa que o modelo completo de 35B caiba em um download de 3 GB, nem que qualquer celular com 3 GB de RAM possa executá-lo na velocidade anunciada. O modelo transmite pesos de especialistas a partir do armazenamento e usa agendamento, quantização e otimizações de inferência para manter pequeno o conjunto de trabalho ativo.
A versão tem duas variantes principais:
| Variante | Design | Uso pretendido |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE com 35B de parâmetros totais e cerca de 3B ativos por token | Compreensão local mais robusta de imagens, documentos, múltiplas imagens e vídeos |
| MiniCPM-V 4.7 1B | Modelo denso pequeno; a QbitAI descreve aproximadamente 1,3B de parâmetros | Tarefas visuais com menos recursos, OCR e extração de documentos |
O modelo 35B-A3B é o primeiro MoE da série MiniCPM-V. O projeto anunciou o 4.7 em 12 de outubro de 2026, seguido pelos cabeçalhos de decodificação especulativa DSpark para ambas as variantes em 15 de outubro.
O repositório lista suporte de implantação para iOS, Android e HarmonyOS. Ele também descreve suporte em plataformas Intel, AMD, Arm, Rockchip e Houmo. O desempenho real depende do dispositivo, do formato do modelo, do backend de inferência e das configurações; portanto, o suporte a plataformas não deve ser interpretado como velocidade idêntica em todos os hardwares.
A tabela oficial de avaliação do 35B-A3B apresenta os seguintes resultados no modo Instruct:
| Benchmark | Compressão visual de 4× | Compressão visual de 16× |
|---|---|---|
| MMBench | 91,72 | 90,87 |
| MMStar | 80,67 | 80,13 |
| MMMU | 80,22 | 80,00 |
| MathVista | 88,00 | 87,30 |
| OCRBench | 91,20 | 90,40 |
| OmniDocBench v1.6 | 94,24 | 93,25 |
| Video-MME, sem legendas | 76,40 | 74,70 |
| LongVideoBench | 68,90 | 67,60 |

Fonte: OpenBMB, repositório MiniCPM-V. A tabela combina relatórios públicos com avaliações locais da equipe, usando checkpoints oficiais no modo Instruct.
A tabela mostra quedas relativamente pequenas em diversas tarefas ao passar para uma compressão visual mais forte. O MMBench cai 0,85 ponto, por exemplo, enquanto o OCRBench cai 0,80. Outras tarefas perdem mais; por isso, os desenvolvedores ainda precisam verificar se textos pequenos, gráficos ou detalhes visuais importam para sua própria carga de trabalho.
Esses são resultados de avaliação do modelo, não provas de que a configuração móvel reproduz todas as pontuações nem de que toda imagem enviada por usuários será interpretada corretamente. Eles são pontos de referência úteis para decidir o que testar.
O MoE reduz a computação ao ativar apenas especialistas selecionados para um token. Ele não elimina a necessidade de armazenar os demais especialistas, pois tokens e camadas posteriores podem escolher outros.
Em um celular com memória limitada, manter esses pesos na memória flash disponibiliza o modelo, mas esperar repetidamente pelo armazenamento pode tornar a decodificação lenta. Restringir o roteamento a um subconjunto fixo de especialistas reduz os carregamentos, porém altera quais especialistas o modelo pode usar. Em vez disso, o MiniCPM-V 4.7 tenta sobrepor carregamento e computação, preservando as decisões reais do roteador.
O Lookahead Expert Scheduling, ou LES, prevê quais especialistas a próxima camada provavelmente precisará e pré-carrega seus pesos. Quando o roteador real seleciona os especialistas, o mecanismo primeiro calcula os especialistas selecionados que já estão disponíveis enquanto carrega os demais necessários.
A previsão altera a ordem de preparação e execução. Ela não substitui a decisão de roteamento do modelo: especialistas não previstos ainda são carregados e avaliados quando selecionados. Essa distinção explica por que a técnica pode melhorar a velocidade sem depender de um conjunto de especialistas permanentemente reduzido.
O guia oficial combina LES com quantização detalhada por camada. Pesos menores dos especialistas reduzem o tráfego entre armazenamento e memória, enquanto um layout otimizado torna o carregamento mais eficiente. A equipe relata uma melhoria de cinco vezes na decodificação em dispositivos reais decorrente de seu trabalho de otimização no dispositivo; esse é um resultado para sua configuração testada, não um multiplicador universal.
O DSpark adiciona um modelo de rascunho que propõe tokens para o modelo principal verificar. A versão fornece cabeçalhos de rascunho dedicados para ambos os tamanhos. Esse é outro componente da pilha otimizada; portanto, não se deve presumir que um checkpoint padrão executado em um backend genérico atingirá a mesma velocidade.
No lado da visão, o modelo usa compressão antecipada dentro do codificador visual, com base no LLaVA-UHD v4. Mesclar tokens visuais antecipadamente reduz o trabalho nas camadas posteriores do codificador. As configurações selecionáveis de 4× e 16× expõem uma troca entre detalhe visual e custo de inferência.
A documentação oficial do aplicativo móvel oferece uma visão muito mais clara da implantação completa:
| Item da implantação móvel | Requisito ou tamanho documentado |
|---|---|
| Celular validado para o 35B-A3B | iPhone 17 Pro Max com 12 GB de RAM |
| RAM de dispositivo recomendada para a demonstração 35B-A3B | Pelo menos 12 GB |
| Download total do modelo 35B-A3B | Aproximadamente 16,6 GB |
| Armazenamento livre recomendado | Aproximadamente 17 GB para os arquivos do modelo |
| Armazenamento de especialistas | Diretório experts/ separado, contendo 40 fragmentos e um manifesto |
| Janela de contexto padrão da demonstração | 4K tokens |
O pacote móvel dividido é diferente de um GGUF padrão de modelo completo. Seu arquivo principal -les depende do diretório de especialistas correspondente, e o aplicativo verifica se os arquivos são consistentes. Janelas de contexto maiores aumentam a memória do cache KV, enquanto um cache menor de especialistas em dispositivos com menos RAM pode tornar a geração consideravelmente mais lenta.
Um número pequeno de memória de trabalho não elimina a necessidade de armazenamento local rápido e substancial.
O artigo da QbitAI mostra exemplos locais em celular e tablet e, depois, testes de API separados. Manter essa distinção é importante: um resultado de API não é prova de que a mesma tarefa foi executada offline no celular.
Na demonstração inicial no iPhone, o modelo examina o gráfico de Minard sobre a campanha russa de Napoleão. Ao ser questionado sobre a temperatura mais baixa e sua data, ele identifica −30° Réaumur em 6 de dezembro de 1812 e converte o valor para −37,5 °C usando °C = °Ré × 1.25.
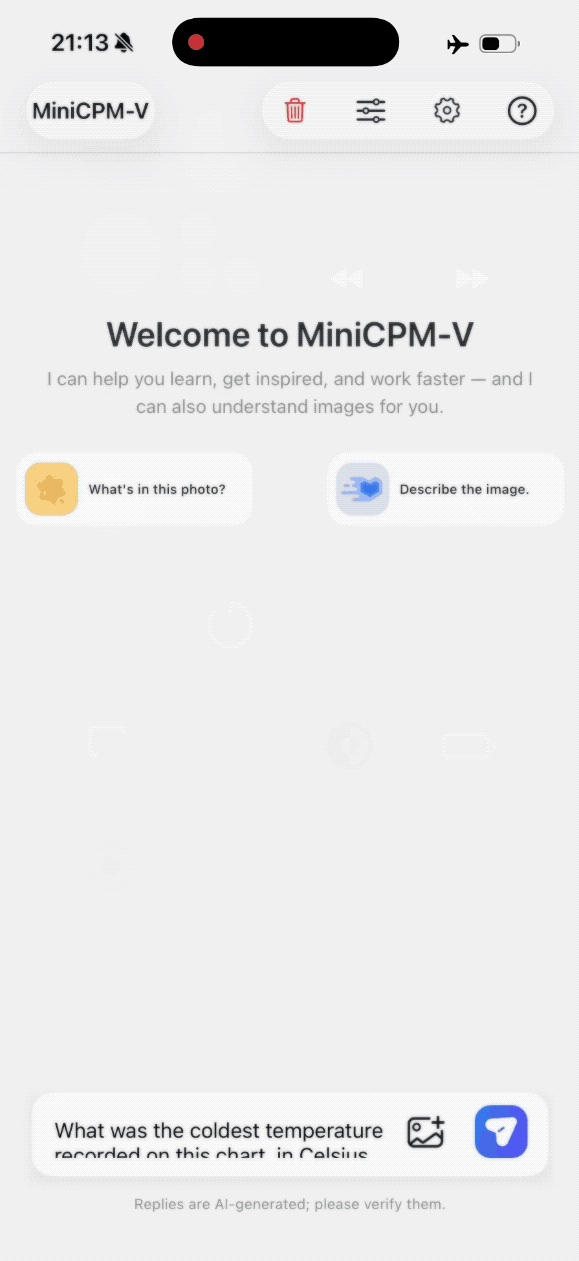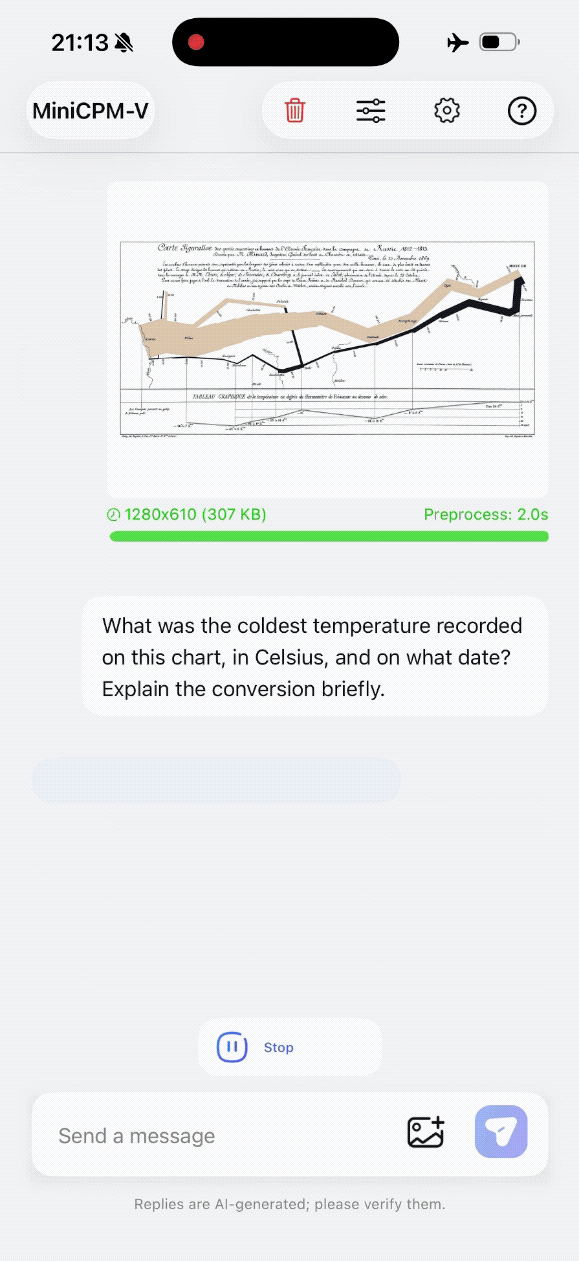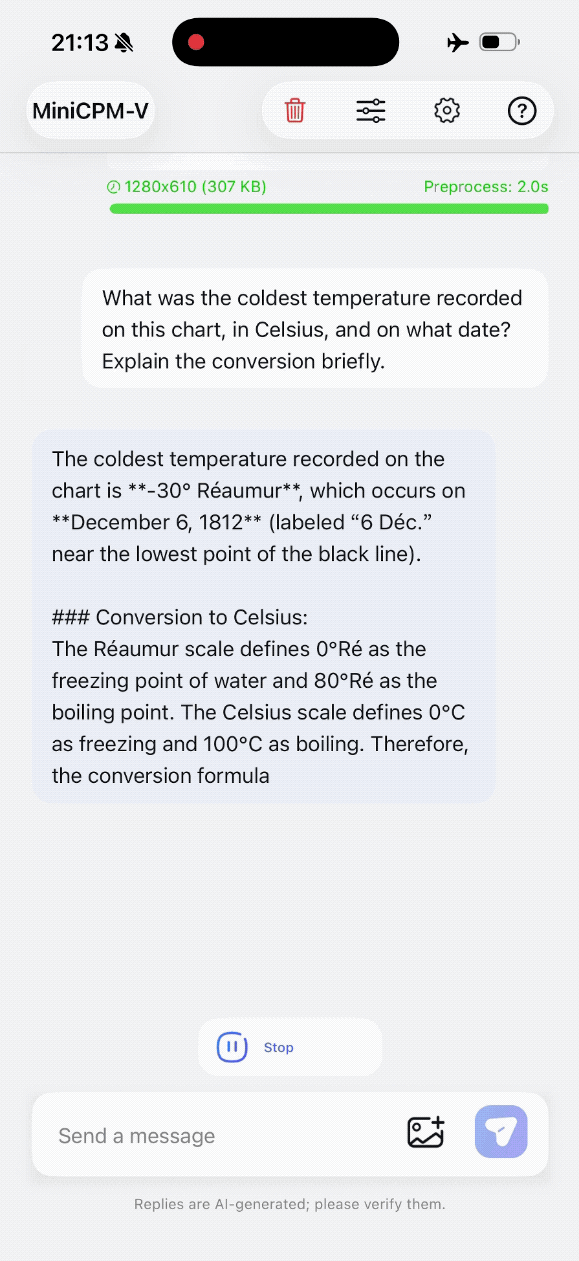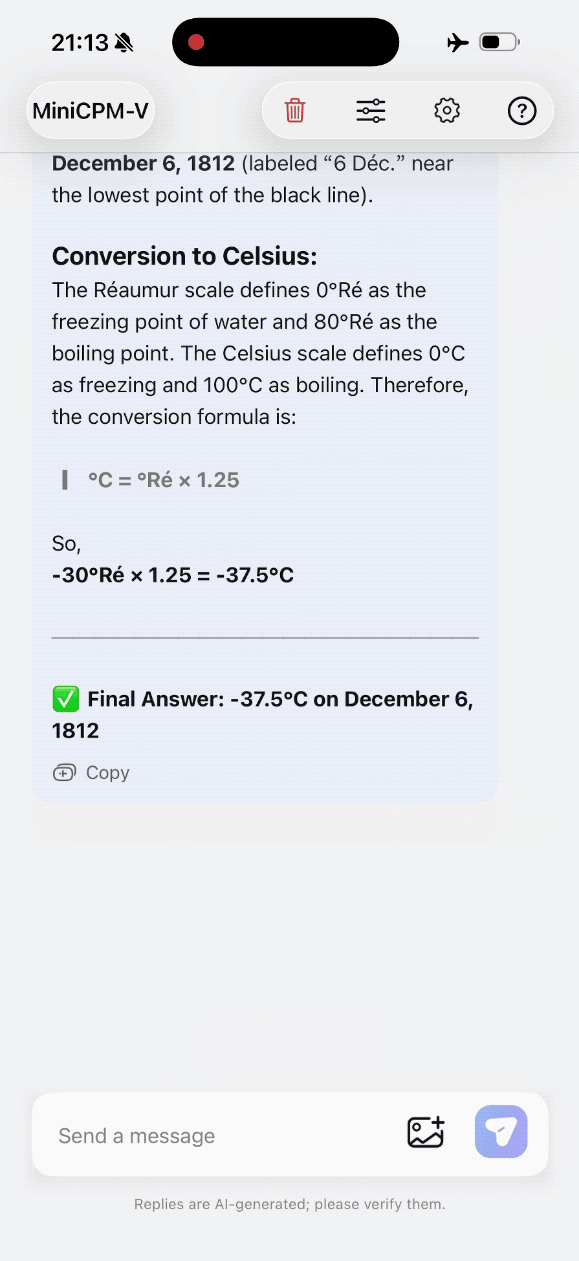
Fonte: QbitAI via BAAI; gravação animada da tela do celular. A fonte também relata a mesma resposta em um iPad M4.
Esse exemplo testa mais do que reconhecimento de texto. O modelo precisa ler o gráfico, associar uma data ao ponto relevante, reconhecer a escala de temperatura e aplicar uma conversão.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Outro exemplo combina potências de eletrodomésticos e tempos de uso com uma conta mensal de 420 kWh que custa ¥126. A saída relatada estima 213,63 kWh para os aparelhos listados, ou cerca de 50,9% da conta, e identifica a redução do uso do ar-condicionado como o melhor entre os três planos de economia propostos.
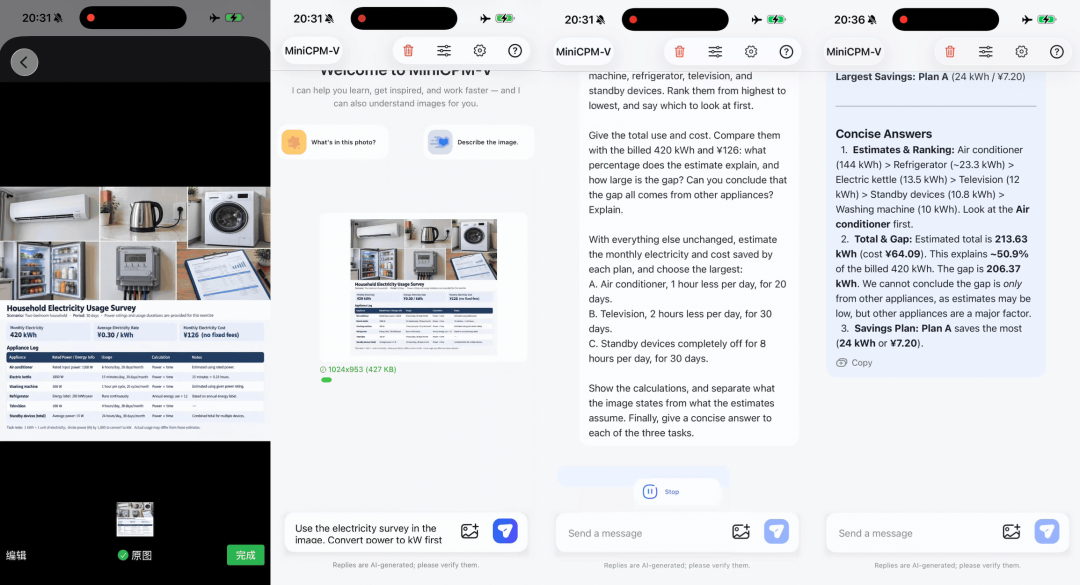
Fonte: QbitAI via BAAI. A resposta exibida trata o consumo não explicado como incerto, em vez de atribuí-lo automaticamente a outros aparelhos.
Essa ressalva é útil: horas estimadas, consumo real de energia e dispositivos omitidos podem afetar a comparação com a conta. Apenas um total aritmético correto não estabelece por que ocorreu o consumo restante.
O modelo menor é apresentado convertendo uma página de artigo em Markdown, incluindo títulos, uma tabela e notação matemática. A QbitAI relata que a demonstração levou menos de meio minuto.
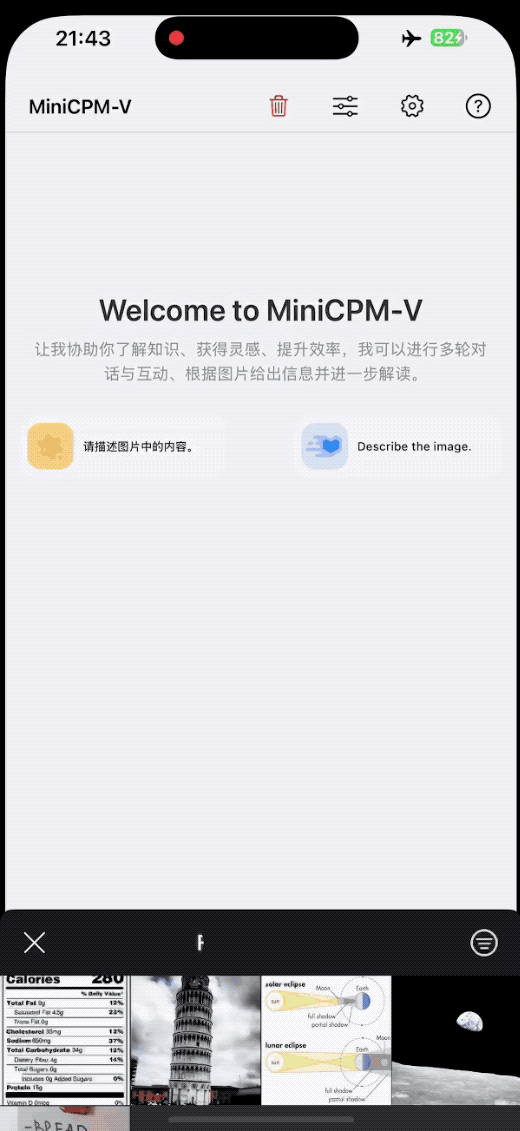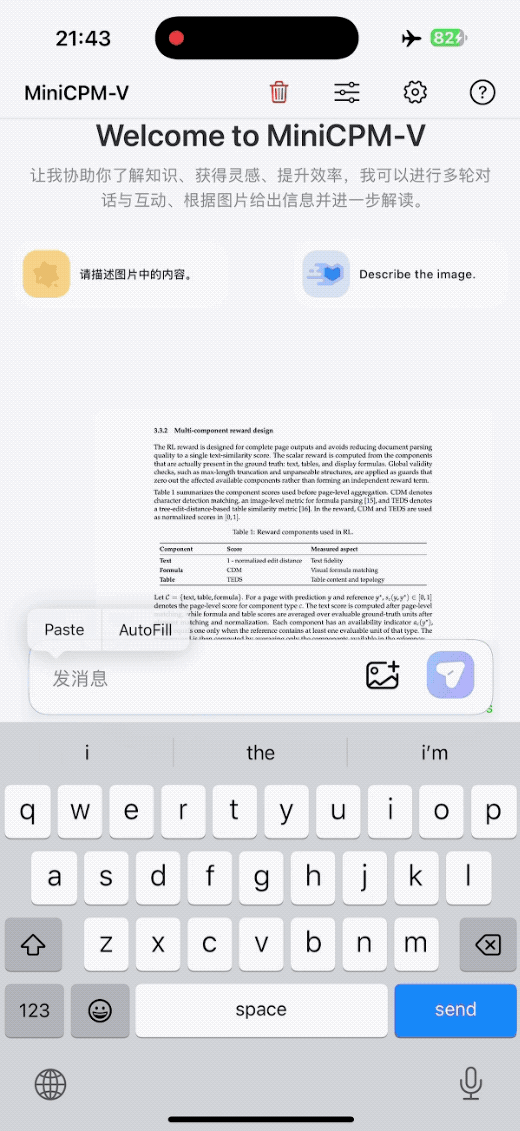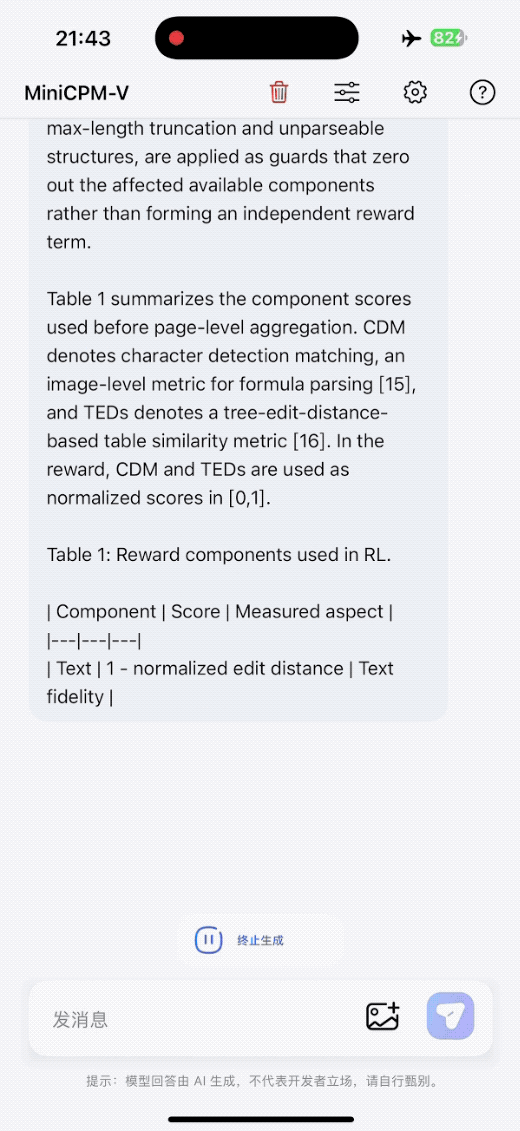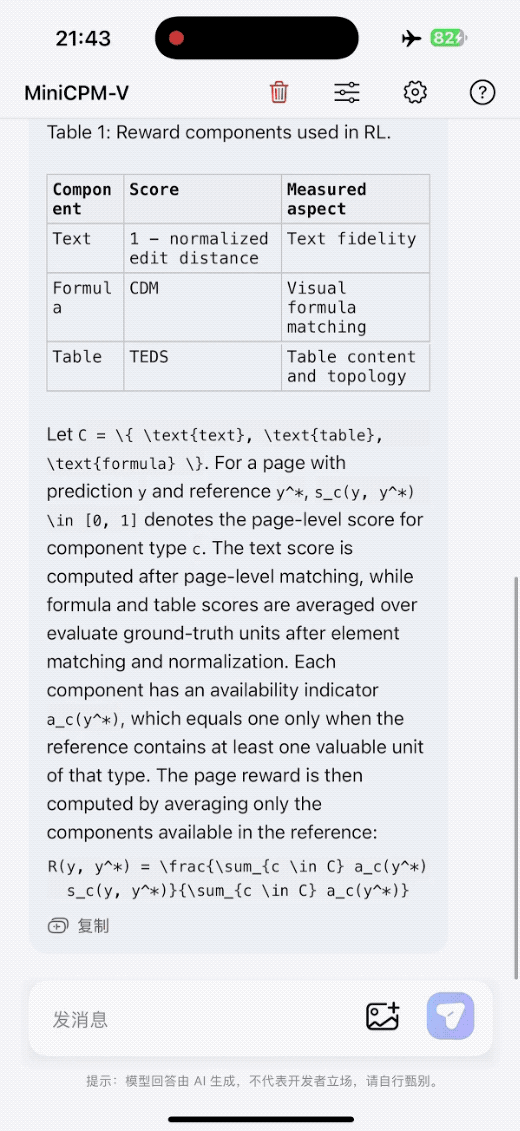
Fonte: QbitAI via BAAI; demonstração animada de documento local.
Em seus testes de API separados, o artigo relata um cálculo de recibo de ¥86,40 menos ¥8 em descontos, correspondendo a um pagamento de ¥78,40. Também descreve uma tarefa sobre regras de estacionamento que verifica uma permanência de 90 minutos em relação a restrições de limpeza, um limite de duas horas, isenções para residentes e condições de reentrada. Esses são testes ilustrativos, não um estudo sistemático de precisão.
Uma versão relacionada trata do esquecimento durante a personalização. O Self-Replay Fine-Tuning gera respostas de domínio geral a partir do modelo original, filtra-as por qualidade e mistura os exemplos retidos com os novos dados da tarefa durante o ajuste fino supervisionado padrão.
O método altera os dados de treinamento, não a arquitetura do modelo nem a função de perda. Exemplos de reprodução podem ser gerados antes do treinamento e reutilizados, reduzindo a necessidade de novas execuções online durante cada rodada.
A publicação da OpenBMB relata resultados encorajadores de retenção em experimentos de contagem e OCR de documentos, incluindo testes em modelos MiniCPM anteriores e outras famílias de modelos. Esses resultados não devem ser apresentados como garantia geral para todo ajuste fino do 4.7. Cobertura de prompts, qualidade da filtragem e a proporção entre tarefa e reprodução continuam sendo escolhas experimentais.
O repositório de aplicativos móveis fornece demonstrações para iOS, Android e HarmonyOS. Para o caminho MoE em celular, seu gerenciador de modelos no aplicativo baixa o arquivo principal correspondente, o projetor visual e os fragmentos de especialistas; o repositório alerta que arquivos GGUF comuns, não divididos e destinados a desktop não são intercambiáveis com esse pacote móvel.
Para outras implantações, o guia 4.7 lista SGLang, vLLM, llama.cpp e Ollama, além de SWIFT e LLaMA-Factory para ajuste fino. Ele também aponta para opções de quantização, incluindo GGUF, BNB, AWQ, GPTQ e FP8. Escolha o artefato para o runtime pretendido, em vez de tratar todos os formatos compatíveis como um modelo móvel intercambiável.
A inferência offline começa depois que os arquivos necessários do aplicativo e do modelo estão presentes localmente. Isso elimina a necessidade de enviar cada solicitação de inferência a um modelo em nuvem, enquanto permissões do aplicativo, tratamento de dados locais, armazenamento e desempenho do hardware continuam sendo considerações práticas de implantação.
É uma versão de modelo multimodal da ModelBest e da OpenBMB com variantes MoE 35B-A3B e 1B menor. Ele oferece suporte a tarefas que envolvem imagens, documentos, múltiplas imagens e vídeos.
O projeto demonstra uma implantação otimizada do 35B-A3B em um iPhone 17 Pro Max. Ele mantém um conjunto de trabalho menor na memória enquanto transmite especialistas do armazenamento local, em vez de carregar todos os 35B de parâmetros na RAM de uma vez.
Não. A demonstração móvel oficial lista um download total de aproximadamente 16,6 GB para o pacote 35B-A3B e recomenda cerca de 17 GB de armazenamento livre. O iPhone validado tem 12 GB de RAM do dispositivo.
Não. O LES prevê especialistas para pré-busca e agenda primeiro aqueles que já estão disponíveis. O roteador real do modelo ainda seleciona os especialistas a serem calculados, incluindo quaisquer especialistas que a previsão não tenha antecipado.
Sim. As demonstrações locais executam inferência no dispositivo depois que os arquivos necessários são baixados ou instalados. Os exemplos de API da fonte são testes separados e não devem ser confundidos com operação offline.
Não. A demonstração exige um pacote dividido correspondente com seu arquivo principal -les, projetor visual e fragmentos de especialistas. A documentação do aplicativo explica por que arquivos GGUF padrão de modelo completo não fornecem o mesmo comportamento de implantação em celular.
O MiniCPM-V 4.7 combina computação esparsa com transmissão de especialistas, agendamento antecipado, quantização e compressão visual para tornar um modelo multimodal maior prático em dispositivos locais selecionados. As demonstrações abrangem interpretação de gráficos, conversão de documentos e cálculos cotidianos, enquanto os benchmarks publicados fornecem pontos de partida para avaliação.
A principal restrição de implantação é a diferença entre memória de trabalho, RAM total do dispositivo e pesos armazenados. O resultado no celular é crível como uma configuração específica e otimizada, não como promessa de que um modelo completo de 35B cabe em 3 GB ou funciona igualmente bem em todos os dispositivos.
Comece com uma frase e tenha um site completo em minutos.