For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/minimax-m3-1-flash-api-pricing-benchmarks-c8e3fe1c.md.
A MiniMax lançou o M3.1 Flash com preços mais baixos por token e resultados divulgados mais fortes em raciocínio e tarefas de agentes. A cob...
A MiniMax lançou o M3.1 Flash com preços mais baixos por token e resultados divulgados mais fortes em raciocínio e tarefas de agentes. A cobertura do THE DECODER de 19 de outubro o posiciona com 42 pontos no Artificial Analysis Intelligence Index, em comparação com 29 do M3.
A distinção importante é entre o preço de um token e o custo de concluir uma tarefa. Um modelo pode ser mais barato nas duas métricas, mas o custo da tarefa também depende de quanto ele gera, da frequência com que tenta novamente e de o resultado ser utilizável.
A comparação do período de lançamento apresentada no relatório coloca o M3.1 Flash ao lado do GLM-5.3-Flash no índice composto, logo à frente do Gemini 3.8 Flash e atrás do DeepSeek V4.1 Flash 1017.
| Avaliação divulgada | M3.1 Flash | Comparação destacada no relatório |
|---|---|---|
| Artificial Analysis Intelligence Index | 42 | M3: 29; GLM-5.3-Flash: 42; Gemini 3.8 Flash: 41; DeepSeek: 45. |
| Humanity's Last Exam | 48% | DeepSeek: 43%. |
| CritPt | 22% | GLM: 15%; Gemini: 18%; DeepSeek: 24%. |
| Precisão no AA-Omniscience | 56% | GLM: 28%; DeepSeek: 43%. |
| Custo médio de avaliação por tarefa | Cerca de US$ 0,22 | DeepSeek: cerca de US$ 0,26. |
Estes são os números divulgados no momento da publicação. As configurações dos benchmarks, os snapshots e as revisões dos modelos são relevantes; a tabela não representa uma classificação universal para todas as cargas de trabalho.

Crédito do gráfico: Artificial Analysis, reproduzido pelo THE DECODER.
O relatório relaciona o menor custo por tarefa, em parte, ao menor consumo de tokens de saída. A comparação de aproximadamente 189 milhões contra 224 milhões de tokens de saída diz respeito aos totais dos benchmarks, e não à quantidade gerada por uma solicitação comum.
A MiniMax afirma separadamente que a inferência online é quase três vezes mais rápida e que os custos gerais de uso em tarefas de agentes foram reduzidos em 70% em relação ao antecessor. Essas medições da empresa não são iguais à comparação de custos da Artificial Analysis. Elas não devem ser combinadas em um único resultado de eficiência verificado de forma independente.
O relatório também cita uma taxa de alucinação de 93% no AA-Omniscience. Isso não significa que 93% de todas as respostas estavam incorretas, nem prevê a taxa de erro de um assistente implantado em tarefas arbitrárias.
A Artificial Analysis define essa taxa sobre as respostas não corretas: respostas incorretas divididas pela combinação de respostas incorretas, parciais e não tentadas. A métrica mede a tendência de fornecer uma resposta errada quando seria preferível admitir incerteza. Já a precisão contabiliza as respostas corretas entre todas as perguntas.
Essa distinção permite que um modelo tenha uma precisão factual comparativamente forte e, ao mesmo tempo, um tratamento ruim da incerteza. Em trabalhos sensíveis ao conhecimento, verifique as evidências e se o modelo consegue se abster de responder, em vez de depender apenas de uma pontuação composta.
O THE DECODER informa uma janela de contexto de até um milhão de tokens e suporte a entradas de texto e imagem. O suporte a entradas não deve ser confundido com geração de imagens: aceitar uma imagem não implica produzir uma.
O anúncio oficial da MiniMax confirma preços fixos por milhão de tokens:
| Categoria de token | Preço por um milhão de tokens |
|---|---|
| Entrada | US$ 0,15 |
| Saída | US$ 0,60 |
| Entrada em cache | US$ 0,015 |
O preço de cache se aplica a acertos de cache elegíveis, não a todos os tokens de entrada. Por exemplo, um milhão de tokens de entrada sem cache mais um milhão de tokens de saída custariam US$ 0,75 com essas tarifas publicadas, antes de quaisquer outras cobranças aplicáveis. Esse é um exemplo de custo de tokens, não uma estimativa típica de custo por tarefa.
A API, o M Plan e o MiniMax Code são as formas de acesso listadas no anúncio oficial. O THE DECODER informa 23 de outubro como a data planejada para o lançamento dos pesos abertos; a publicação da empresa analisada afirma que os pesos chegarão posteriormente, sem especificar essa data. Na preparação deste artigo, em 20 de outubro, um lançamento futuro não deve ser descrito como pesos já disponíveis para download.
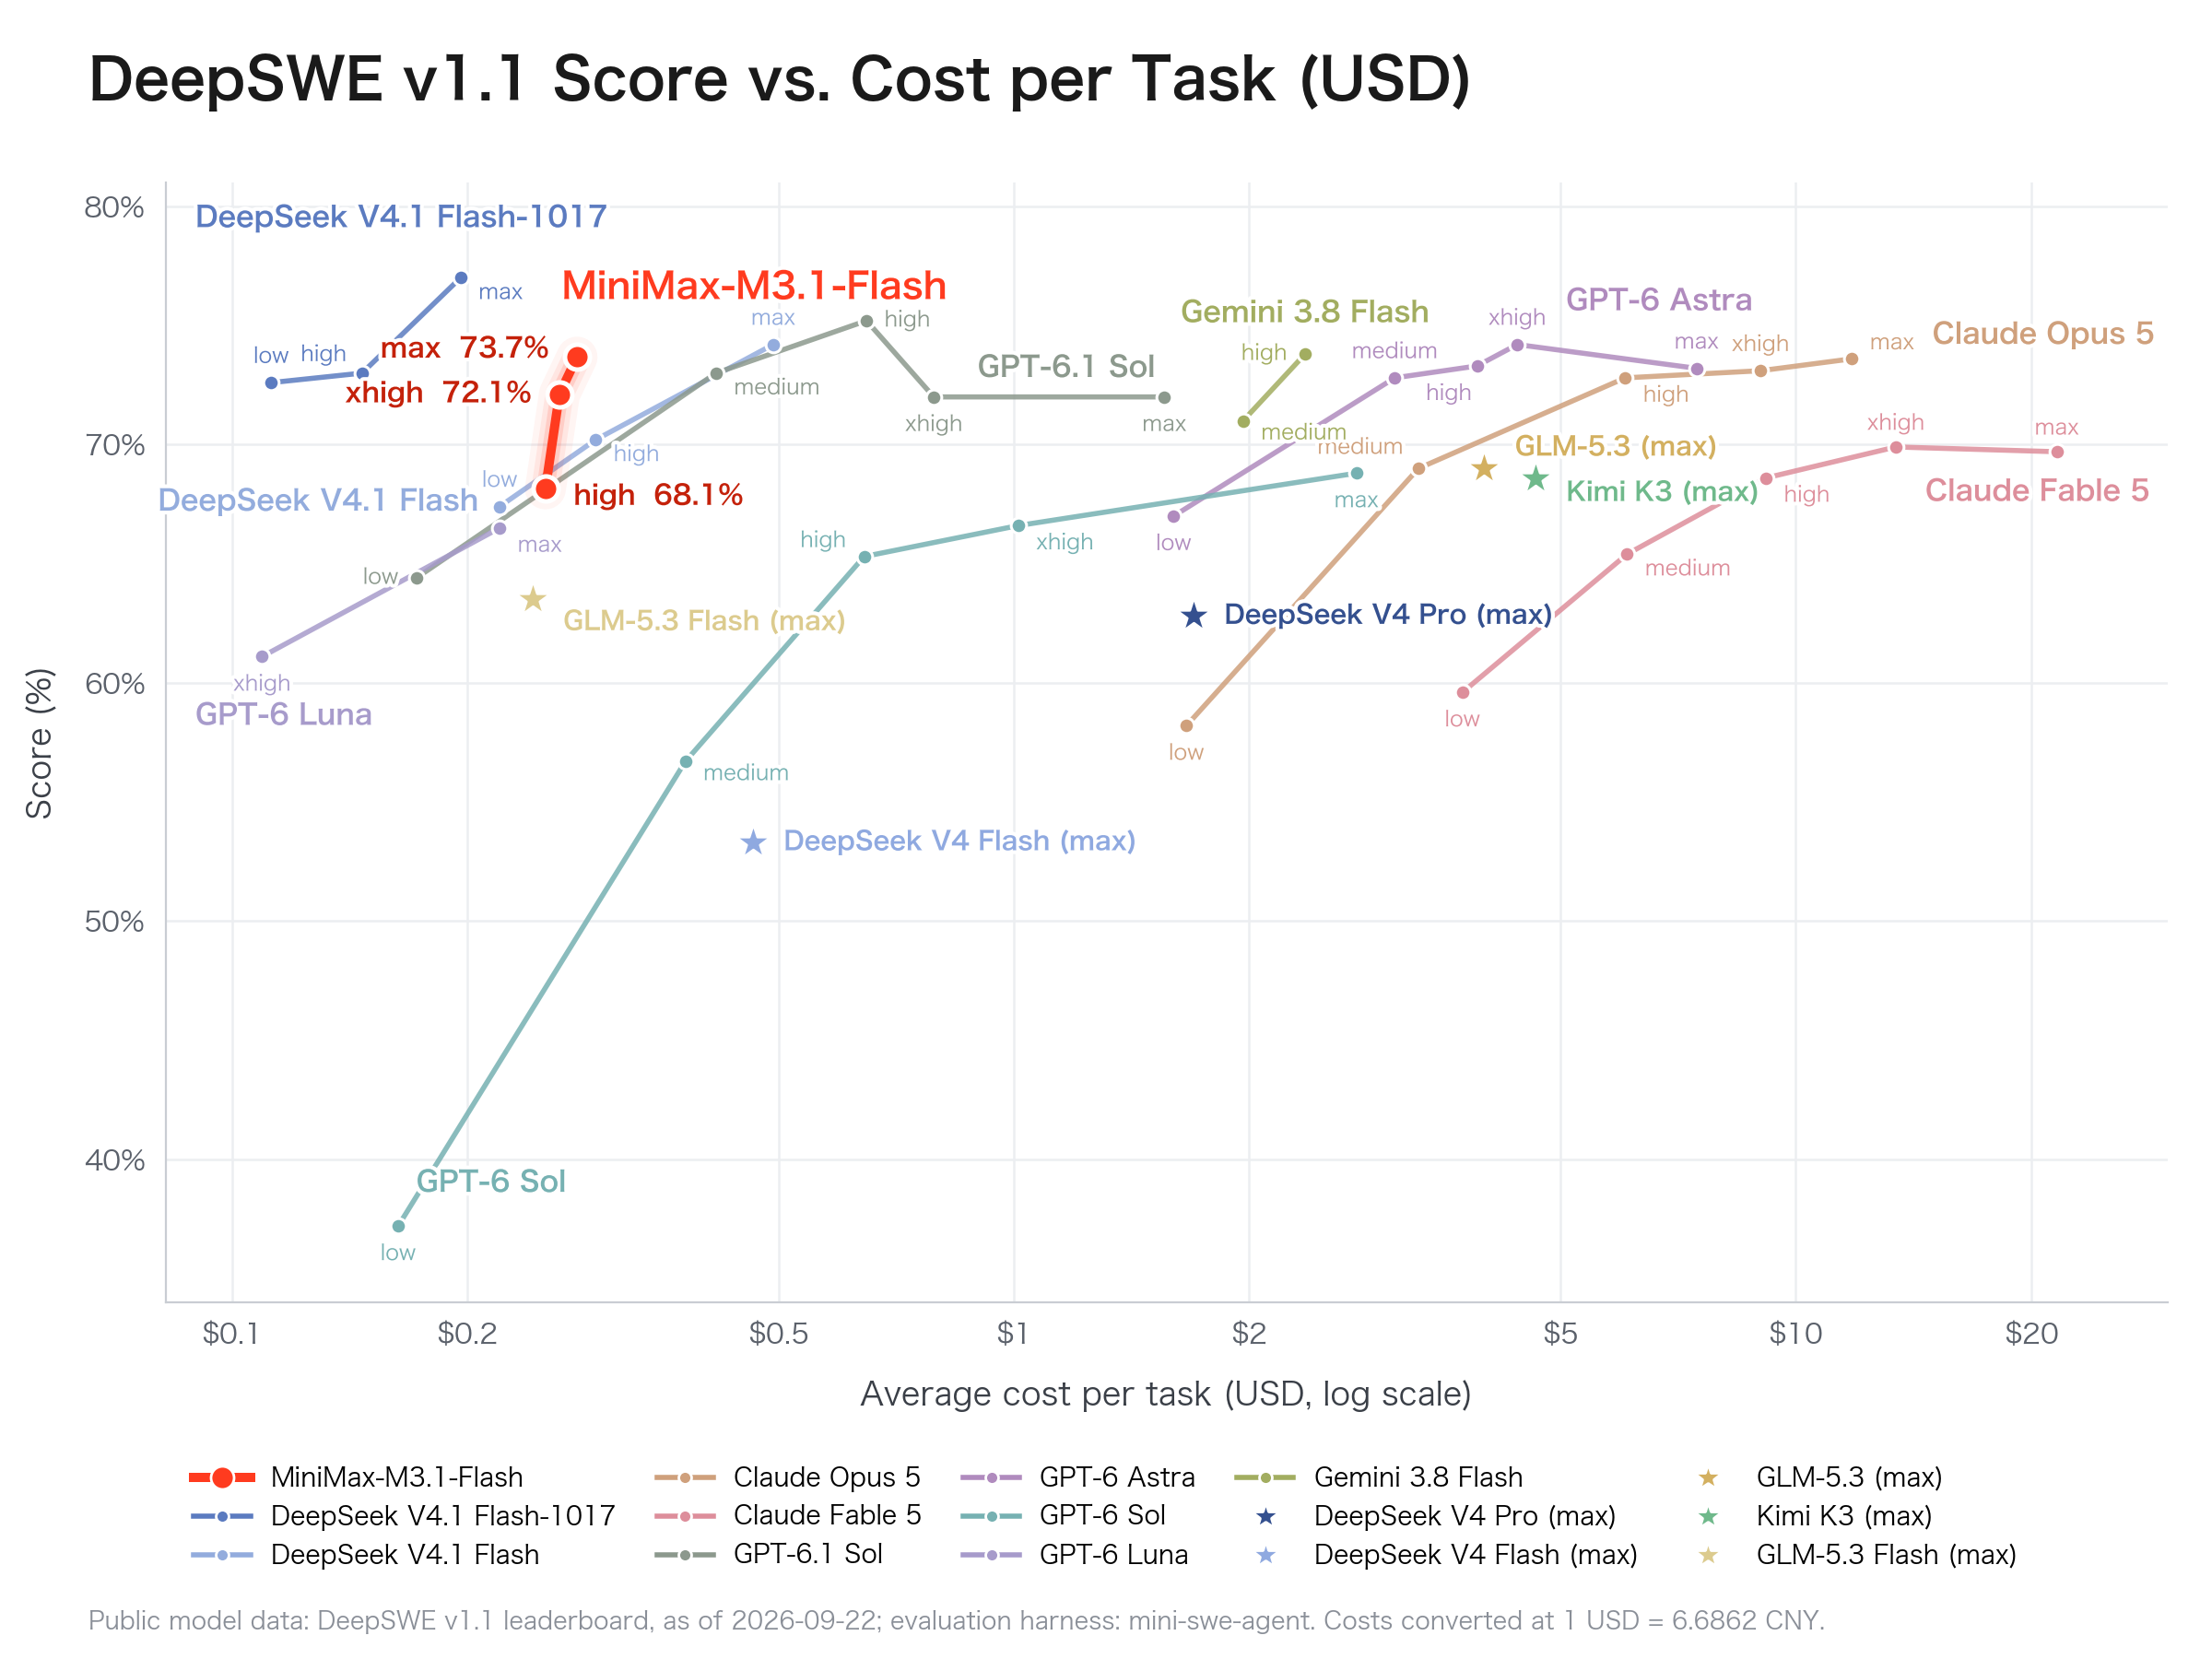
A MiniMax informa até 73,7% no DeepSWE v1.1, com custo por tarefa inferior a US$ 0,30 em seu gráfico. As configurações de menor esforço mostradas na mesma figura trocam parte da pontuação por um custo mais baixo.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Gráfico publicado pela empresa; a figura identifica o mini-swe-agent como o sistema de avaliação e informa a data dos dados de comparação.
Uma pontuação de programação reflete conjuntamente o modelo, as ferramentas, o nível de esforço e o ambiente de teste. Ela não significa que 73,7% dos chamados de uma organização serão resolvidos sem revisão ou que todas as tarefas custarão a média representada no gráfico.
A comparação final da fonte não aponta um único vencedor. O DeepSeek lidera no índice composto e na pontuação de física citada, enquanto a MiniMax lidera no resultado divulgado do Humanity's Last Exam e na precisão do AA-Omniscience.
O menor custo médio por tarefa da MiniMax nesse snapshot é uma evidência útil para avaliação, não uma razão para presumir que ela será a opção mais barata em todas as solicitações. Uma carga de trabalho com saídas mais longas, chamadas de ferramentas malsucedidas ou mais tentativas pode alterar a classificação.
O relatório também diferencia o status de lançamento: ele vincula um repositório existente de pesos do DeepSeek e descreve os pesos da MiniMax como futuros. Pesos abertos, uma assinatura de API e um aplicativo de programação para desktop são opções de distribuição distintas, com requisitos operacionais diferentes.
É o novo modelo Flash da MiniMax, disponível por meio de seus produtos hospedados e de sua API. O lançamento enfatiza raciocínio, tarefas de agentes, programação e eficiência de inferência.
O anúncio oficial lista US$ 0,15 para entrada, US$ 0,60 para saída e US$ 0,015 para entrada em cache por milhão de tokens. Confirme os preços atuais da conta e as regras de cache antes de estimar uma fatura de produção.
Não: esse é um custo médio de benchmark divulgado. Os custos reais dependem do tamanho do prompt, da saída gerada, do comportamento do cache, dos ciclos de ferramentas e das novas tentativas.
Não: o denominador da métrica contém respostas não corretas, e não todas as respostas. Ela trata de respostas incorretas em comparação com respostas parciais ou abstenções nessa avaliação.
As fontes analisadas os descrevem como futuros. O THE DECODER cita 23 de outubro, enquanto o anúncio da MiniMax não informa uma data exata; verifique o repositório e a licença reais quando forem lançados.
Os resultados divulgados se dividem entre os benchmarks. Escolha com base nas tarefas específicas, nos requisitos de confiabilidade e no custo total medido em sua própria avaliação.
O M3.1 Flash combina preços de token baixos, conforme divulgados, com resultados competitivos de raciocínio e programação. Sua vantagem de custo é mais significativa quando medida por tarefa concluída com sucesso e sob configurações comparáveis.
Leia as definições dos benchmarks, separe as alegações da empresa das medições externas e verifique a disponibilidade real dos pesos antes de planejar a implantação.
Comece com uma frase e tenha um site completo em minutos.



