
A MiniMax lançou o M3.1 Flash em 19 de outubro, pouco depois do DeepSeek V4.1 Flash-1017. O artigo fornecido compara os dois modelos por meio de gráficos de pontuação versus custo em tarefas de programação e agentes, nos quais modelos relativamente baratos se aproximam de sistemas mais caros em avaliações específicas.
A abordagem de “DeepSeek primeiro, MiniMax depois” diz respeito a uma comparação específica de custo-desempenho em programação. Ela não deve ser interpretada como uma classificação válida para todas as tarefas, versões de modelo ou configurações de implantação. A pergunta mais útil é qual configuração conclui o trabalho de forma confiável a um custo total aceitável.
Resultados de programação e fluxos de trabalho empresariais com agentes
Os materiais de lançamento da MiniMax informam 73,7% no DeepSWE v1.1, uma avaliação que envolve compreensão de repositórios, desenvolvimento, correções e testes. A tabela da fonte posiciona o DeepSeek V4.1 Flash-1017 em 77,0, o GPT-5.6 Sol em 73,0 e o Opus 5 em 74,0 nessa comparação.
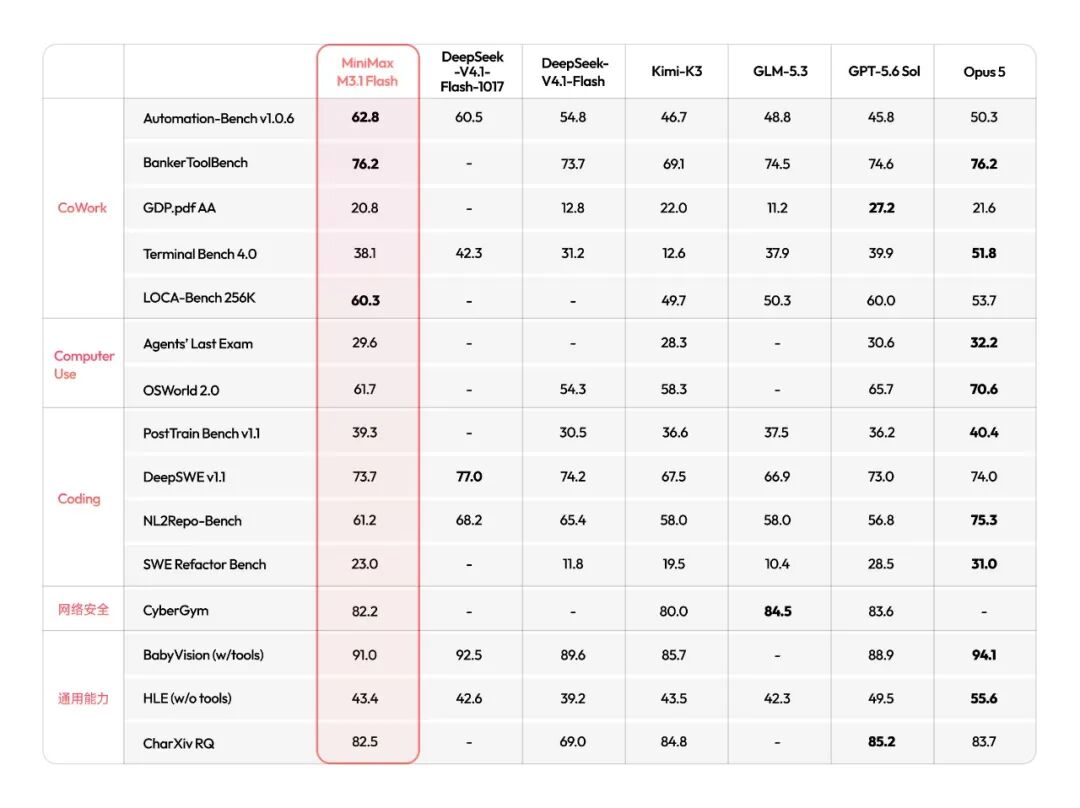
Comparação da empresa reproduzida por Xinzhiyuan; as versões dos modelos e as condições de avaliação são importantes.
O gráfico de custos mostra o M3.1 Flash próximo da extremidade de baixo custo em sua pontuação informada, enquanto o DeepSeek Flash-1017 aparece à frente nessa comparação representada. Diferentes níveis de esforço aparecem como pontos separados, portanto, selecionar uma configuração pode alterar tanto o custo quanto o resultado.
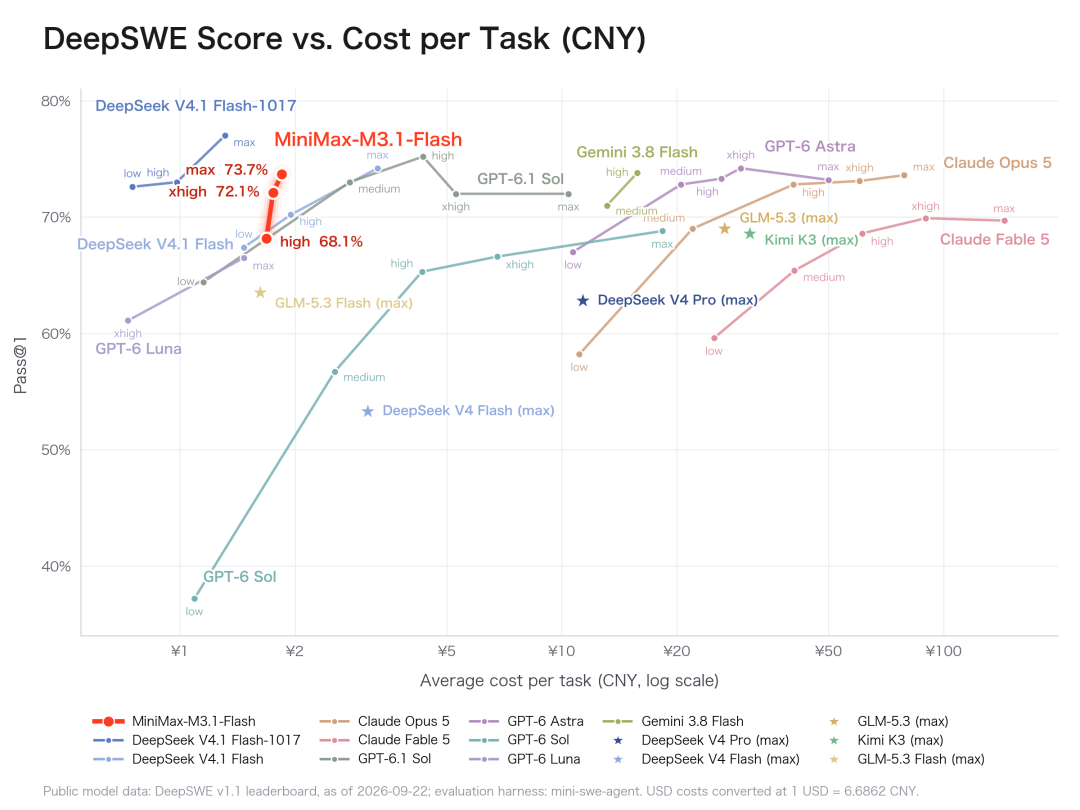
Uma média inferior a CNY 2 nessa avaliação não é uma tarifa fixa para cada correção de bug. O consumo de tokens, as tentativas malsucedidas, o tamanho do repositório e o uso de ferramentas podem alterar o custo de uma tarefa real.
Automação e uso de ferramentas
No Automation-Bench, o gráfico fornecido informa 62,8% no nível máximo de esforço. Ele posiciona o M3.1 Flash acima das outras configurações exibidas, incluindo um ponto da MiniMax com menor esforço que troca parte da pontuação por um custo mais baixo.
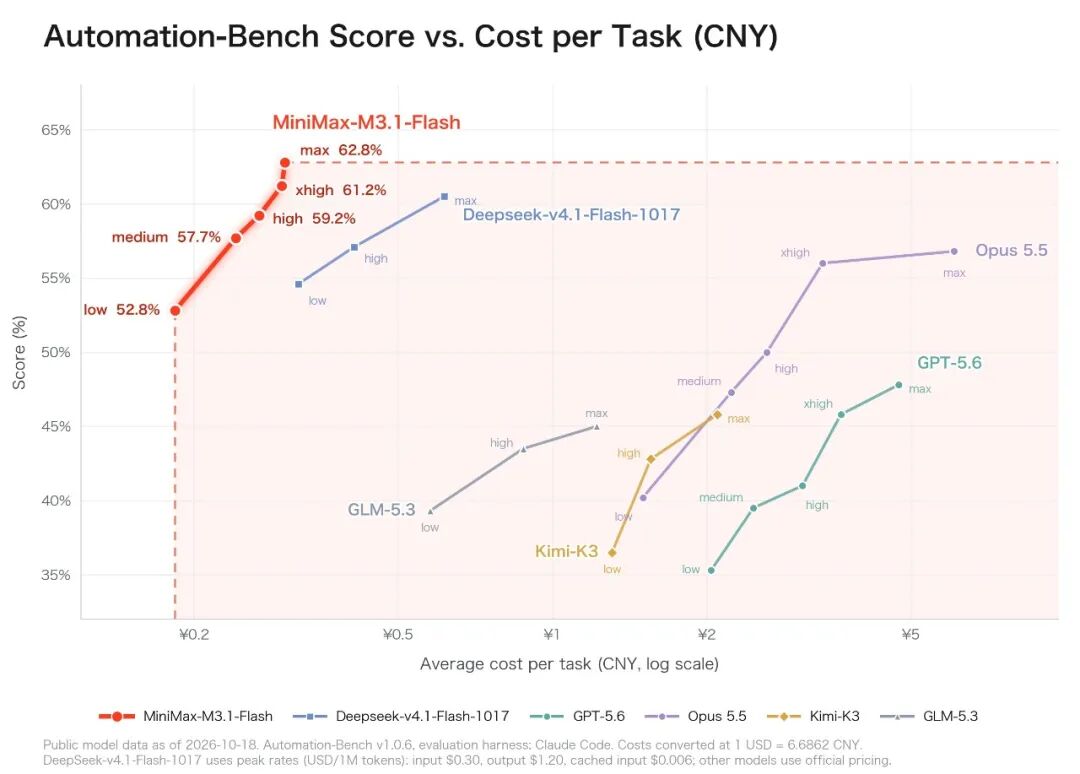
A fonte descreve fluxos de trabalho empresariais que abrangem ferramentas SaaS e funções de negócio. Um benchmark aproxima partes desse trabalho; ele não estabelece que um modelo terá sucesso em todos os processos reais de vendas, finanças ou suporte ao cliente.
Outras pontuações informadas pela MiniMax incluem:
| Avaliação | Pontuação do M3.1 Flash na fonte | Limite de comparação |
|---|---|---|
| LOCA-Bench 256K | 60,3. | Um pouco acima do valor de 60,0 do GPT-5.6 Sol exibido. |
| BankerToolBench | 76,2. | Empatado com o valor do Opus 5 nessa tabela. |
| CyberGym | 82,2. | Abaixo das pontuações exibidas do GLM-5.3 e do GPT-5.6 Sol; ainda competitivo nessa fotografia. |
| OSWorld 2.0 | 61,7. | Acima dos 54,3 exibidos para o DeepSeek V4.1 Flash; não é a maior pontuação entre todos os modelos listados. |
| Agents' Last Exam | 29,6. | Abaixo dos 30,6 do GPT-5.6 Sol e dos 32,2 do Opus 5. |
Esses são testes distintos, não números que possam ser calculados em uma média para produzir uma taxa universal de sucesso significativa sem uma metodologia explícita.
Uso de computador e a estimativa de CNY 739 do ALE
O anúncio oficial da MiniMax confirma as pontuações informadas de 61,7 no OSWorld V2 e 29,6 no Agents' Last Exam. A alegação de liderança entre os modelos chineses nesses testes está limitada à comparação e às condições de teste usadas no lançamento.
O gráfico de ALE da fonte estima CNY 739 para executar o conjunto completo de 152 tarefas, com uma taxa de aprovação de 29,6%. Ele não afirma que todas as tarefas foram aprovadas nem que o custo é por tarefa concluída com sucesso.
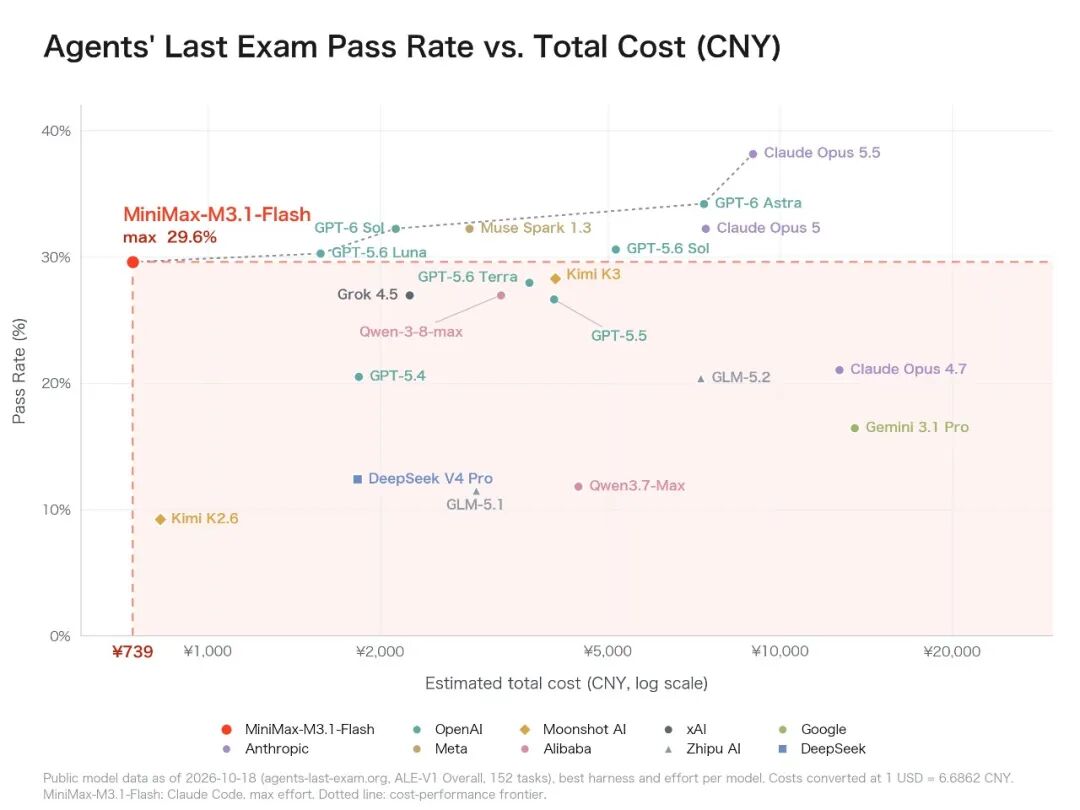
Dividir CNY 739 por 152 resulta em aproximadamente CNY 4,86 por tarefa tentada. Essa aritmética explica a escala do gráfico; ela não inclui os custos de integração, infraestrutura ou revisão humana de uma organização.
A fronteira pontilhada conecta configurações selecionadas com resultados favoráveis para os custos plotados. Seu formato depende dos modelos incluídos, da data da avaliação e das premissas de custo. Um ponto nessa fronteira é uma evidência comparativa útil, e não uma prova de que a mesma configuração será a mais barata para todas as cargas de trabalho.
Preços de tokens e cálculo do cache
O anúncio oficial em inglês da MiniMax lista tarifas fixas por milhão de tokens de US$ 0,15 para entrada, US$ 0,60 para saída e US$ 0,015 para entrada em cache. O artigo em chinês fornecido apresenta uma tarifa em CNY de CNY 1 para entrada, CNY 4 para saída e CNY 0,10 para leituras do cache.
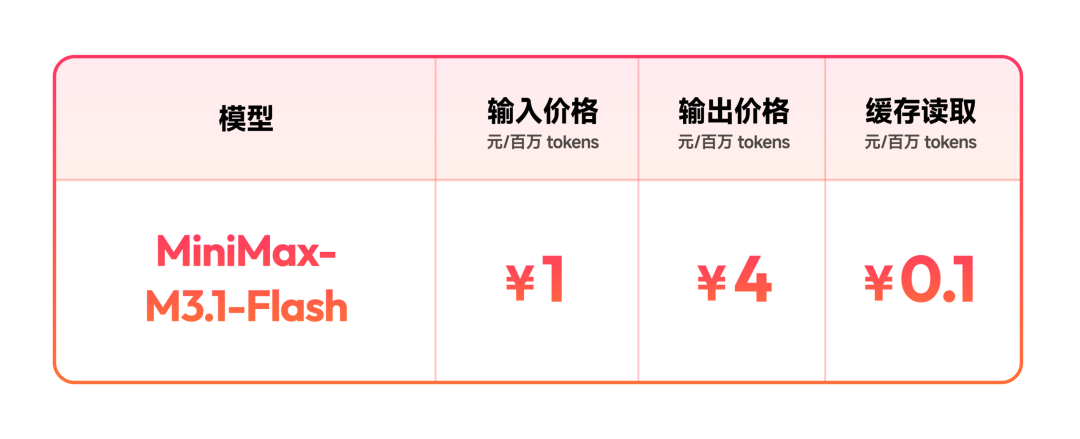
As duas tabelas de preços em moedas diferentes não devem ser tratadas como equivalentes exatos de câmbio em vigor. Use a tarifa da plataforma de cobrança e da conta efetivamente utilizadas.
A fonte compara a tabela da MiniMax em CNY com as tarifas de pico e fora de pico informadas para o DeepSeek. Seus exemplos com um bilhão de tokens de entrada podem ser verificados sob as premissas indicadas:
| Taxa de acerto do cache | Custo de entrada da MiniMax | Custo de entrada no pico do DeepSeek na fonte | Menor valor neste exemplo |
|---|---|---|---|
| 90% | CNY 190. | CNY 236. | MiniMax por CNY 46. |
| 95% | CNY 145. | CNY 138. | DeepSeek por CNY 7. |
| 99% | CNY 109. | CNY 59,60. | DeepSeek por CNY 49,40. |
Para a MiniMax com 90% de acertos, um bilhão de tokens de entrada corresponde a 1.000 unidades de um milhão de tokens: 100 × 1 + 900 × 0,10 = 190. Os tokens de saída estão excluídos desses exemplos que consideram apenas a entrada, assim como quaisquer cobranças não representadas pelas tarifas citadas.
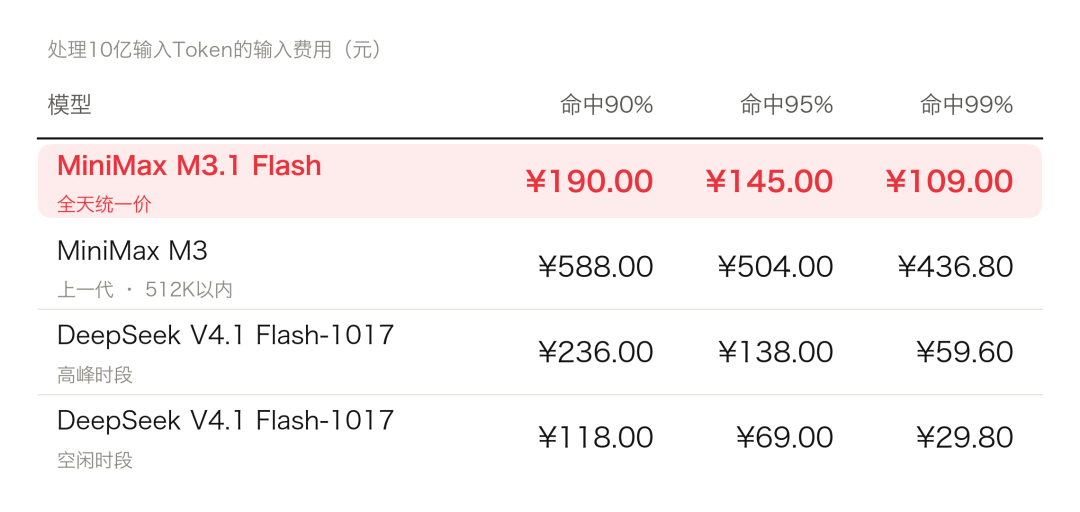
Isso também mostra por que um preço de entrada mais baixo sem cache não garante a menor fatura quando o cache domina o consumo. A extrapolação do artigo, de uma média de benchmark para 1.000 tarefas empresariais, é uma ilustração orçamentária, não uma cotação para executar essas tarefas em produção.
A MiniMax também afirma uma redução de 70% no custo geral de uso em tarefas de agentes em relação à sua antecessora. Essa afirmação sobre a carga de trabalho é diferente de uma simples redução do preço por token.
Velocidade de inferência, Space Bunny e configurações da API
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A empresa identifica o Space Bunny testado anonimamente como uma versão inicial do M3.1 Flash e afirma que ele processou mais de 200 trilhões de tokens. A empresa informa que a velocidade de saída alcança mais de 200 tokens por segundo, com velocidades medianas superiores a 170 tokens por segundo, além de uma inferência on-line quase três vezes mais rápida.
Essas são medições da empresa. Tokens por segundo medem a taxa de saída, enquanto o tempo para concluir uma tarefa com agente também inclui raciocínio, chamadas de ferramentas, espera, novas tentativas e testes.
O guia de invocação de modelos da MiniMax confirma uma janela de contexto de 1.000.000 de tokens e entradas de texto, imagem e vídeo. Aceitar essas entradas não significa que o modelo gere imagens ou vídeos.
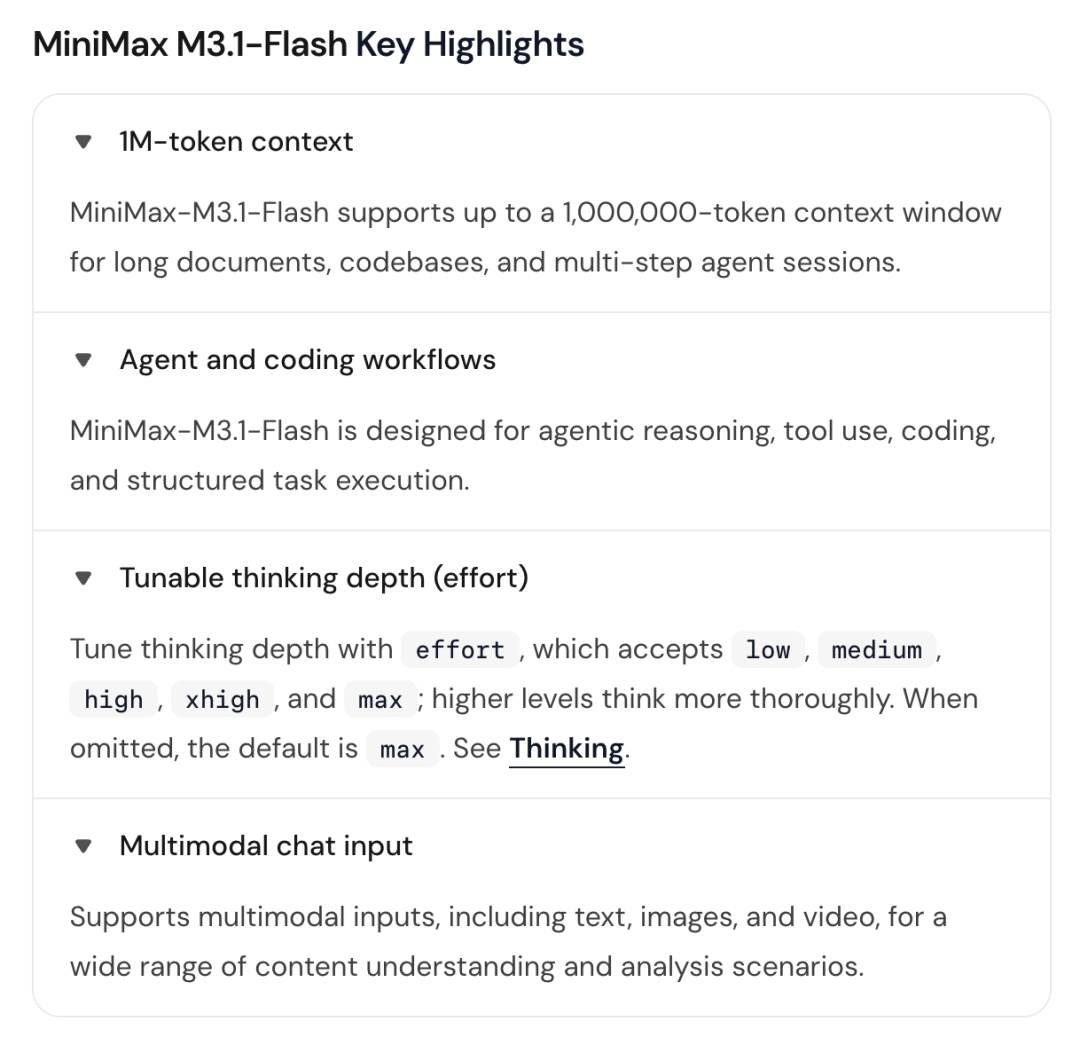
O guia confirma cinco níveis de raciocínio: low, medium, high, xhigh e max. Se a configuração for omitida, o padrão será max; o raciocínio não pode ser desativado. O campo da solicitação depende do protocolo:
| Protocolo | Campo de profundidade do raciocínio |
|---|---|
| Compatível com Anthropic | output_config.effort. |
| Chat Completions compatível com OpenAI | reasoning_effort. |
| OpenAI Responses | reasoning.effort. |
Esses nomes de campo não devem ser reunidos em um único parâmetro de nível superior chamado effort. O guia oficial afirma que níveis mais altos geralmente geram mais tokens de raciocínio e aumentam a latência; reduzir o esforço diminui esse trabalho, em vez de desativá-lo.
O acesso no lançamento inclui a API da MiniMax, o M Plan e o MiniMax Code. O anúncio afirma que os pesos do modelo serão disponibilizados posteriormente, portanto, este artigo não implica que uma versão auto-hospedável ou sua licença final já estivesse disponível no lançamento.
Os exemplos de cidade dobrável e pagode da fonte
A Xinzhiyuan descreve a conexão do modelo ao Codex e a solicitação de uma cidade dobrável interativa. Seu relato inclui um controle deslizante de dobragem, iluminação noturna e uma visualização que pode ser girada para inspecionar a cena.

Essa é uma demonstração do editor, não um novo teste realizado para este documento. A imagem ilustra uma saída selecionada sem estabelecer taxa de quadros, qualidade do código ou comportamento entre navegadores.
O artigo também reproduz o exemplo de pagode do desenvolvedor AJ, supostamente gerado em uma única chamada à API com o raciocínio máximo e aproximadamente 50.000 tokens. A afirmação de maior impacto visual é uma avaliação desse desenvolvedor, não uma comparação padronizada com o DeepSeek.
Como associar um modelo Flash ao trabalho
A comparação da fonte sugere pontos fortes diferentes: a posição do DeepSeek no gráfico de engenharia de software e os resultados sólidos da MiniMax em fluxos de trabalho empresariais. Essas distinções favorecem testar ambos em trabalhos representativos, em vez de depender de uma única classificação de destaque.
Acompanhe o sucesso após a revisão, o tempo decorrido, as novas tentativas e o gasto total. Uma tarifa menor por token é mais relevante quando o modelo consegue concluir a tarefa necessária sem gerar retrabalho suficiente para eliminar a economia.
A MiniMax também afirma que uma variante Pro será lançada posteriormente. Esse produto futuro deve permanecer separado do comportamento documentado do M3.1 Flash no lançamento.
Perguntas frequentes
O MiniMax M3.1 Flash é o segundo melhor no geral?
A classificação da fonte refere-se a uma comparação específica de pontuação versus custo em programação. Outras avaliações do artigo mostram classificações e empates diferentes.
Quais são os preços oficiais dos tokens em USD?
O anúncio da MiniMax lista US$ 0,15 para entrada, US$ 0,60 para saída e US$ 0,015 para entrada em cache por milhão de tokens. Verifique a plataforma de cobrança aplicável antes de elaborar um orçamento com base em uma tabela de preços em outra moeda.
O valor de CNY 739 do ALE significa que todas as tarefas foram aprovadas?
Não: trata-se de um custo estimado para uma execução completa de 152 tarefas tentadas. A taxa de aprovação informada é de 29,6%, e o valor exclui custos que não fazem parte das premissas do gráfico.
Quais entradas e qual tamanho de contexto o guia suporta?
O guia oficial lista entradas de texto, imagem e vídeo e até um milhão de tokens de contexto. A compreensão de entradas não implica geração de imagens ou vídeos.
O que acontece se a configuração de raciocínio for omitida?
A documentação afirma que o padrão é max. Use o campo específico do protocolo correto para escolher um nível inferior; o raciocínio não pode ser desativado.
Os pesos do modelo já estavam disponíveis no lançamento?
O anúncio de lançamento afirma que eles seriam disponibilizados posteriormente. O acesso à API hospedada e a promessa de disponibilização dos pesos são declarações distintas de disponibilidade.
Ferramentas relacionadas
- Plataforma da API da MiniMax: Acesso hospedado aos modelos da MiniMax e a serviços para desenvolvedores.
- MiniMax Code: Aplicativo de programação para desktop oferecido no anúncio de lançamento.
- M Plan: Modalidade de assinatura mencionada para o acesso à MiniMax.
- Repositório do DeepSeek Flash-1017: Repositório publicado do modelo usado na comparação.
Links relacionados
- Artigo fornecido no BAAI Hub: Fonte das comparações em CNY e dos exemplos ilustrados.
- Anúncio do M3.1 Flash da MiniMax: Preços oficiais de lançamento, formas de acesso e afirmações da empresa sobre benchmarks.
- Guia de invocação de modelos da MiniMax: Contexto, formatos de entrada e controles de raciocínio específicos de cada protocolo, verificados.
- Plataforma da API da MiniMax: Ponto de entrada oficial para desenvolvedores.
- Download do MiniMax Code: Produto para desktop vinculado pelo anúncio oficial.
- DeepSeek V4.1 Flash-1017: Repositório do modelo relevante para a comparação.
Resumo
O M3.1 Flash combina preços acessíveis por token com resultados competitivos, informados pela empresa, em programação, automação e uso de computador. Seu valor depende das configurações de esforço, do comportamento do cache e da capacidade de concluir o fluxo de trabalho real com um nível aceitável de retrabalho.
Use os gráficos de benchmark para decidir o que testar; depois, deixe os resultados bem-sucedidos, o tempo decorrido e a fatura total determinarem o modelo.


