For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
O lançamento do Muse Wonder pela Meta produziu dois tipos muito diferentes de evidência: resultados fortes em benchmarks e demonstrações de ...
O lançamento do Muse Wonder pela Meta produziu dois tipos muito diferentes de evidência: resultados fortes em benchmarks e demonstrações de desenvolvedores que, por vezes, foram muito menos convincentes. Uma reportagem chinesa da Xinzhiyuan, republicada no BAAI Hub, transforma essa diferença em uma crítica contundente à otimização focada em benchmarks.
A divergência merece análise, mas uma demonstração ruim não comprova fraude. Uma leitura justa exige a variante exata do modelo, a tarefa sendo testada, o software de agente em torno do modelo e a fonte de cada resultado.
A fonte descreve desenvolvedores comparando resultados de jogos em navegador ou 3D e considerando o Wonder decepcionante ao lado de modelos concorrentes. Essas demonstrações são fáceis de inspecionar: os espectadores podem ver se o movimento funciona, se a câmera se comporta de forma sensata e se a cena se assemelha ao resultado solicitado.
A fonte também cita Alexandr Wang, da Meta, afirmando que a equipe não havia treinado explicitamente para jogos de demonstração 3D e incentivando desenvolvedores a testar trabalho real de programação. Essa resposta é relatada pela Xinzhiyuan; ela não deve se tornar uma explicação genérica para toda tarefa de programação que falhe.
As demonstrações de jogos continuam sendo evidência relevante. Elas testam uma combinação real de geração de código, avaliação visual, interação e depuração. Sua limitação é o escopo: um prompt e uma execução não podem estabelecer o desempenho em manutenção de repositórios, trabalho em terminal ou projetos longos de software.
O anúncio principal da Meta apresenta o Muse Wonder e o Muse Wonder Full como modelos para agentes pessoais e profissionais. O Wonder é oferecido por meio da Meta Model API e do Muse Code; o Full é oferecido a assinantes do Muse Code.
O anúncio define Memória Ativa como a retenção de contexto importante entre conversas e sua recuperação quando relevante. Foco Ativo descreve o progresso sustentado rumo a um objetivo, incluindo testar alternativas, adaptar-se a novas informações, pedir esclarecimentos e verificar antes de ações importantes.
Essas descrições ajudam a explicar o que a Meta busca aprimorar. Elas são alegações de produto e de avaliação, não garantias de que um agente concluirá toda tarefa atribuída.
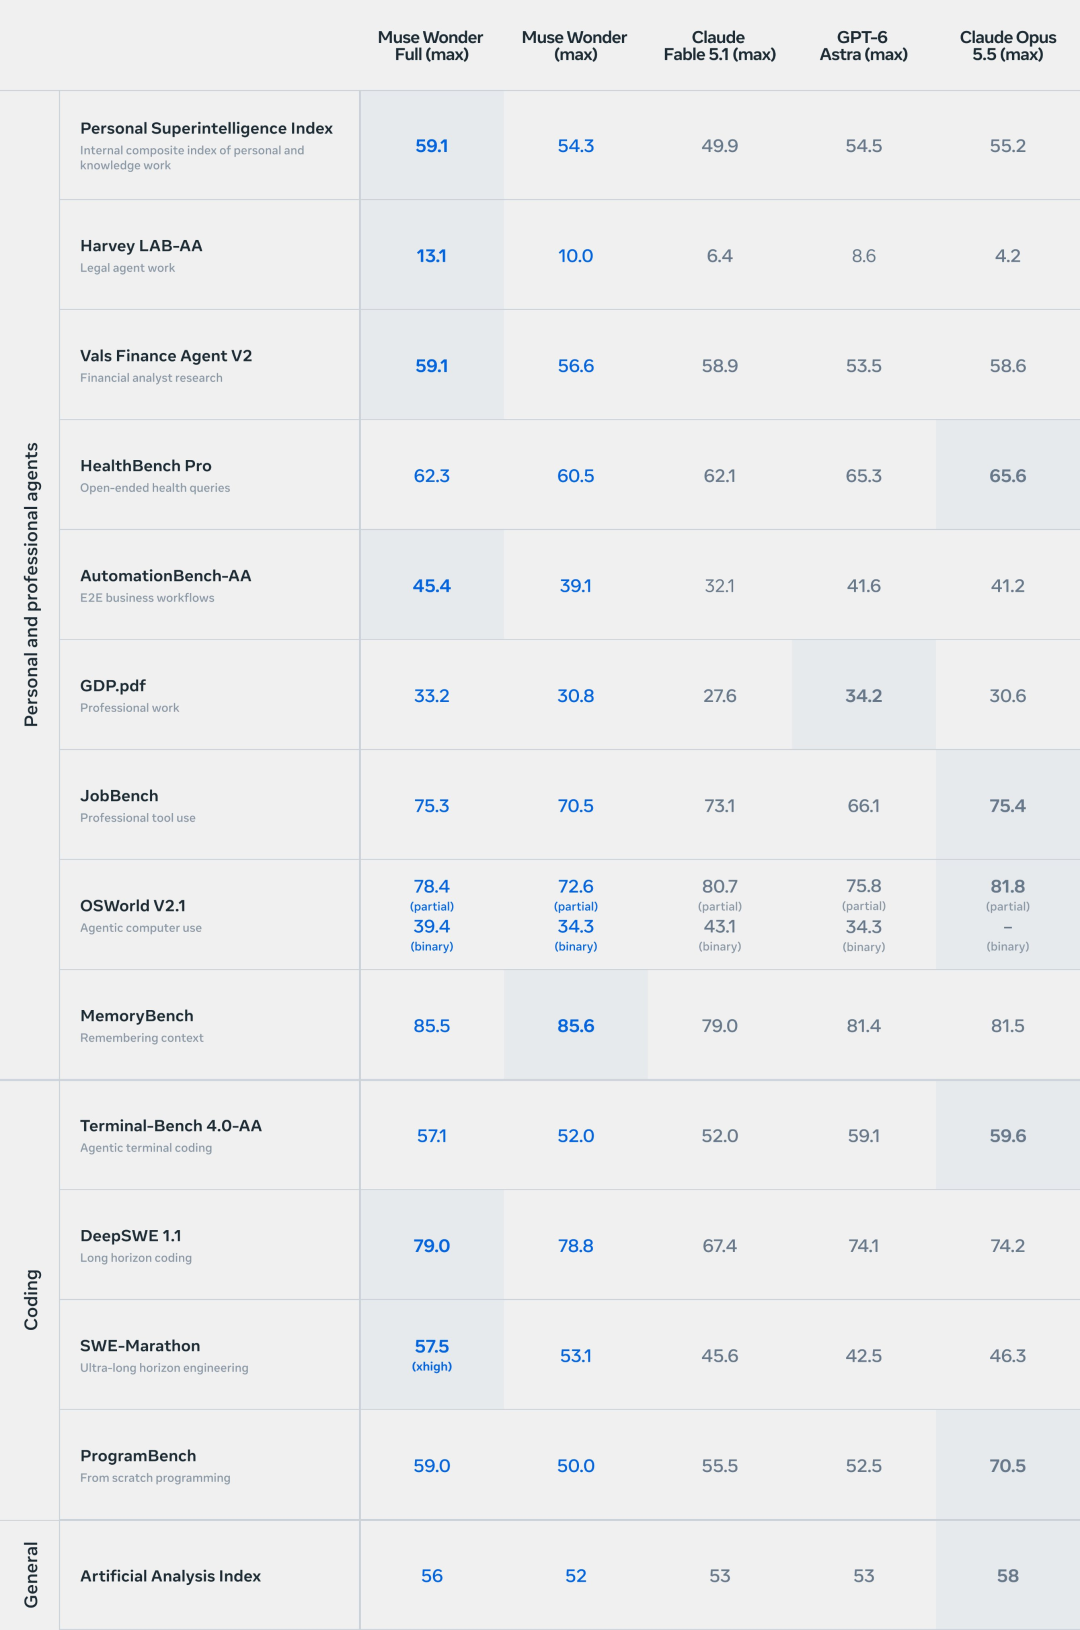
Tabela comparativa publicada pela Meta, reproduzida pela Xinzhiyuan no BAAI Hub. Os valores pertencem às configurações e condições de avaliação apresentadas nos materiais de lançamento.
A tabela não mostra um vencedor universal. Seus resultados de programação variam substancialmente conforme a tarefa:
| Avaliação | Muse Wonder Full | Claude Opus 5.5 | Direção da comparação |
|---|---|---|---|
| DeepSWE 1.1 | 79,0 | 74,2 | O Full obtém pontuação mais alta |
| SWE-Marathon | 57,5 | 46,3 | O Full obtém pontuação mais alta na configuração relatada |
| Terminal-Bench 4.0-AA | 57,1 | 59,6 | O Opus obtém pontuação mais alta |
| ProgramBench | 59,0 | 70,5 | O Opus obtém pontuação mais alta |
O material complementar da Meta também relata pontos fortes em memória e fluxos de trabalho de agentes, além de áreas nas quais outros modelos lideram. A existência de um resultado forte em trabalho de software de longa duração não implica o melhor desempenho na geração de uma aplicação do zero.
As condições de avaliação são especialmente importantes para o SWE-Marathon. O model card da Meta descreve concorrentes executados por meio do Codex e do Claude Code, enquanto o resultado destacado do Wonder Full usa uma configuração xhigh. Esses são resultados significativos em nível de produto, mas não constituem um único experimento controlado com um mecanismo de agente idêntico para todos os modelos.
O blog de lançamento da Meta discute explicitamente a diferença entre benchmarks familiares e tarefas não familiares. Sua análise compara o desempenho dentro e fora da distribuição à medida que a computação em tempo de teste aumenta, argumentando que o modelo-base mais forte do Wonder Full melhora a transferência dos ganhos de pós-treinamento para outras tarefas.
Isso é evidência técnica relevante para a posição da Meta. Ainda assim, trata-se de uma avaliação escolhida e apresentada pela desenvolvedora do modelo, e não resolve toda reclamação sobre o resultado de um desenvolvedor.
Da mesma forma, relatos de uma demonstração de jogo decepcionante não demonstram contaminação de benchmark ou fabricação de resultados. Para estabelecer essas alegações, seria necessária evidência mais direta sobre dados, métodos ou resultados manipulados do que a fornecida pelo artigo de origem.
A cobertura independente da Artificial Analysis relata pontuações no Intelligence Index v4.3 de 56 para o Wonder Full e 52 para o Wonder, com esforço máximo de raciocínio. Portanto, um usuário de API que testa o Wonder regular está avaliando uma oferta de lançamento diferente do modelo Full que lidera vários gráficos.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A Artificial Analysis lista uma janela de contexto de um milhão de tokens para cada variante. Para o Wonder, ela informa US$ 4 por milhão de tokens de entrada, US$ 0,20 para entrada em cache e US$ 20 para saída. Sua estimativa de US$ 4,52 por tarefa do Intelligence Index é um custo específico da avaliação, não um preço fixo para qualquer solicitação de usuário.
A fonte também critica a ausência de uma versão pública com pesos abertos. Nem o anúncio de lançamento verificado nem a descrição de acesso fornecem um lançamento para download dos pesos do Wonder; portanto, desenvolvedores não devem presumir que a auto-hospedagem local esteja disponível.
A Meta afirma que o Wonder foi treinado em seu data center Prometheus de escala gigawatt. O artigo do BAAI relaciona o lançamento a comentários de Mark Zuckerberg e Wang sobre a escala do investimento em infraestrutura de IA e o papel dos agentes pessoais no comércio.
Esses comentários descrevem uma estratégia mais ampla. Eles não devem ser convertidos em um valor verificado de custo de treinamento para este modelo específico. Da mesma forma, um exemplo de agentes negociando ou comprando serviços é uma visão para o comportamento do produto, não evidência de que cada fluxo de trabalho desse tipo tenha sido implantado.
O próximo passo útil é realizar testes repetíveis: manter os requisitos constantes, identificar a variante e a configuração de raciocínio, documentar o ambiente e medir o trabalho concluído. Isso pode revelar pontos fortes e fracos com mais confiabilidade do que uma única pontuação de destaque ou uma única falha marcante.
Não. Elas podem mostrar desempenho ruim nas tarefas demonstradas, mas provar fraude em benchmarks exige evidência separada sobre métodos de avaliação, dados ou resultados manipulados.
Eles são ofertas distintas da família de modelos, com diferentes caminhos de acesso no lançamento. A Artificial Analysis relata 52 para o Wonder e 56 para o Full, com esforço máximo de raciocínio, em seu Intelligence Index v4.3.
A tabela citada fornece respostas diferentes para avaliações distintas de programação. O Full lidera no DeepSWE 1.1 e na configuração relatada do SWE-Marathon, enquanto o Opus lidera no Terminal-Bench 4.0-AA e no ProgramBench.
Apenas com uma ressalva sobre a configuração. O model card da Meta descreve concorrentes usando seus produtos de programação, de modo que diferenças no comportamento do agente e nas ferramentas podem influenciar o resultado, além do modelo subjacente.
A cobertura de lançamento da Artificial Analysis informa US$ 4 por milhão de tokens de entrada, US$ 0,20 por milhão de tokens de entrada em cache e US$ 20 por milhão de tokens de saída. Verifique os termos atuais de cobrança do provedor antes de assumir um compromisso de uso em produção.
Nenhum download público dos pesos foi estabelecido pelos materiais de lançamento verificados. Os caminhos de acesso documentados são a API e o Muse Code para o Wonder, além do acesso por assinatura do Muse Code para o Full.
Os resultados de lançamento do Muse Wonder mostram uma família de modelos com boas pontuações em agentes e engenharia de software, resultados desiguais entre categorias de programação e caminhos de acesso diferentes para as variantes regular e Full.
A conclusão útil é específica para cada tarefa: verifique o modelo exato e teste o trabalho concluído antes de aceitar uma alegação de vitória universal ou uma acusação de fraude.
Comece com uma frase e tenha um site completo em minutos.