For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
O lançamento do Muse Wonder pela Meta coloca dois modelos com nomes muito semelhantes em um campo competitivo. Isso torna a primeira pergunt...
O lançamento do Muse Wonder pela Meta coloca dois modelos com nomes muito semelhantes em um campo competitivo. Isso torna a primeira pergunta excepcionalmente prática: você está analisando o Muse Wonder ou o Muse Wonder Full?
A Artificial Analysis relata pontuações de 52 para o Wonder e 56 para o Wonder Full no Intelligence Index v4.3, ambos com esforço máximo de raciocínio. O artigo em chinês republicado no BAAI Hub destaca que o Full ficou à frente do resultado reportado de 53 pontos do Gemini 4 Argon. Trata-se de uma comparação de benchmark entre configurações específicas de modelos, e não de uma prova de que qualquer variante do Wonder vence todas as tarefas do mundo real.
O anúncio oficial da Meta informa que o Muse Wonder está disponível por meio da Meta Model API e do Muse Code. O Muse Wonder Full está disponível para assinantes do Muse Code. A empresa afirma que o Wonder posteriormente oferecerá recursos em seu assistente Muse, inicialmente para assinantes.
| Modelo | Intelligence Index v4.3, esforço máximo | Acesso no lançamento descrito pela Meta |
|---|---|---|
| Muse Wonder | 52 | Meta Model API e Muse Code |
| Muse Wonder Full | 56 | Assinatura do Muse Code |
Essas distinções são importantes ao tentar reproduzir um resultado publicado. Acessar o Wonder pela API não é o mesmo que avaliar o Full por meio do produto de programação.
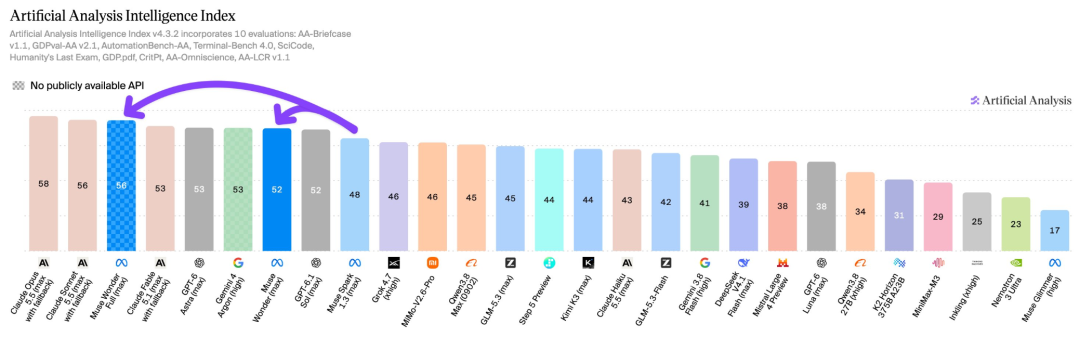
Gráfico: Artificial Analysis, reproduzido e anotado na reportagem da QbitAI no BAAI Hub. Ele reflete a comparação no momento da publicação da fonte.
A Artificial Analysis também informa janelas de contexto de um milhão de tokens para ambas as variantes. Sua análise de lançamento lista os preços da API do Wonder em US$ 4 por milhão de tokens de entrada, US$ 0,20 por milhão de tokens de entrada em cache e US$ 20 por milhão de tokens de saída. O Full não tem preço por token nessa análise porque seu acesso no lançamento ocorre por meio de um produto por assinatura.
O artigo do BAAI enfatiza o acesso mais restrito do Gemini 4 Argon no momento da reportagem. A disponibilidade pode mudar rapidamente; portanto, esse contraste histórico não deve ser interpretado como uma promessa sobre as regras de acesso atuais de qualquer um dos provedores.
A Meta apresenta o Wonder como uma família de modelos para agentes pessoais e profissionais. Seu anúncio atribui nomes distintos a duas capacidades recorrentes.
Memória Ativa diz respeito a reter informações importantes entre conversas e recuperar os detalhes relevantes para uma nova tarefa. Para um assistente pessoal, isso poderia significar usar uma preferência já estabelecida sem exigir que o usuário a repita todas as vezes.
Foco Ativo diz respeito a continuar em direção a um objetivo quando a primeira tentativa falha. A Meta descreve a tentativa de abordagens alternativas, a adaptação a novas informações, a busca por esclarecimentos quando necessário e a verificação antes de ações importantes.
A programação exige os dois tipos de comportamento. Um agente pode precisar preservar uma restrição original enquanto avança por diversas rodadas de edições, falhas em testes e revisões. A Meta afirma que os modelos Wonder foram treinados em tarefas diversas que exigem trabalho prolongado, com base na abordagem de escalonamento usada para o Muse Spark.
A fonte contrasta benchmarks robustos de engenharia de software com reações mistas a demonstrações de jogos 3D. Essas são cargas de trabalho diferentes, mesmo quando ambas exigem que o modelo escreva código.
O DeepSWE 1.1 testa o trabalho em software existente, enquanto o ProgramBench se refere à criação de programas do zero. A tabela de comparação do material de lançamento da Meta informa 59,0 para o Wonder Full e 70,5 para o Claude Opus 5.5 no ProgramBench. Portanto, um modelo pode liderar em um tipo de tarefa de engenharia e ficar atrás em outro.
O relatório original também descreve desenvolvedores que preferiram o Opus para uma demonstração em Unity e outro desenvolvedor que relatou uma execução bem-sucedida do Wonder Full. Essas são observações individuais, com prompts, ambientes e critérios de sucesso diferentes. A discordância entre elas é um motivo para examinar a configuração da tarefa, em vez de transformar anedotas em uma classificação universal.
Uma qualificação adicional é relevante para testes de software de longa duração: o model card da Meta afirma que sua comparação SWE-Marathon usa os agentes de programação dos fornecedores concorrentes, incluindo Codex e Claude Code. Isso torna o resultado relevante para uma comparação de produtos de ponta a ponta, mas não é uma comparação controlada em que todos os modelos usam o mesmo ambiente de agente.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Isso oferece ao benchmark de destaque uma contraparte prática. Um modelo que produz uma demonstração de jogo menos impressionante ainda pode ser útil para uma tarefa de manutenção, e uma pontuação elevada no índice não justifica uma saída com falhas.
É a variante completa da família de modelos Muse Wonder da Meta. O anúncio de lançamento da Meta o disponibiliza para assinantes do Muse Code, enquanto a variante Wonder regular também tem acesso por API.
A comparação do Intelligence Index no lançamento da fonte posiciona o Wonder Full em 56 e o Gemini 4 Argon em 53. Isso descreve o índice específico e as configurações apresentadas, não um resultado para todas as tarefas ou avaliações.
O anúncio da Meta distingue os dois caminhos de acesso. Ele lista o Wonder para a API e o Muse Code, e o Full para assinantes do Muse Code.
A cobertura de lançamento da Artificial Analysis lista US$ 4 por milhão de tokens de entrada, US$ 0,20 para entrada em cache e US$ 20 para saída. Esses são preços reportados no momento da publicação; portanto, consulte os termos de cobrança do provedor antes da implantação.
A Memória Ativa diz respeito a recuperar informações úteis de conversas anteriores. O Foco Ativo diz respeito à execução sustentada, incluindo tentar outra abordagem quando uma tarefa encontra um obstáculo.
Elas mostram uma limitação nessas tarefas e configurações específicas. O desempenho mais amplo em programação também inclui manutenção de repositórios, depuração, uso de ferramentas e cumprimento de requisitos em fluxos de trabalho mais longos.
As fortes pontuações de lançamento do Wonder Full fazem dele uma opção relevante para trabalho exigente com agentes. O Wonder regular tem uma pontuação e um caminho de acesso diferentes; por isso, o nome da variante deve acompanhar toda alegação de desempenho.
Use classificações de benchmark para selecionar um candidato a teste e, em seguida, compare o modelo exato no trabalho que você precisa que ele conclua.
Comece com uma frase e tenha um site completo em minutos.



