
Outra onda de lançamentos de modelos pode estar se aproximando, segundo um artigo da QbitAI publicado em 21 de outubro. O relato aborda um modelo Claude ainda não lançado, um modelo do Google chamado Carbon e um identificador GPT-6.1 Terra supostamente encontrado em uma configuração de avaliação da Microsoft.
Esses são diferentes tipos de evidência. Impressões de testadores privados, um nome encontrado em código e resultados de avaliações publicados não devem ser tratados como provas equivalentes do lançamento de um produto. O desenvolvimento mais claramente confirmado neste resumo é o trabalho publicado separadamente pela OpenAI sobre linguagens de programação menos utilizadas em treinamentos e aplicações.
Um modelo Claude ainda não lançado aparentemente vai além de bugs individuais
A QbitAI atribui suas informações sobre o Claude ao The Information. Segundo esse relato, um usuário inicial descreve um raciocínio melhor e uma capacidade mais forte de inferir o objetivo por trás de uma solicitação.
O exemplo de programação envolve o diagnóstico da causa raiz: em vez de lidar apenas com um bug relatado, o modelo supostamente reconhece uma fonte mais ampla de falhas semelhantes e pergunta se o usuário deseja resolver toda essa classe de problemas. Perguntar antes de ampliar uma alteração é uma parte importante desse exemplo, especialmente em um repositório no qual uma correção mais abrangente poderia afetar comportamentos não relacionados.
O relato também descreve respostas menos convencionais para perguntas abertas. Seu exemplo de seleção de ações é uma anedota sobre a geração de uma nova abordagem, e não uma evidência de desempenho de investimento. Nenhum retorno validado, benchmark financeiro ou algoritmo de negociação pronto para implementação é apresentado.
A identidade do modelo continua sem definição na fonte. Nomes como Fable e Opus aparecem como possibilidades, não como uma marca de lançamento confirmada. Também não há um benchmark reproduzível que estabeleça o tamanho da melhoria alegada.
Gemini Carbon e os limites do feedback interno
A próxima parte trata do modelo Carbon interno do Google, segundo os relatos. A informação fornecida afirma que ele supera o Argon em programação e continua forte em tarefas visuais, como analisar vídeos ou examinar o comportamento de interfaces front-end.
O relato também afirma que funcionários testaram o Carbon por meio de uma plataforma interna de programação chamada Jetski e avaliaram a experiência de forma favorável em comparação com o Opus 5.5. Essas são impressões informais de um ambiente interno. Diferenças nos prompts, no acesso a ferramentas e nas condições de teste impedem que elas estabeleçam uma classificação geral dos modelos.
A QbitAI descreve Argon, Barium e Carbon como nomes internos de desenvolvimento e afirma que uma versão candidata Barium-B acabou se tornando o Argon anunciado publicamente. Esse histórico de nomenclatura é apresentado aqui como parte do relato da fonte; um rótulo interno, por si só, não estabelece a linhagem exata de treinamento de um modelo público.
O artigo então discute uma publicação em rede social que menciona o autoaperfeiçoamento recursivo, ou RSI. Ele interpreta o momento da publicação como uma possível pista sobre o Carbon. Uma observação em rede social não comprova que o Carbon tenha sido treinado por meio de RSI, e a fonte não fornece uma descrição técnica desse tipo de sistema. Sua explicação envolvendo dados de treinamento do YouTube também não é sustentada por uma divulgação de treinamento verificada nos materiais consultados para este artigo.
Um nome GPT-6.1 Terra aparece em uma captura de tela de avaliação
O artigo fornecido mostra uma publicação da Lumina descrevendo um pull request da Microsoft que supostamente substitui as configurações de avaliação do GPT-5.6 Terra pelo GPT-6.1 Terra. A captura de tela incluída exibe gpt-6.1-terra como modelo avaliador padrão.
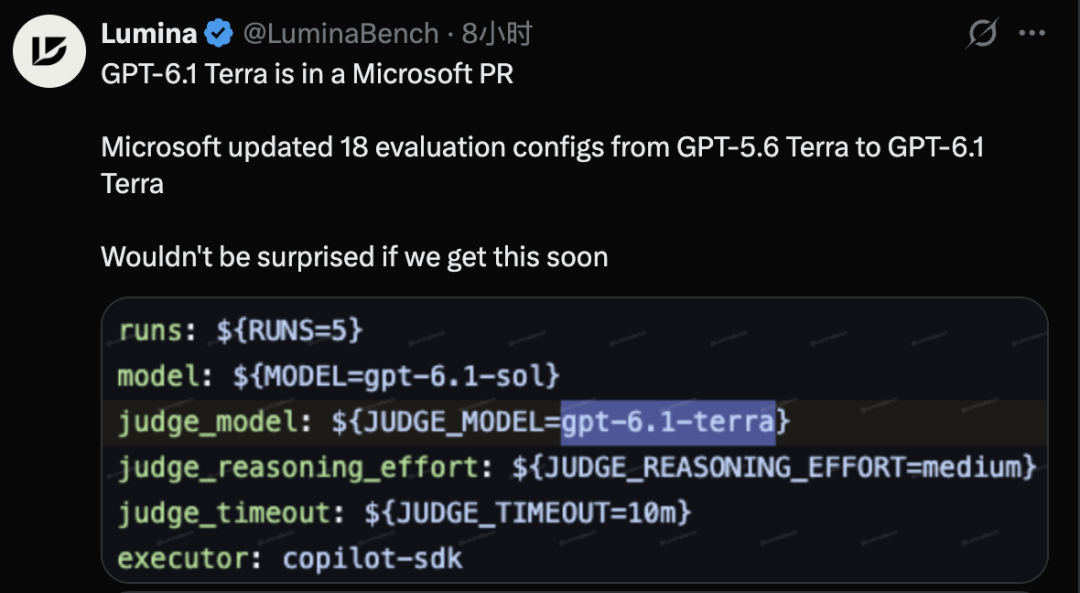
Captura de tela da fonte: publicação da Lumina reproduzida pela QbitAI e pelo BAAI Hub.
Uma string de configuração é uma evidência útil de que determinado nome foi referenciado. Ela não comprova a existência de um endpoint geralmente disponível, preço, data de lançamento ou nível de capacidade. O catálogo público de modelos da OpenAI consultado para este artigo não apresentou uma entrada confirmada para o lançamento do GPT-6.1 Terra.
A fonte usa essa descoberta para questionar a teoria de que o GPT-6.1 Sol seria simplesmente o Terra com outro nome. Nem uma captura de tela nem especulações sobre nomenclatura são suficientes para reconstruir as decisões de treinamento ou de produto dos modelos.
Algumas reações no artigo são céticas; outras sugerem que um modelo mais barato poderia viabilizar uma integração mais ampla entre o ChatGPT e fluxos de programação. Essa estratégia de produto continua sendo uma interpretação presente nesse relato, e não um plano de lançamento confirmado ou uma garantia de acesso a um plano gratuito.
Progresso confirmado em COBOL e outras linguagens com poucos recursos
O anúncio de pesquisa da OpenAI de 19 de outubro descreve duas avaliações: construir software compatível com SQLite em 20 linguagens e migrar COBOL preservando seu comportamento. Aqui, “poucos recursos” refere-se à relativa escassez de código e documentação disponíveis para treinamento, e não à importância da linguagem ou aos requisitos computacionais.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Na avaliação de migração de COBOL, o GPT-6.1 Sol alcança 86,6% com baixo esforço de raciocínio, em comparação com 5,4% do GPT-5.6 Sol na mesma configuração. A OpenAI relata 97,9% com um esforço de raciocínio mais alto. Esses são resultados obtidos em sua avaliação, não taxas de sucesso prometidas para migrações bancárias arbitrárias.
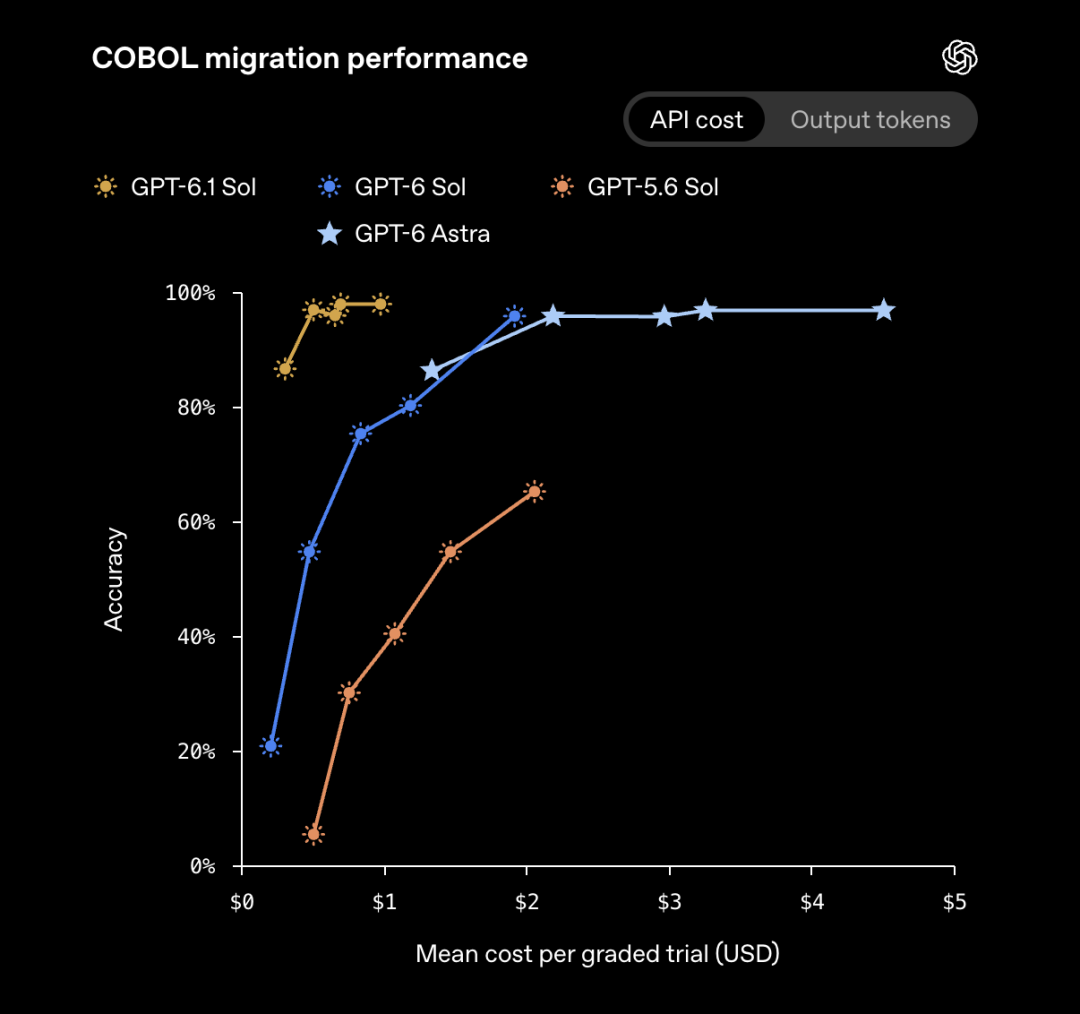
Crédito do gráfico: OpenAI, reproduzido no artigo fornecido.
A preservação do comportamento é importante porque um programa pode ser compilado e ainda assim alterar arredondamentos, tratamento de registros ou resultados observáveis. A revisão de especialistas e testes representativos continuam sendo necessários ao aplicar uma migração a um sistema real.
A fonte encerra antecipando novos lançamentos de modelos chineses, incluindo Kimi, GLM e MiniMax, após a nova movimentação do DeepSeek. Ela não fornece um calendário completo e confirmado de lançamentos; portanto, essas expectativas devem continuar em aberto, em vez de serem apresentadas como lançamentos programados.
Perguntas frequentes
O novo modelo Claude foi identificado oficialmente?
O artigo fornecido não estabelece seu nome público final. As descrições de capacidade vêm de um teste privado relatado, e não de uma especificação de lançamento verificada.
O Gemini Carbon é um lançamento público confirmado?
A fonte descreve um modelo interno e feedback de funcionários. Ela não fornece uma data pública de lançamento verificada nem um endpoint acessível do Carbon.
A publicação sobre RSI prova que o Carbon consegue se aperfeiçoar?
Não. Nenhuma evidência técnica no relato fornecido comprova essa afirmação. O artigo conecta uma observação em rede social aos relatos sobre o modelo, o que continua sendo uma inferência.
O GPT-6.1 Terra está disponível pela API da OpenAI?
A descoberta no código não comprova a disponibilidade pela API. O catálogo oficial consultado para este artigo não confirmou um lançamento público do GPT-6.1 Terra.
Qual foi a pontuação do GPT-6.1 Sol na migração de COBOL?
A OpenAI relata 86,6% com baixo esforço de raciocínio e 97,9% com uma configuração mais alta. Esses números descrevem as condições de sua avaliação, e não uma garantia universal de migração.
As migrações de código legado geradas por IA podem ser implementadas imediatamente?
A geração ou compilação bem-sucedida não é suficiente para comprovar a equivalência do comportamento. As equipes ainda precisam de testes que cubram as regras de negócio, os formatos de dados e as dependências do sistema, além da revisão de especialistas.
Ferramentas relacionadas
- Claude: plataforma de assistente da Anthropic, distinta da identidade não confirmada do modelo mencionada neste relato.
- Gemini: serviço público de assistente do Google, separado dos testes internos relatados.
- Catálogo de modelos da OpenAI: documentação oficial para consultar identificadores de modelos publicados.
Links relacionados
- Artigo fornecido da QbitAI no BAAI Hub: fonte do resumo sobre os modelos e das capturas de tela.
- Pesquisa da OpenAI sobre linguagens com poucos recursos: fonte primária dos números da avaliação de COBOL.
- Catálogo de modelos publicado pela OpenAI: referência para consultar listagens de modelos, em vez de inferir disponibilidade a partir de vazamentos.
- Primeira referência social citada pela QbitAI: referência social original listada pelo artigo fornecido; suas afirmações subjacentes não foram autenticadas de forma independente aqui.
- Segunda referência social citada pela QbitAI: outra referência fornecida pelo artigo, e não um anúncio oficial de lançamento.
Resumo
O resumo aponta para possíveis novos modelos Claude e Gemini, além de um identificador Terra encontrado em código de avaliação. A marca final, a disponibilidade e o desempenho comparativo permanecem incertos com base nas evidências disponíveis.
O resultado confirmado é mais restrito: a OpenAI publicou pontuações melhores em avaliações com linguagens legadas, enquanto as demais alegações de lançamento ainda exigem confirmação oficial.


