For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
À medida que as fábricas de IA crescem de infraestruturas de megawatts para infraestruturas em escala de gigawatts, o desafio já não se limi...
À medida que as fábricas de IA crescem de infraestruturas de megawatts para infraestruturas em escala de gigawatts, o desafio já não se limita a instalar aceleradores mais rápidos em um data center. Distribuição de energia, resfriamento líquido, redes, capacidade de manutenção, comportamento da rede elétrica e projetos de racks interoperáveis precisam escalar em conjunto.
No Open Compute Project Global Summit 2026, em San Jose, a NVIDIA anunciou um conjunto de parcerias, especificações abertas e contribuições de software projetadas para criar uma base mais comum para a infraestrutura de IA de próxima geração.
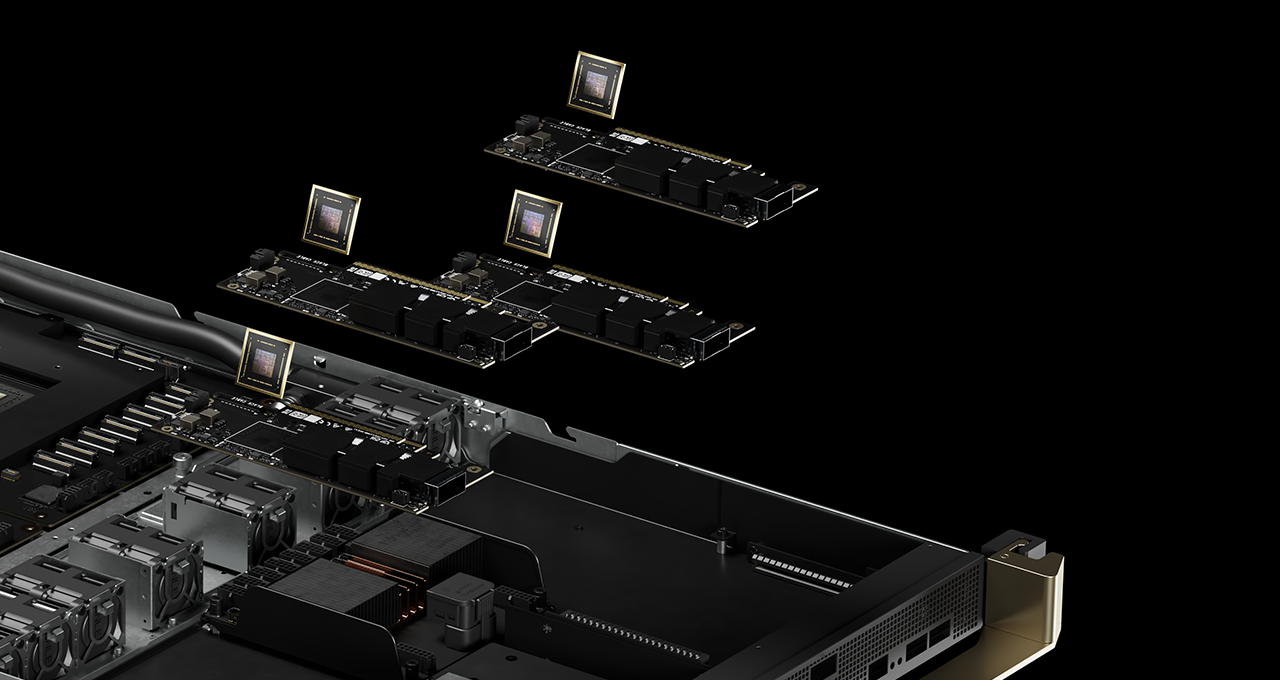
O elemento central é o NVIDIA Vera Rubin. A NVIDIA contribuiu com projetos essenciais de racks e bandejas de computação Vera Rubin para a OCP por meio da arquitetura aberta NVIDIA MGX, permitindo que integradores de sistemas e parceiros de infraestrutura trabalhem a partir de um projeto de referência compartilhado, em vez de desenvolver cada camada de forma independente.
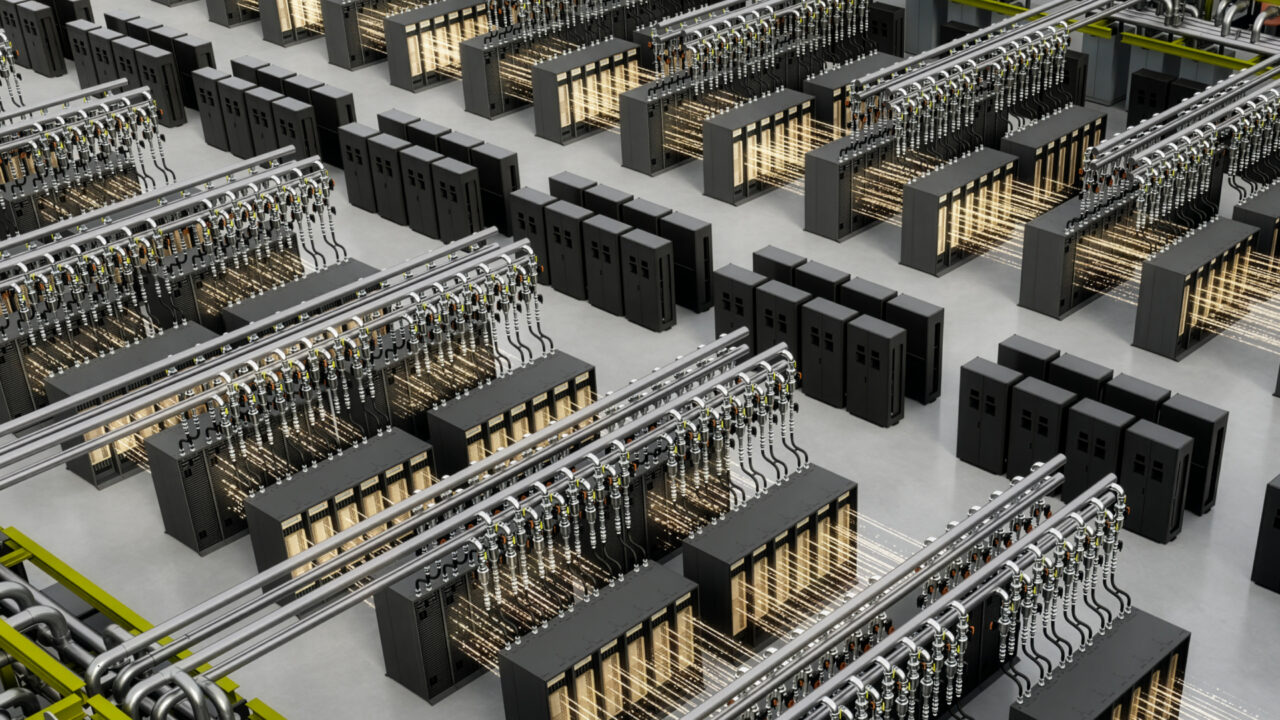
Os anúncios abrangem três camadas conectadas da fábrica de IA:
O resultado é um impulso mais amplo em direção a uma infraestrutura aberta e repetível que os parceiros podem fabricar, implantar e manter em escala global.
No OCP Global Summit 2026, a NVIDIA e seus parceiros do ecossistema anunciaram diversas iniciativas de infraestrutura em torno do Vera Rubin.
Os principais anúncios incluem:
No evento, Ian Buck, vice-presidente de Hyperscale e High-Performance Computing da NVIDIA, descreveu a infraestrutura aberta como uma parte cada vez mais importante da expansão das fábricas de IA em todo o mundo.
O fio condutor dos anúncios é o codesenvolvimento. Computação, rede, energia, resfriamento e software estão sendo tratados como partes de um único sistema, e não como camadas isoladas.
A NVIDIA se juntou a outros participantes do setor para contribuir com o projeto de referência de terceira geração MGX AI data center por meio da Open DC Initiative da OCP.
A especificação atualizada MGX 1.2 estende a arquitetura para fábricas de IA de maior potência e com resfriamento líquido.
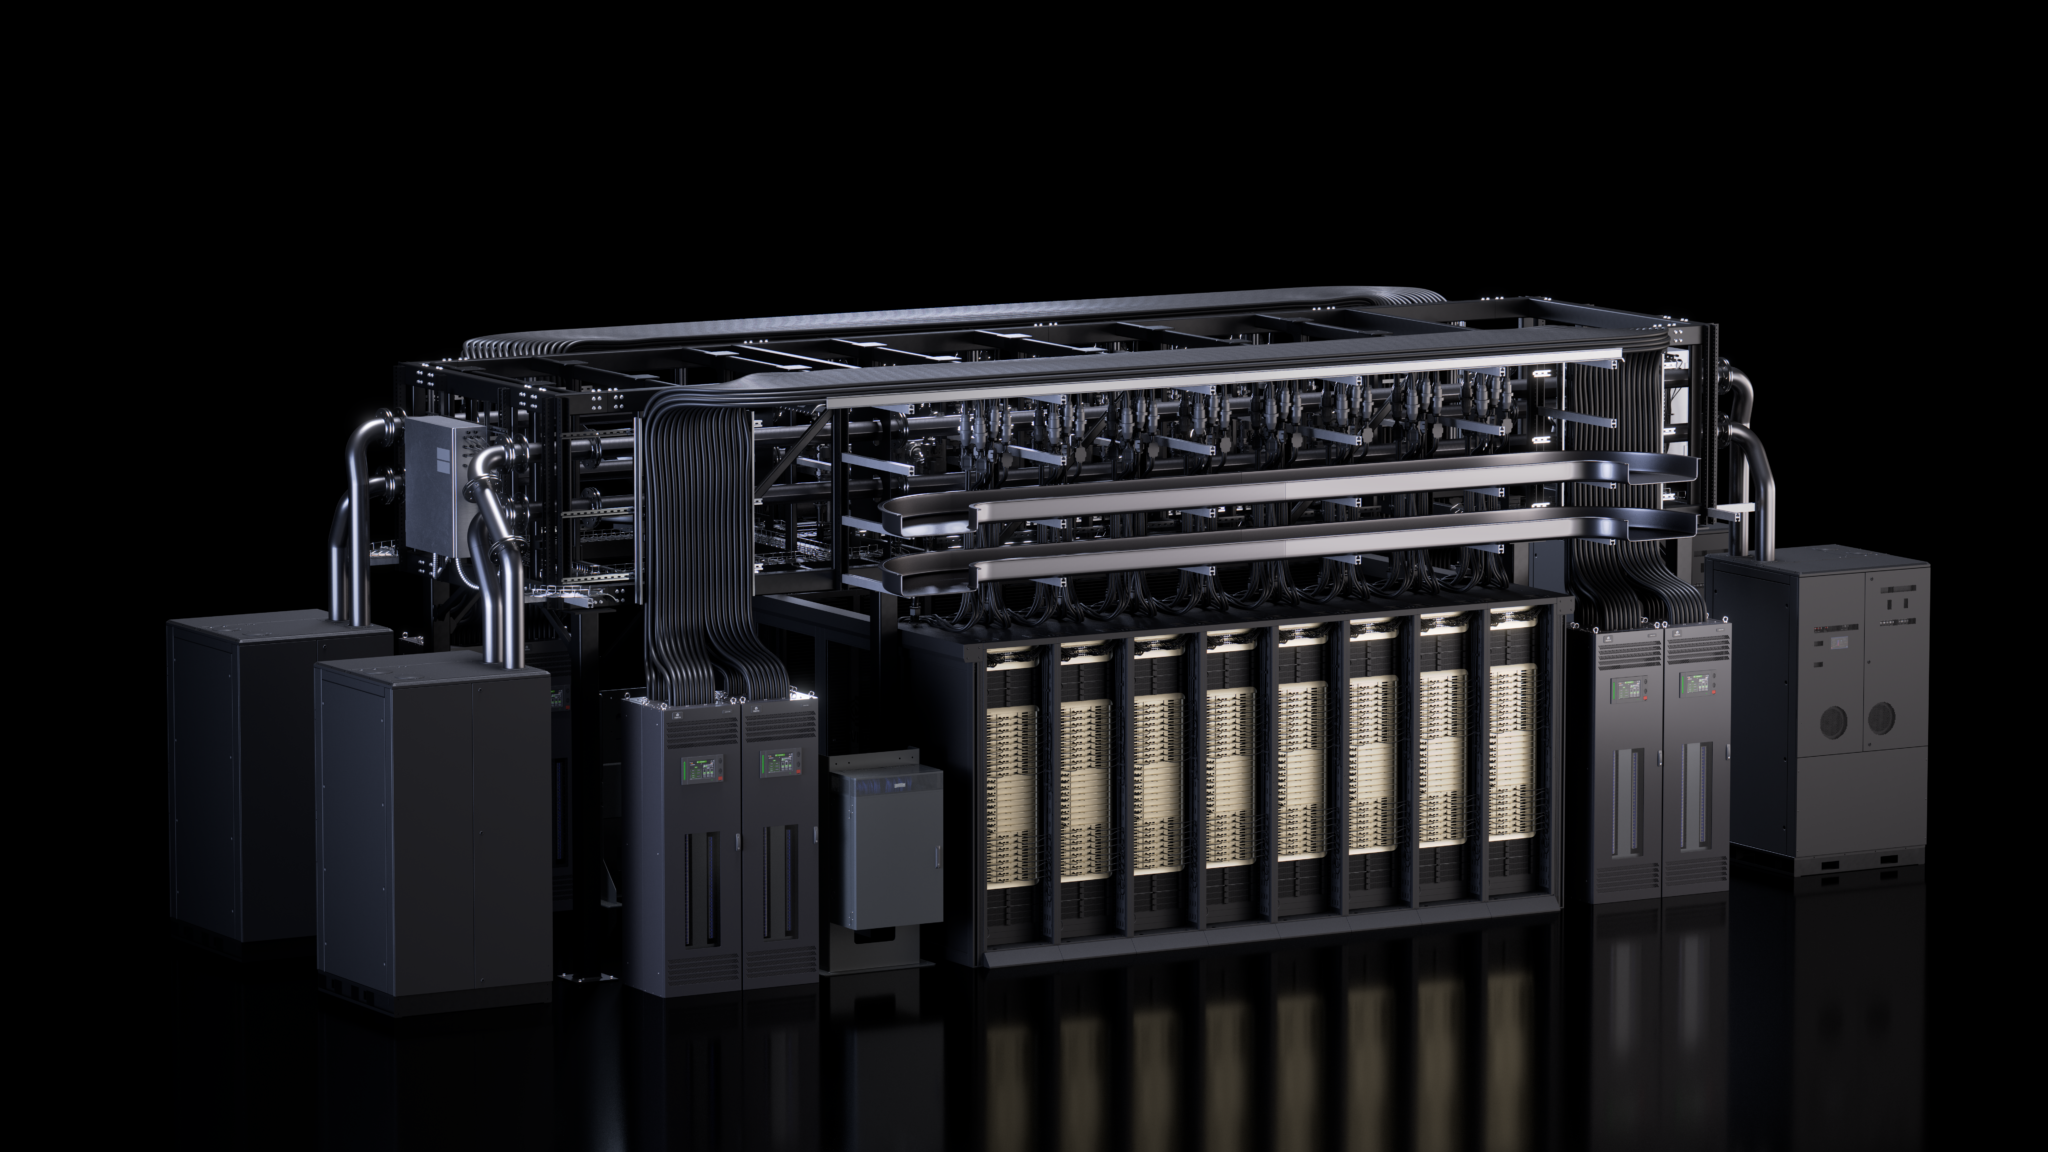
Entre as principais adições estão:
A NVIDIA afirma que a arquitetura pode suportar implantações em rack de até 250 kW, melhorando ao mesmo tempo a capacidade de manutenção e a reutilização da infraestrutura.
O MGX é uma arquitetura de referência modular, e não um único projeto fixo de servidor.
Isso oferece a OEMs, ODMs e parceiros de infraestrutura uma base mecânica, elétrica e de resfriamento comum, ao mesmo tempo que permite diferentes combinações de CPUs, GPUs, rede e armazenamento.
Para o Vera Rubin, isso significa que os parceiros podem desenvolver a partir de um projeto conhecido em escala de rack, em vez de partir de uma plataforma proprietária a cada vez.
A plataforma Vera Rubin NVL72 combina:
Ela pode então escalar horizontalmente por meio de NVIDIA Quantum-X800 InfiniBand ou Spectrum-X Ethernet.
A NVIDIA também está estendendo os mesmos princípios de projeto do MGX para um rack de CPU Vera dedicado.
Enquanto o Vera Rubin NVL72 foi projetado para treinamento e inferência em grande escala, o rack de CPU Vera é destinado a cargas de trabalho de agentes com uso intensivo de CPU, como:
A ideia mais ampla é manter a infraestrutura física consistente mesmo quando diferentes partes da carga de trabalho de IA exigem recursos computacionais distintos.
A plataforma DSX AI Factory da NVIDIA foi projetada para coordenar computação, rede, energia, resfriamento, instalações e software como um sistema otimizado.
No centro da camada de software está o DSX OS, que a NVIDIA descreve como uma camada operacional aberta para operações repetíveis de fábricas de IA.
Na OCP, a NVIDIA expandiu o DSX OS com quatro componentes de código aberto.
O NVIDIA Config Manager automatiza a configuração de switches em escala.
Seu objetivo é ajudar os operadores a implantar, validar e manter malhas de rede consistentes com o mínimo de configuração manual.
O NVIDIA Cluster Readiness Engine realiza testes de estresse em clusters de GPU usando simulações de carga de trabalho antes do início do treinamento em produção.
O objetivo é detectar problemas de hardware ou infraestrutura cedo o suficiente para evitar falhas dispendiosas em trabalhos de treinamento.
O NVIDIA Rack Management Service fornece uma abstração de hardware e uma camada operacional em nível de rack.
Em vez de tratar cada servidor de forma independente, o software trata os racks como unidades operacionais de primeira classe para gerenciamento de firmware e controle de infraestrutura em larga escala.
O Cluster API Provider for NVIDIA Infrastructure Controller foi projetado para acelerar o provisionamento bare metal e a integração de tenants.
A NVIDIA afirma que o objetivo é transformar hardware bruto de IA em clusters prontos para produção em horas, e não em dias.
Esses componentes foram desenvolvidos com base na experiência da NVIDIA na operação do DGX Cloud e têm como objetivo tornar as capacidades de fábrica de IA mais fáceis de integrar a plataformas de nuvem multilocatárias.
Grandes instalações de IA precisam de mais do que um projeto de rack compartilhado. Instalações, sistemas de resfriamento, arquitetura de energia e comportamento da rede elétrica também precisam de expectativas comuns.
Na OCP, a NVIDIA se juntou à AMD, Google e Meta para publicar uma especificação aberta atualizada de data center para infraestrutura de IA de próxima geração.
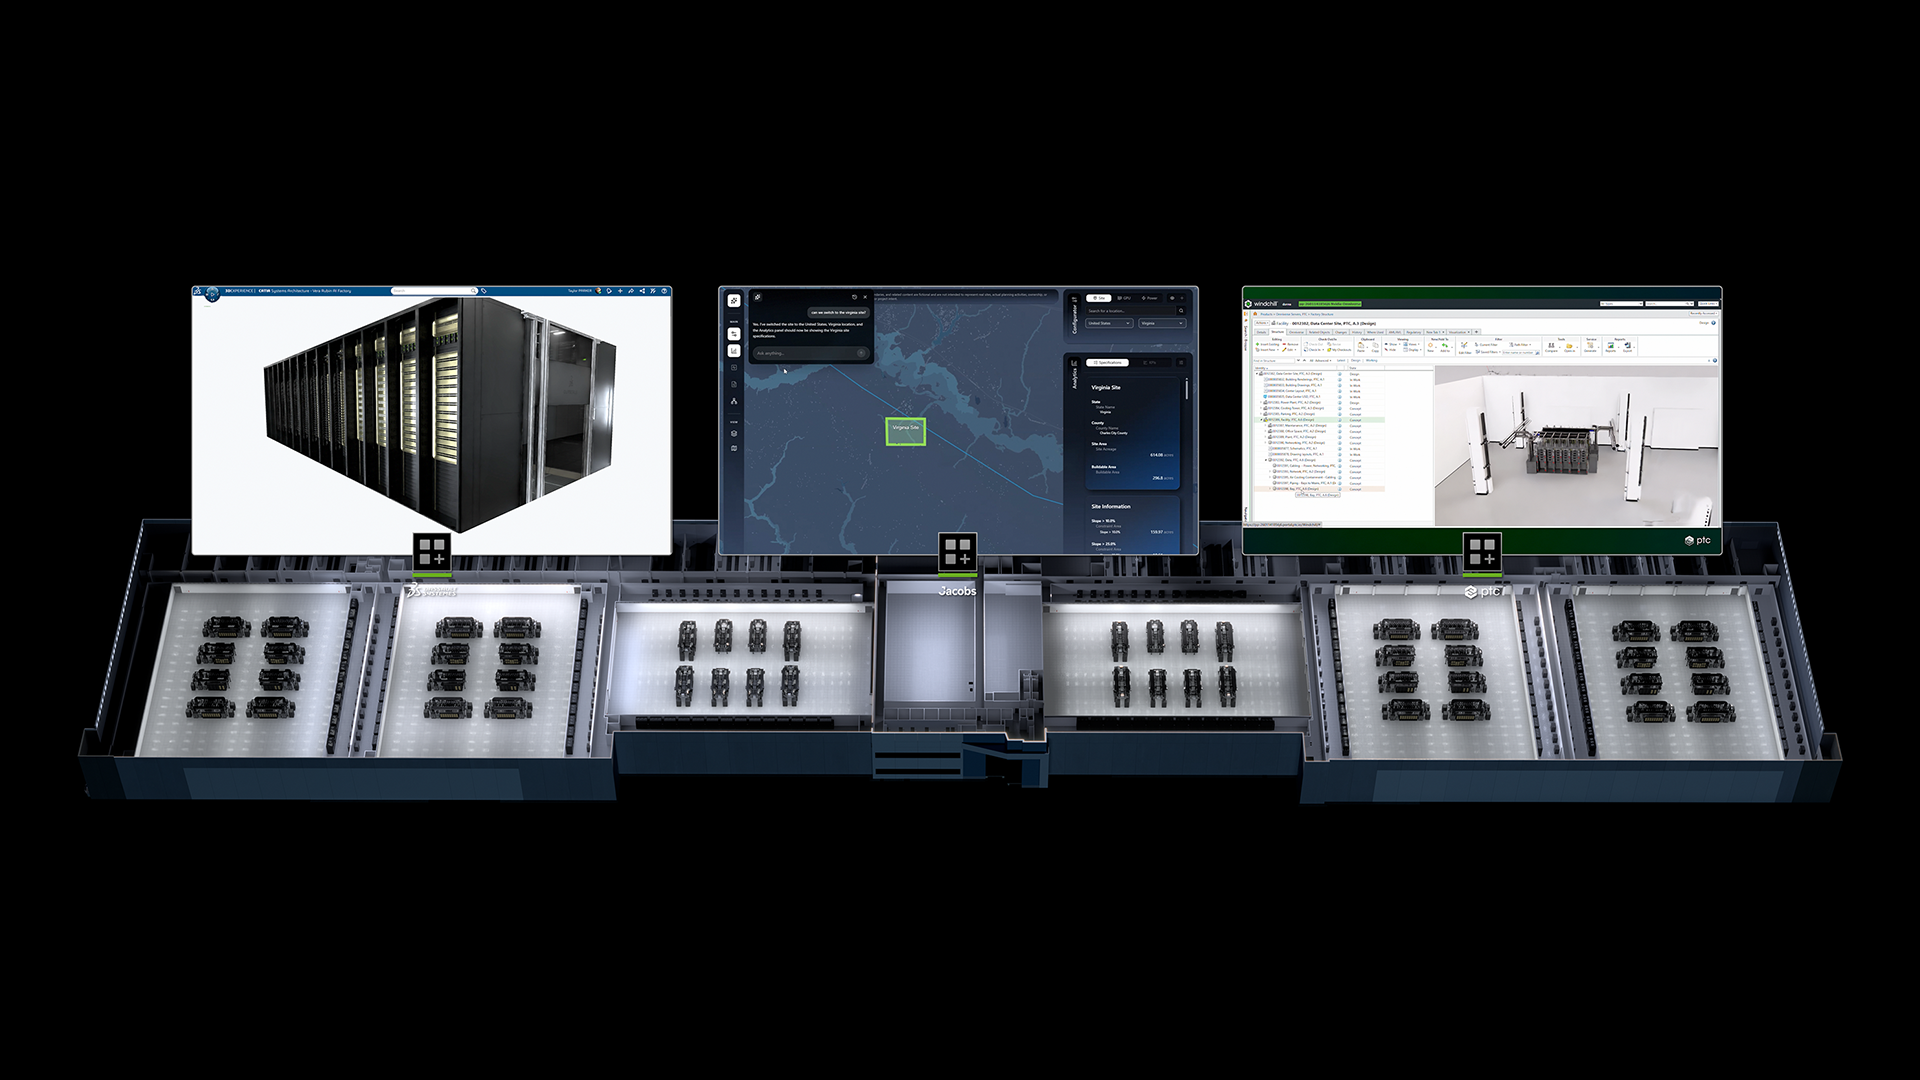
A Open Data Center Specification v0.7 define um plano comum para o projeto de instalações de fábricas de IA.
Ela abrange áreas como:
O objetivo é oferecer a fabricantes, provedores de colocation e operadores uma meta comum, em vez de exigir que aguardem uma especificação proprietária diferente de cada cliente.
Google, Meta, Microsoft e NVIDIA também publicaram uma OCP Grid Resilience Specification.
Essa especificação define como infraestruturas de IA muito grandes devem se comportar durante perturbações na rede elétrica.
O objetivo do projeto é que as instalações de IA:
Isso se torna cada vez mais importante à medida que as instalações de IA ficam grandes o bastante para que mudanças repentinas no consumo de energia afetem a rede elétrica ao redor.
A NVIDIA afirma que seus projetos de referência DSX oferecem um caminho de implementação aplicável, desde esses padrões abertos até a infraestrutura real de fábricas de IA.
A densidade de potência está se tornando uma das maiores restrições no projeto de fábricas de IA.
À medida que os clusters de treinamento, inferência e raciocínio crescem, a distribuição tradicional de menor tensão exige quantidades cada vez maiores de cobre, cabeamento e hardware de conversão.
Na OCP, a Visionbay.ai revelou planos para a K-1, uma plataforma de fábrica de IA baseada em uma arquitetura de 800 VDC e projetada considerando futuras implantações do Vera Rubin.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
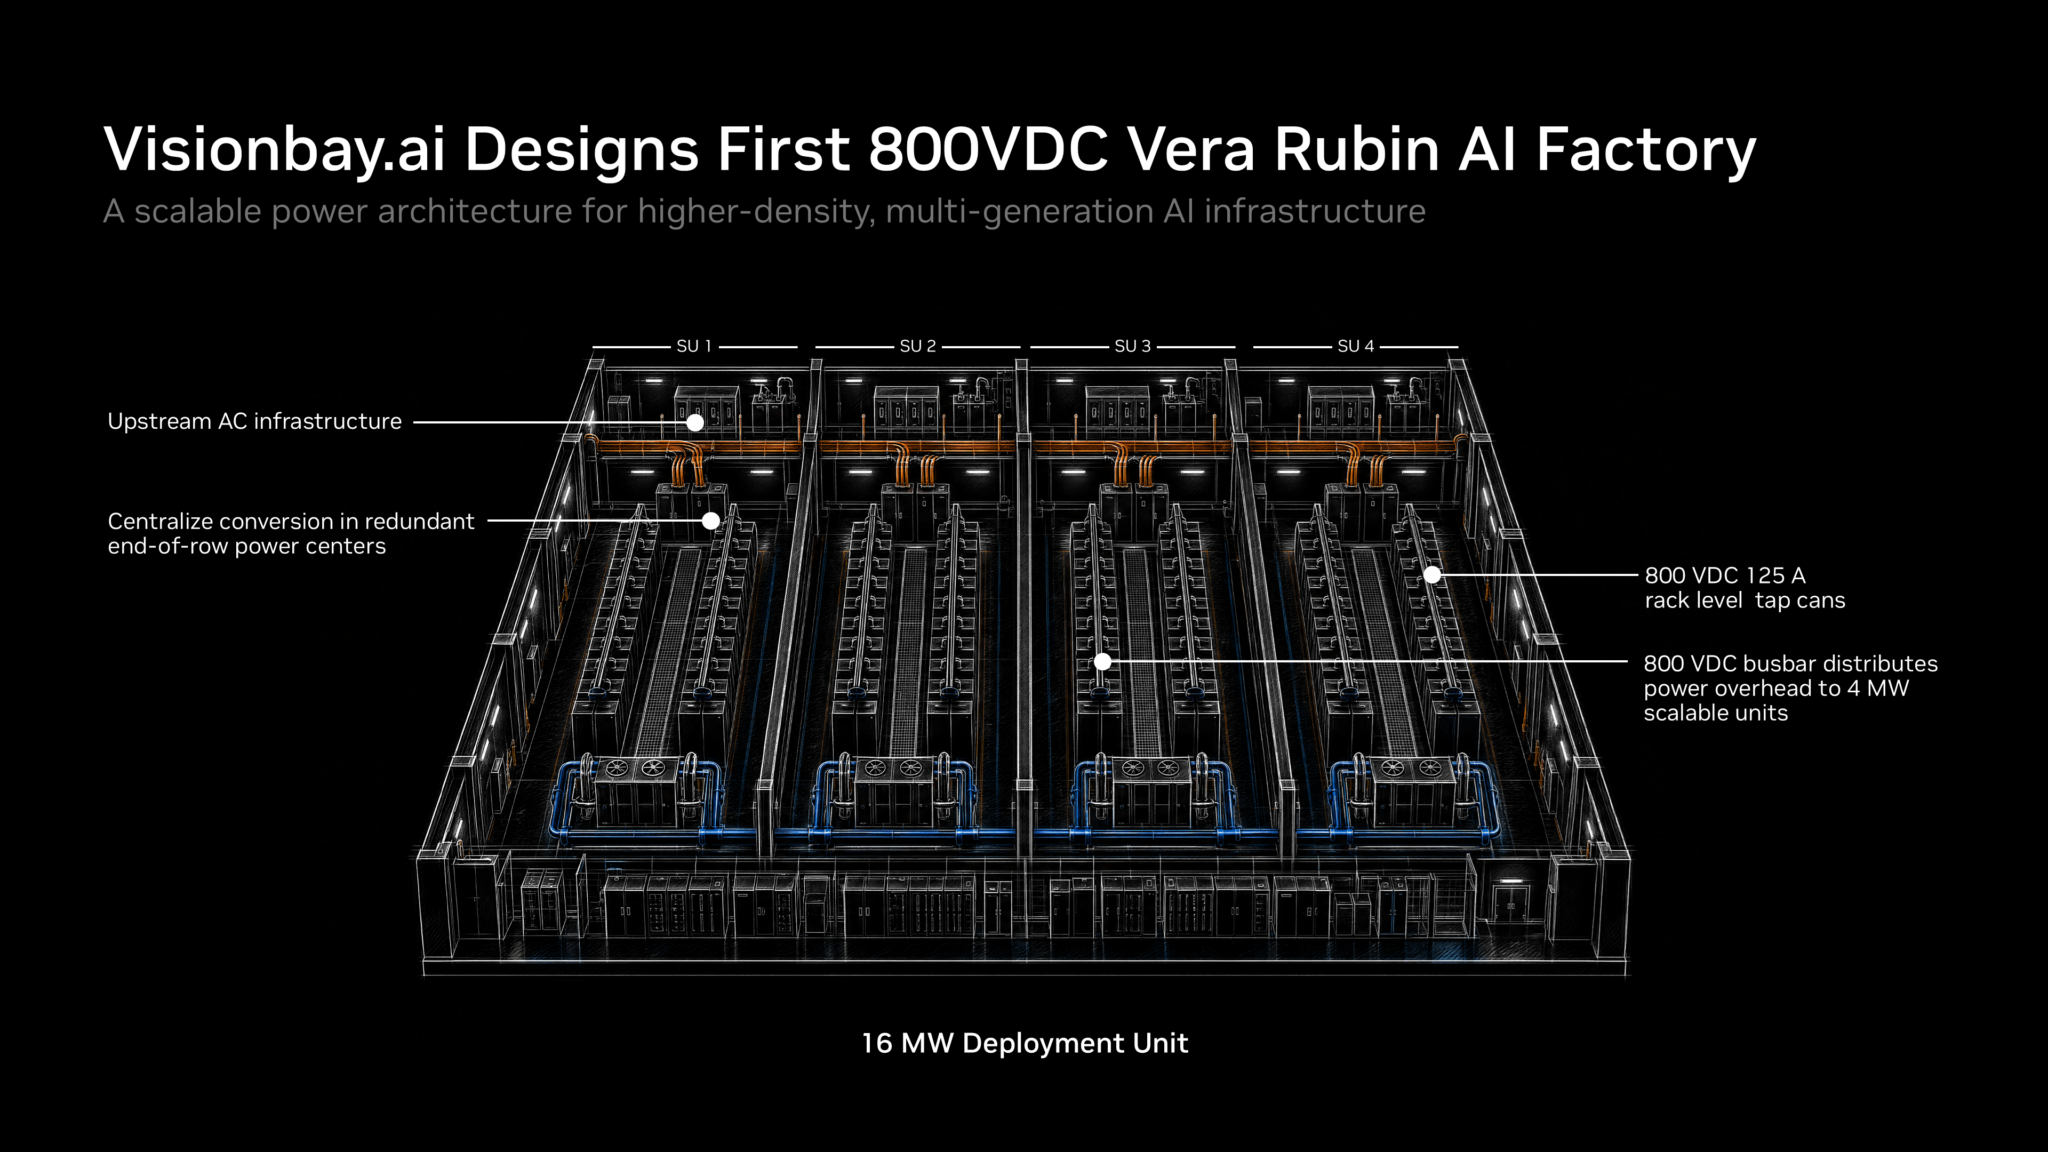
O projeto combina a arquitetura de referência de 800 VDC da NVIDIA com tecnologias de energia e térmicas da Vertiv.
A arquitetura tem o objetivo de aproximar a distribuição de corrente contínua de alta tensão da camada de computação.
Em vez de converter repetidamente e distribuir energia de menor tensão por meio de uma grande quantidade de cobre, a K-1 usa centros de energia em nível de cluster que centralizam a conversão de CA para CC e então distribuem 800 VDC mais perto dos racks.
Segundo a NVIDIA, essa abordagem pode:
A plataforma também foi projetada para adoção gradual, em vez de exigir que toda uma instalação migre para 800 VDC de uma só vez.
Isso oferece aos operadores um caminho para introduzir corrente contínua de alta tensão onde ela gera mais valor, preservando a compatibilidade com a infraestrutura existente.
Na OCP, Meta e NVIDIA anunciaram mais uma etapa de sua colaboração em redes.
A Meta está adotando switches Ethernet NVIDIA Spectrum-6 de 102,4 Tb/s para fábricas de IA Vera Rubin maiores, executadas em infraestrutura de rede aberta.
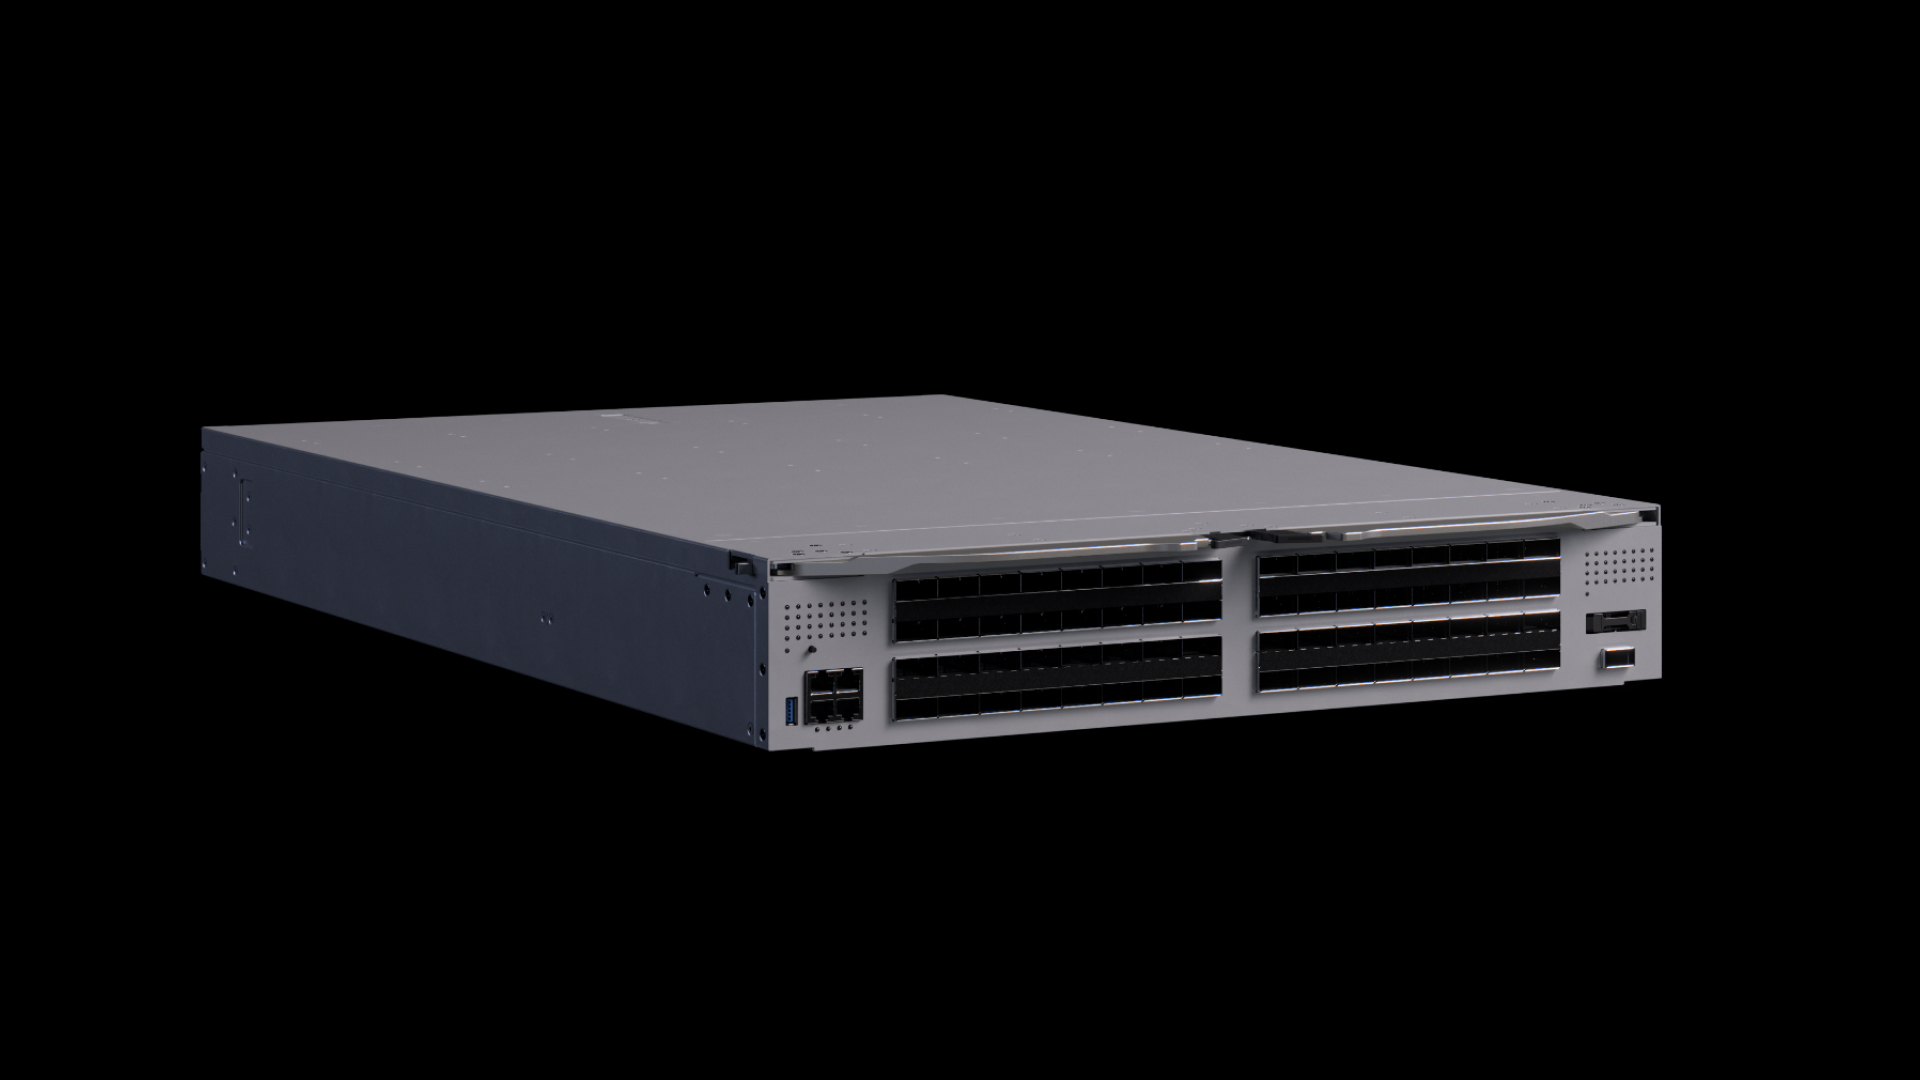
O Spectrum-6 fornece:
O switch baseado em Spectrum-6 da Meta chama-se N-IceCube.
Ele foi projetado para se encaixar no IcePack, o rack de rede resfriado a líquido de 100T da Meta.
O N-IceCube executa o FBOSS, o sistema operacional de rede de código aberto da Meta.
O FBOSS usa a Switch Abstraction Interface (SAI), um padrão da OCP que fornece uma interface independente de fornecedor para o controle de hardware de switches.
Isso permite que a Meta use um plano de controle de software conhecido enquanto adota o silício de comutação Spectrum-6.
Uma parte importante da colaboração é a tecnologia Spectrum-X Multiplane.
Usando switches Spectrum-6 e SuperNICs ConnectX-9, o Multiplane distribui o tráfego de GPU em hardware por até oito planos de rede independentes.
O projeto foi pensado para suportar fábricas de IA com mais de 100.000 GPUs, reduzindo o número de camadas de switches necessárias.
Múltiplos caminhos também melhoram a resiliência.
Se um componente de rede falhar, o tráfego pode migrar para os planos restantes. A carga de trabalho pode continuar com largura de banda reduzida, em vez de perder toda a malha.
O resultado é uma arquitetura de rede concebida para ser altamente escalável e mais fácil de operar em condições reais de produção.
À medida que os clusters de IA crescem, a própria conexão óptica física se torna um fator limitante.
A NVIDIA e a Cisco anunciaram planos para o Ultra-Dense Small Form Factor Pluggable (USFP), um novo módulo transceptor óptico conectável projetado para redes de IA de próxima geração.
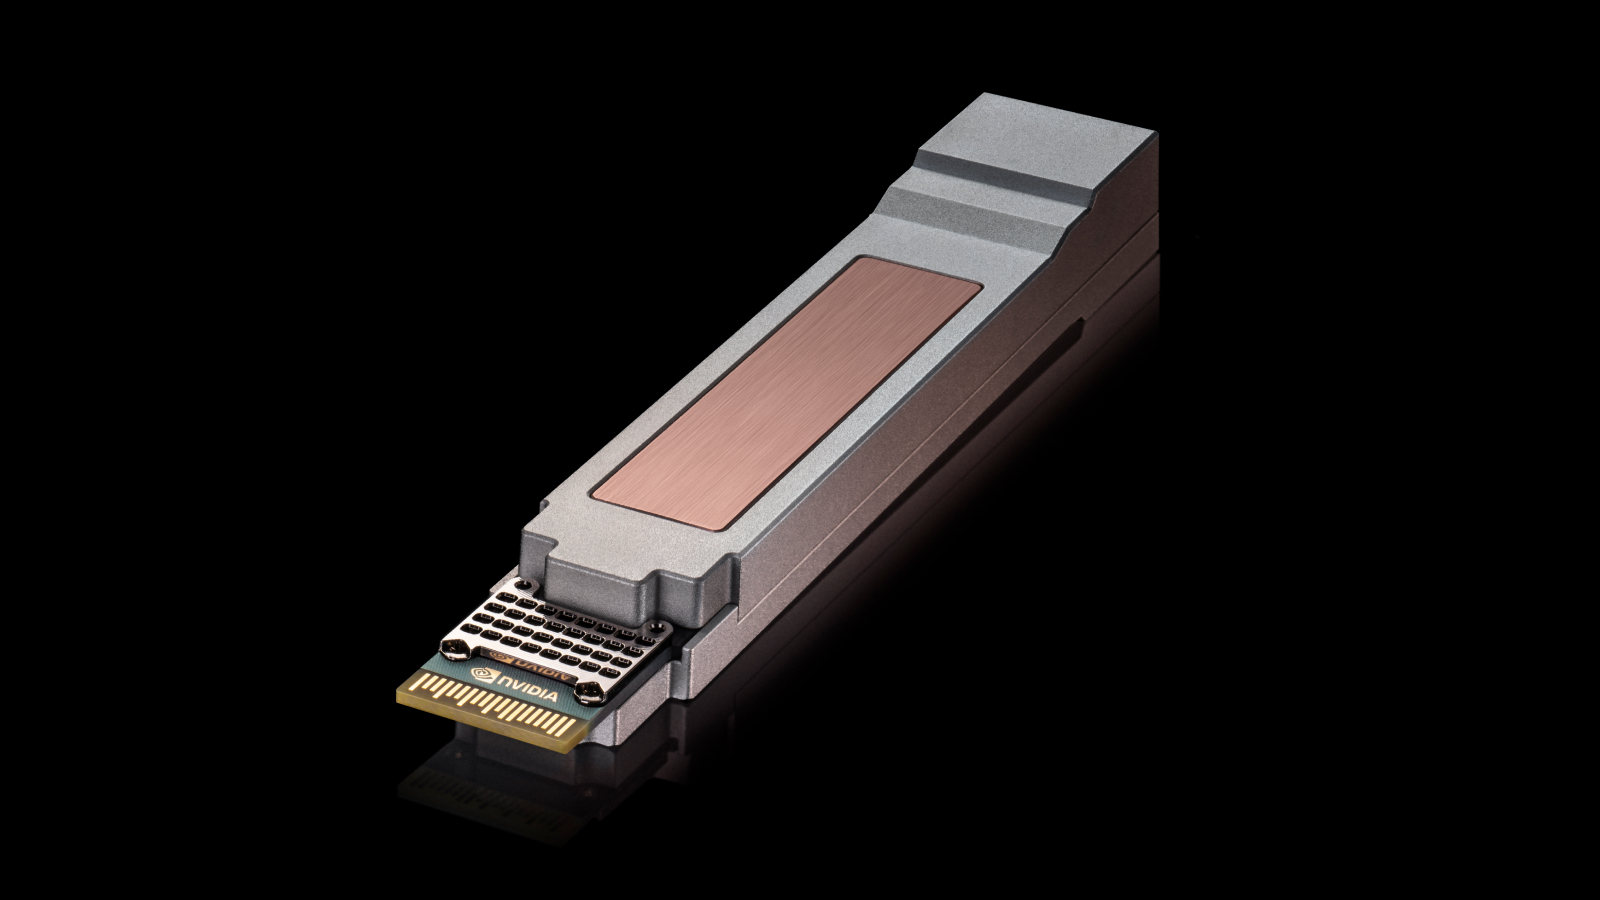
O USFP foi projetado para fornecer um caminho para redes de 400 Gb/s por faixa, mantendo aproximadamente a mesma área ocupada pelo formato OSFP de 200 Gb/s por faixa amplamente utilizado.
O projeto planejado inclui:
O objetivo é conectar mais recursos de computação sem adicionar camadas extras de rede que aumentam a latência, o consumo de energia e a complexidade operacional.
A NVIDIA e a Cisco estão trabalhando com a TE Connectivity e a Amphenol em gaiolas, conectores e módulos, e planejam avançar o USFP por meio de um esforço multifuente liderado pela comunidade.
Isso mantém o projeto alinhado ao tema mais amplo da OCP de interoperabilidade, em vez de um ecossistema óptico de fornecedor único.
A NVIDIA e o Google também anunciaram que o Falcon Transport terá suporte em futuras SuperNICs NVIDIA ConnectX-10 e DPUs BlueField.
O Falcon é um protocolo de transporte projetado para comunicação confiável e de alto desempenho em redes Ethernet, especialmente sob congestionamento.
Ele inclui suporte a:
A colaboração combina a aceleração de hardware da NVIDIA com o software DOCA para implementar o Falcon, mantendo interfaces de programação RDMA padrão disponíveis para as aplicações.
Isso é importante porque fornece ao hardware de rede da NVIDIA e do Google uma camada de transporte comum, permitindo que o software continue a usar APIs RDMA conhecidas.
Em grandes malhas de IA, o Falcon pode distribuir tráfego entre caminhos, adaptar-se ao congestionamento e recuperar-se de perda de pacotes sem exigir que as aplicações gerenciem diretamente esses detalhes.
A NVIDIA contribuiu com projetos essenciais de racks e bandejas de computação Vera Rubin para a OCP por meio da arquitetura aberta MGX e participou de novos padrões de instalações, rede elétrica e rede. Também lançou quatro novos componentes de infraestrutura de código aberto do DSX OS.
O MGX 1.2 é uma arquitetura de referência atualizada em escala de rack para computação acelerada de alta densidade. Ela adiciona resfriamento líquido blind-mate, um barramento de 5.000 A, suporte nativo a 19 polegadas, baias de E/S configuráveis e suporte para racks de até 250 kW.
Os componentes recém-destacados são NVIDIA Config Manager, Cluster Readiness Engine, Rack Management Service e Cluster API Provider for NVIDIA Infrastructure Controller. Eles abrangem configuração de rede, testes de integridade de clusters, operações em nível de rack e provisionamento bare metal.
A distribuição de corrente contínua de maior tensão pode reduzir a quantidade de cobre, cabeamento e equipamentos de conversão necessários à medida que a potência do rack aumenta. O projeto da NVIDIA pretende suportar futuros racks de IA em classe de megawatts, permitindo ao mesmo tempo adoção gradual em instalações existentes.
O Spectrum-6 é a plataforma de switch Ethernet de 102,4 Tb/s da NVIDIA para fábricas de IA. Ela fornece rede de 200 Gb/s por faixa e está sendo adotada pela Meta como parte de sua arquitetura N-IceCube e Spectrum-X Multiplane.
O USFP é um novo formato de módulo óptico conectável que está sendo desenvolvido pela NVIDIA e Cisco para redes de 400 Gb/s por faixa. Ele foi projetado para aumentar a densidade de largura de banda e a eficiência energética, preservando a capacidade de manutenção das ópticas conectáveis.
O Falcon é o protocolo Ethernet de alto desempenho do Google. Espera-se que futuras SuperNICs ConnectX-10 e DPUs BlueField o suportem por meio da aceleração de hardware da NVIDIA e do software DOCA, preservando as interfaces de programação RDMA.
Sim. A NVIDIA anunciou em maio de 2026 que o Vera Rubin estava entrando em produção plena, com parceiros globais de sistemas e cadeia de suprimentos fabricando sistemas em escala.
No OCP Global Summit 2026, a NVIDIA expandiu o Vera Rubin de uma plataforma de computação para um plano de infraestrutura mais aberto. O MGX 1.2 padroniza mais elementos do projeto de rack, resfriamento e energia, enquanto o DSX OS adiciona ferramentas de código aberto para configurar, validar e operar grandes clusters de IA.
O ecossistema ao redor está se movendo na mesma direção. Novas especificações da OCP para instalações e rede elétrica definem como grandes fábricas de IA devem ser construídas e como devem se comportar durante perturbações de energia. O projeto de 800 VDC da Visionbay aborda a crescente densidade dos racks, enquanto Meta, Cisco e Google ampliam a pilha de rede por meio do Spectrum-6, USFP e Falcon Transport.
O tema central é a interoperabilidade: o Vera Rubin está se tornando não apenas uma plataforma de GPU, mas uma arquitetura de referência compartilhada que abrange computação, rede, energia, resfriamento e operações.
Comece com uma frase e tenha um site completo em minutos.



