For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/openai-28-day-sprint-day-1-gpt-6-speed-bo-37dfc44c.md.
A OpenAI começou outubro com um compromisso público incomum de Thibault “Tibo” Sottiaux, que lidera o trabalho nos produtos Codex e ChatGPT.
A OpenAI começou outubro com um compromisso público incomum de Thibault “Tibo” Sottiaux, que lidera o trabalho nos produtos Codex e ChatGPT.
Durante 28 dias, a equipe afirmou que faria uma de duas coisas a cada dia: lançar uma melhoria clara e relevante para a maioria dos usuários de Codex ou ChatGPT Work, ou emitir uma redefinição completa de uso.
A primeira entrega chegou em 5 de outubro de 2026. A OpenAI informou que otimizou a velocidade de resposta padrão do GPT-6 Astra e do GPT-6.1 Sol em aproximadamente 50% para usuários de assinaturas nos produtos da OpenAI e em parceiros compatíveis que usam Sign in with ChatGPT.
Isso parece uma vitória fácil. Mas a reação foi mais complexa.
O anúncio de velocidade chegou ao mesmo tempo que outras três mudanças importantes para usuários avançados: a OpenAI introduziu um novo formato de publicidade visual para o ChatGPT, publicou seu plano de marca-d’água de texto para a UE e alterou a economia de suas assinaturas Pro de nível mais alto. Um novo relatório da SemiAnalysis argumentou então que as assinaturas da Anthropic atualmente oferecem valor equivalente de API substancialmente maior em algumas categorias comuns de modelos.
O resultado foi um primeiro dia que pareceu menos uma celebração tranquila e mais um retrato das concessões que a OpenAI tenta administrar: modelos mais rápidos, custos de infraestrutura mais altos, nova monetização, conformidade regulatória e usuários que comparam cada limite e token com produtos concorrentes.
O sprint de 28 dias começou com uma regra simples.
Tibo disse que, nos 28 dias seguintes, a OpenAI lançaria uma melhoria claramente relevante para a maioria dos usuários de Codex e ChatGPT Work a cada dia ou forneceria uma redefinição completa.
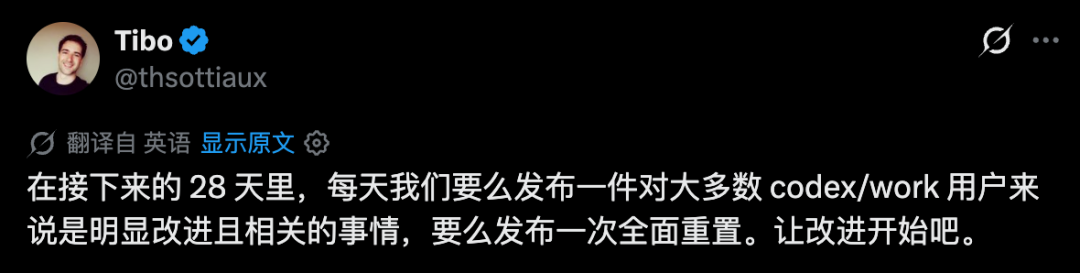
A equipe também restringiu suas prioridades de curto prazo a algumas áreas:
O compromisso surgiu após um período de frustração particularmente visível em relação à velocidade dos modelos, indisponibilidades e mudanças nas cotas de uso.
Para o Dia 1, a OpenAI escolheu o desempenho de inferência.
O primeiro item lançado foi uma otimização de velocidade padrão para GPT-6 Astra e GPT-6.1 Sol.
O atual Centro de Ajuda da OpenAI descreve a melhoria como um aumento de aproximadamente 50% na velocidade de geração de texto na configuração de velocidade padrão.
A alteração se aplica quando os modelos são usados por meio de uma assinatura do ChatGPT em produtos da OpenAI ou em aplicativos parceiros compatíveis que autenticam com Sign in with ChatGPT, incluindo exemplos como OpenCode, Pi, Amp e Devin.
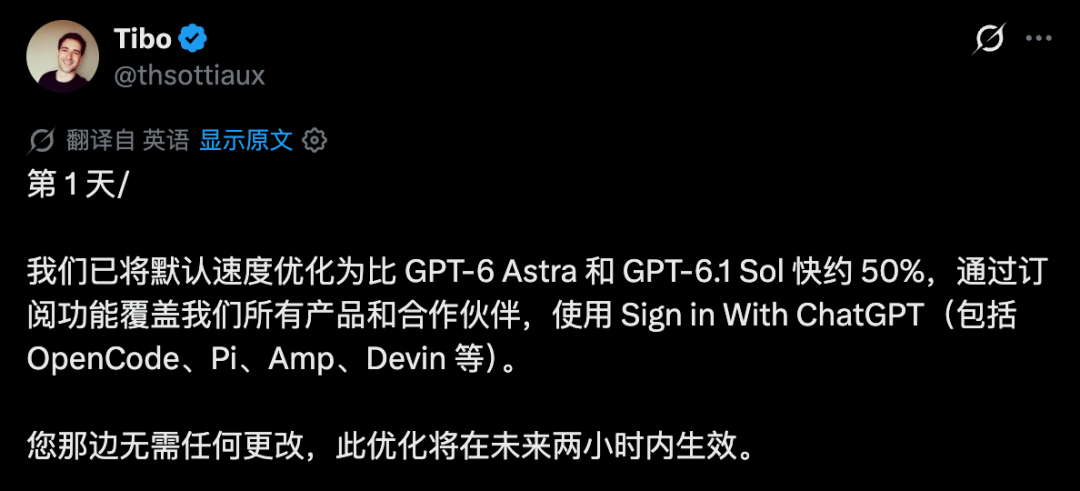
O usuário não precisa ativar Fast ou Ultrafast para receber essa otimização de velocidade padrão.
O rastreador da comunidade da OpenAI descreveu a mudança como uma elevação da taxa de saída padrão de cerca de 30 tokens por segundo para aproximadamente 50 tokens por segundo.
Esse número exige uma ressalva importante: uma geração de tokens mais rápida não significa que uma tarefa completa de Codex ou Work seja concluída 50% mais cedo.
Tarefas agênticas frequentemente consomem tempo em atividades como:
Se a geração de texto pelo modelo é apenas uma parte do tempo total da tarefa, a latência de ponta a ponta pode melhorar muito menos do que sugere a porcentagem do título.
O GPT-6.1 Sol já havia recebido reclamações sobre latência logo após seu lançamento em 29 de setembro.
A fonte da BAAI observa que alguns usuários consideraram as respostas até mesmo no modo Fast mais lentas do que o esperado durante períodos de alta carga. Tibo reconheceu publicamente uma carga excepcionalmente alta e afirmou que o desempenho do serviço estava sendo restaurado, com redefinições de uso oferecidas a usuários pagantes afetados.
Isso ajuda a explicar por que a otimização de inferência se tornou o primeiro item do programa de 28 dias.
A OpenAI não estava adicionando um novo modelo no Dia 1. Ela estava tornando os modelos que as pessoas já utilizavam mais rápidos na prática.
O anúncio de velocidade não foi a única novidade da OpenAI naquela semana.
Em 5 de outubro, a OpenAI anunciou um novo formato de anúncio visual para o ChatGPT.
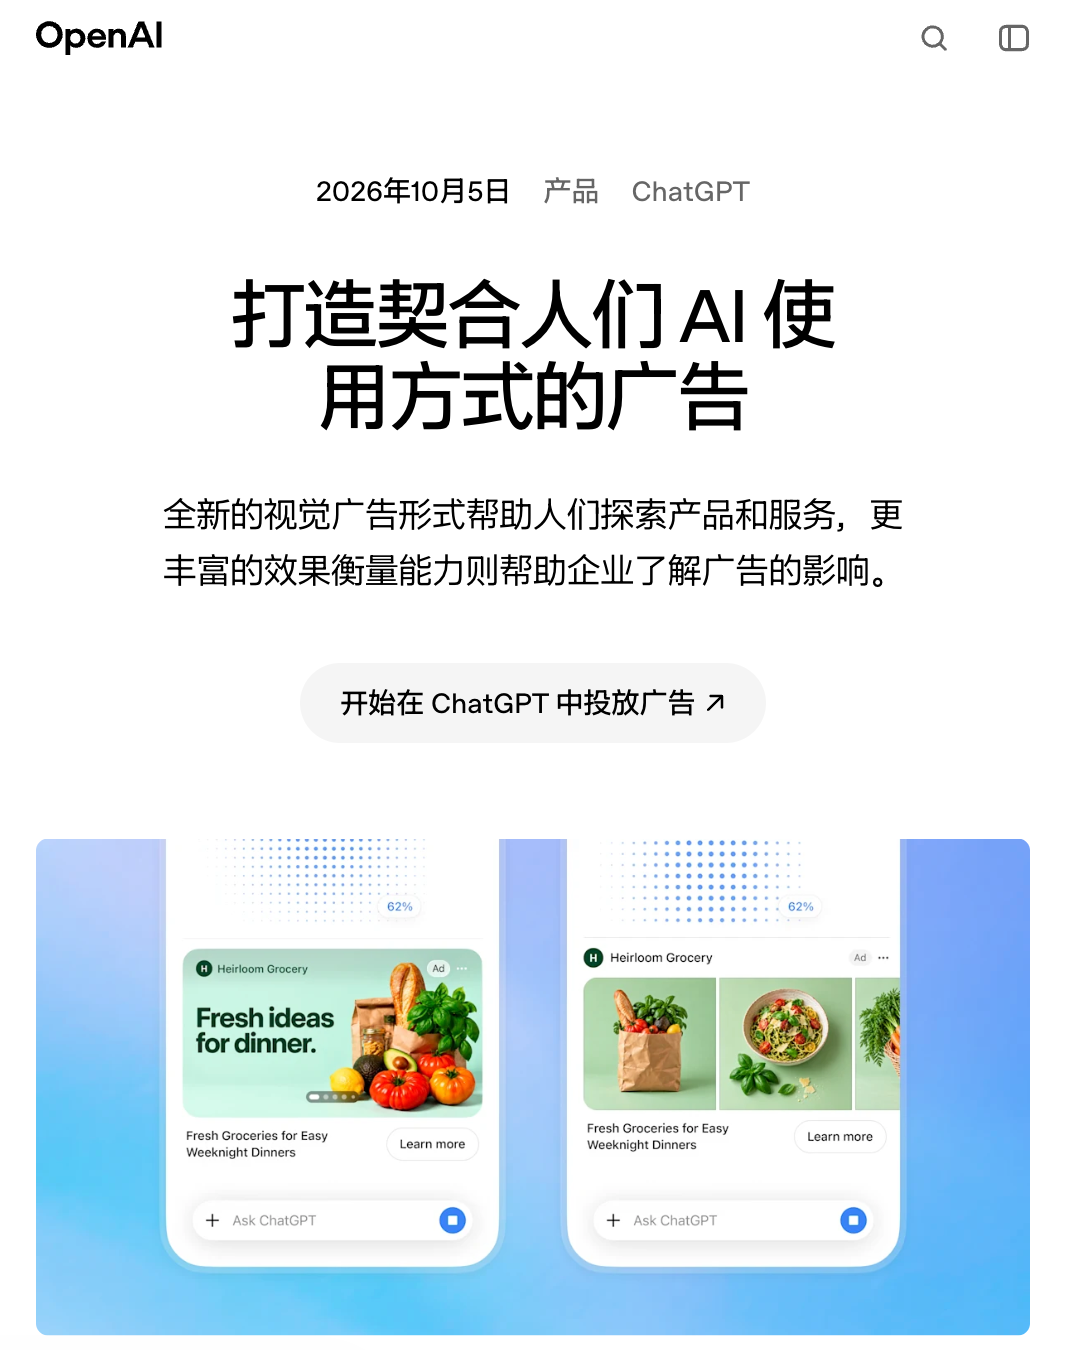
O formato foi criado para mostrar inspiração de produtos, uso de produtos ou outras imagens de marcas enquanto as pessoas exploram produtos e serviços no ChatGPT.
O primeiro teste é mais restrito do que algumas manchetes sugerem.
A OpenAI afirma que a implantação inicial irá:
A empresa também afirma que os anúncios serão claramente identificados e permanecerão separados da imagem que está sendo gerada.
Segundo a OpenAI, a publicidade não influencia as respostas do ChatGPT.
O anúncio vai além de uma nova unidade visual.
A OpenAI está desenvolvendo uma estrutura mais ampla de medição publicitária com parceiros de atribuição, dados de conversão, incrementalidade e adequação de marca.
Os parceiros nomeados pela OpenAI incluem serviços como:
A OpenAI afirma que o ChatGPT agora alcança 1,2 bilhão de pessoas por semana, tornando a publicidade um modelo de negócios adicional significativo ao lado das assinaturas.
Os princípios declarados pela empresa permanecem os de que as respostas devem continuar independentes, as conversas dos usuários devem permanecer privadas dos anunciantes e as pessoas devem manter o controle sobre sua experiência com anúncios.
Um segundo anúncio concentrou-se em proveniência, e não em monetização.
A OpenAI publicou seu plano para cumprir os requisitos de transparência da Lei de IA da UE por meio da introdução de uma marca-d’água estatística de texto chamada textGrain.
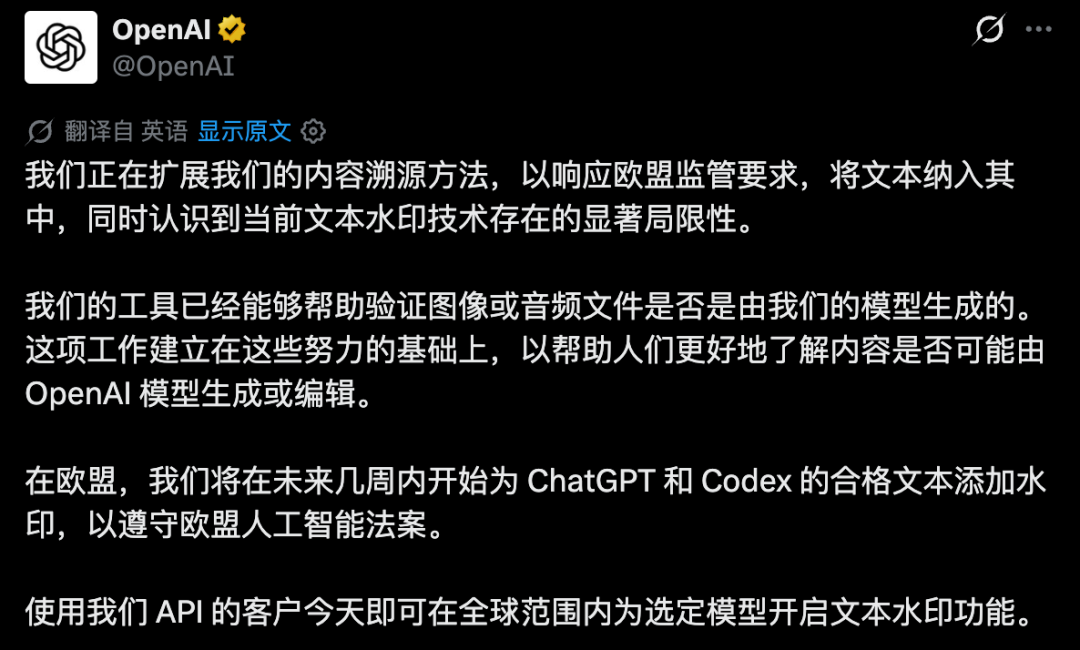
A marca-d’água não é um caractere Unicode oculto, um espaço invisível ou uma etiqueta de metadados.
Em vez disso, o textGrain afeta sutilmente a forma como o modelo escolhe entre possíveis palavras ou partes de palavras. Em uma passagem suficientemente longa, essas escolhas criam um sinal estatístico que um detector pode procurar.
A implementação da OpenAI possui dois caminhos distintos:
| Caminho do produto | Status da marca-d’água |
|---|---|
| ChatGPT e Codex na UE | Implementação nas próximas semanas para saídas de texto elegíveis |
| API da OpenAI no mundo todo | Adesão opcional para modelos selecionados; desativada por padrão |
| Detector público | Não disponibilizado amplamente no lançamento |
| Acesso para pesquisadores/especialistas | Disponível mediante solicitação, caso a caso |
O artigo de origem conecta corretamente a medida à Lei de IA da UE, mas é importante não descrever a marca-d’água como um padrão global do ChatGPT no lançamento.
A OpenAI afirma explicitamente que a implementação inicial no ChatGPT e Codex é somente na UE.
A OpenAI é excepcionalmente direta sobre o que a marca-d’água não pode provar.
Uma marca-d’água detectada não estabelece:
A ausência de uma marca-d’água detectada também não prova autoria humana.
A própria avaliação da OpenAI mostra o motivo. Com uma taxa-alvo de falsos positivos de 1%, a detecção se torna mais forte em passagens mais longas e sem restrições, enquanto textos curtos, altamente restritos, traduzidos ou editados podem ser muito mais difíceis de classificar.
A empresa informa que substituir até mesmo uma fração modesta de palavras por sinônimos pode enfraquecer significativamente o sinal.
Portanto, o textGrain é um sinal de proveniência, e não um detector infalível de autoria.
Se anúncios e marcas-d’água irritaram alguns usuários, a economia das assinaturas foi mais diretamente relevante para desenvolvedores que usam Codex e fluxos de trabalho com agentes de forma intensa.
Em 5 de outubro, a empresa independente de pesquisa de semicondutores e infraestrutura de IA SemiAnalysis publicou um relatório que mede os limites práticos dos principais planos de assinatura de IA.
O relatório tenta estimar o valor equivalente de API, em vez de simplesmente comparar preços mensais.
A SemiAnalysis mede a velocidade com que os medidores de uso de assinaturas avançam sob cargas de trabalho controladas, estima quantos tokens cabem nas janelas de uso de um plano e, em seguida, converte esses limites em valor usando os preços correspondentes de API.
Essa metodologia é útil, mas ainda é uma estrutura analítica criada pela SemiAnalysis, e não uma avaliação oficial dos planos pela OpenAI ou Anthropic.
A SemiAnalysis argumenta que as assinaturas para consumidores são altamente subsidiadas em comparação com o uso direto de API.
Para a Anthropic, seu modelo aproximado estima que as assinaturas representem cerca de 10% da receita, enquanto consomem mais de 40% da capacidade computacional de inferência.
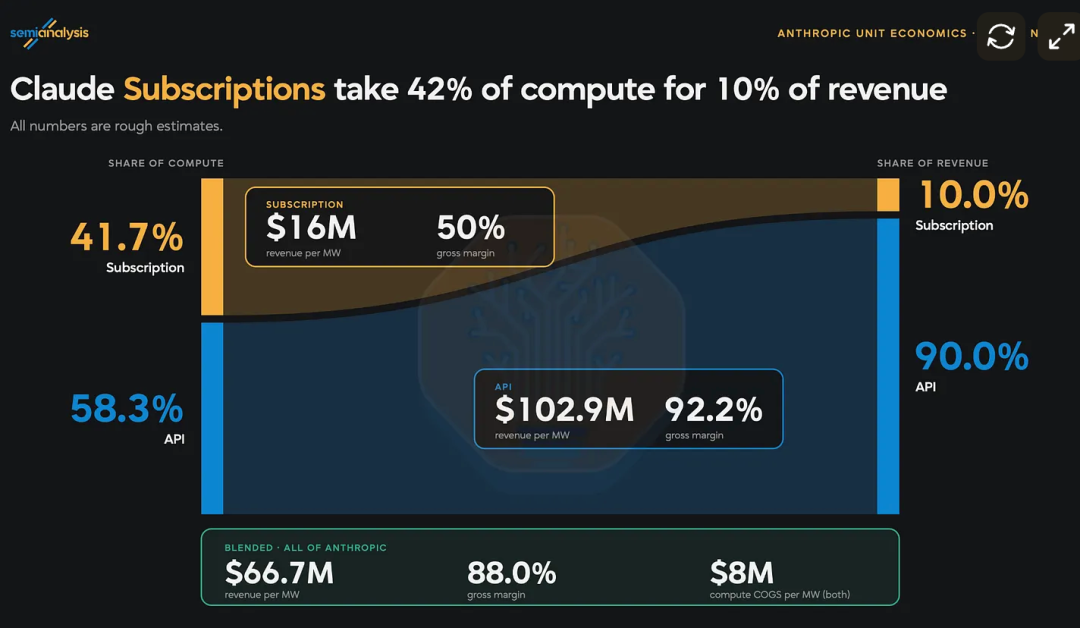
A empresa estima que isso reduz a receita combinada por megawatt em aproximadamente US$ 36 milhões, em comparação com uma combinação de carga de trabalho mais intensiva em API.
A economia exata são estimativas, e não divulgações financeiras das empresas.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Mas a pressão mais ampla é fácil de entender: assinaturas mensais fixas incentivam o uso pesado, enquanto a inferência de modelos de fronteira continua cara.
Isso cria uma tensão contínua entre limites de uso generosos e margens sustentáveis.
A OpenAI agora oferece três níveis mensais Pro:
| Plano | Preço mensal | Astra Ultrafast |
|---|---|---|
| Pro 100 | US$ 100 | Não |
| Pro 200 | US$ 200 | Não |
| Pro 500 | US$ 500 | Sim |
O Pro 500 foi lançado em 29 de setembro e inclui o maior uso agregado entre os três planos Pro, além de acesso ao Astra Ultrafast no ChatGPT Work e Codex.
A OpenAI também reduziu a franquia incluída para assinaturas Pro 200 recém-adquiridas. Clientes elegíveis para manutenção das condições anteriores podem preservar a franquia anterior até 29 de outubro de 2026.
Essa mudança é real e documentada pela OpenAI.
O que a SemiAnalysis acrescenta é uma medição de quanto uso prático dos modelos esses níveis aparentemente contêm.
Segundo a empresa, o plano Pro 200 atualizado da OpenAI fornece aproximadamente metade do valor equivalente de API anterior sob sua metodologia de teste.
O relatório também afirma que o novo nível de US$ 500 oferece apenas cerca de 21% mais uso do GPT-6 Astra do que o antigo nível de US$ 200 com condições anteriores, embora o Pro 500 acrescente o benefício separado do Astra Ultrafast.
Isso torna o novo plano de US$ 500 difícil de avaliar com um único número: seu valor depende parcialmente de o usuário se importar com a taxa máxima de processamento, e não apenas com o volume de tokens.
O gráfico mais discutido compara o GPT-6.1 Sol ao Claude Opus 5.5 em uma carga de trabalho agêntica.
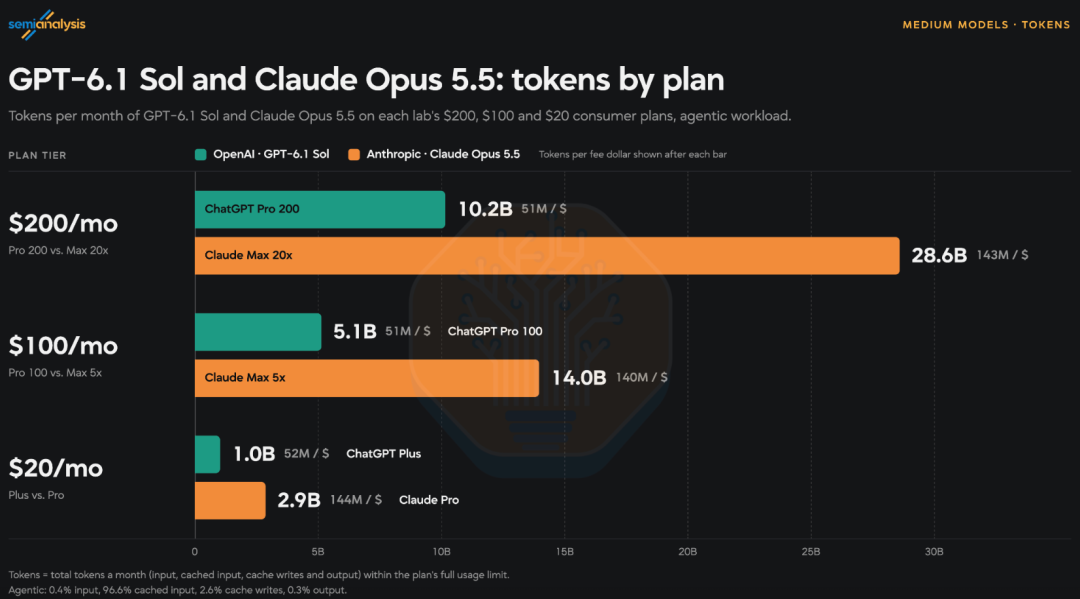
A SemiAnalysis conclui que a Anthropic oferece aproximadamente 5× o valor equivalente de API nessa comparação de nível intermediário.
Isso não significa que toda assinatura Claude seja cinco vezes melhor para todos os usuários.
O resultado depende de:
A própria SemiAnalysis observa que a eficiência de tokens é difícil de medir de forma confiável e que o valor equivalente de API pode ser enganoso se o preço da API não corresponder claramente à utilidade prática.
Ainda assim, o relatório fornece aos desenvolvedores um motivo concreto para comparar assinaturas com base na carga de trabalho real, em vez de apenas nos rótulos de marketing.
Após o anúncio de velocidade do Dia 1, alguns usuários começaram a medir por conta própria a nova taxa de processamento padrão.
Um resultado amplamente compartilhado mostrou o GPT-6.1 Sol Standard com média de cerca de 31,7 tokens por segundo durante um período de medição, com uma janela curta mais recente próxima da faixa de 30 e poucos tokens.
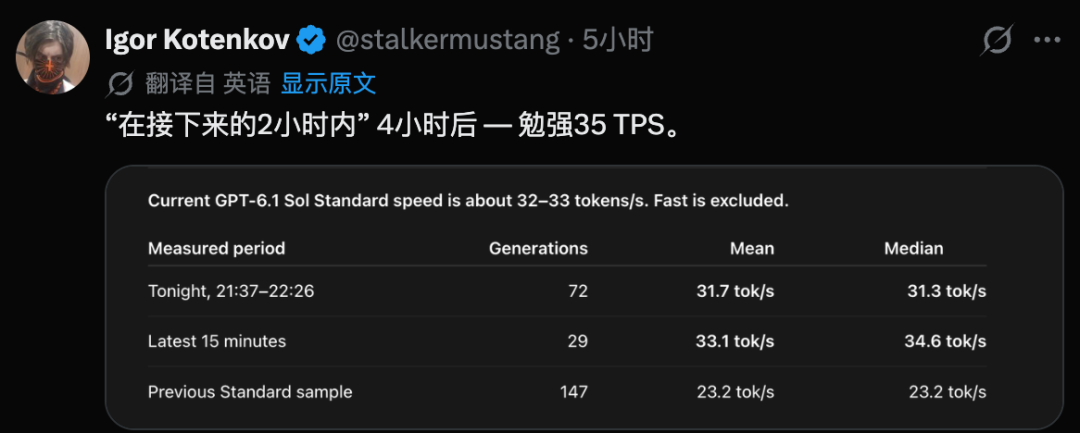
Isso ficou abaixo da marca de aproximadamente 50 tokens por segundo associada ao anúncio da implementação.
Isso não significa necessariamente que a otimização falhou.
A velocidade observada pode variar conforme:
O próprio Centro de Ajuda da OpenAI afirma que o suporte atualmente não consegue verificar a melhoria de velocidade para uma conta individual.
Portanto, a alegação oficial deve ser entendida como uma otimização no nível da plataforma, e não como uma taxa de processamento fixa garantida para cada solicitação.
Outra reação no artigo de origem foi mais cética: alguns usuários argumentaram que o GPT-6.1 Sol já havia desacelerado substancialmente após o lançamento, de modo que o aumento de velocidade do Dia 1 pareceu restaurar desempenho perdido, em vez de introduzir uma capacidade genuinamente nova.
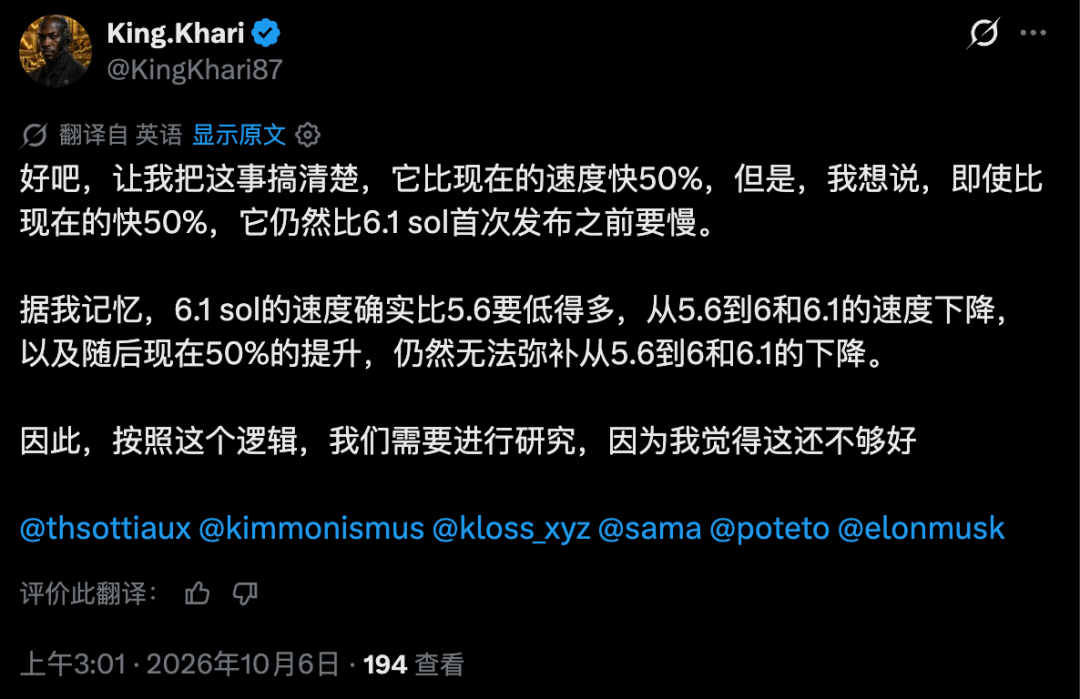
Esse argumento é difícil de provar com dados públicos porque não existe um único gráfico histórico oficial da taxa de inferência por usuário antes e depois de cada evento de carga.
O que está confirmado é que a OpenAI reconheceu uma carga excepcionalmente alta em torno do GPT-6.1 Sol e, posteriormente, lançou uma otimização de inferência destinada a melhorar a velocidade padrão de geração de texto.
A reação dos usuários ainda importa porque explica por que uma melhoria de desempenho tecnicamente significativa não gerou automaticamente uma resposta positiva.
Os usuários avaliam uma atualização em relação à experiência anterior, não apenas em relação ao benchmark atual da empresa.
Considerada isoladamente, uma taxa de resposta padrão mais rápida é uma melhoria direta na qualidade de uso.
Mas o Dia 1 chegou em meio a diversas mudanças sobrepostas:
Isso tornou a reação menos relacionada a uma otimização de inferência e mais relacionada ao que os usuários acreditam que a OpenAI está priorizando.
Para desenvolvedores, a pergunta central é prática:
Os modelos estão se tornando mais rápidos e úteis com rapidez suficiente para compensar limites mais restritos, níveis mais caros e uma experiência de produto mais comercializada?
Não há uma resposta única.
Um usuário que valoriza Astra Ultrafast, Codex Cloud ou o ecossistema mais amplo de ferramentas da OpenAI pode chegar a uma conclusão muito diferente da de um desenvolvedor que otimiza puramente por tokens de modelo por dólar de assinatura.
O programa de 28 dias cria um ciclo de feedback incomumente público.
Em vez de anunciar um grande roteiro e pedir que os usuários aguardem, a OpenAI está se obrigando a produzir melhorias visíveis em uma cadência diária ou compensar os usuários com uma redefinição.
O primeiro dia concentrou-se na velocidade de inferência.
Até 8 de outubro, o desafio já havia avançado além do Dia 1, com atualizações posteriores incluindo Auto Review gratuito, simplificação de limites de taxa de API, um plugin de reuniões, beta público da Decisions API, redefinições e GPT-6 com Intelligent UI.
Este artigo permanece focado no retrato do Dia 1, pois esse é o tema do relatório original da BAAI.
O teste mais importante é o que os 28 dias completos somarão.
Se o programa entregar melhorias que os usuários realmente sintam no trabalho diário de programação e conhecimento, a otimização de velocidade parecerá um primeiro passo razoável.
Se as atualizações posteriores parecerem cosméticas enquanto limites e preços continuarem sendo a principal fonte de atenção, o ceticismo observado no Dia 1 será mais difícil de reverter.
Durante 28 dias, Tibo Sottiaux, da OpenAI, afirmou que a equipe lançaria a cada dia uma melhoria clara e relevante para a maioria dos usuários de Codex e ChatGPT Work ou emitiria uma redefinição completa. O programa começou no início de outubro de 2026.
A OpenAI descreve a otimização do Dia 1 como um aumento de aproximadamente 50% na velocidade padrão de geração de texto. Isso não significa que toda tarefa completa de Work ou Codex será concluída 50% mais rápido, pois uso de ferramentas, navegação, raciocínio e serviços externos também consomem tempo.
Não. A OpenAI afirma que a melhoria se aplica à configuração de velocidade padrão. Fast e Ultrafast são níveis de serviço e opções de produto separados.
A OpenAI afirma que o teste inicial de anúncios visuais começará no fim de outubro de 2026 nos Estados Unidos, durante a geração de imagens para usuários Free e Go. Os anúncios serão identificados e separados da imagem gerada.
Não. A OpenAI planeja adicionar a marca-d’água textGrain a textos elegíveis do ChatGPT e Codex na União Europeia nas próximas semanas. Clientes da API em todo o mundo podem optar pela funcionalidade em modelos selecionados, mas a marca-d’água vem desativada por padrão na API.
O Pro 500 é o nível Pro de US$ 500 por mês da OpenAI. Ele inclui o maior uso agregado entre os planos Pro e acesso ao Astra Ultrafast no ChatGPT Work e Codex.
Sim. A OpenAI documenta uma franquia incluída menor para assinaturas Pro 200 recém-adquiridas, enquanto usuários elegíveis com condições anteriores podem manter a franquia anterior até 29 de outubro de 2026.
Essa é uma conclusão da SemiAnalysis para comparações específicas de modelos e cargas de trabalho usando sua metodologia de valor equivalente de API. Ela não deve ser tratada como uma medida universal de qualidade ou utilidade do modelo para todos os usuários.
A OpenAI iniciou seu sprint de lançamentos de 28 dias para Codex e ChatGPT Work com uma melhoria real de infraestrutura: GPT-6 Astra e GPT-6.1 Sol agora geram texto aproximadamente 50% mais rápido na configuração de velocidade padrão em produtos por assinatura e parceiros compatíveis com Sign in with ChatGPT.
A reação moderada faz mais sentido quando observada junto de tudo o que ocorria ao mesmo tempo. A OpenAI está testando anúncios visuais, implementando marcas-d’água de texto na UE, reestruturando as franquias de uso do Pro e vendendo um novo nível de US$ 500 com Astra Ultrafast, enquanto a SemiAnalysis argumenta que a Anthropic atualmente entrega muito mais valor equivalente de API em várias comparações comuns de assinaturas.
O debate do primeiro dia, portanto, não é realmente sobre tokens por segundo. É sobre a proposta de valor completa que os usuários agora avaliam: qualidade do modelo, velocidade, limites, preços, ferramentas, privacidade, publicidade e confiabilidade.
O Dia 1 tornou os modelos mais rápidos; os 27 dias restantes determinarão se a OpenAI conseguirá tornar a experiência geral de Codex e Work significativamente melhor.
Comece com uma frase e tenha um site completo em minutos.



