A série GPT-5.6 da OpenAI inclui três níveis de modelos: Sol, Terra e Luna. Em vez de oferecer um modelo único para todas as cargas de traba...

A série GPT-5.6 da OpenAI inclui três níveis de modelo: Sol, Terra e Luna.
Em vez de oferecer um único modelo para todas as cargas de trabalho, a OpenAI diferencia a série com base em capacidade, custo e taxa de transferência:
A OpenAI visualizou esta série pela primeira vez em junho de 2026, e ela foi totalmente lançada em 9 de julho. O artigo original da AIBase foi publicado em 30 de julho, destacando as melhorias de eficiência por trás deste lançamento: melhor desempenho por token, níveis de modelo de menor custo e otimizações de infraestrutura e ciclo de agente projetadas para reduzir o custo total de conclusão de trabalho real.
Este foco é crucial. Para sistemas de IA em produção, as métricas relevantes cada vez mais não são apenas o quão inteligente um modelo parece isoladamente, mas quanto trabalho útil ele pode concluir dado um tempo, recurso computacional e orçamento específicos.
A OpenAI descreve Sol, Terra e Luna como níveis de capacidade duradouros, não sufixos temporários.
O número da geração identifica a série GPT-5.6, enquanto os nomes distinguem os níveis esperados de desempenho e custo.
| Modelo | Posicionamento | Preço de Entrada da API | Preço de Saída da API | Janela de Contexto | Saída Máxima |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Modelo principal para trabalho profissional complexo | US$ 5 por 1 milhão de tokens | US$ 30 por 1 milhão de tokens | 1.050.000 tokens | 128.000 tokens |
| GPT-5.6 Terra | Equilíbrio entre inteligência e custo | US$ 2,50 por 1 milhão de tokens | US$ 15 por 1 milhão de tokens | 1.050.000 tokens | 128.000 tokens |
| GPT-5.6 Luna | Carga de trabalho de alta taxa de transferência sensível a custo | US$ 1 por 1 milhão de tokens | US$ 6 por 1 milhão de tokens | 1.050.000 tokens | 128.000 tokens |
Todos os três modelos listam a data de corte de conhecimento de 16 de fevereiro de 2026 e suportam entrada de texto e imagem e saída de texto.
O alias da API gpt-5.6 roteia para GPT-5.6 Sol.
Sol é o nível GPT-5.6 mais capaz da OpenAI.
A OpenAI o posiciona para uso em:
No Artificial Analysis Coding Agent Index v1.1, a OpenAI relata que GPT-5.6 Sol atinge uma pontuação de 80 no modo de raciocínio máximo, em comparação com a pontuação de 77,2 do Claude Fable 5 na mesma tabela.
A OpenAI também afirma que, nesta comparação, Sol usou menos da metade dos tokens de saída, menos da metade do tempo, enquanto seu custo estimado da tarefa é menor.
Isso não significa que Sol seja superior em todos os benchmarks. A própria tabela de lançamento da OpenAI mostra que modelos concorrentes lideram em algumas avaliações. O ponto de venda mais consistente do GPT-5.6 é o desempenho por token e por dólar, em vez de liderar em todas as categorias de tarefas.
Terra é o modelo intermediário na série.
A OpenAI descreve sua capacidade como comparável ao nível GPT-5.5, enquanto cobra:
Isto equivale à metade do preço de US$ 5 / US$ 30 do nível principal anterior.
Portanto, Terra é adequado para cargas de trabalho onde as equipes precisam de raciocínio robusto e capacidades de agente, mas não precisam usar Sol para cada solicitação.
Exemplos típicos incluem:
O modelo suporta a mesma janela de contexto de 1,05 milhão de tokens e saída máxima de 12,8 mil tokens que o Sol.
Luna é projetado para cargas de trabalho onde a taxa de transferência e o custo são mais críticos.
Seus preços de API são:
Isso torna o preço de entrada e saída 80% menor que o Sol.
A OpenAI descreve Luna como seu modelo GPT-5.6 mais rápido e acessível. É adequado para cargas de trabalho como:
O preço mais baixo não significa que Luna seja apenas um modelo utilitário sem raciocínio. Ele ainda suporta as funções de raciocínio do GPT-5.6 e o ecossistema de ferramentas da OpenAI, mas seu teto de capacidade é menor que o Sol.
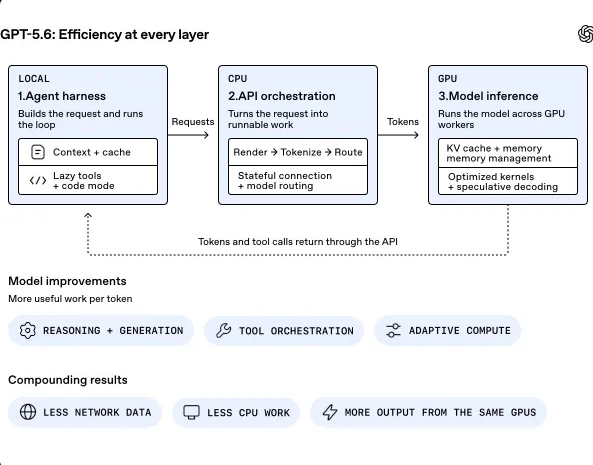
O artigo da AIBase enfatiza que o GPT-5.6 não é apenas uma atualização na qualidade do modelo.
O objetivo maior da engenharia é aumentar a quantidade de trabalho útil produzido por token e reduzir a sobrecarga adicional da execução do agente.
Os materiais oficiais de lançamento da OpenAI apoiam esta direção mais ampla.
A empresa afirma que o GPT-5.6 foi treinado para concluir trabalho útil com menos tokens de saída, e seu guia de desenvolvedores sugere que, ao migrar do GPT-5.5 ou GPT-5.4, teste o mesmo esforço de raciocínio — geralmente reduzindo um nível.
Isto é importante porque o preço anunciado por token é apenas uma parte do custo do agente.
Um fluxo de trabalho de várias etapas pode consumir custos através de:
Portanto, um modelo que requer menos etapas, mesmo que sua taxa nominal por token pareça semelhante, pode ser mais barato na prática.
O artigo original destaca o desempenho do agente de codificação Sol.
Tabela de referência atual da OpenAI
Relatório:
| Avaliação de Codificação | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna | GPT-5.5 |
|---|---|---|---|---|
| Índice de Inteligência de Codificação por Análise de IA v1.1 | 80 | 77,4 | 74,6 | 76,4 |
| SWE-Bench Pro | 64,6% | 63,4% | 62,7% | 59,4% |
| DeepSWE v1.1 | 72,7% | 69,6% | 67,2% | 67,0% |
| Terminal-Bench 2.1 | 88,8% | 87,4% | 84,7% | 85,6% |
Estes dados provêm da tabela de lançamento publicada pela OpenAI e devem ser interpretados no contexto de estruturas e configurações de avaliação específicas.
Por exemplo, os resultados de referência podem variar de acordo com:
A OpenAI também observa que algumas de suas comparações de custo e latência são baseadas em estimativas offline do comportamento de produção, e não em faturamento direto de cada serviço concorrente.
A lição prática é testar modelos em cargas de trabalho representativas de produção, em vez de selecionar modelos apenas com base em rankings.
A fonte AIBase descreve a otimização de toda a pilha de serviços, incluindo:
Ela também relata que o trabalho de inferência melhorou a eficiência da geração de tokens em mais de 15%.
Estes detalhes subjacentes do serviço são apresentados no relatório da AIBase. A atual página de lançamento público do GPT-5.6 da OpenAI confirma o esforço mais amplo para melhorar o serviço e a eficiência da pesquisa, mas os dados subjacentes exatos devem ser considerados como relatados pela fonte, a menos que sejam reproduzidos em publicações técnicas da OpenAI ou benchmarks que documentem métodos completos.
O que pode ser confirmado de forma independente a partir da documentação da OpenAI é que o GPT-5.6 adicionou vários mecanismos destinados a reduzir o trabalho desnecessário do modelo.
Isso inclui:
A direção da engenharia é coerente: reduzir o trabalho redundante em torno de cada tarefa bem-sucedida.
O GPT-5.6 introduziu um cache de prompt mais previsível.
A documentação da OpenAI oferece suporte a pontos de interrupção de cache explícitos, permitindo que os desenvolvedores decidam quais prefixos de prompt reutilizáveis devem ser armazenados em cache.
Para os modelos GPT-5.6:
Isso muda a forma como os desenvolvedores pensam sobre agentes de longo prazo.
Se grandes prompts de sistema, catálogos de ferramentas, seções de política ou contextos de projeto estáveis são enviados repetidamente como entrada sem cache, o custo pode ser alto.
Quando os prefixos reutilizáveis permanecem estáveis, o cache pode reduzir esse custo.
No entanto, gravações de cache desnecessárias podem aumentar o custo. Portanto, a OpenAI recomenda rastrear o uso de tokens de cache e tokens de gravação de cache simultaneamente, em vez de assumir que o cache é sempre mais barato.
A segunda área principal de eficiência é a estrutura do agente.
O ciclo tradicional de ferramentas geralmente é o seguinte:
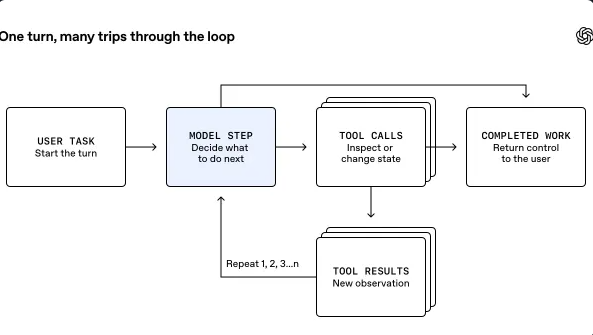
Embora flexível, essa abordagem pode se tornar cara.
Grandes saídas intermediárias de ferramentas podem entrar repetidamente no contexto do modelo, mesmo que apenas uma pequena parte dos dados seja necessária.
A chamada programática de ferramentas do GPT-5.6 oferece uma alternativa.
A documentação da OpenAI mostra que o GPT-5.6 pode escrever JavaScript em um ambiente de execução gerenciado para:
Para fluxos de trabalho limitados, isso pode reduzir:
A OpenAI afirma que esse padrão é particularmente útil quando o código pode lidar com vários resultados previsíveis de ferramentas sem precisar reavaliar semanticamente após cada chamada.
Não é adequado para todas as tarefas de agente.
A interação direta modelo-ferramenta ainda é a melhor escolha quando:
O objetivo não é minimizar o número de chamadas a todo custo, mas evitar passar informações desnecessárias pelo modelo.
O artigo da AIBase também aponta que um gerenciamento mais rigoroso do histórico de conversas é uma forma de melhorar a taxa de reutilização do cache.
O guia de desenvolvimento atual do GPT-5.6 da OpenAI fornece o mecanismo oficial relacionado: inferência persistente.
Os desenvolvedores podem configurar como o raciocínio de rodadas anteriores permanece disponível.
Isso é importante para fluxos de trabalho de longo prazo, pois nem todas as ideias anteriores são igualmente úteis para sempre.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Se a tarefa permanecer estável, o raciocínio anterior pode melhorar a continuidade.
Se o objetivo mudar, manter todo o raciocínio anterior aumenta o custo e introduz suposições desatualizadas.
Portanto, a OpenAI permite que os aplicativos controlem o contexto de raciocínio e recomenda preservar corretamente os itens de resposta necessários ao gerenciar o histórico manualmente.
Isso dá aos desenvolvedores outra alavanca para equilibrar:
O guia de desenvolvimento do GPT-5.6 da OpenAI recomenda especificamente prompts simplificados.
Em amostras de execuções internas de avaliação de agente de codificação, a OpenAI relata que simplificar prompts e descrições de ferramentas:
A OpenAI afirma explicitamente que esses números são apenas para referência e que os resultados variam de acordo com a carga de trabalho.
A recomendação não é remover restrições úteis.
O objetivo é eliminar conteúdo duplicado.
Um fluxo de migração prático é o seguinte:
Isso é particularmente importante para produtos de agente, onde o mesmo prompt de sistema e descrições de ferramentas podem ser enviados milhares de vezes por dia.
A série GPT-5.6 oferece aos desenvolvedores três opções principais de custo-qualidade.
Escolha Sol quando a tarefa puder se beneficiar substancialmente de capacidades de ponta.
Cenários de uso incluem:
Quando a tarefa requer capacidade de raciocínio relativamente forte, mas não o Sol, o Terra é a escolha prática.
É adequado para:
A Luna é a escolha natural para os seguintes cenários:
Uma arquitetura comum é rotear trabalhos regulares para a Luna ou Terra, encaminhando apenas as tarefas mais difíceis para a Sol.
Para sistemas de agentes, uma simples comparação de tokens pode ser enganosa.
Considere dois modelos.
O Modelo A tem um custo menor por token de saída, mas requer:
O Modelo B tem um preço mais alto, mas reduz pela metade as etapas necessárias para concluir a tarefa.
O segundo modelo ainda pode ser mais barato por tarefa concluída.
Portanto, as equipes que avaliam o GPT-5.6 devem monitorar:
Este é o verdadeiro significado de "inteligência por token".
Para equipes que já usam o GPT-5.5 ou modelos anteriores, uma comparação controlada é mais útil do que uma migração completa imediata.
Inclui:
A OpenAI sugere começar com o mesmo esforço de raciocínio usado no modelo anterior.
Em seguida, teste a redução de um nível.
O GPT-5.6 pode manter a qualidade usando menos tokens de raciocínio, mas isso precisa ser confirmado na sua carga de trabalho.
Não presuma que o modelo principal é automaticamente a melhor escolha para produção.
Meça se a Terra ou a Luna podem atender aos mesmos critérios de aceitação a um custo menor.
Acompanhe as leituras e gravações em cache.
Quando a taxa de reutilização é alta, um contexto estável pode se tornar significativamente mais econômico, mas prefixos de prompt que mudam com frequência podem não se beneficiar muito.
Aplique-as em estágios de processamento com limites bem definidos, como:
Compare os resultados com chamadas de ferramenta diretas comuns.
Uma conta de tokens mais baixa só faz sentido se a tarefa final ainda atingir os padrões de qualidade.
O objetivo de otimização correto não é o menor número de tokens.
É obter um resultado bem-sucedido ao menor custo confiável.
Por anos, a competição entre modelos de fronteira foi dominada por uma questão: qual modelo é mais capaz?
Essa questão ainda é importante.
Mas, com a IA entrando em produção em larga escala, outra questão se torna igualmente importante:
Quanto trabalho útil o sistema pode realizar por unidade de computação e por dólar investido?
Os sistemas de agentes amplificam essa pressão.
Uma única solicitação de usuário pode desencadear:
Sem uma orquestração cuidadosa, a conta total pode crescer rapidamente.
O GPT-5.6 reflete uma mudança mais ampla, de simplesmente escalar a capacidade intelectual para tornar a implantação de IA mais econômica.
A Sol impulsiona a capacidade intelectual no topo.
A Terra reduz o custo do trabalho geral poderoso.
A Luna traz a família de modelos para cargas de trabalho de alto rendimento.
O cache de prompt e a orquestração programática de ferramentas visam a sobrecarga do sistema ao redor do próprio modelo.
O resultado é uma família de modelos projetada não apenas em torno de pontuações de referência, mas também em torno da economia de produção.
O GPT-5.6 é a família de modelos da OpenAI para raciocínio complexo, programação, trabalho especializado, fluxos de trabalho de agentes e aplicações de IA de alto rendimento. A série atualmente inclui Sol, Terra e Luna.
A Sol é o nível principal e mais capaz. A Terra equilibra inteligência e custo, enquanto a Luna é otimizada para cargas de trabalho de baixo custo e alto rendimento.
A OpenAI precifica a Sol em US$ 5 por milhão de tokens de entrada e US$ 30 por milhão de tokens de saída, a Terra em US$ 2,50/US$ 15 e a Luna em US$ 1/US$ 6. Os preços de entrada em cache são mais baixos e prompts muito longos podem ter preços diferentes.
A página atual do modelo de API da OpenAI lista a janela de contexto para Sol, Terra e Luna como 1.050.000 tokens. Cada modelo suporta até 128.000 tokens de saída.
A OpenAI relata que a Sol obtém pontuações mais altas em várias avaliações de agentes de programação, incluindo o Artificial Analysis Coding Agent Index, SWE-Bench Pro, DeepSWE e Terminal-Bench 2.1. O desempenho real em produção ainda depende do repositório, estrutura do agente, prompt e ferramentas.
As chamadas de ferramenta programáticas permitem que o GPT-5.6 escreva código para orquestrar ferramentas elegíveis em um tempo de execução hospedado e processar resultados intermediários. Elas podem reduzir viagens de ida e volta do modelo e uso de tokens em fluxos de trabalho com limites bem definidos.
Por exemplo, operações como filtragem, junção, ordenação e agregação.
Sim. O GPT-5.6 suporta cache automático e pontos de interrupção de cache explícitos. A OpenAI afirma que as leituras em cache recebem 90% de desconto na entrada, enquanto novas gravações em cache custam 1,25x o preço da entrada não armazenada em cache.
Geralmente não. Se a Terra ou a Luna puderem atender aos mesmos critérios de avaliação a um custo menor, usar um nível de modelo menor melhora a economia da aplicação. Apenas encaminhe tarefas complexas para a Sol quando a maior capacidade trouxer benefícios mensuráveis.
Catálogo oficial dos modelos e suas especificações principais.
O GPT-5.6 é uma família de modelos composta por três níveis, não um único modelo de uso geral. O Sol é voltado para capacidades de ponta, o Terra oferece um equilíbrio mais econômico para tarefas regulares de produção, e o Luna é otimizado para cenários de alto throughput.
O tema principal é eficiência. A OpenAI reduz a carga de trabalho do modelo necessária para concluir tarefas complexas ao combinar modelos com maior eficiência de tokens, cache explícito de prompts, raciocínio contínuo, consumo de raciocínio configurável e chamadas de ferramentas de programação.
Fontes da AIBase também relataram mais otimizações na pilha de inferência, incluindo decodificação especulativa e trabalho em núcleos de GPU, resultando em um aumento de mais de 15% na velocidade de geração de tokens.
Eficiência. A menos que reproduzidos em publicações técnicas completamente documentadas da OpenAI, esses dados de baixo nível devem ser tratados como reportagens de fontes.
A melhor compreensão do GPT-5.6 não é apenas o lançamento de um modelo mais forte, mas uma tentativa de melhorar a economia da inteligência em todo o fluxo de trabalho dos agentes.
Comece com uma frase e tenha um site completo em minutos.



