For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/opening-claude-s-brain-is-not.md.
O estudo recente de explicabilidade da Anthropic ofereceu aos pesquisadores uma nova maneira de observar a atividade interna do Claude. Por ...
O estudo recente de explicabilidade da Anthropic ofereceu aos pesquisadores uma nova maneira de observar a atividade interna do Claude. Por meio de um método chamado Lente Jacobiana (ou J-lens), a equipe de pesquisa identificou um pequeno conjunto de representações internas verbalizáveis, denominado J-Space.
Essa descoberta é significativa. Ela indica que certos conceitos dentro de modelos de linguagem podem ser usados globalmente para relatar, raciocinar e controlar comportamentos. Os pesquisadores podem observar essas representações e intervir nelas em experimentos controlados, testando se elas têm impacto causal na saída do modelo.
Mas observar uma representação interna não equivale a explicá-la completamente.
Um estado de ativação legível pode nos dizer que o modelo está rastreando um conceito, como contagem, engano, França ou conclusão. Mas isso não nos diz automaticamente: por que esse conceito é relevante? A informação subjacente é confiável? Que fatos externos sustentam a conclusão? Ou se a decisão final é razoável?
Essa distinção aponta para uma abordagem mais ampla de IA explicável. Em vez de tratar o estado interno do modelo como o único objeto a ser explicado, podemos examinar simultaneamente as informações que o modelo processa: de onde elas vêm, como são constituídas, quais conceitos e relações são usados, como as evidências fluem pelo sistema e, finalmente, como a saída se conecta a sistemas de conhecimento externos.
É aqui que a engenharia ontológica entra em ação.
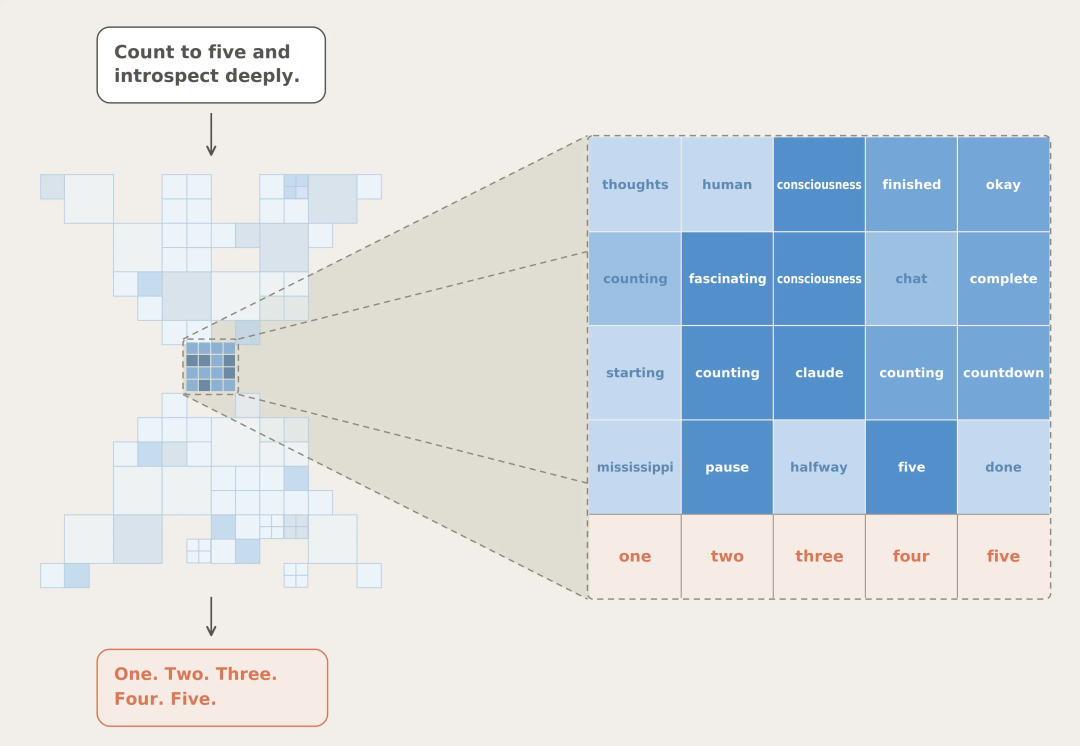
O artigo da Anthropic, Representações Verbalizáveis em Modelos de Linguagem Constituem um Espaço de Trabalho Global, introduziu o conceito de J-Space ao se basear na teoria do espaço de trabalho global da ciência cognitiva.
Na neurociência e na ciência cognitiva, o espaço de trabalho global é geralmente descrito como um palco de capacidade limitada, onde informações selecionadas se tornam amplamente acessíveis a múltiplos processos cognitivos. A Anthropic descobriu que um subconjunto pequeno e esparso das representações internas do Claude parece desempenhar um papel funcionalmente semelhante.
Os pesquisadores usaram vetores J-lens associados a itens lexicais para examinar o estado interno do modelo. Seus experimentos mostraram que as informações representadas no J-Space podem:
Esses resultados avançam a explicabilidade além da simples observação do comportamento de saída. Eles fornecem um método para testar a função de certas representações internas.
A Anthropic adota uma postura cautelosa.
Não se pode afirmar que o Claude replica a arquitetura cognitiva completa do cérebro humano ou possui consciência subjetiva. O J-Space é uma estrutura funcional em um sistema matemático, não uma evidência de atividade mental semelhante à humana.
Essa cautela é crucial, pois a similaridade funcional pode facilmente ser confundida com equivalência psicológica.
Um modelo pode conter um espaço de trabalho interno compartilhado sem possuir sentimentos, experiências, intenções ou consciência no sentido humano. O padrão de ativação associado à palavra "medo" não é, em si, medo, mas sim um estado computacional que participa da geração de comportamento.
O J-Space pertence a uma ampla tradição de explicabilidade cujo ponto de partida é uma pergunta:
O que está acontecendo dentro do modelo?
Essa abordagem internalista examina padrões de ativação, circuitos, características, padrões de atenção, representações e caminhos causais, com o objetivo de tornar os mecanismos ocultos das redes neurais mais observáveis e testáveis.
Esse trabalho tem valor claro, ajudando pesquisadores a:
A limitação não reside na inutilidade da explicabilidade interna, mas no fato de que a visibilidade interna cobre apenas um nível da explicação.
Um padrão neural pode estar associado a uma resposta, mas não resolve o problema do significado e da base dessa resposta.
Suponha que o modelo diga "Paris é a capital da França". A detecção interna pode identificar representações relacionadas a Paris, França, geografia e capital, mas várias questões externas permanecem em aberto:
Essas questões não residem inteiramente dentro dos padrões de ativação, mas dizem respeito à relação entre as representações do modelo e os fatos externos, a linguagem, os conceitos humanos e os padrões de justificação.
A explicabilidade voltada para a engenharia geralmente considera que um sistema é explicável quando os pesquisadores podem observar e intervir em seus mecanismos internos.
Embora útil, essa definição é muito restrita.
Na filosofia da ciência e na epistemologia, uma explicação pode também precisar fornecer:
O J-Space pode revelar quais informações são ativadas em uma tarefa, mas por si só não pode determinar se essas informações são verdadeiras, relevantes, éticas ou suficientes para justificar o resultado da saída.
Portanto, a questão mais profunda reside não apenas na opacidade da rede neural em si, mas no fato de que as informações que cercam esses sistemas são frequentemente mal estruturadas e difíceis de rastrear.
Grandes modelos de linguagem são sistemas de processamento de informações. Eles recebem texto, imagens, arquivos, respostas de ferramentas, resultados de banco de dados e outros sinais, e então geram informações como resposta.
O significado dessas entradas e saídas depende de relações fora do modelo.
Um termo médico se refere a um conceito clínico, um identificador corporativo corresponde a uma entidade legal, regras políticas pertencem a jurisdições e períodos de validade específicos, números financeiros incluem fonte, unidade, data e definição contábil, e afirmações científicas dependem de evidências, métodos e hipóteses.
Se essas relações não forem explicitamente apresentadas, o modelo deve inferi-las por meio da linguagem e do contexto. Isso às vezes funciona, mas outras vezes gera ambiguidade, contradição, alucinação ou respostas aparentemente razoáveis, mas não auditáveis.
Uma abordagem de explicabilidade centrada na informação, portanto, levanta as seguintes questões:
Isso expande o objeto da explicabilidade da rede neural para todo o ambiente de informações no qual o modelo opera.
Esse ambiente inclui:
Um modelo pode ser internamente explicável, mas ainda assim operar com base em informações mal definidas ou não confiáveis. Por outro lado, os mecanismos do modelo podem ser opacos, mas altamente rastreáveis porque cada afirmação está vinculada a evidências estruturadas e regras explícitas.
Os sistemas mais poderosos provavelmente combinarão essas duas formas de transparência.
O termo ontologia tem dois significados relacionados.
Na filosofia, a ontologia investiga a natureza do ser e como as coisas são categorizadas. Na ciência da computação, uma ontologia é uma formalização de entidades, classes, atributos, relações e restrições dentro de um domínio.
O artigo de origem conecta a explicabilidade da inteligência artificial à teoria das categorias de Immanuel Kant.
Kant argumentava que a compreensão humana não simplesmente recebe dados sensoriais brutos, mas organiza a experiência por meio de formas conceituais. Ele resumiu doze categorias em:
O artigo usa essa estrutura para apresentar um ponto de vista mais amplo: a informação só se torna inteligível depois de organizada por uma estrutura conceitual.
A imagem está intimamente relacionada ao contexto.
O contexto menciona as doze categorias de Kant, e esta imagem apresenta essas quatro categorias de forma visual, em consonância com a introdução da teoria kantiana no artigo. Para sistemas de inteligência artificial, o significado prático não reside na necessidade de o modelo de linguagem realmente possuir as doze categorias de Kant. Uma ideia mais útil é: a explicabilidade requer um quadro compartilhado para identificar os tipos de coisas que o modelo está discutindo e os tipos de relações que ele está afirmando.
Por exemplo, considere a seguinte frase:
O sistema rejeitou o pedido porque o requerente não atendeu aos requisitos de renda.
Uma explicação útil não pode depender apenas de mapas de ativação. Pode ser necessário identificar:
Uma ontologia pode definir formalmente esses elementos e relações.
Ela fornece uma estrutura semântica que permite que a saída do modelo seja interpretada, verificada e questionada.
Uma ontologia de domínio bem projetada pode especificar:
Essa estrutura cria um sistema de coordenadas semânticas estável.
Os avaliadores não precisam dizer que o modelo "parece entender relações causais"; em vez disso, podem perguntar se a saída contém uma relação causal bem definida, se as entidades envolvidas foram corretamente identificadas e se as evidências citadas apoiam essa relação.
Isso não torna automaticamente correta cada decisão do modelo, mas torna as informações usadas na decisão mais verificáveis.
A ontologia filosófica fornece conceitos. A engenharia de ontologias transforma esses conceitos em sistemas utilizáveis por software.
Na prática, a engenharia de ontologias envolve definir o domínio, coletar requisitos, identificar conceitos, modelar relações, formalizar restrições, testar consistência, documentar proveniência e manter a ontologia à medida que o domínio muda.
O desenvolvimento tradicional de ontologias costuma ser caro e lento, pois depende fortemente de especialistas de domínio e engenheiros de conhecimento.
Os modelos de linguagem de grande escala podem acelerar várias etapas do processo.
Eles podem ajudar a:
Isso forma uma relação bidirecional.
Os modelos de linguagem podem acelerar a construção de ontologias, enquanto as ontologias podem tornar os sistemas de modelos de linguagem mais estruturados, verificáveis e rastreáveis.
Especialistas de domínio podem fornecer dezenas de relatórios, políticas, manuais, esquemas de banco de dados e vocabulários. Os LLMs podem digitalizar esses materiais e gerar uma lista inicial de conceitos e relações.
Por exemplo, eles podem identificar:
Isso pode reduzir o trabalho de descoberta manual.
No entanto, os resultados ainda precisam ser revisados por especialistas de domínio. Os modelos de linguagem podem inventar relações, mesclar conceitos que deveriam permanecer independentes ou reproduzir inconsistências dos documentos de origem.
Portanto, a engenharia de ontologias assistida por LLM deve ser vista como modelagem de conhecimento sob supervisão humana, e não como extração automática de verdade.
As ontologias podem apoiar aplicações de modelos de linguagem de várias maneiras.
As ontologias fornecem ao modelo um vocabulário controlado e relações explícitas. Isso pode reduzir ambiguidades durante a recuperação e geração.
O sistema pode conectar a linguagem do usuário a entidades padrão, identificar sinônimos e realizar recuperação de informações com base no significado, e não apenas nas palavras superficiais.
As saídas podem ser verificadas em relação às restrições da ontologia. Por exemplo, dosagens médicas podem exigir unidades, transações devem incluir contas ou decisões políticas devem citar regras válidas.
Raciocinadores e sistemas de validação podem detectar classificações incompatíveis, atributos ausentes ou contradições em dados estruturados.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
As declarações geradas podem ser vinculadas a documentos de origem, conceitos da ontologia, regras e versões. Isso torna a revisão mais prática do que exigir que os usuários confiem em explicações opacas geradas a posteriori.
A ontologia pode servir como um contrato semântico entre LLMs, bancos de dados, ferramentas, aplicativos de negócios e equipes humanas.
O modelo permanece flexível na linguagem, enquanto os sistemas circundantes mantêm uma representação controlada de:
Conceitos-chave.
O valor de uma explicação do modelo aumenta significativamente quando ela pode ser apresentada como uma cadeia de rastreabilidade:
Isso é diferente de pedir ao modelo que gere parágrafos fluentes descrevendo o "porquê" de uma resposta.
As explicações geradas podem, elas mesmas, conter viés. As cadeias de rastreabilidade ancoradas em conhecimento estruturado podem ser auditadas independentemente.
As ontologias tradicionais são frequentemente projetadas para mecanismos de raciocínio formais, contendo axiomas complexos construídos para apoiar a inferência simbólica determinística.
As ontologias para modelos de linguagem de grande escala podem exigir um ponto de equilíbrio diferente.
As ontologias ainda precisam ser precisas, mas devem ser mais fáceis para os modelos recuperarem, citarem e aplicarem.
O texto original propõe: Ontologias amigáveis para IA devem focar em fornecer um esqueleto semântico claro, em vez de tentar codificar todas as etapas de raciocínio possíveis.
Essa divisão de trabalho é valiosa:
Essa abordagem evita dois extremos.
O primeiro extremo é um fluxo de trabalho de modelo de linguagem completamente não estruturado, definindo conceitos importantes apenas por meio de prompts e documentos. O segundo extremo é um sistema simbólico superengenhado que tenta formalizar cada detalhe, tornando-se difícil de manter.
Ontologias amigáveis para IA devem almejar o seguinte:
Cada categoria e relação importante deve ter uma descrição concisa e inequívoca.
Entidades e conceitos-chave devem usar identificadores canônicos, em vez de depender apenas de nomes.
Definições, fatos e regras devem registrar sua fonte, proprietário, versão e período de validade.
Os conceitos devem incluir rótulos legíveis por humanos, descrições, sinônimos e exemplos de uso.
A ontologia deve ser dividida em módulos gerenciáveis, permitindo que o modelo recupere apenas as partes relevantes.
Dados e saídas de alto valor devem ser verificados por meio de restrições explícitas (como formas SHACL ou validadores em nível de aplicação).
Como mudanças na ontologia podem afetar o comportamento do modelo, as atualizações devem ser revisadas, versionadas e testadas.
As aplicações devem manter registros dos conceitos e fatos fornecidos ao modelo.
A ontologia deve identificar cenários onde as regras estão incompletas, os conceitos são ambíguos ou a aprovação humana é necessária.
Uma camada semântica só tem valor se for mantida.
Ontologias desatualizadas podem fazer com que um sistema cometa erros de forma aparentemente altamente organizada.
O debate sobre o J-Space destaca dois objetivos distintos.
O primeiro é explicar o próprio modelo: suas representações internas, circuitos, computações e mecanismos comportamentais.
O segundo é explicar o impacto do modelo: quais informações moldaram a saída, quais regras autorizaram a ação, quais evidências apoiaram o resultado e quem pode revisá-lo ou contestá-lo.
Esses objetivos se sobrepõem, mas não são idênticos.
A explicabilidade mecânica pode revelar que um modelo já representava internamente um engano antes de produzir uma saída enganosa. A rastreabilidade baseada em ontologia pode revelar qual declaração era falsa, qual fonte a refutou e qual fluxo downstream foi afetado.
O primeiro ajuda pesquisadores a entender o comportamento interno. O segundo ajuda organizações a governar as consequências do mundo real.
Portanto, uma solução completa de explicabilidade pode incluir múltiplas camadas:
A engenharia ontológica fortalece principalmente as camadas de informação e de sistema. Ela também pode apoiar a análise de impacto e a governança ao esclarecer conceitos, regras e fontes.
Ela não substitui a explicabilidade neural.
Grafos de conhecimento estruturados não conseguem revelar objetivos ocultos embutidos nos pesos do modelo. O J-Space não pode provar que um documento fonte é autoritativo ou que uma regra de negócio é justa.
Essas duas abordagens resolvem partes diferentes do problema.
A metáfora de abrir a caixa-preta da IA pode estabelecer uma meta irrealista: transparência total, até cada peso e computação interna.
Para modelos de ponta, isso pode nunca ser tão viável quanto se imagina.
Uma meta mais alcançável é tornar a operação do sistema suficientemente compreensível, rastreável, testável e governável em seu cenário de uso.
Isso implica projetar sistemas onde:
Quando tecnicamente viável, usamos meios de monitoramento.
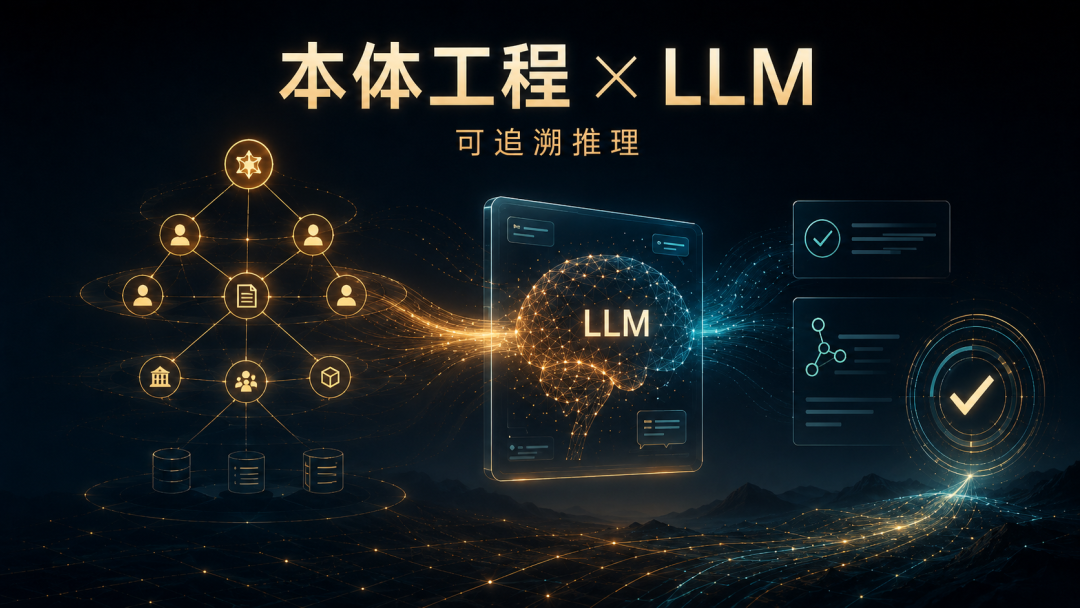
A mudança central é: não tratar mais a explicabilidade como um problema único de visualização, mas sim como uma questão de engenharia e governança.
Talvez nunca consigamos traduzir completamente cada computação de rede neural em uma história compreensível para humanos. No entanto, ainda podemos construir uma arquitetura de informação que torne as saídas de alto impacto mais fáceis de entender e questionar.
A engenharia ontológica transforma esse objetivo em trabalho concreto:
Isso não é tão chamativo quanto "ler a mente do modelo", mas pode ser mais útil na produção real.
O artigo original em chinês termina com uma menção promocional ao LegionSpace (um produto relacionado ao Dunfu). A fonte o descreve como uma infraestrutura de IA empresarial construída em torno de engenharia ontológica e raciocínio rastreável.
Esta adaptação não avaliou independentemente essas alegações de produto e, portanto, não as utiliza como evidência para um argumento mais amplo.
A lição relevante é universal: qualquer plataforma que afirme fornecer explicabilidade baseada em ontologia deve ser avaliada com base em perguntas específicas.
Um produto não deve ser considerado explicável apenas por usar um grafo de conhecimento ou exibir um gráfico de raciocínio.
J-Space é o nome que a Anthropic deu a um pequeno subconjunto de representações internas identificadas por meio da lente Jacobiana. A pesquisa sugere que essas representações podem conter conceitos verbalizáveis que podem ser usados para relatórios, raciocínio e intervenção causal.
Não. A Anthropic não afirma que seus modelos reproduzem a consciência humana ou experiências subjetivas. O J-Space mostra semelhanças funcionais parciais com a teoria do espaço de trabalho global, mas analogias funcionais não são evidência de uma mente semelhante à humana.
Ferramentas internas podem mostrar quais representações ou mecanismos influenciaram o comportamento, mas não podem determinar automaticamente se a informação do modelo é verdadeira, de fonte confiável, relevante ou razoável. A explicabilidade também requer evidências, definições semânticas, fontes, regras e a descrição do impacto no mundo real.
Engenharia ontológica é a prática de formalizar a definição de entidades, categorias, atributos, relações e restrições dentro de um domínio. Em sistemas de software, ontologias são geralmente representadas em padrões como RDF e OWL e podem ser validadas por meio de SHACL.
Ontologias fornecem conceitos normativos e relações explícitas, ancorando processos de recuperação, geração e verificação. Elas ajudam a conectar alegações a conceitos definidos, evidências de apoio, regras formalizadas e versões registradas.
LLMs podem acelerar a extração de conceitos, descoberta de relações, mapeamento e escrita de documentação, mas suas sugestões precisam de revisão de especialistas. A geração ontológica totalmente automática pode reproduzir erros dos dados fonte, mesclar conceitos diferentes ou criar relações infundadas.
Não. Ontologias podem restringir saídas importantes e melhorar a rastreabilidade, mas não podem eliminar todos os erros do modelo. Sistemas confiáveis também precisam de controle de qualidade na recuperação, verificação, teste, gerenciamento de permissões, monitoramento e revisão humana.
Elas abordam diferentes camadas da explicabilidade e são melhor usadas como complementares. A explicabilidade mecânica estuda o comportamento interno do modelo, enquanto a engenharia ontológica torna as informações, regras e caminhos de decisão externos mais fáceis de auditar.
Eclipse RDF4J: Framework Java modular para criar, armazenar, consultar, inferir e validar dados RDF.
A pesquisa J-Space da Anthropic representa um avanço significativo no campo da interpretabilidade mecânica. Ela oferece aos pesquisadores um novo método para observar e testar causalmente um pequeno conjunto de representações internas materializáveis no Claude.
Esta pesquisa não resolve o problema mais amplo da interpretabilidade. Compreender sistemas de IA também exige esclarecer as informações que eles utilizam, o significado dos conceitos, as evidências por trás das afirmações, as regras que orientam seu comportamento e o impacto de seus resultados.
A engenharia de ontologias oferece um caminho viável para formalizar essas estruturas externas. Ela pode apoiar recuperação semântica, validação, rastreabilidade, auditoria e responsabilização, especialmente quando combinada com revisão humana e pesquisa de interpretabilidade interna.
A verdadeira chave para uma IA interpretável talvez não seja escolher entre "abrir o modelo" ou "construir a estrutura do mundo externo", mas sim aprender a equilibrar ambos.
Comece com uma frase e tenha um site completo em minutos.



