A LlamaFactory torna o ajuste fino de modelos de grande porte mais acessível a um grupo mais amplo de desenvolvedores. Agora, seu criador Zh...
O LlamaFactory tornou o ajuste fino de modelos em larga escala mais acessível a uma comunidade mais ampla de desenvolvedores. Agora, seu criador, Zheng Yaowei, e a equipe PrismShadow estão aplicando a mesma abordagem de "facilidade de uso em primeiro lugar" aos agentes de IA.
O novo projeto de código aberto deles, PenguinHarness, tem como objetivo automatizar três etapas do ciclo de vida de um agente:
O usuário não precisa selecionar manualmente frameworks, conectar ferramentas, escrever prompts, construir interfaces e testar resultados repetidamente — basta descrever a necessidade e deixar o PenguinHarness montar uma aplicação de agente funcional.
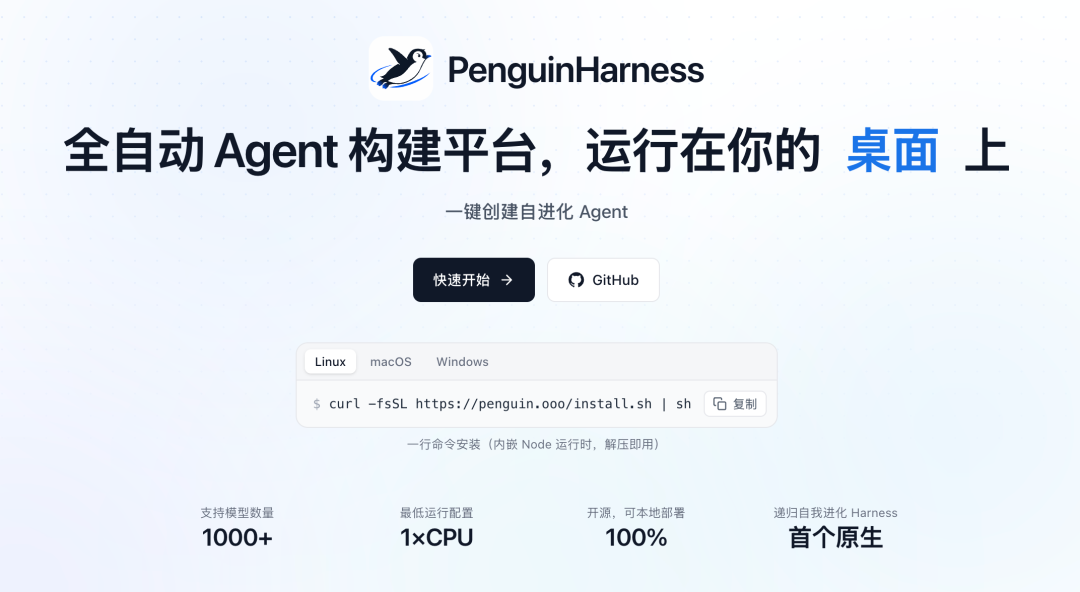
PenguinHarness é uma ferramenta de construção de agentes automatizada e de código aberto para implantação em desktop e servidores.
O projeto é leve, licenciado sob Apache 2.0, e suporta Linux, macOS e Windows. Ele pode ser executado localmente ou usado em servidores remotos por meio de uma interface de navegador.
O PenguinHarness também suporta modelos online e locais por meio de presets integrados e uma interface compatível com OpenAI. O repositório oficial atualmente lista os modelos mais recentes de provedores como DeepSeek, Kimi, GLM, Qwen, OpenAI, Google e Anthropic.
O relatório original descreve uma aplicação RAG gerada por apenas 0,2 yuan em custo de tokens de modelo. O mesmo exemplo na página oficial do projeto custa cerca de US$ 0,02 (usando DeepSeek V4 Pro).
Esse número é um dado de demonstração do projeto, não um preço fixo garantido. O custo real depende do modelo escolhido, do provedor, da complexidade do prompt, do número de tentativas, do escopo da aplicação e do preço dos tokens.
O PenguinHarness começa com uma ideia simples: um agente deve ser capaz de construir outra aplicação de agente com base em uma necessidade expressa em linguagem natural.
Isso se alinha à discussão mais ampla sobre "IA servindo à IA" e autoaperfeiçoamento recursivo — sistemas de IA que ajudam a criar, testar ou melhorar outros sistemas de IA.
O primeiro caso de uso apresentado no artigo original pedia ao sistema para construir uma aplicação RAG que precisava:
Um teste comparativo colocou o PenguinHarness lado a lado com um agente de codificação, pedindo que ambos os sistemas realizassem tarefas semelhantes.
De acordo com a demonstração do projeto, o PenguinHarness concluiu a aplicação com maior velocidade e menor custo de tokens. Os resultados incluíram respostas fluidas, saída em streaming e fontes vinculadas.
A saída do concorrente apresentada no relatório tinha problemas de mistura de idiomas e não apresentava o mesmo comportamento de streaming.
Esses exemplos são demonstrações úteis, mas não provam universalmente que o PenguinHarness é superior a todos os agentes de codificação em todos os cenários.
O repositório. Os resultados dependem em grande parte do modelo, da configuração do agente, do design da tarefa e do método de avaliação.
O desenvolvimento tradicional de agentes envolve normalmente várias etapas manuais:
O PenguinHarness tenta transformar essas etapas em um único fluxo de trabalho orientado por agente.
Quando o requisito é claro, o sistema pode gerar:
O exemplo oficial do projeto usou a seguinte solicitação:
Colete a documentação de https://github.com/ericbuess/claude-code-docs e construa uma aplicação RAG que responda a perguntas sobre o Claude Code como um especialista em configuração, citando suas fontes.
O relatório do projeto afirma que, quando construída com o DeepSeek V4 Pro, a aplicação RAG gerada consumiu cerca de US$ 0,02 (ou ¥0,2) em tokens de modelo.
O PenguinHarness utiliza arquivos como a principal camada de cooperação entre humanos e agentes.
Nesse design:
Essa abordagem torna os agentes mais fáceis de inspecionar e modificar.
Em vez de esconder comportamentos importantes dentro de um grande framework de aplicação, o PenguinHarness usa arquivos editáveis como interface principal. Humanos podem ler e modificar esses arquivos, enquanto o agente pode aprimorá-los em processos de otimização aprovados.
A ferramenta é responsável por montar esses arquivos em um objeto de agente executável.
Em tempo de execução, o PenguinMessage atua como um formato de mensagem universal que conecta modelos, ambientes, ferramentas e usuários.
O artigo original o compara a um pacote de rede: diferentes componentes podem trocar informações por meio da mesma interface leve, sem exigir integrações exclusivas para cada modelo ou ambiente.
Assim, o PenguinHarness é ao mesmo tempo:
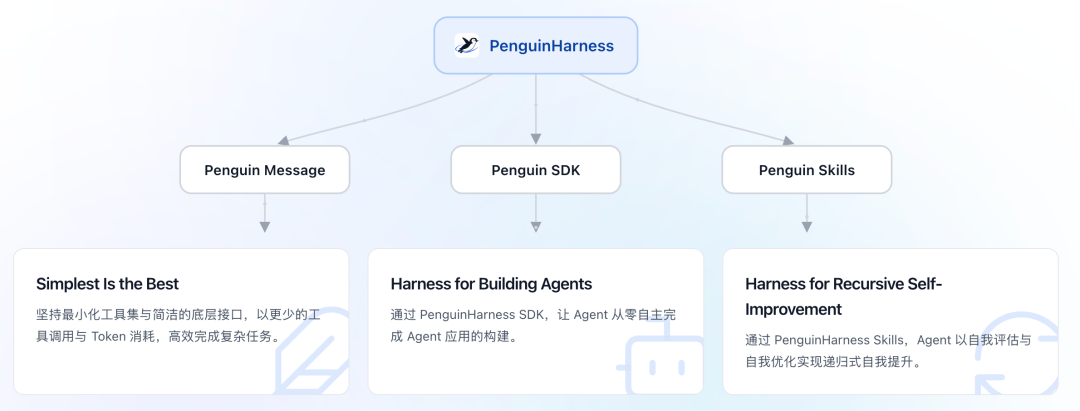
PenguinHarness combina PenguinMessage, Penguin SDK e Penguin Skills em uma arquitetura leve.
Os três domínios centrais apresentados na arquitetura do projeto são:
| Componente | Função |
|---|---|
| PenguinMessage | Protocolo mínimo de mensagens entre usuário, modelo, ferramentas e ambiente |
| Penguin SDK | Camada de desenvolvimento para construir aplicações de agente |
| Penguin Skills | Capacidades reutilizáveis para construir, avaliar e otimizar agentes |
Ciclo de auto-evolução reproduzível localmente
Construir um agente é apenas o primeiro passo.
O objetivo de longo prazo do PenguinHarness é permitir que os usuários operem agentes que podem ser avaliados e otimizados localmente, sem precisar reconstruir manualmente todo o sistema.
O projeto distingue duas fases:
Modificar um agente é relativamente fácil, pois prompts, código, habilidades e configurações podem ser editados. Mas determinar se uma mudança realmente tornou o agente melhor é muito mais difícil.
Modelos de linguagem de grande porte são probabilísticos, e sistemas de agentes introduzem ainda mais incerteza por meio de ferramentas, ambientes, memória e tomada de decisão em múltiplas etapas.
Portanto, um ciclo de melhoria confiável exige um sistema de medição confiável.
Um agente pode ter melhor desempenho em um único exemplo, mas piorar no geral.
Sem benchmarks estruturados, um otimizador pode:
A equipe do PrismShadow passou mais de seis meses explorando como avaliar agentes auto-evolutivos.
O desafio central está na falta de benchmarks que consigam distinguir claramente entre experiência de treinamento e testes retidos.
Se um agente melhora nas mesmas questões usadas para avaliação, é difícil saber se ele aprendeu uma estratégia reutilizável ou apenas memorizou as respostas.
A equipe criou o GDPevo, um benchmark de evolução nativa baseado em processos de negócios reais.
O artigo de origem descreve sua cobertura em áreas como saúde, finanças e trabalho jurídico. O repositório público atual da V2 contém 240 tarefas em 24 grupos de tarefas, abrangendo domínios como:
Cada grupo de tarefas inclui:
O GDPevo usa um método chamado mistura de regras. Os processos de negócios são decompostos em regras menores, distribuídas entre as tarefas de treinamento e recombidadas nas tarefas de teste retido.
Essa estrutura ajuda a determinar se o agente aprendeu fluxos de trabalho reutilizáveis, em vez de apenas ter visto as respostas do teste antecipadamente.
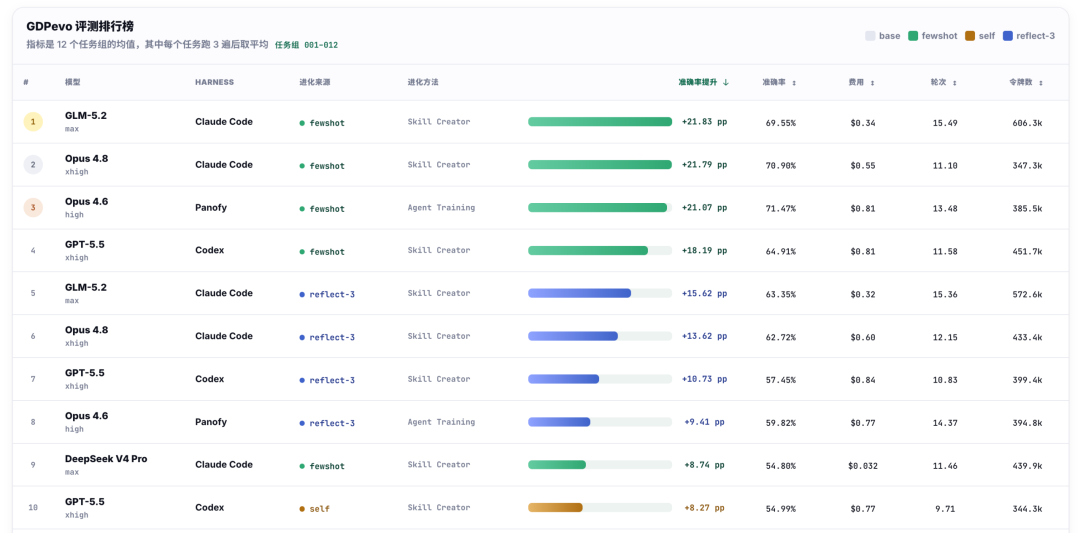
O GDPevo avalia o quanto os agentes melhoram em tarefas de negócios retidas após diferentes formas de evolução.
Relatório do artigo do GDPevo
A auto-evolução melhorou a precisão retida em até 16,44 pontos percentuais em seus experimentos. Também aponta que o melhor agente evoluído ainda está muito abaixo do limite ideal de 91,6% sob informação completa.
Essa lacuna é crucial. Os agentes atuais podem melhorar, mas a auto-evolução confiável está longe de ser resolvida.
O PenguinHarness transforma as ideias centrais por trás do GDPevo em habilidades reutilizáveis para:
Após a invocação das habilidades relevantes, múltiplos agentes podem colaborar no processo de melhoria.
O artigo de origem dá um exemplo de um agente projetado para tarefas como previsão esportiva, geração de estratégias de investimento ou suporte ao e-commerce.
Os usuários não precisam modificar manualmente prompts e fluxos de trabalho; basta deixar o PenguinHarness criar conjuntos de avaliação, executar testes repetidos, analisar causas de falhas e propor versões melhores.
O relatório de demonstração do projeto mostra que, após várias rodadas de iteração, a pontuação subiu de 53 para 95, com um custo de tokens de modelo de aproximadamente 0,5 RMB usando DeepSeek V4 Flash.
Este é um resultado de demonstração da equipe do projeto, não uma garantia geral de benchmark. Os resultados reais variam de acordo com a tarefa, critérios de pontuação, modelo, tamanho da amostra e orçamento de otimização.
O fluxo de trabalho de auto-evolução usa vários agentes com funções distintas.
O agente otimizador determina o número necessário de perguntas e repetições e, em seguida, inicia vários agentes avaliadores em paralelo.
A avaliação paralela ajuda a reduzir o tempo necessário para testar múltiplas tarefas ou execuções repetidas.
Cada agente avaliador inicia uma cópia independente do agente alvo e pede que ele resolva uma tarefa.
O agente avaliador tem acesso aos critérios de pontuação, enquanto o agente alvo não.
Esse isolamento visa evitar que o agente alvo otimize diretamente para instruções de pontuação ocultas.
O agente otimizador coleta os resultados e examina as trilhas de execução.
Ele identifica as causas da perda de pontos e então modifica partes aprovadas do agente alvo, como:
O agente otimizador gera uma versão candidata da próxima iteração.
Os agentes avaliadores testam novamente a versão candidata.
Somente quando a versão candidata obtém uma pontuação estritamente maior o agente otimizador a aceita. Se a pontuação permanecer igual ou cair, o framework reverte para a versão anterior.
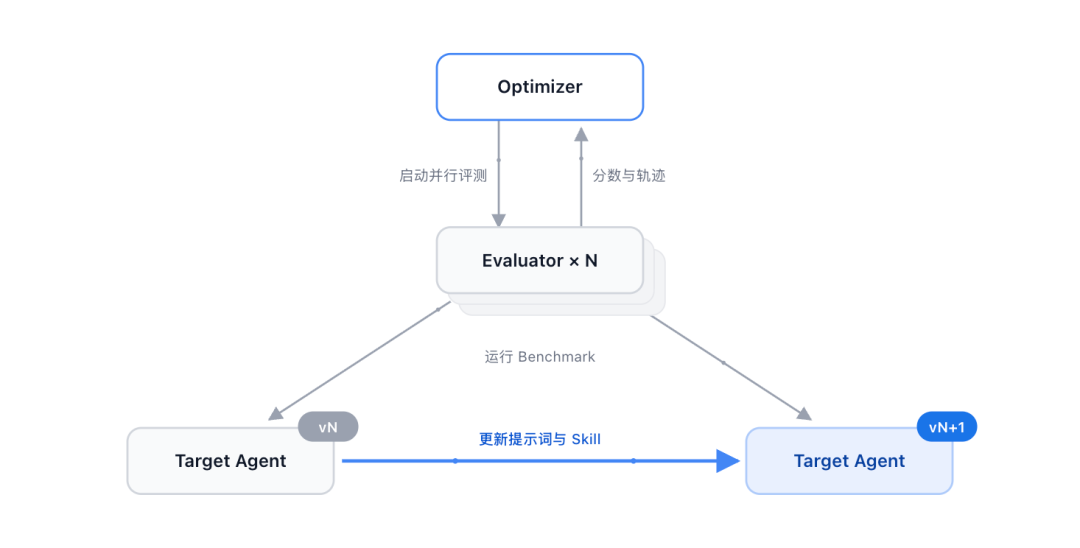
O agente otimizador coordena agentes avaliadores paralelos e só aceita candidatos com pontuação maior.
O fluxo pode ser resumido como:
Agente alvo vN
      ↓
Agentes avaliadores paralelos
      ↓
Pontuações, critérios de avaliação e trilhas de execução
      ↓
Agente otimizador
      ↓
Atualização de prompts, habilidades ou configurações
      ↓
Agente candidato vN+1
      ↓
Aceito somente se a pontuação for estritamente maior
Essa combinação de critérios de pontuação ocultos, testes retidos, snapshots e melhoria estrita de pontuação visa tornar a otimização mais reproduzível.
A auto-evolução levanta uma questão de segurança óbvia: o que o agente tem permissão de alterar?
O PenguinHarness define esses limites em um arquivo portátil chamado CONTRACT.md.
O contrato estabelece que as capacidades podem ser aprimoradas em áreas aprovadas, enquanto o núcleo do framework de testes e seus limites de segurança permanecem fixos.
O CONTRACT.md define os limites para a evolução de agentes, auditoria, controle de versão e isolamento de credenciais.
O artigo-fonte destaca quatro regras centrais.
A área editável está limitada ao workspace, prompts, skills e configurações aprovadas.
O agente não pode reescrever o núcleo do framework de testes nem seus mecanismos de segurança.
Isso reduz o risco de o processo de otimização enfraquecer os seguintes aspectos:
Antes da rodada de otimização, o framework armazena um snapshot da versão do estado do agente.
Se um agente candidato tiver desempenho pior ou causar efeitos colaterais indesejados, o sistema pode reverter para uma versão anterior.
Um sistema de autoaperfeiçoamento sem capacidade de reversão pode acumular danos. O controle de versão torna as melhorias reversíveis.
O agente-alvo recebe as tarefas, mas não os critérios de avaliação ocultos.
Somente o avaliador tem acesso aos critérios de pontuação.
Isso tem como objetivo reduzir comportamentos de atalho, memorização de respostas e ataques de recompensa.
Isso não elimina completamente esses riscos, mas cria uma separação mais clara entre resolver o problema e avaliar o resultado.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Requisições de modelo, chamadas de ferramentas, uso de tokens, tempo, falhas, aprovações e alterações de otimização são gravados em arquivos de rastreamento.
Os usuários podem verificar o que mudou e por quê.
O contrato mais amplo do projeto também inclui:
O resultado final é um framework no qual os agentes podem evoluir, mas o processo de evolução permanece visível e reversível.
O PenguinHarness inclui várias capacidades além da criação e otimização automatizada de agentes.
e implantação
O projeto inclui skills integradas relacionadas ao desenvolvimento de aplicações de IA, incluindo:
penguin-sdkpenguin-cliagenthub-modelsvllmollamallamafactory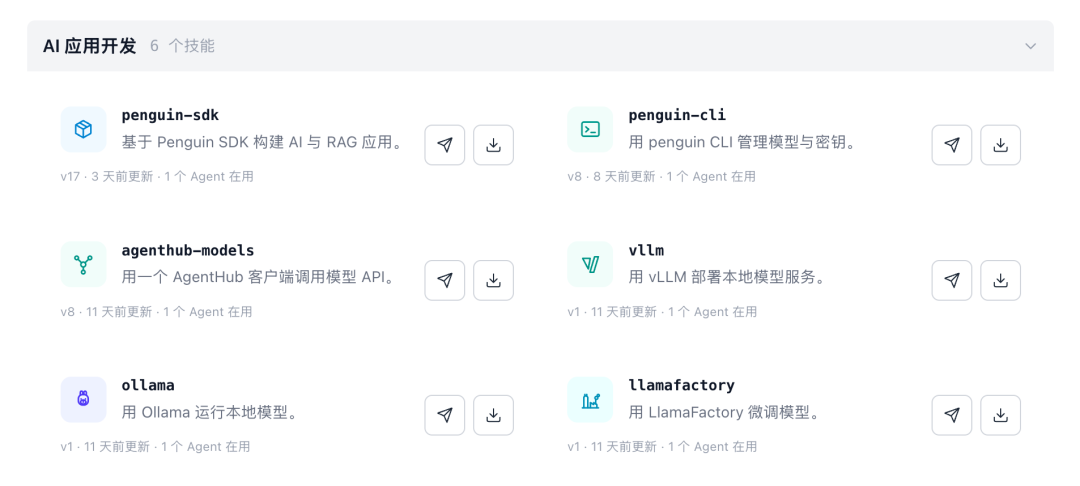
O PenguinHarness inclui skills para construir agentes e trabalhar com ferramentas como vLLM, Ollama e LlamaFactory.
Essas skills permitem que os usuários descrevam tarefas de treinamento ou implantação em linguagem natural, e o agente prepara os arquivos ou comandos necessários.
O repositório oficial divide as skills integradas em quatro grandes categorias:
| Grupo de skills | Exemplos |
|---|---|
| Eficiência de escritório | Análise de dados e coleta de dados na web |
| Desenvolvimento de software | Design de sites e engenharia de software |
| Desenvolvimento de aplicações de IA | Penguin SDK, gateway de modelos, vLLM, Ollama e LlamaFactory |
| Ajuste de agentes | Criação de agentes, design de benchmarks, avaliação e otimização |
Usuários e agentes também podem criar ou aprimorar skills adicionais.
O PenguinHarness inclui predefinições de modelos e suporta interfaces personalizadas compatíveis com a OpenAI.
O projeto afirma que, por meio dos provedores e gateways suportados, os usuários podem acessar mais de 1000 modelos online e locais.
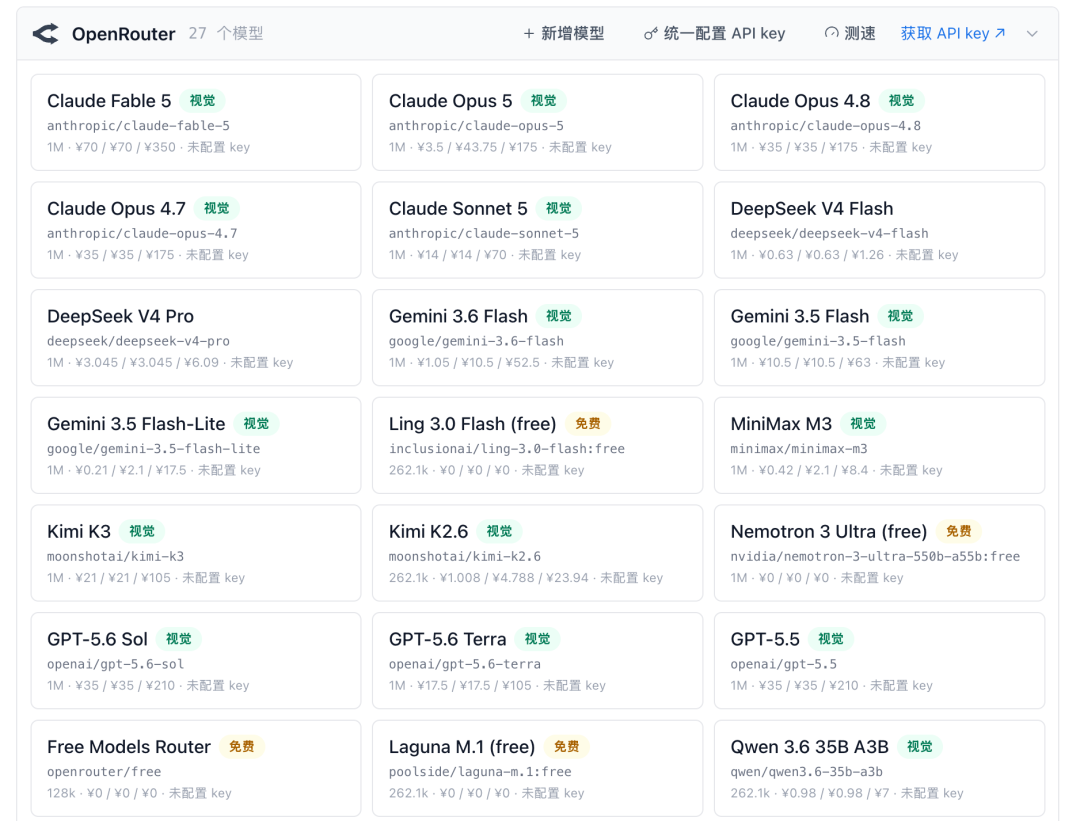
O gateway de modelos permite que os usuários configurem diferentes provedores de modelos online e locais.
O repositório atual lista as seguintes famílias de modelos:
A disponibilidade dos modelos e os nomes dos provedores mudam com frequência; portanto, a página "Modelos" no aplicativo e a documentação oficial atual devem ser consideradas como as fontes de informação mais recentes.
O artigo-fonte descreve um padrão de desenvolvimento no qual um modelo predominantemente textual, como o DeepSeek, atua como agente principal, enquanto um modelo com capacidade visual atua como assistente visual.
O agente visual pode examinar:
O modelo principal pode então corrigir sua saída com base nas descrições visuais.
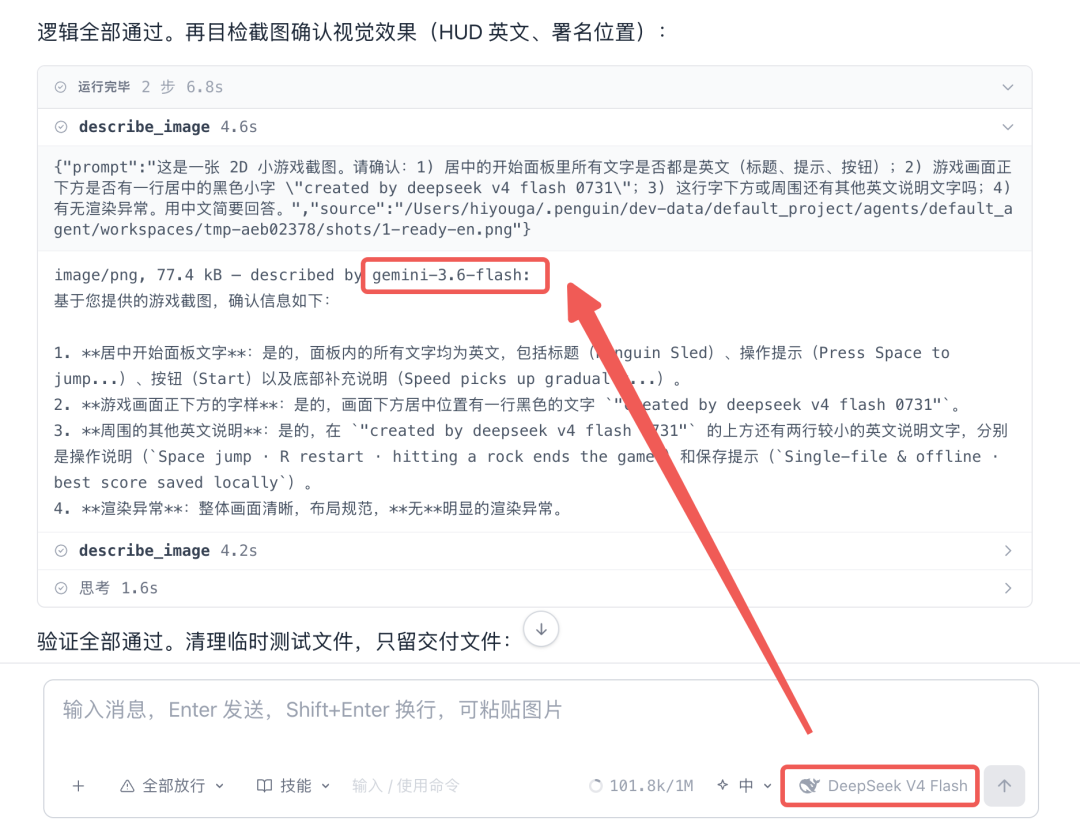
Um agente com capacidade visual
pode examinar capturas de tela, enquanto o DeepSeek continua sendo o principal modelo de trabalho.*
Isso é útil quando o modelo principal é bom em codificação ou raciocínio, mas não processa imagens nativamente.
Essa técnica não dá diretamente capacidade visual ao modelo principal. Ela cria um fluxo de trabalho multimodelo no qual um modelo visual converte capturas de tela em informações utilizáveis pelo agente principal.
O PenguinHarness registra chamadas de modelo, execuções de ferramentas, tempos, uso de tokens, aprovações e atividades de subagentes.
A interface de Trace exibe a sequência de execução em uma linha do tempo.
Acima está a área de estatísticas globais, que lista claramente valores como lotes, chamadas de ferramentas, número de conexões, bem como dados principais como tokens de entrada, tokens de saída, custo, despesas, tempo de execução e TPS individual. O corpo principal da interface é a linha do tempo de execução da "Rodada 1", que distingue diferentes blocos de tempo para raciocínio do modelo, chamadas de ferramentas, espera de aprovação e execução de chamadas de ferramentas por categoria, correspondendo ao eixo de tempo de duração da execução; abaixo, também são exibidos os registros detalhados de mensagens de execução, incluindo instruções do usuário, o processo de raciocínio do sistema e detalhes das chamadas de ferramentas, apresentando completamente os detalhes sequenciais da execução do agente, e a visão Trace descrita no contexto pode ser usada para visualizar subagentes paralelos, chamadas de modelo, uso de ferramentas e outros conteúdos em correspondência.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/08/29548888-b6dd-4d98-a216-beef965d0417-f038b908-4c76-409a-af91-fe7f4f3c580a.png)
A visão Trace ajuda os usuários a inspecionar subagentes paralelos, chamadas de modelo, uso de ferramentas, latência e custo de tokens.
Isso ajuda a identificar:
Os dados de Trace também são o núcleo da auto-evolução, pois o otimizador precisa de evidências sobre por que a versão anterior perdeu pontos.
O PenguinHarness também pode ser usado como um agente genérico minimizado, e não apenas como um construtor de automação.
O projeto usa o Shell como interface genérica de baixo nível e mantém conscientemente o conjunto de ferramentas padrão pequeno e enxuto.
Ele trata a execução de subagentes como uma característica central de desempenho.
O código-fonte relata que o prompt de sistema padrão tem aproximadamente 1.300 tokens, enquanto o valor comparativo do Claude Code no projeto é de cerca de 15.000 tokens.
Esse número é auto-relatado pelo projeto e pode mudar conforme qualquer um dos produtos evolui.
O princípio de design subjacente é estável: prompts mais curtos e um conjunto de ferramentas menor reduzem a sobrecarga de tokens e tornam os modelos abertos mais fáceis de usar.
O projeto publicou resultados comparativos em um conjunto complexo de análise de dados.
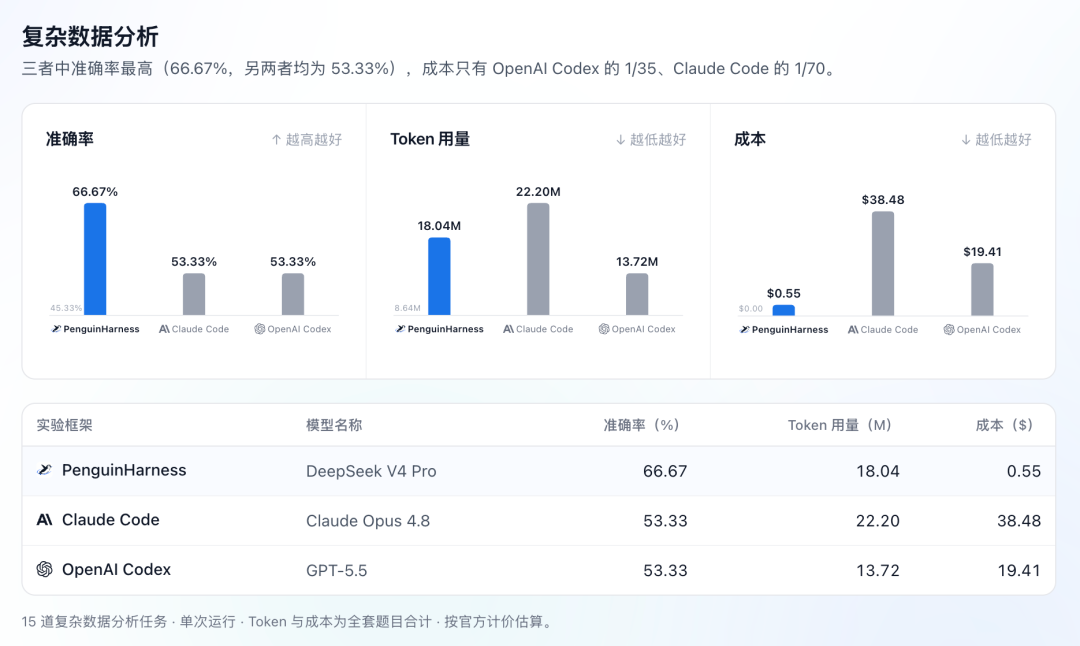
O projeto relata ter alcançado maior precisão em sua comparação de análise de dados complexos com uma fração do custo do modelo.
A tabela de dados publicada relata:
| Framework | Modelo | Precisão | Uso de tokens | Custo estimado |
|---|---|---|---|---|
| PenguinHarness | DeepSeek V4 Pro | 66,67% | 18,04M | US$ 0,55 |
| Claude Code | Claude Opus 4.8 | 53,33% | 22,20M | US$ 38,48 |
| OpenAI Codex | GPT-5.5 | 53,33% | 13,72M | US$ 19,41 |
O projeto resume isso como:
Codex
Esta comparação combina cada ferramenta com o modelo com o qual é normalmente emparelhada. Ela não separa a contribuição da ferramenta da contribuição do modelo escolhido e dos preços do provedor.
Para uma avaliação interna justa, as equipes devem executar as mesmas tarefas usando:
Os dados públicos podem servir como referência de benchmark do projeto, mas não devem ser interpretados como uma taxa de custo universal aplicável a todas as tarefas.
O artigo de origem afirma que a equipe usou o PenguinHarness em dois cenários de produção.
Diz-se que uma instituição de exames físicos usou o PenguinHarness para criar um agente de revisão de relatórios, cujo desempenho foi descrito como comparável ao de especialistas médicos.
De acordo com a equipe do projeto, um trabalho de revisão que originalmente levava cerca de 30 minutos pode ser concluído em dezenas de segundos.
Diz-se que uma empresa de manufatura implantou vários agentes construídos com o PenguinHarness para monitorar continuamente equipamentos de linha de produção e tentar recuperação automática.
A equipe relatou:
Estes são dados de estudo de caso fornecidos pelo fornecedor. O relatório original não fornece nomes de clientes, desenho de pesquisa, tamanho da amostra, definições de linha de base ou auditoria independente.
Estes devem ser considerados como exemplos de casos de uso relatados, não como resultados operacionais garantidos.
O PenguinHarness suporta Linux, macOS e Windows 10 ou versões posteriores, com suporte a sistemas x64 e Arm64 quando disponível.
O script de instalação em uma linha inclui seu próprio runtime Node.js. A instalação via npm requer Node.js 24 ou superior.
curl -fsSL https://penguin.ooo/install.sh | sh
penguin web
A interface web abre no endereço:
http://127.0.0.1:7364
irm https://penguin.ooo/install.ps1 | iex
penguin web
npm install -g @prismshadow/penguin-cli
penguin web
Na instalação via CLI, o primeiro login na web usa o nome de usuário admin. A senha inicial é impressa na primeira inicialização do servidor e deve ser alterada imediatamente.
O repositório oficial fornece exemplos de CLI como os seguintes:
penguin config model add \
  --provider deepseek \
  --model-id deepseek-v4-flash \
  --api-key sk-... \
  --set-default
Executar uma tarefa única:
penguin run -m "Crie hello.txt contendo Hello, Penguin"
Iniciar uma sessão interativa:
penguin chat
Iniciar um servidor headless:
penguin server
Chaves de API nunca devem ser commitadas em sistemas de controle de versão de código-fonte, nem coladas em logs públicos.
O PenguinHarness pode ser executado em uma máquina local ou servidor. Sua interface de navegador suporta múltiplas sessões, gerenciamento de agentes e habilidades, configuração de modelos, estatísticas de uso, observabilidade de Trace e fluxos de trabalho de avaliação.
O projeto atualmente indica que algumas
builds da versão desktop não são assinadas, o que pode acionar avisos do sistema operacional na primeira inicialização. Os usuários devem baixar apenas do site oficial ou
Baixe o instalador pelos GitHub Releases e verifique a descrição do projeto antes de ignorar os avisos.
O PenguinHarness foi lançado como código aberto pela PrismShadow, uma equipe fundada em 2025, dedicada à construção de infraestrutura de agentes capaz de aprender com conhecimento de negócios, fluxos de trabalho e feedback.
Os membros fundadores listados no relatório original são:
| Membro da equipe | Histórico |
|---|---|
| Zheng Yaowei | Criador do LlamaFactory; focado em modelos acessíveis e infraestrutura de agentes |
| Qian Buyue | Doutor pela UC Davis; ex-pesquisador do IBM T. J. Watson e ex-professor da Universidade de Fudan |
| Wu Xuejun | Membro fundador do NLP da Baidu; ocupou cargos seniores na Alibaba e na JD Digital |
| Hu Junhao | Doutorando pela Universidade de Pequim; pesquisa em eficiência de modelos e cache |
| Chen Xi | Professor da Stern School of Business, NYU; doutor pela Carnegie Mellon, ex-cientista-chefe da Amazon |
Os perfis individuais nas fontes foram fornecidos pelos editores e pela equipe do projeto. Quando essas informações tiverem impacto substancial em questões de emprego ou validação acadêmica, os leitores devem verificá-las nas páginas oficiais das instituições.
Do LlamaFactory ao PenguinHarness, o objetivo declarado da equipe permanece o mesmo: transformar infraestrutura complexa de inteligência artificial em ferramentas mais acessíveis, confiáveis e eficientes para um público mais amplo.
O PenguinHarness é um framework de agentes de código aberto para construir, executar, avaliar e otimizar agentes de IA. Ele oferece interface web, CLI, SDK, habilidades integradas, configuração de modelos, rastreamento e fluxos de trabalho de avaliação multiagente.
Sim. O código-fonte principal é distribuído sob a licença Apache 2.0. Os usuários ainda são responsáveis pelos custos de API de modelos, infraestrutura ou serviços de terceiros gerados por suas cargas de trabalho.
Sim. Ele roda em Linux, macOS e Windows, tanto como aplicativo de desktop quanto por meio de CLI e interface de navegador. Também pode ser instalado em servidores para uso remoto.
Sim. Ele inclui habilidades e integrações com ferramentas como Ollama e vLLM, além de suportar endpoints personalizados compatíveis com OpenAI. A compatibilidade real depende do comportamento da API do modelo e dos recursos necessários.
Auto-evolução significa que o sistema avalia agentes, analisa pontuações e registros de rastreamento, modifica prompts, habilidades ou configurações aprovadas, e testa candidatos da próxima versão. Um candidato só é aceito se tiver desempenho superior sob as avaliações configuradas.
O contrato do projeto diz que não. A evolução é limitada a espaços de trabalho, prompts, habilidades e configurações aprovadas, enquanto o núcleo do framework e os mecanismos de segurança permanecem inalterados.
Não. O valor de ¥0,2 vem de uma demonstração do projeto que usou o DeepSeek V4 Pro para gerar um aplicativo RAG. O custo real depende da precificação do modelo, uso de tokens, número de tentativas, provedor e complexidade da tarefa.
O GDPevo é um benchmark aberto que mede a capacidade de auto-evolução de agentes em tarefas reais de negócios separadas. Sua versão pública V2 contém 240 tarefas em 24 categorias e distingue tarefas de treino e de teste.
O PenguinHarness é uma plataforma de código aberto que permite que agentes construam outro aplicativo de agente com base em necessidades expressas em linguagem natural. Ele pode gerar estrutura de código, prompts, habilidades, configurações, código, interface frontal e instruções de execução, além de suportar modelos hospedados e locais.
O foco de longo prazo é a auto-evolução. Múltiplos agentes avaliadores pontuam o agente alvo, um otimizador analisa os resultados e os registros de execução, e um candidato só é aceito se obtiver pontuação maior. O CONTRACT.md limita o que pode ser alterado e exige snapshots, reversão, critérios de avaliação ocultos, aprovações, isolamento de credenciais e trilhas de auditoria.
O projeto relata reduções significativas de custo e ganhos iniciais de produção, mas esses números são demonstrações e estudos de caso fornecidos pela equipe, não conclusões universalmente aplicáveis.
Garantia. O repositório Apache 2.0, os comandos publicados e o benchmark GDPevo oferecem material suficiente para que desenvolvedores testem a abordagem em suas próprias cargas de trabalho.
A ideia central do PenguinHarness é direta: construir agentes deve ser automatizável, mas melhorá-los com segurança exige avaliação mensurável, limites rigorosos e mudanças reversíveis.
Comece com uma frase e tenha um site completo em minutos.



