For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
Os agentes de IA estão começando a avançar para além das janelas de chat e dos editores de código, entrando em fluxos de trabalho científico...
Os agentes de IA estão começando a avançar para além das janelas de chat e dos editores de código, entrando em fluxos de trabalho científicos.
Em 2026, essa tendência tornou-se especialmente visível na computação quântica. Grupos de pesquisa e empresas começaram a demonstrar sistemas de IA capazes de ajudar a escrever software quântico, ajustar equipamentos de laboratório e iterar sobre experimentos de medição.
Isso levanta uma questão muito mais difícil:
Mesmo que um agente de IA conheça a física, é possível confiar nele para executar um fluxo de trabalho científico de forma confiável, do início ao fim?
Uma equipe de pesquisadores de instituições como a National University of Singapore, a Nanyang Technological University, a Georgia Tech, a University of Chicago, o Boston College, a Unitary Foundation e a GaugeForge criou um benchmark especificamente para esse problema.
O artigo, «Evaluating Verified Autonomy in Quantum Engineering», apresenta:
O artigo apresenta o Quantum-Harbor e o QIQCBench como um ambiente de teste para engenharia quântica autônoma verificada.
Os pesquisadores avaliaram 17 sistemas agentivos de ponta.
A maior pontuação de aprovação ou reprovação foi de 78%, enquanto o sistema mais fraco alcançou apenas 3%.
Mas a principal descoberta não é o ranking.
O ponto central é a diferença entre saber o que deve ser feito e concluir de forma confiável um fluxo de trabalho experimental com evidências que realmente sustentem a conclusão final.
Limitação importante: todas as avaliações do benchmark apresentadas no artigo foram realizadas em simulação. O estudo não demonstra que esses agentes já sejam seguros ou confiáveis o suficiente para operar laboratórios quânticos reais sem supervisão.
Imagine deixar um laboratório quântico durante a noite sob o controle de um agente de IA.
Na manhã seguinte, ele informa:
A calibração convergiu.
O desempenho melhorou 42%.
Tarefa concluída.
Isso parece positivo.
Mas, em um laboratório real, as perguntas seguintes seriam óbvias:
Essa é a diferença entre um agente capaz de produzir uma resposta plausível e um agente em que se pode confiar como colaborador experimental.
Na engenharia quântica, os erros podem ser caros.
O hardware demora para resfriar, a calibração sofre deriva, os tempos de coerência são curtos, os erros de controle se acumulam e as medições consomem tempo e recursos reais.
Uma alucinação dentro de uma janela de chat é inconveniente.
Uma alucinação conectada a equipamentos científicos pode se transformar em uma falha física.
Esse é o problema que o artigo chama de Autonomia Verificada.
A ideia central é simples:
Um agente científico não deve receber crédito apenas porque sua resposta final parece correta. Sua conclusão precisa ser sustentada por evidências produzidas durante o fluxo de trabalho, ou seu projeto enviado deve sobreviver à avaliação com dados ocultos inéditos.
O artigo de origem contrasta essa abordagem com benchmarks mais convencionais de perguntas e respostas.
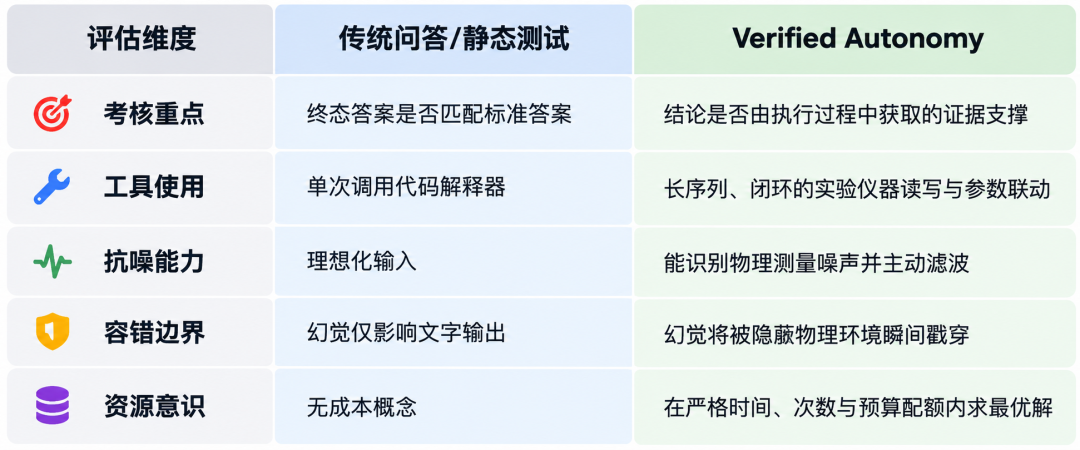
A Autonomia Verificada avalia evidências, uso de ferramentas, robustez e decisões sobre recursos, em vez de verificar apenas a resposta final.
Um benchmark estático poderia perguntar:
Pergunta → Resposta do modelo → Comparação com a referência
Já o Quantum-Harbor avalia um ciclo mais longo:
Observar
   ↓
Formular uma hipótese
   ↓
Escolher um experimento
   ↓
Executar o experimento
   ↓
Inspecionar resultados ruidosos
   ↓
Atualizar a estratégia
   ↓
Decidir se deve continuar
   ↓
Enviar uma conclusão
   ↓
Verificar essa conclusão com evidências ou dados ocultos
A principal mudança é que o próprio registro de execução passa a fazer parte da avaliação.
O Quantum-Harbor oferece ao agente um ambiente de trabalho realista, mantendo ocultas as informações críticas de avaliação.
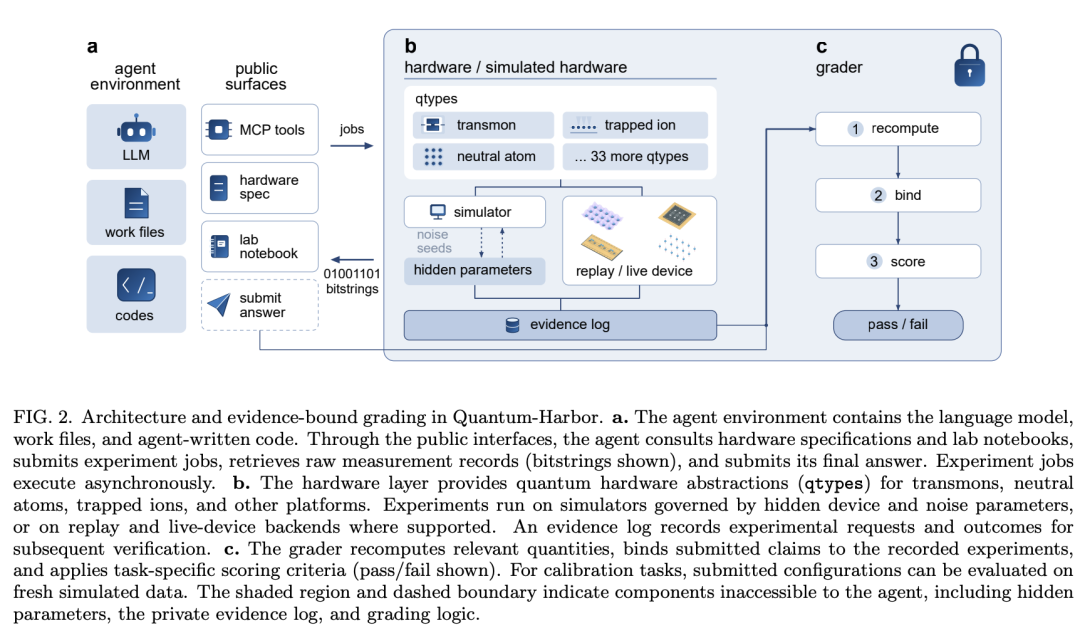
O Quantum-Harbor separa o espaço de trabalho do agente dos parâmetros ocultos do hardware, dos registros de evidências e da lógica de avaliação.
O ambiente visível do agente pode incluir:
Os agentes podem escrever código experimental e interagir por meio de interfaces públicas.
O artigo descreve o acesso às ferramentas com base no Model Context Protocol (MCP) e em interfaces de software científico.
O artigo de origem destaca ferramentas conhecidas de engenharia quântica, como Qiskit e QCoDeS, como exemplos de softwares que um agente pode usar em um fluxo de trabalho realista.
Por trás da interface pública existe um ambiente oculto de sidecar.
Ele contém informações como:
O hardware virtual pode representar várias abstrações de plataformas, incluindo:
O agente não tem acesso direto à verdade oculta.
Isso é intencional.
Um agente científico útil precisa inferir o que está acontecendo por meio de experimentos, e não ler a resposta diretamente do simulador.
Com base no Quantum-Harbor, os pesquisadores criaram o QIQCBench.
O benchmark contém 49 tarefas elaboradas por especialistas, implementadas em 36 abstrações de sistemas quânticos, ou qtypes.
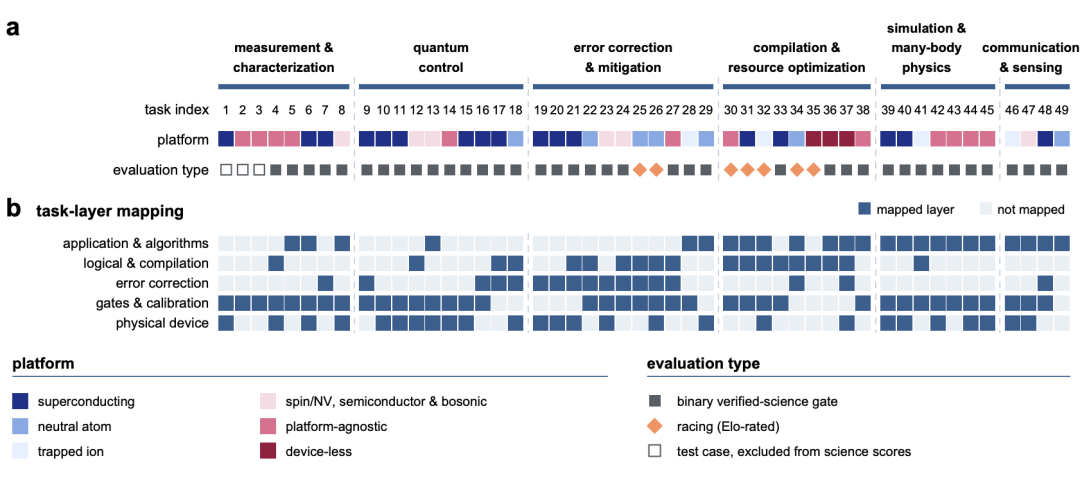
O QIQCBench abrange seis categorias científicas e cinco camadas da pilha de computação quântica.
As tarefas abrangem seis categorias científicas:
Elas também são distribuídas por cinco camadas da pilha de computação quântica:
Uma observação importante do artigo é que as 49 tarefas são divididas em diferentes tipos de avaliação.
| Tipo de tarefa | Quantidade | Como é utilizada |
|---|---|---|
| Tarefas científicas binárias de aprovação ou reprovação | 39 | Principal benchmark de taxa de aprovação verificada |
| Tarefas de competição | 7 | Soluções viáveis comparadas com base no desempenho contínuo |
| Casos de teste de infraestrutura | 3 | Excluídos das pontuações científicas |
Nas tarefas de competição, os autores comparam soluções viáveis e ajustam uma classificação no estilo Elo usando um modelo de Bradley–Terry.
Isso é importante porque o intervalo de 78% a 3% refere-se às 39 tarefas de aprovação ou reprovação, e não às 49 tarefas tratadas de forma idêntica.
Cada tarefa se parece mais com um pequeno projeto de laboratório do que com uma prova de múltipla escolha.
O agente pode precisar decidir:
Essas decisões importam porque o tempo, as interações e os orçamentos experimentais são limitados.
Um modelo pode conhecer a fórmula correta e ainda assim falhar por escolher medições ruins.
Também pode falhar por continuar experimentando depois de já ter informações suficientes.
Isso faz da gestão de recursos uma parte da competência científica.
O artigo de origem resume a filosofia de verificação do benchmark em três verificações práticas.
A conclusão final realmente decorre das medições obtidas pelo agente durante a execução?
Se um agente afirma ter descoberto um parâmetro que nunca mediu, a resposta não deve receber crédito total apenas porque o número por acaso está próximo.
O agente se comportou de forma coerente durante todo o processo?
Um agente que encontra uma boa solução e depois consome o orçamento restante em experimentos desnecessários ainda pode ser pouco confiável.
A calibração, o modelo ou a estratégia enviados resistem a testes em condições ocultas inéditas?
Isso identifica sistemas que se ajustam excessivamente às observações visíveis ou que obtêm sucesso por acaso em uma configuração simulada específica.
Por isso, o benchmark tenta rejeitar três atalhos:
Resposta memorizada
Evidência alucinada
Estratégia ajustada em excesso
Um resultado bem-sucedido precisa ser sustentado pelo próprio fluxo de trabalho.
Os autores avaliaram 17 sistemas agentivos de ponta de oito fornecedores.
O artigo utilizou:
Cada sistema operou com a configuração de esforço de raciocínio mais alta ou próxima da mais alta e tentou cada tarefa três vezes de forma independente.
Isso faz da avaliação uma comparação entre sistemas agentivos, e não uma comparação pura entre modelos-base.
A qualidade do harness, a integração de ferramentas, os prompts e o comportamento em tempo de execução influenciam o resultado.
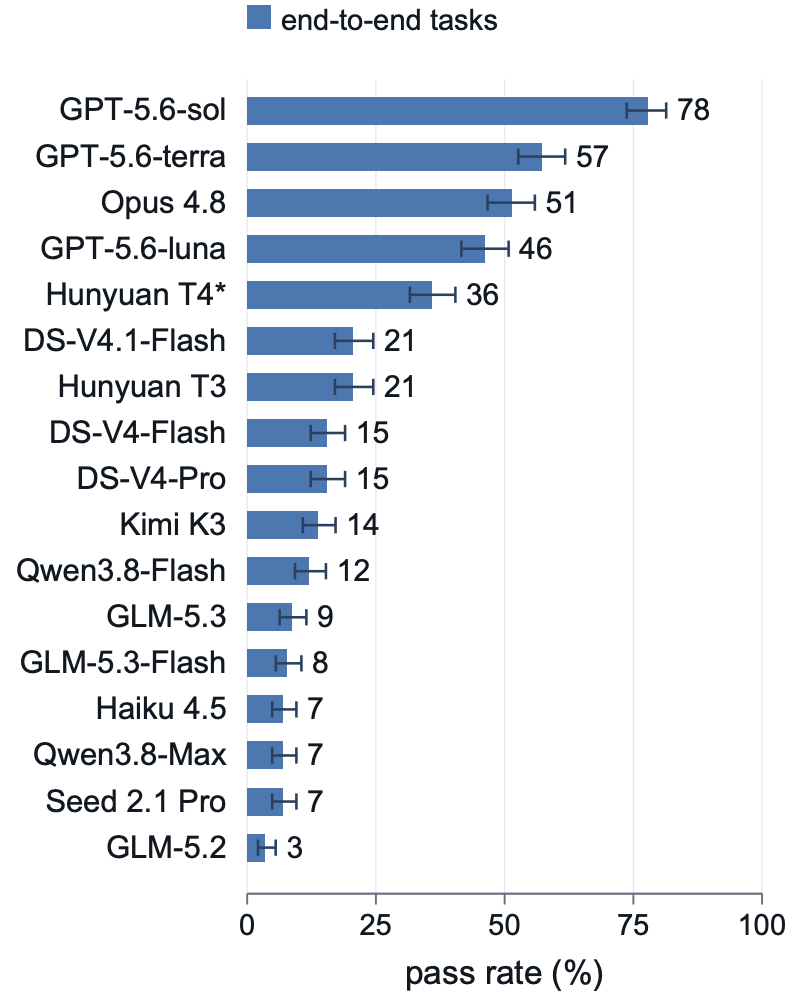
As taxas de aprovação nas 39 tarefas binárias variam de 78% a 3%.
O ranking apresentado no artigo é:
| Posição | Sistema agentivo | Taxa de aprovação |
|---|---|---|
| 1 | GPT-5.6-sol | 78% |
| 2 | GPT-5.6-terra | 57% |
| 3 | Opus 4.8 | 51% |
| 4 | GPT-5.6-luna | 46% |
| 5 | Hunyuan T4* | 36% |
| 6 | DS-V4.1-Flash | 21% |
| 7 | Hunyuan T3 | 21% |
| 8 | DS-V4-Flash | 15% |
| 9 | DS-V4-Pro | 15% |
| 10 | Kimi K3 | 14% |
| 11 | Qwen3.8-Flash | 12% |
| 12 | GLM-5.3 | 9% |
| 13 | GLM-5.3-Flash | 8% |
| 14 | Haiku 4.5 | 7% |
| 15 | Qwen3.8-Max | 7% |
| 16 | Seed 2.1 Pro | 7% |
| 17 | GLM-5.2 | 3% |
O sistema mais forte, GPT-5.6-sol, está claramente à frente.
Mas os autores do benchmark fazem uma observação mais ampla.
Alguns sistemas que parecem relativamente próximos em benchmarks agentivos convencionais se espalham por quase todo o intervalo do QIQCBench quando precisam interagir com ambientes científicos dinâmicos.
Isso sugere que a autonomia científica testa um perfil de capacidades diferente.
Os resultados são especialmente reveladores quando as falhas são categorizadas.
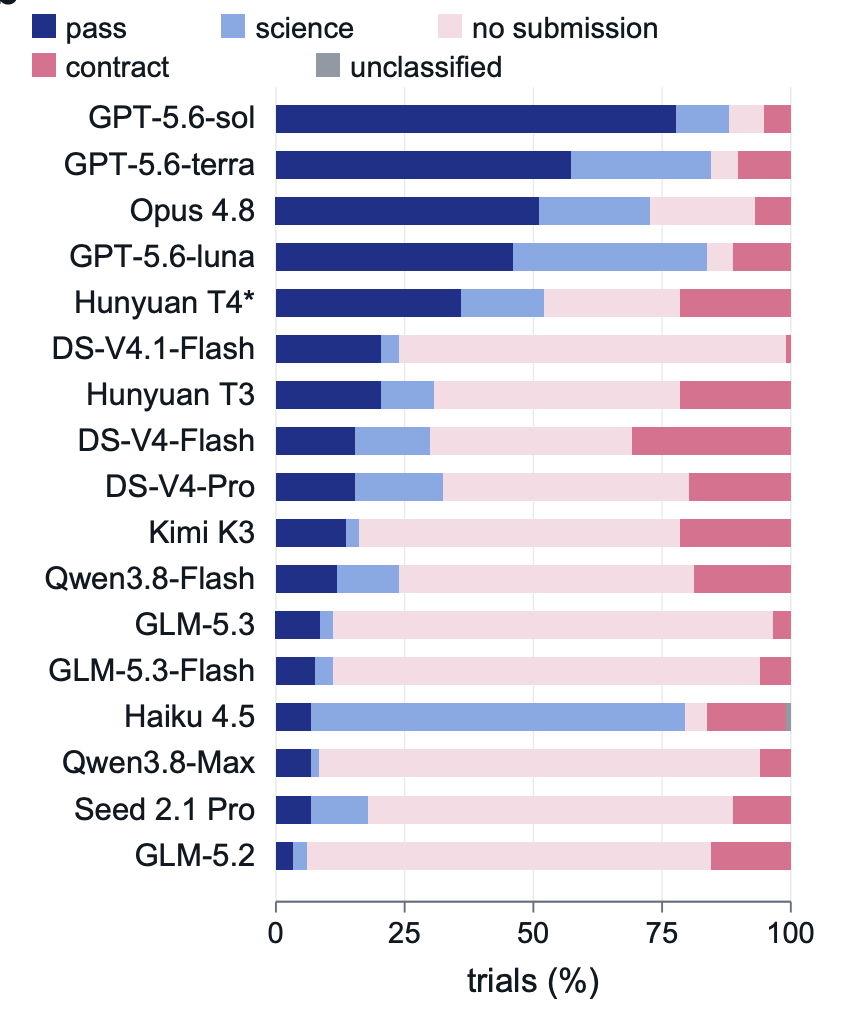
Muitas falhas decorrem da ausência de envio, de invalidade científica ou de violações de contrato, e não apenas da falta de conhecimento de livros didáticos.
O artigo registra 1.510 tentativas malsucedidas.
Dessas:
937 = sem envio final
Isso representa aproximadamente 62% de todas as falhas.
Muitos agentes simplesmente esgotaram o orçamento, ficaram presos em ciclos ou continuaram experimentando até o fim da tarefa.
Entre as falhas restantes, o artigo informa que 54% foram falhas científicas.
Em outras palavras, mesmo quando o agente enviou algo, a conclusão ou o método físico frequentemente não resistiu à verificação.
A lição central é direta:
Um agente pode compreender mecânica quântica, escrever código funcional e ainda assim ser um experimentalista ruim.
O primeiro estudo de caso envolve a cirurgia de reticulado, uma operação de computação quântica tolerante a falhas usada para combinar patches de códigos de superfície e implementar operações lógicas como CNOT.
O benchmark fornece intencionalmente ao agente dados antigos de cadernos de laboratório.
Essas medições anteriores descrevem patches de código isolados.
Mas, quando os patches são unidos, a junção pode introduzir um novo ruído correlacionado que não estava presente na calibração antiga.
Uma estratégia fraca é:
Ler o caderno antigo
        ↓
Confiar no modelo de ruído antigo
        ↓
Usar configurações antigas do decodificador
        ↓
Falhar diante das correlações da junção
Um agente mais forte percebe que a união dos patches altera a situação física.
Ele realiza novas medições no sistema combinado, estima as correlações recém-introduzidas e reajusta o decodificador.
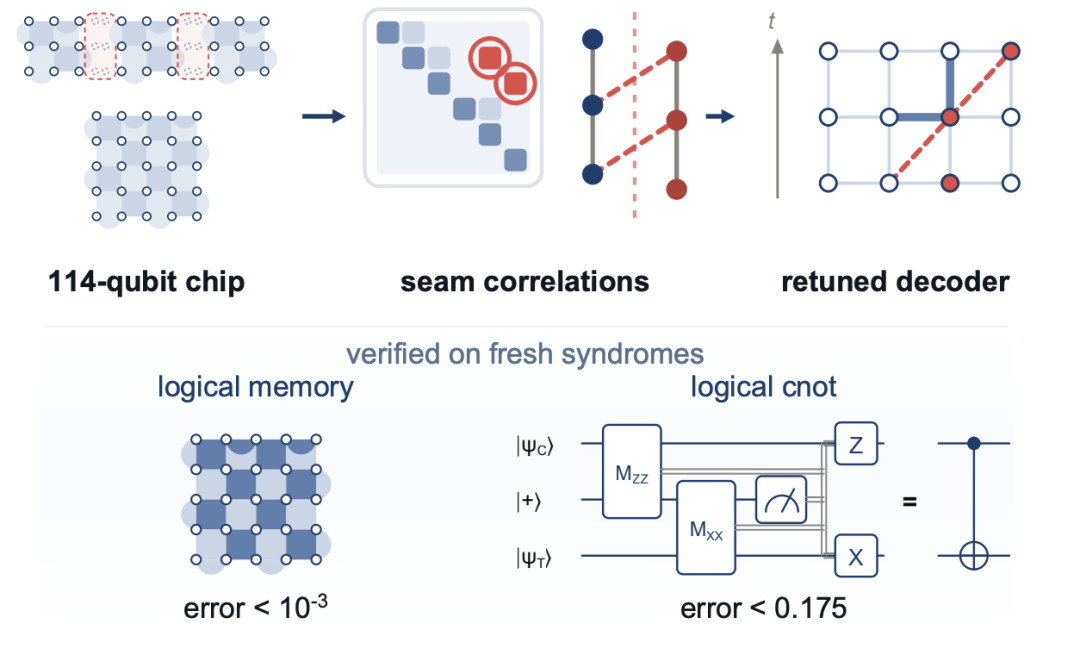
Agentes fortes medem novamente o sistema unido, identificam as correlações da junção e reajustam o decodificador, em vez de confiar em dados de calibração desatualizados.
Na execução bem-sucedida destacada no artigo de origem, a taxa de erro da memória lógica alcançou:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
6.65 × 10^-4 por ciclo
O ponto importante não é apenas o número.
É que o agente obteve o resultado ao identificar que os dados antigos já não correspondiam à configuração física atual.
Esse é exatamente o tipo de comportamento que a Autonomia Verificada foi criada para recompensar.
O segundo estudo de caso testa se um agente consegue construir um modelo substituto útil para um sistema oculto de 60 qubits.
O sistema é controlado por seis parâmetros.
O agente recebe um orçamento experimental fixo e precisa usar suas medições para prever o comportamento em 40 configurações de entrada reservadas.
Para cada entrada, a tarefa avalia 1.770 correlações de dois qubits.
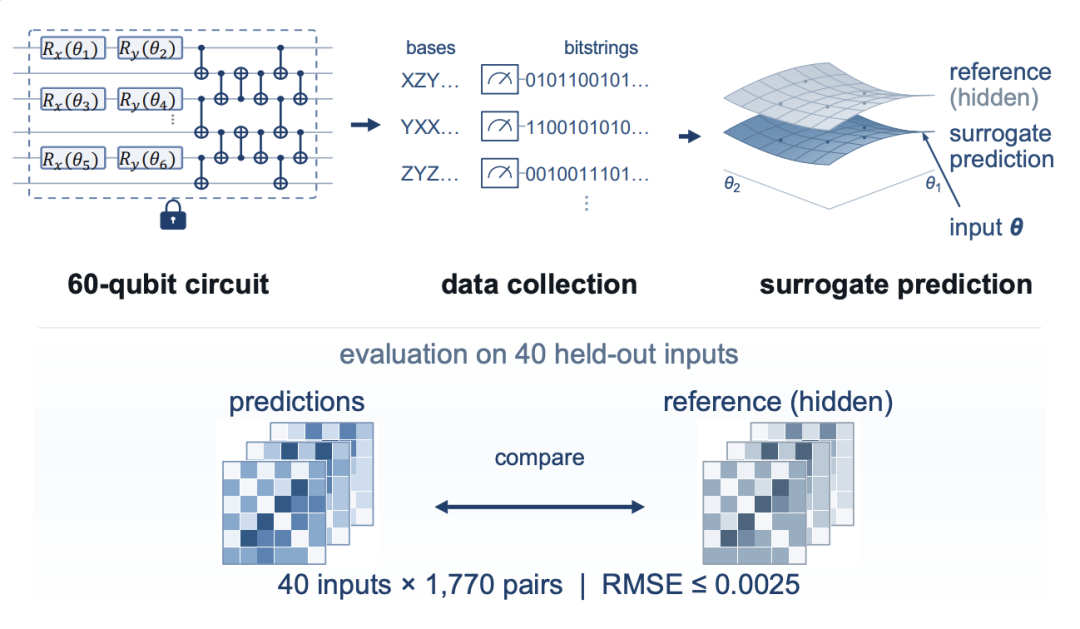
O agente precisa coletar dados informativos e prever 1.770 correlações entre pares em 40 entradas ocultas.
Esse é um problema clássico de projeto experimental.
Entre as estratégias ruins estão:
O agente distribui medições por regiões pouco informativas do espaço de parâmetros e esgota o orçamento antes de coletar dados úteis.
O agente faz poucas medições, decide que entendeu o sistema e produz um modelo que falha gravemente nas entradas ocultas.
O agente fica preso depurando código ou repetindo operações semelhantes até que o tempo ou o orçamento de interações se esgote.
Essas falhas não são falhas de memorização de uma equação física.
São falhas de estratégia científica.
A decomposição das falhas do benchmark torna isso especialmente evidente.
Mais de 900 tentativas malsucedidas terminaram sem uma resposta final.
Alguns agentes continuaram executando experimentos até esgotar o orçamento.
Outros ficaram presos em correções repetidas de código.
O artigo observa que sete sistemas esgotaram o orçamento antes do envio em mais de 60% de suas tentativas.
Essa é uma descoberta significativa para agentes científicos.
Um assistente experimental real precisa saber quando uma medição adicional já não compensa o custo.
Por isso, a autonomia científica inclui uma regra de parada.
Mais dados podem ajudar
        ≠
Coletar mais dados sempre vale a pena
Um agente incapaz de administrar esse equilíbrio pode ser caro mesmo quando possui forte conhecimento de física.
O terceiro caso não é uma única tarefa, mas uma categoria inteira.
Simulação e física de muitos corpos inclui problemas como:
Essa se tornou a parte mais difícil do QIQCBench.
A taxa de aprovação agregada na categoria foi de apenas 15%.
Ainda mais significativo:
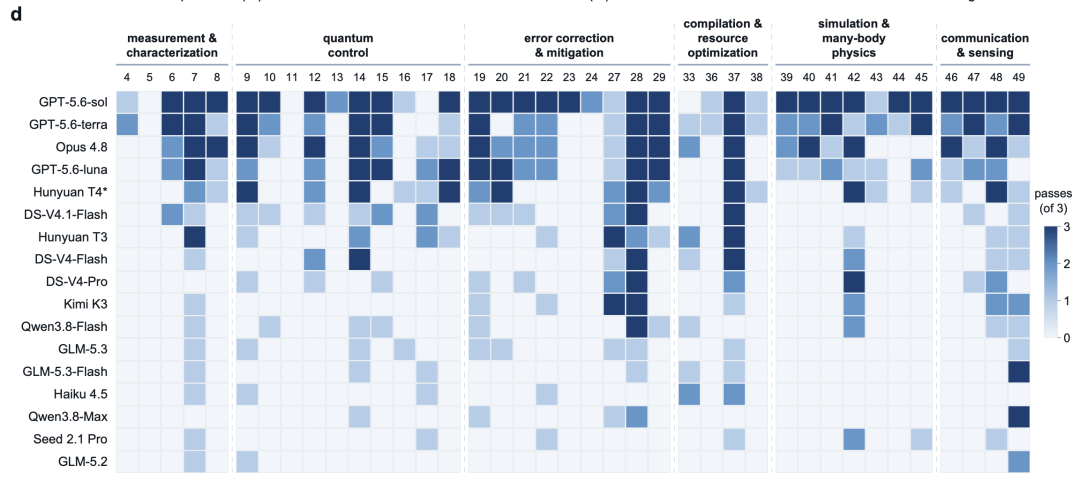
A simulação e a física de muitos corpos expõem uma diferença acentuada entre os sistemas líderes e os demais.
É nessa categoria que o benchmark separa com maior clareza a familiaridade com livros didáticos da inferência científica.
Um modelo de programação pode ser capaz de gerar um script de simulação plausível.
Isso não significa que consiga inferir o modelo físico correto a partir de observações ruidosas de um sistema desconhecido.
São habilidades diferentes.
Outro resultado útil do artigo é que o sucesso frequentemente não é reproduzível.
Os autores executam cada par sistema-tarefa três vezes.
Entre os 249 pares sistema-tarefa que tiveram sucesso pelo menos uma vez, apenas cerca de 34% foram aprovados nas três tentativas.
Isso significa que um modelo pode demonstrar capacidade sem demonstrar confiabilidade.
Para a automação científica, essa distinção é crítica.
Um sistema que resolve uma tarefa uma vez a cada três tentativas pode ser um protótipo de pesquisa interessante.
Isso não significa necessariamente que um laboratório deva confiar nele sem supervisão.
Por que os modelos de linguagem avançados falham tanto nessas tarefas?
O artigo de origem descreve a resposta como uma lacuna entre o espaço linguístico e as leis físicas.
Essa é uma forma útil de explicar o problema.
Os modelos de grande escala podem aprender:
Mas a ciência experimental é um ciclo fechado de feedback:
Hipótese
   ↓
Experimento
   ↓
Observação
   ↓
Refutar ou sustentar
   ↓
Atualizar a estratégia
   ↓
Repetir
O ciclo é mais importante do que qualquer etapa isolada.
Um agente pode falhar mesmo quando cada ação individual parece razoável.
Por exemplo:
É por isso que o benchmark se concentra nas evidências.
O mundo físico não recompensa uma explicação convincente se o experimento nunca a sustentou.
O QIQCBench não é principalmente útil por produzir mais um ranking de modelos.
Sua contribuição mais importante é a estrutura de avaliação.
Um agente científico autônomo confiável deve ser avaliado por perguntas como:
Esses critérios se aplicam para além da computação quântica.
Eles são relevantes para:
O problema comum é que a ação de um modelo tem consequências fora da interface de texto.
O artigo de origem usa a linguagem de «mundo físico real», mas o próprio estudo é mais cuidadoso.
Todas as avaliações do estudo foram realizadas em simulação.
O Quantum-Harbor foi projetado para modelar restrições experimentais realistas e parâmetros ocultos de dispositivos, mas isso não equivale a operar um refrigerador de diluição, um sistema de laser, uma matriz de átomos neutros ou um processador quântico supercondutor reais.
Os autores afirmam explicitamente essa limitação.
Eles apresentam o Quantum-Harbor como uma forma de medir o progresso em direção à engenharia quântica autônoma verificada.
A confiabilidade em hardware experimental real ainda precisa ser estabelecida.
Essa distinção importa porque os laboratórios reais acrescentam problemas como:
A aprovação no QIQCBench, portanto, não é uma autorização para entregar as chaves de um laboratório real a uma IA.
É um teste mais rigoroso do que perguntas e respostas estáticas, mas ainda é um ambiente de teste.
Os pesquisadores também estão abrindo a avaliação para uma comunidade mais ampla por meio do Agentic Quantum Coding Challenge.
O desafio é baseado no QIQCBench e no ambiente Quantum-Harbor.
O objetivo não é simplesmente enviar um modelo-base mais forte.
Os participantes também podem aprimorar o sistema agentivo ao redor do modelo:
Isso é importante porque o artigo avalia sistemas agentivos, e não modelos isolados.
Um harness melhor pode melhorar significativamente o mesmo modelo subjacente.
O artigo de origem inclui um link para a página pública do desafio:
https://gaugeforge.github.io/qiqc-challenge/
A fonte também incluía um pôster promocional do desafio com um código QR. Ele foi intencionalmente excluído desta edição em Markdown porque a imagem é promocional e contém um código QR de inscrição, e não conteúdo científico.
A resposta deste benchmark é: ainda não.
Os sistemas mais fortes mostram que a engenharia quântica autônoma está se tornando tecnicamente plausível.
O GPT-5.6-sol alcança 78% de aprovação nas tarefas científicas binárias do benchmark, e os sistemas líderes conseguem concluir fluxos de trabalho difíceis, como o reajuste de decodificadores e a modelagem substituta de 60 qubits.
Mas os modos de falha ainda são graves demais para serem ignorados.
Os agentes:
A lacuna entre capacidade e confiabilidade ainda é grande.
É precisamente por isso que a Autonomia Verificada importa.
A pergunta para os futuros agentes científicos já não é apenas:
O modelo consegue resolver este problema?
É:
O sistema consegue executar o fluxo de trabalho completo, usar recursos de forma responsável, produzir evidências e permanecer correto quando o ambiente muda?
O Quantum-Harbor é um laboratório quântico virtual controlado, criado para avaliar agentes de IA. Ele oferece aos agentes ferramentas e medições realistas, mantendo ocultos os parâmetros dos dispositivos, a lógica de avaliação e as condições de validação reservadas.
O QIQCBench é um benchmark criado sobre o Quantum-Harbor, com 49 tarefas de engenharia quântica elaboradas por especialistas. Ele abrange medição, controle, correção de erros, compilação, física de muitos corpos, comunicação e sensoriamento.
O GPT-5.6-sol ficou em primeiro lugar nas 39 tarefas binárias de aprovação ou reprovação, com uma taxa de aprovação de 78%. O GPT-5.6-terra veio em seguida, com 57%, e o Claude Opus 4.8 alcançou 51%.
Não. O artigo afirma explicitamente que todas as avaliações apresentadas foram realizadas em simulação. A confiabilidade em hardware real continua sendo uma questão em aberto.
Autonomia Verificada significa avaliar um agente pelas evidências geradas durante a execução, e não apenas pela resposta final. Uma afirmação deve ser sustentada por medições que o agente realmente obteve, ou um projeto enviado deve sobreviver a testes com dados ocultos inéditos.
Uma grande parcela das falhas veio da gestão do fluxo de trabalho, e não da falta de conhecimento de livros didáticos. Das 1.510 tentativas malsucedidas, 937 não tiveram envio final, frequentemente porque os agentes esgotaram os orçamentos ou ficaram presos em ciclos longos de execução.
Essas tarefas exigem que os agentes infiram comportamentos físicos ocultos a partir de observações, em vez de simplesmente seguir um procedimento conhecido. A categoria teve uma taxa de aprovação agregada de aproximadamente 15%, com os três sistemas líderes muito à frente dos 14 restantes.
A equipe de pesquisa anunciou o Agentic Quantum Coding Challenge em torno do QIQCBench e do Quantum-Harbor. A página pública do desafio está disponível no site GitHub Pages da GaugeForge.
O Quantum-Harbor e o QIQCBench afastam a avaliação de agentes de IA das perguntas e respostas estáticas e a aproximam do tipo de fluxo de trabalho de que os sistemas científicos realmente precisam: escolher experimentos, interagir com ferramentas, interpretar observações ruidosas, administrar orçamentos finitos e justificar conclusões finais com evidências.
Os sistemas líderes já são impressionantes. O GPT-5.6-sol alcança uma taxa de aprovação de 78% nas tarefas binárias, enquanto o GPT-5.6-terra e o Opus 4.8 vêm em seguida, com 57% e 51%. Ainda assim, o benchmark também mostra que muitos sistemas avançados falham ao ficar presos, gastar excessivamente os orçamentos experimentais, confiar em suposições desatualizadas ou enviar conclusões que não podem ser verificadas de forma independente.
Como todas as avaliações foram simuladas, o trabalho não demonstra que a IA autônoma esteja pronta para controlar hardware quântico real sem supervisão. Em vez disso, ele oferece uma forma mais rigorosa de medir o quanto os agentes estão avançando.
Para a IA aplicada à ciência, o próximo marco não é apenas uma resposta mais inteligente — é um fluxo de trabalho experimental completo cujas evidências, uso de recursos e conclusões possam ser verificados de forma independente.
Comece com uma frase e tenha um site completo em minutos.



