For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
Os sistemas de IA estão assumindo uma parcela maior do trabalho envolvido na criação de IA: escrever software, depurar infraestrutura, execu...
Os sistemas de IA estão assumindo uma parcela maior do trabalho envolvido na criação de IA: escrever software, depurar infraestrutura, executar experimentos e sugerir o que tentar em seguida. Isso torna o autoaperfeiçoamento recursivo, normalmente abreviado como RSI, uma questão de pesquisa cada vez mais prática.
A distinção relevante é se a IA acelera um processo dirigido por humanos ou se consegue projetar e desenvolver de forma independente um sucessor mais capaz. O relatório fornecido da BAAI descreve um setor que avança em direção à segunda possibilidade. Pesquisas públicas oferecem evidências concretas da primeira, juntamente com uma incerteza substancial sobre até onde esse progresso irá.
Na discussão de pesquisa da Anthropic, RSI completo significa um sistema tornar-se capaz de projetar e desenvolver autonomamente o seu sucessor. Um agente de programação que melhora um script de treinamento pode contribuir para esse processo sem completar todo o ciclo.
Há diversas capacidades distintas envolvidas:
O sucesso em um nível não comprova o sucesso em todos os níveis posteriores. A Anthropic afirma explicitamente que o RSI completo ainda não foi alcançado em sua análise e que não é inevitável.
A Anthropic relata que, em maio de 2026, o Claude foi responsável por mais de 80% do código integrado à sua base de código. Trata-se de uma medida de atribuição do código integrado, e não da alegação de que a IA tomou mais de 80% de todas as decisões de engenharia.
A empresa também relata que a produção típica de código por engenheiro no segundo trimestre de 2026 foi cerca de oito vezes maior que o nível de 2024, medida por linhas de código integradas por dia. A ressalva da própria empresa é essencial: linhas de código medem quantidade de forma imperfeita e não devem ser interpretadas como um aumento de oito vezes na produtividade útil.
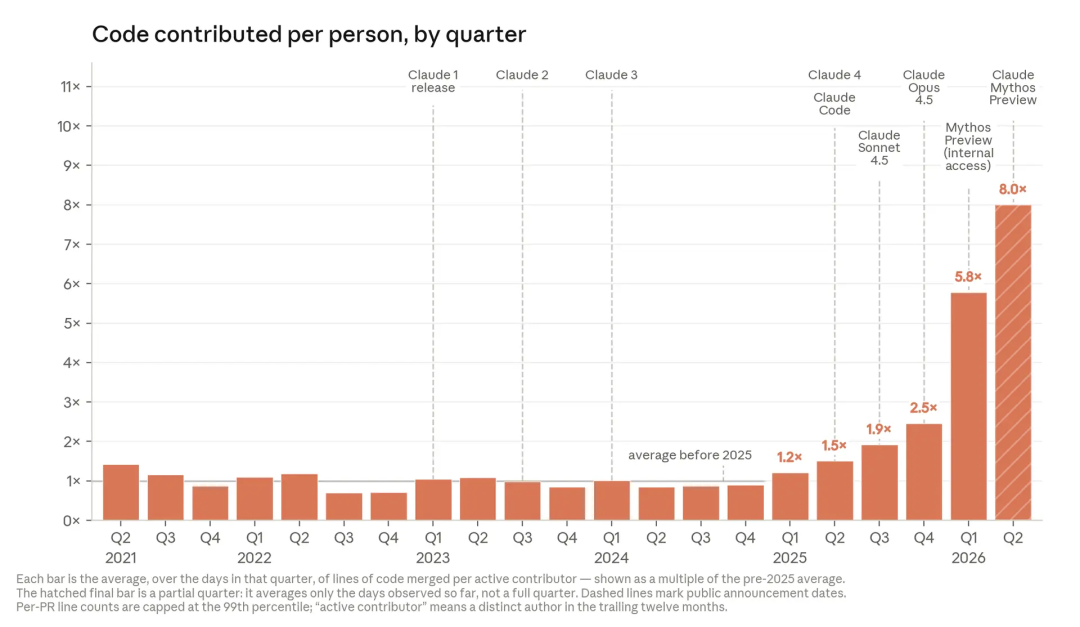
Gráfico da Anthropic reproduzido no artigo da Xinzhiyuan no BAAI Hub.
A mudança prática é que um engenheiro pode orientar e revisar mais trabalho sem digitar cada implementação. Isso ainda deixa objetivos, qualidade do código, infraestrutura compartilhada e capacidade de revisão como restrições. Não comprova que a revisão humana se tornou desnecessária.
Escrever uma implementação é apenas parte da pesquisa. Um agente também precisa executar experimentos, inspecionar resultados e decidir se uma mudança realmente ajudou.
A Anthropic descreve um teste de otimização repetida no qual um modelo recebe código de treinamento e tenta torná-lo mais rápido, preservando as verificações de correção. Os resultados melhoraram de forma significativa ao longo das gerações de modelos. A empresa alerta que o ganho absoluto de velocidade depende de quanto espaço para otimização existe no código inicial; isso não é uma medição de um ganho equivalente no treinamento de modelos de fronteira.
Seu projeto de pesquisa automatizada weak-to-strong oferece outro exemplo. Agentes puderam propor e executar experimentos dentro de um problema e de uma estrutura de pontuação selecionados por humanos. Isso é evidência de automação de pesquisa dentro de limites especificados, e não uma demonstração de que o sistema escolheu de forma independente a agenda de pesquisa mais valiosa.
O SWE-bench avalia alterações de software em tarefas de repositório e testes. Os horizontes de tempo para conclusão de tarefas da METR analisam a duração de tarefas que modelos conseguem concluir em níveis de confiabilidade especificados.
Essas medições respondem a perguntas diferentes. Um sistema pode se tornar melhor em corrigir problemas de repositório ou concluir tarefas mais longas sem conseguir planejar por conta própria um programa bem-sucedido de desenvolvimento de modelos.
Os resultados de horizonte de tempo também são probabilísticos. A duração de uma tarefa em um benchmark não significa que o agente trabalhará de forma confiável durante esse mesmo tempo de relógio em qualquer projeto. Referências humanas, limiares de sucesso, acesso a ferramentas e a distribuição de tarefas são todos fatores relevantes.
O artigo-fonte cita discussões em redes sociais sobre agentes internos, ciclos de lançamento mais curtos, modelos não lançados e grandes resultados científicos. Esses relatos podem indicar temas que valem ser investigados, mas não demonstram de forma independente um ciclo autônomo de autoaperfeiçoamento.
Intervalos de lançamento menores podem ter diversas explicações. Um modelo resolver problemas matemáticos difíceis demonstra capacidade nesses problemas; isso não mostra, por si só, que o modelo aprimorou seu próprio processo de treinamento. Da mesma forma, uma alegação anônima sobre o modelo interno de um laboratório não substitui um relatório técnico com evidências reproduzíveis.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
A conclusão defensável é mais limitada: divulgações públicas mostram que a IA executa uma parcela crescente da engenharia e de parte da pesquisa experimental. Se esse progresso se tornará RSI completo continua sendo uma questão em aberto.
A Anthropic discute tanto os possíveis benefícios quanto os riscos do desenvolvimento cada vez mais automatizado. Agentes de pesquisa mais capazes podem acelerar o trabalho científico, ao mesmo tempo que tornam verificação, monitoramento e alinhamento mais exigentes.
O mesmo processo também pode criar gargalos operacionais comuns. Se agentes geram código mais rapidamente do que as pessoas conseguem revisá-lo, uma geração mais rápida não se converte diretamente em uma implantação confiável mais rápida. Disponibilidade de computação, qualidade dos experimentos e decisões sobre o que desenvolver continuam relevantes mesmo quando a implementação se torna mais barata.
Por isso, uma avaliação de RSI deve acompanhar evidências em cada etapa: o que o agente fez, quem selecionou seu objetivo, quais recursos utilizou e como o resultado foi verificado.
RSI significa autoaperfeiçoamento recursivo. Nesse contexto, refere-se a um sistema de IA que se torna capaz de projetar e desenvolver autonomamente um sucessor mais forte, em vez de apenas ajudar um humano a melhorar software.
A geração de código mostra que parte do processo de desenvolvimento pode ser automatizada. O RSI completo exigiria uma combinação muito mais ampla de direção de pesquisa, implementação, treinamento e avaliação; portanto, uma alta participação de código atribuído à IA não é evidência suficiente.
Ele se refere ao código atribuído ao Claude e integrado à base de código da Anthropic até maio de 2026. Não deve ser interpretado como a proporção de todo o trabalho da empresa executado de forma autônoma nem como a proporção de decisões estratégicas tomadas pela IA.
Elas podem indicar uma mudança no volume de produção, mas não medem diretamente utilidade, capacidade de manutenção ou valor de negócio. A própria Anthropic alerta que seu aumento de oito vezes na produção de código provavelmente superestima o ganho real de produtividade.
Eles descrevem o desempenho em uma coleção específica de tarefas, em níveis de sucesso declarados, usando durações humanas de tarefas como referência. Não garantem que um agente consiga concluir qualquer tarefa real de duração equivalente.
Sim; um agente pode projetar e executar experimentos dentro de um problema e de uma estrutura de pontuação fornecidos por humanos. Isso pode ser uma automação de pesquisa valiosa, enquanto as decisões de nível mais alto continuam com as pessoas.
A discussão principal da Anthropic afirma explicitamente que não é inevitável. Julgamento de pesquisa, computação, infraestrutura, avaliação e outros gargalos podem limitar ou alterar a trajetória, e previsões devem permanecer separadas de resultados demonstrados.
As evidências públicas sustentam um aumento substancial na programação assistida por IA e na automação delimitada de pesquisa. Esses avanços tornam a possibilidade de autoaperfeiçoamento recursivo digna de análise, mas não estabelecem que já exista um ciclo totalmente autônomo de desenvolvimento de sucessores.
A questão-chave é quais partes do desenvolvimento de IA um sistema consegue executar e verificar de forma independente, e não quão dramática parece sua cadência de lançamentos ou seu benchmark de destaque.
Comece com uma frase e tenha um site completo em minutos.



