A Tencent Hunyuan lançou o Hy ASR 3.0 Preview, um novo modelo de reconhecimento de fala em tempo real baseado nas capacidades de compreensão...
A Tencent anunciou o Hy ASR 3.0 Preview, um novo modelo de reconhecimento de fala em tempo real construído sobre a capacidade de compreensão de linguagem do Hy3.
O modelo foi projetado para levar o reconhecimento automático de fala além da decodificação acústica isolada.
Os sistemas tradicionais de ASR respondem principalmente a uma pergunta:
Qual sequência de palavras corresponde melhor a este áudio?
O Hy ASR 3.0 adiciona uma segunda pergunta:
Qual transcrição faz mais sentido no contexto?
Essa distinção é crucial quando o áudio contém:
A Tencent afirma que o modelo combina um sistema acústico de alta precisão com a modelagem de contexto e o raciocínio semântico do Hy3. O objetivo não é reescrever criativamente o que o usuário disse, mas usar o contexto linguístico para selecionar a transcrição mais plausível quando o áudio em si é ambíguo.
A Tencent relatou uma taxa de erro de palavras (WER) de 3,34% para mandarim, 2,62% para inglês e 3,12% para cantonês em conjuntos de avaliação públicos agregados.
O Hy ASR 3.0 Preview já está disponível com documentação como mecanismo WebSocket em tempo real da Tencent Cloud e foi integrado ao assistente Tencent Yuanbao. O WorkBuddy e outros produtos da Tencent estão sendo integrados gradualmente.
A versão de visualização pública já está disponível, mas ainda não atingiu a forma final do produto descrita no anúncio mais amplo. Suas limitações atuais de API são relevantes para equipes que planejam integrações de produção.
A Tencent avaliou o Hy ASR 3.0 Preview em vários conjuntos de dados públicos de fala e o comparou com outros sistemas de ASR.
As taxas de erro de palavras agregadas relatadas pela empresa são as seguintes:
| Idioma ou variante de fala | WER do Hy ASR 3.0 Preview |
|---|---|
| Mandarim | 3,34% |
| Inglês | 2,62% |
| Cantonês | 3,12% |
Quanto menor o WER, melhor.
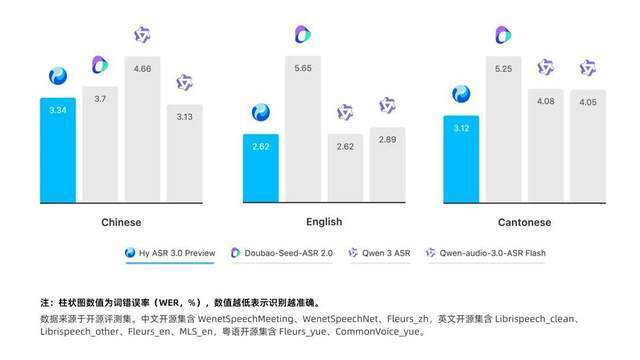
As notas do gráfico indicam que a avaliação agregada utilizou os seguintes conjuntos de dados:
Os dados agregados são úteis para comparações amplas, mas também podem ocultar diferenças importantes.
O desempenho do modelo pode variar em diferentes cenários:
Portanto, as equipes de produção devem testar com seu próprio áudio.
Em vez de escolher um modelo de ASR apenas com base no número de WER de um único título.
A taxa de erro de palavras é normalmente definida como:
WER = (substituições + exclusões + inserções) / número de palavras de referência
Os três tipos de erro são:
Um WER mais baixo geralmente indica uma transcrição mais precisa.
No entanto, o WER não cobre todas as falhas em cenários do mundo real.
Considere dois erros de uma única palavra:
"Envie o pedido amanhã"
→ "Envie o pedido hoje"
E:
"A cor é azul-marinho"
→ "A cor é azul marinho"
Ambos podem produzir contagens de erro semelhantes, mas o primeiro pode alterar uma ação comercial, enquanto o segundo pode não ter nenhum impacto para o negócio.
Para setores como atendimento ao cliente, saúde, finanças, manufatura e interfaces de comando, as equipes devem avaliar tanto o impacto semântico quanto o WER.
A Tencent também divulgou resultados de conjuntos de avaliação internos que abrangem quatro categorias práticas:
Os resultados relatados são os seguintes:
| Categoria de avaliação interna | WER do Hy ASR 3.0 Preview |
|---|---|
| Reconhecimento geral | 4,95% |
| Reconhecimento de dialetos | 9,31% |
| Avaliação de contexto | 4,76% |
| Condições acústicas complexas | 6,36% |
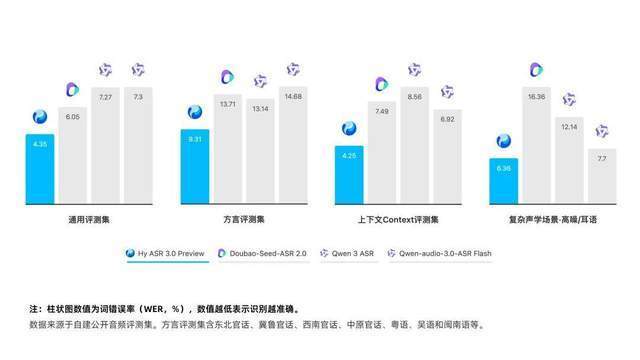
A Tencent afirma que o Hy ASR 3.0 Preview alcançou o menor WER entre os sistemas comparados em todas as quatro categorias internas.
Esses resultados são úteis como evidência de produto relatada pela empresa, mas os conjuntos de testes internos não são benchmarks públicos neutros.
Antes da adoção, as organizações devem perguntar:
A Tencent resume as melhorias práticas em quatro áreas.
O modelo foi projetado para melhorar o reconhecimento nos seguintes cenários:
A Tencent também afirma que o modelo reduz erros cumulativos em enunciados mais longos.
Essa afirmação descreve a capacidade subjacente do modelo. A versão Preview atual da Tencent Cloud ainda limita a entrada pública da API a 60 segundos por chamada; portanto, aplicações que processam reuniões ou gravações precisam segmentar o áudio atualmente.
E gerenciar o contexto entre os segmentos por conta própria.
Uma segmentação inadequada pode reintroduzir os problemas que o modelo foi projetado para resolver.
Por exemplo, cortar o áudio em limites arbitrários de 60 segundos pode interromper:
Portanto, a lógica de segmentação deve preservar ao máximo os limites de sentença e os limites de atividade de fala.
A fala contém muitos sons ambíguos.
O mandarim possui um grande número de homófonos. O inglês tem palavras e nomes com pronúncias semelhantes. Sotaques regionais podem fazer com que múltiplas transcrições candidatas pareçam acusticamente plausíveis.
Decodificadores tradicionais podem escolher a palavra com maior probabilidade local.
Sistemas com capacidade de percepção de contexto podem avaliar a fala completa.
Por exemplo, um usuário pode dizer uma frase que pode ser transcrita como dois homófonos diferentes. Palavras relacionadas a finanças, jogos, medicina ou viagens nas proximidades podem indicar qual significado é mais provável.
O fluxo de processamento pretendido pode ser simplificado como:
Características de áudio
→ Palavras candidatas
→ Contexto da sentença
→ Verificação de consistência semântica
→ Texto transcrito final
Isso não significa que o modelo possa realmente compreender a fala da mesma forma que um humano.
Em vez disso, significa que os componentes de linguagem utilizam uma janela de contexto mais ampla e probabilidades semânticas para melhorar as decisões de transcrição.
Sistemas ASR com percepção de contexto também trazem novos riscos: correção semântica excessiva.
O modelo pode, às vezes, substituir uma frase incomum, mas foneticamente correta, por uma frase comum que parece mais fluente.
Portanto, a avaliação em ambiente de produção deve incluir:
O objetivo é usar o contexto sem inventar conteúdo de fala que nunca foi pronunciado.
Os materiais de divulgação destacam o aprimoramento por palavras-chave, aplicável a:
Quando um modelo genérico não tem frequência suficiente de ocorrência para uma palavra rara, as palavras-chave podem agregar valor significativo.
Exemplos incluem:
Nomes de medicamentos patenteados
Modelos de máquinas de fábrica
Códigos de conta de clientes
Marcas recém-lançadas
Abreviações técnicas
O produto ASR genérico da Tencent Cloud já possui API de lista de palavras-chave e o parâmetro hotword_id.
No entanto, a documentação atual do preview do Hy ASR 3.0 declara explicitamente que o aprimoramento por palavras-chave ainda não está disponível para este mecanismo de preview.
Portanto, deve-se distinguir entre as promoções públicas do produto e o status real da API acessível:
| Capacidade | Notas de lançamento do modelo | Status atual da API de preview |
|---|---|---|
| Aprimoramento por palavras-chave | Descrito como capacidade suportada | Listado como "em breve" |
| Entrada de contexto | Descrito como capacidade principal | Listado como "em breve" |
| Modelagem de linguagem contextual interna | Característica central do modelo | Disponível por meio do comportamento do modelo |
Até que a Tencent Cloud confirme o suporte na documentação oficial da API, as empresas não devem planejar lançamentos que dependam de injeção de contexto externo ou listas de palavras-chave.
A Tencent afirma que o modelo foi otimizado para as seguintes situações:
A robustez ao ruído é importante porque a fala real raramente aparece como gravações limpas de laboratório.
Microfones de atendimento ao cliente podem capturar sons de teclado e colegas falando ao lado.
Assistentes móveis podem ouvir ruído de trânsito, vento, música ou outras pessoas falando.
Aplicativos de reunião podem receber áudio compactado de microfones de laptops distantes.
O modelo pode melhorar a robustez, mas não pode recuperar informações que nunca foram capturadas.
As equipes ainda devem usar:
A qualidade do ASR é uma propriedade do sistema, não apenas do modelo.
A Tencent afirma que o Hybrid Hy ASR 3.0 Preview combina três grandes componentes:
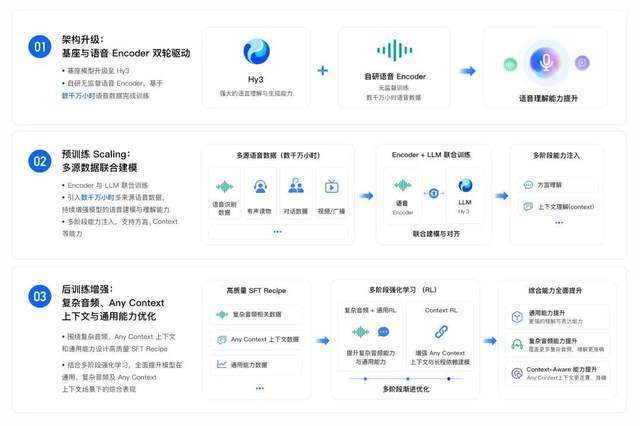
O Hy3 fornece o componente de compreensão de linguagem.
Suas funções incluem:
A Tencent descreve a arquitetura como um design de Mistura de Especialistas (MoE) que equilibra capacidade e eficiência.
A documentação pública de ASR não divulga o número total de parâmetros, parâmetros ativos, perfil de latência ou arquitetura completa de inferência do Hy ASR 3.0 Preview.
O codificador de fala converte o áudio bruto em representações acústicas que o modelo de linguagem pode processar.
A Tencent afirma que o codificador foi treinado com dezenas de milhões de horas de fala não rotulada.
O treinamento de áudio não supervisionado ou autossupervisionado é valioso porque transcrever manualmente dados de fala nessa escala é proibitivamente caro.
O codificador pode aprender estruturas recorrentes a partir do áudio bruto, como:
A qualidade dessa representação afeta todos os estágios subsequentes.
Se dois sons forem confundidos no estágio do codificador, o modelo de linguagem terá que depender mais do contexto para recuperar as palavras corretas.
A Tencent afirma que o codificador de fala e o modelo de linguagem foram treinados em conjunto usando conjuntos de dados de fala de múltiplas fontes em larga escala, cobrindo:
O objetivo é reduzir a lacuna entre o reconhecimento acústico e a compreensão da linguagem.
Em vez de tratar o reconhecimento de fala como:
Modelo de áudio conclui
→ Modelo de linguagem limpa a transcrição depois
O Hy ASR 3.0 é apresentado como um processo mais integrado:
Representação de fala e modelagem de linguagem
→ Treinados para trabalhar juntos
→ Saída de uma transcrição contextualizada

As fronteiras internas exatas entre codificador, decodificador, modelo de linguagem e estágios de aprendizado por reforço não foram totalmente divulgadas.

## SFT e aprendizado por reforço em múltiplos estágios

A Tencent descreve um esquema de ajuste fino supervisionado que cobre:

- Transcrição geral.
- Tarefas de contexto arbitrário.
- Terminologia especializada.
- Diferentes ambientes acústicos.
- Grupos diversificados de falantes.
- Dez principais regiões de dialeto.
- Mais de 20 regiões de dialeto menores.

A empresa também relata o uso de aprendizado por reforço em múltiplos estágios, para:

- Precisão geral de transcrição.
- Comportamento contextual.
- Casos complexos de cauda longa.
- Redução de erros de substituição e exclusão.

Atualmente, não há artigo técnico público fornecendo o design completo de recompensa, proporção de dados, poder computacional de treinamento ou resultados de experimentos de ablação.

Portanto, as declarações de arquitetura devem ser vistas como descrições técnicas no nível do produto, não como especificações de pesquisa reproduzíveis.

## Idiomas e dialetos suportados atualmente pelos mecanismos da Tencent Cloud

A documentação da Tencent Cloud descreve o mecanismo atual `Hy-ASR-3.0-preview` como suportando:

- Mandarim.
- Inglês.
- 20 dialetos chineses ou variantes regionais.

A lista de dialetos documentada é a seguinte:

| Nº | Dialeto ou variante regional |
|-|-|
| 1 | Cantonês |
| 2 | Nordestino |
| 3 | Henanês |
| 4 | Dialeto de Shaanxi |
| 5 | Chengduês |
| 6 | Chongqingnês |
| 7 | Wuhanês |
| 8 | Guiyangnês |
| 9 | Qingdaonês |
| 10 | Jinanês |
| 11 | Changshanês |
| 12 | Hefeinês |
| 13 | Dialeto de Hebei |
| 14 | Kunmingnês |
| 15 | Lanzhounês |
| 16 | Yinchuanês |
| 17 | Nanchangnês |
| 18 | Pequinês |
| 19 | Sichuanês |
| 20 | Tianjinês |

Os rótulos de dialeto na documentação comercial de ASR são categorias amplas de produto.

A fala real dentro de cada categoria varia conforme cidade, idade, contexto social, alternância de código, vocabulário e falante.

Afirmar suporte a um dialeto não deve ser interpretado como precisão idêntica para todos os falantes daquela região.

## Disponibilidade atual da prévia

A Tencent Cloud adicionou o mecanismo de prévia Hy ASR 3.0 ao produto WebSocket em tempo real em **4 de agosto de 2026**.

Este serviço público é atualmente descrito como versão de teste interno ou prévia.

| Item | Status documentado atual |
|-|-|
| Tipo de produto | Reconhecimento de fala em tempo real |
| Método de integração | API WebSocket da Tencent Cloud |
| Nome do mecanismo | `Hy-ASR-3.0-preview` |
| Duração do áudio | Máximo de 60 segundos por entrada |
| Formato de áudio | PCM mono de 16 kHz |
| Concorrência incluída | 20 conexões simultâneas |
| Mandarim | Suportado |
| Inglês | Suportado |
| 20 dialetos | Suportados |
| Separação de falantes | Não suportado na prévia |
| Suporte a parâmetros VAD | Listado como não suportado na prévia |
| Substituição de palavras | Não suportado na prévia |

Parâmetro de limite de ruído | Não suportado na prévia |
| Entrada de contexto externo | Em breve |
| Aprimoramento de palavra de ativação | Em breve |

A referência geral da API WebSocket inclui parâmetros usados por outros mecanismos, incluindo VAD e ID de palavra de ativação.

O Hy ASR 3.0 segue as notas específicas da prévia do mecanismo.

A presença de um parâmetro no modo de API compartilhada não garante que o mecanismo de prévia já implemente esse parâmetro.

## Fluxo básico de integração com a Tencent Cloud

A configuração oficial é dividida em três etapas principais.

## Etapa 1: Ativar o serviço de reconhecimento de fala da Tencent Cloud

Abra o serviço de reconhecimento de fala da Tencent Cloud e conclua o processo de ativação da conta.

A documentação oficial de início rápido está em:

```Plaintext
https://cloud.tencent.com/document/product/1093/54362
Antes de habilitar a cobrança pós-paga, consulte as instruções de faturamento.
A Tencent Cloud informa que novas contas têm a cobrança pós-paga desativada por padrão, sendo necessário ativá-la manualmente.
Crie ou obtenha:
AppIDSecretIDSecretKeyEssas credenciais são usadas para assinar as solicitações de conexão WebSocket.
Armazene-as em um gerenciador de segredos ou em variáveis de ambiente protegidas.
Não coloque credenciais de longa duração em:
Para produtos em navegador ou mobile, crie as informações de conexão assinadas em um back-end confiável.
O formato do endpoint documentado pela Tencent Cloud é:
wss://asr.cloud.tencent.com/asr/v2/?{request_parameters}
Substitua `` pelo seu AppID da Tencent Cloud.
A solicitação inclui parâmetros de assinatura, como:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
secretidtimestampexpirednoncevoice_idengine_model_typePara a prévia do Hy ASR 3.0, defina:
engine_model_type=Hy-ASR-3.0-preview
Cada conexão WebSocket requer um voice_id exclusivo.
Se a conexão for encerrada ou falhar, o voice_id antigo se torna inválido e um novo deve ser gerado.
A prévia atual exige:
Taxa de amostragem: 16 kHz
Canais: mono
Formato: PCM
Duração máxima de entrada: 60 segundos
Teste todo o fluxo de áudio, não apenas o arquivo bruto.
SDKs de microfone, APIs de mídia do navegador, sistemas telefônicos e plataformas de reunião podem reamostrar ou comprimir o áudio antes de ele chegar ao servidor.
O serviço suporta transcrição em tempo real, retornando texto enquanto o áudio é enviado.
O aplicativo deve tratar:
Não presuma que cada resultado parcial de reconhecimento seja definitivo.
A interface de ASR em tempo real pode revisar palavras anteriores à medida que mais contexto é obtido.
A interface do usuário deve distinguir entre texto provisório e texto confirmado.
Construa um conjunto de avaliação representativo, incluindo:
Ruído.
Meça tanto a qualidade do reconhecimento quanto o comportamento do sistema.
A Tencent Cloud classifica o Hy ASR 3.0 prévia como mecanismo de reconhecimento de fala em tempo real Grand Model 2.0.
A página de cobrança atual lista:
| Opção de cobrança | Preço atual |
|---|---|
| Pacote pré-pago de 60 horas | Total de 60 yuan, ou seja, 1,00 yuan/hora |
| Pacote pré-pago de 1.000 horas | Total de 950 yuan, ou seja, 0,95 yuan/hora |
| Pacote pré-pago de 10.000 horas | Total de 9.000 yuan, ou seja, 0,90 yuan/hora |
| Pacote pré-pago de 100.000 horas | Total de 88.000 yuan, ou seja, 0,88 yuan/hora |
| Pacote pré-pago de 300.000 horas | Total de 255.000 yuan, ou seja, 0,85 yuan/hora |
| Pós-pago | 1,00 yuan/hora, cobrado diariamente |
A tabela de preços atual da Tencent mostra que o reconhecimento Grand Model 2.0 não possui franquia gratuita de áudio.
Os 20 canais simultâneos incluídos são uma cota de concorrência, não um tempo gratuito de reconhecimento.
Os preços podem mudar. Antes de emitir cotações comerciais ou estimar orçamentos de longo prazo, consulte a página de cobrança em tempo real.
Com base no preço atual pós-pago de 1,00 yuan/hora:
100 horas de reconhecimento bem-sucedido
× 1,00 yuan/hora
= 100 yuan
O orçamento de produção também deve incluir:
A taxa de ASR é apenas uma parte do sistema completo de transcrição.
A Tencent afirma que o Yuanbao participou do desenvolvimento deste modelo e foi o primeiro produto da Tencent a integrá-lo.
Os usuários podem experimentar o recurso por meio da entrada de voz no Yuanbao, e o modelo foi projetado para melhorar:
A Tencent informa que outros produtos, como o WorkBuddy, estão sendo gradualmente integrados.
A integração em produtos de consumo pode diferir da API pública da prévia da Tencent Cloud.
Por exemplo, o Yuanbao pode usar serviços internos, contexto específico do produto ou configurações de implantação ainda não abertas a desenvolvedores externos.
Não se deve presumir que a experiência no Yuanbao corresponda um a um aos parâmetros da API pública.
O Hy ASR 3.0 prévia é voltado para interações de voz curtas e de baixa latência.
Usos potenciais incluem:
A prévia atualmente não possui separação de falantes, o que pode limitar a transcrição de chamadas multipartitas, a menos que outros componentes façam a separação por canal ou falante.
O mecanismo pode suportar legendas curtas em tempo real para:
Os aplicativos devem testar a estabilidade dos resultados parciais e o comportamento de pontuação.
O reconhecimento sensível ao contexto pode melhorar buscas envolvendo:
Até que a injeção de palavras personalizadas seja liberada na prévia, termos raros
e de domínio específico podem ainda exigir pós-processamento ou uma camada separada de correção de erros.
O mecanismo pode converter instruções faladas em texto para:
Controle de dispositivos inteligentes.
O sistema de comandos nunca deve executar ações de alto impacto apenas porque um resultado de transcrição parece ter alta confiança.
Para operações destrutivas ou financeiras, deve-se confirmar a intenção interpretada e exigir aprovação explícita do usuário.
Segmentos de áudio curtos podem ser transcritos antes de serem enviados aos seguintes fluxos:
A qualidade de cada etapa do processamento de IA downstream depende do resultado da transcrição.
Quando as políticas permitirem, armazene o áudio original ou as evidências de confiança para que saídas incertas possam ser revisadas.
Este produto ainda está marcado como versão de pré-visualização ou teste interno.
A interface, os preços, as limitações e os recursos suportados podem mudar.
A API pública atual não pode substituir diretamente a transcrição em lote de gravações longas.
Áudio longo precisa ser processado em segmentos, e pode exigir uma camada de contexto no nível do aplicativo.
A versão de pré-visualização atualmente exige PCM mono de 16 kHz.
Muitos ambientes de produção usam MP3, AAC, Opus ou codecs de telefonia, sendo necessária a conversão.
A documentação exclusiva do motor atual afirma que não há suporte para separação de falantes.
A transcrição com múltiplos falantes pode exigir canais de áudio separados ou outros serviços de separação de falantes.
De acordo com a documentação oficial, as capacidades anunciadas ainda não foram disponibilizadas como recursos públicos da API de pré-visualização.
Os gráficos de referência vêm da Tencent.
Uma avaliação independente sob condições equivalentes aumentaria a credibilidade da comparação.
A Tencent forneceu uma descrição de alto nível da arquitetura e do processo de treinamento do Hy ASR 3.0 pré-visualização, mas ainda não publicou detalhes completos e reproduzíveis.
O decodificador sensível à linguagem pode favorecer frases comuns e ignorar conteúdos incomuns, mas realmente falados.
Os testes devem incluir frases raras e inesperadas.
Inclua pelo menos centenas de falas representativas, em vez de algumas amostras limpas de demonstração.
Crie transcrições de referência verificadas manualmente usando uma estratégia de normalização clara.
Decida como lidar com:
Use:
Não combine todos os falantes de dialetos em uma única média.
Relate os resultados separadamente por região e condições de gravação.
Crie pares de amostras com conteúdo acústico semelhante, mas onde o contexto da frase altera o resultado correto da transcrição.
Avalie nomes de produtos e
termos técnicos primeiro, e repita o teste depois que a Tencent abrir o suporte a palavras-chave.
Use gravações reais de ambiente, e não apenas ruído sobreposto digitalmente.
Confirme se a implementação de segmentação de 60 segundos não corta frases importantes nem gera texto duplicado.
Inclua as seguintes etapas:
Captura
+ Upload
+ Reconhecimento
+ Finalização do resultado
+ Processamento downstream
Gravações de voz podem conter informações pessoais ou sensíveis.
Antes da implantação, políticas de retenção de dados, acesso, criptografia, consentimento do usuário e exclusão devem ser definidas.
| Área | Pipeline tradicional | Direção do Hy ASR 3.0 |
|---|---|---|
| Foco principal | Precisão de áudio para texto | Reconhecimento acústico mais modelagem de linguagem contextual |
| Homófonos fáceis de confundir | Geralmente depende de probabilidades locais | Usa contexto de frase mais amplo |
| Dialetos | Modelos independentes ou cobertura limitada | Um único motor híbrido documentado, com suporte a 20 dialetos |
| Vocabulário especializado | Palavras-chave externas ou modelos personalizados | Capacidade de palavras-chave anunciada; suporte na pré-visualização a ser liberado |
| Fala complexa | Modelo acústico mais pós-processamento | Treinamento conjunto de fala e linguagem mais pós-treinamento |
| Saída | Texto transcrito | Texto transcrito com contexto mais coeso |
| Principal risco | Substituições acústicas e omissão de caracteres | Erros acústicos mais possível correção semântica excessiva |
A nova abordagem não elimina as necessidades da engenharia ASR tradicional.
Ela adiciona uma camada de linguagem mais forte sobre o mesmo sistema de ponta a ponta.
O Hy ASR 3.0 pré-visualização é um modelo de reconhecimento de fala em tempo real lançado pela Tencent Hunyuan, baseado na base de linguagem Hy3 e em um codificador de fala proprietário. Seu objetivo de design é combinar reconhecimento acústico com compreensão contextual da linguagem.
A documentação do Tencent Cloud mostra suporte a mandarim padrão, inglês e 20 dialetos chineses ou variantes regionais, incluindo cantonês, dialeto do nordeste (dongbeihua), dialeto de Henan, dialeto de Shaanxi, dialeto de Chengdu, dialeto de Chongqing, dialeto de Wuhan, entre outros. A precisão pode variar entre falantes e regiões diferentes.
A Tencent divulgou resultados agregados de WER em benchmarks públicos: mandarim 3,34%, inglês 2,62% e cantonês 3,12%. Esses são resultados relatados pela empresa, agregados a partir de vários conjuntos de dados, e não são resultados de um teste unificado reproduzido de forma independente.
A pré-visualização pública atual aceita no máximo 60 segundos de áudio por entrada. Gravações mais longas exigem processamento segmentado, e o aplicativo deve preservar contexto efetivo entre os segmentos.
De acordo com a documentação de pré-visualização do Tencent Cloud de 4 de agosto de 2026, ainda não há suporte. Essas capacidades são descritas nos materiais de lançamento, mas as páginas oficiais da API mostram que a entrada de contexto e o aprimoramento por palavras-chave serão abertos futuramente.
A documentação atual do Hy ASR 3.0 pré-visualização especifica suporte a entrada PCM mono de 16 kHz. Aplicativos que usam MP3, AAC, Opus ou outros formatos devem converter o áudio antes de chamar
este mecanismo.
Os desenvolvedores usam a API WebSocket de reconhecimento de fala em tempo real do Tencent Cloud e definem engine_model_type como Hy-ASR-3.0-preview. A conexão deve ser assinada usando as credenciais do Tencent Cloud.
A página de precificação atual do Tencent Cloud não lista uma cota gratuita de áudio para o reconhecimento do modelo grande 2.0. A página mostra pacotes pré-pagos a partir de 60 horas com preço de 1 RMB por hora, e pós-pago a 1 RMB por hora, com 20 canais concorrentes incluídos.
com/document/product/1093/135476): status oficial atual, dialetos suportados, limitações e configuração básica.
A pré-visualização do Hy ASR 3.0 da Tencent Hunyuan combina o codificador de fala com as capacidades do modelo de linguagem Hy3 para melhorar a transcrição em mandarim, inglês, dialetos, linguagem mista, ambientes ruidosos e contextos dependentes.
A Tencent relatou uma WER de 3,34% para mandarim, 2,62% para inglês e 3,12% para cantonês em conjuntos de dados públicos agregados, além de obter resultados líderes em seus testes de cenário interno. Esses números são promissores, mas ainda precisam ser validados no áudio de cada organização.
A pré-visualização atual da Tencent Cloud tem um escopo mais limitado do que a visão completa do lançamento.
Ela suporta reconhecimento em tempo real via WebSocket, PCM mono de 16 kHz e entrada de áudio de até 60 segundos. Injeção de contexto externo, aprimoramento por palavras-chave, diarização de falantes e vários outros recursos ainda não estão disponíveis neste mecanismo.
A mudança fundamental não é que o reconhecimento de fala deixou de ouvir a voz, mas sim que o modelo de linguagem agora auxilia a determinar o que a voz mais provavelmente significa.
Comece com uma frase e tenha um site completo em minutos.



