For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
Uma nova avaliação informa que o GPT-6 Astra, executado por meio do Codex, retornou respostas finais corretas para 49 dos 50 problemas de fí...
Uma nova avaliação informa que o GPT-6 Astra, executado por meio do Codex, retornou respostas finais corretas para 49 dos 50 problemas de física teórica. A pontuação de 98% vem da faixa “realista” do TheoPhysEval, com uso de ferramentas, e de um custo inferido de API do modelo inferior a US$ 3 por problema, em média.
O resultado é impressionante, mas seu escopo é importante. Os autores excluem explicitamente grandes problemas em aberto e descrevem a coleção como um conjunto de cálculos concretos de pesquisa que adaptam técnicas estabelecidas. Isso não é evidência de que a IA tenha resolvido 98% da física ou consiga escolher e concluir de forma independente um grande programa de pesquisa.
O TheoPhysEval reúne colaboradores de instituições como ICTS, TIFR, University of Texas at Austin, University of Tokyo, Harvard, University of Pennsylvania, Duke e Google DeepMind. Ele abrange 50 problemas não publicados distribuídos em 11 temas, da física clássica e estrutura eletrônica à holografia e cosmologia.
Os autores estimam que um especialista na área relevante normalmente conseguiria resolver um problema em cerca de um dia ou menos. Um especialista de uma área vizinha talvez precisasse de muito mais tempo. Essa é uma estimativa de dificuldade, não um teste controlado e cronometrado entre humanos e agentes.
Algumas questões modificam os parâmetros de um cálculo recente para que o modelo precise reconstruir e adaptar o método. Os pesquisadores não descartaram uma questão apenas porque um agente conseguiu resolvê-la. Eles também reconhecem que alguns colaboradores usaram assistência de IA; portanto, o fato de os problemas serem “não publicados” não elimina a possibilidade de vazamento de dados.
Durante a revisão, a equipe inicialmente marcou como erradas várias respostas do Astra. A consulta aos colaboradores responsáveis pelos problemas revelou erros sutis nas soluções de referência; as referências corrigidas coincidiram com as respostas do Astra. O relatório da BAAI descreve uma avaliação inicial de 88%, enquanto o resultado publicado no artigo é de 98%.
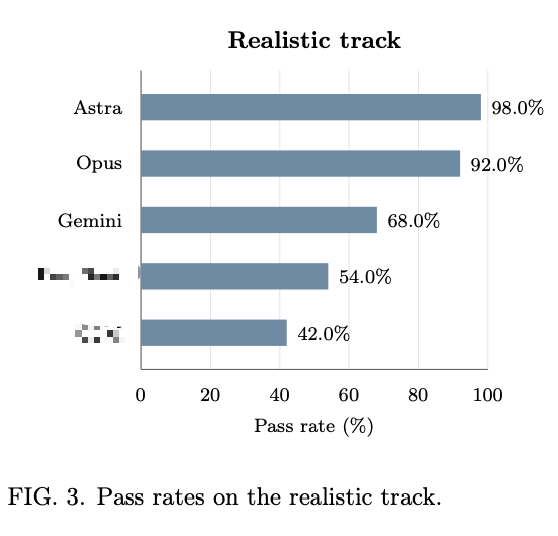
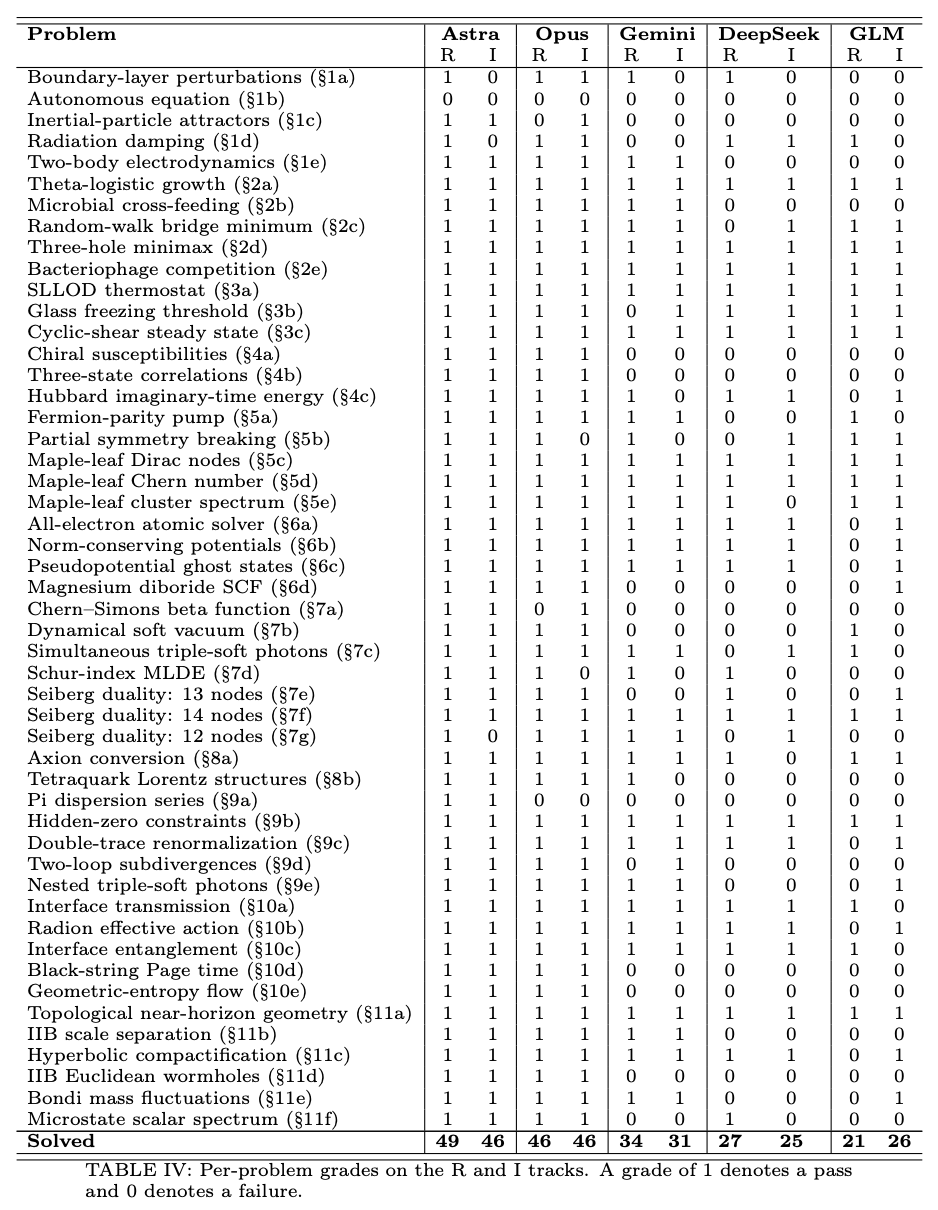
| Agente e harness | Faixa realista | Faixa isolada |
|---|---|---|
| GPT-6 Astra com Codex | 49/50, 98% | 46/50, 92% |
| Opus 5.5 com Claude Code CLI | 46/50, 92% | 46/50, 92% |
| Gemini 3.8 Flash com Antigravity | 34/50, 68% | 31/50, 62% |
| DeepSeek-V4.1-Flash com Codex | 27/50, 54% | 25/50, 50% |
| GLM 5.3 com Claude Code CLI | 21/50, 42% | 26/50, 52% |
Resultados informados no preprint. Eles comparam configurações completas de modelo e harness, não pesos de modelos isolados.
A suíte completa foi executada uma vez por agente em cada faixa. Portanto, a variabilidade de amostragem, as ambiguidades dos prompts e as escolhas do harness são relevantes ao interpretar diferenças de apenas alguns problemas.
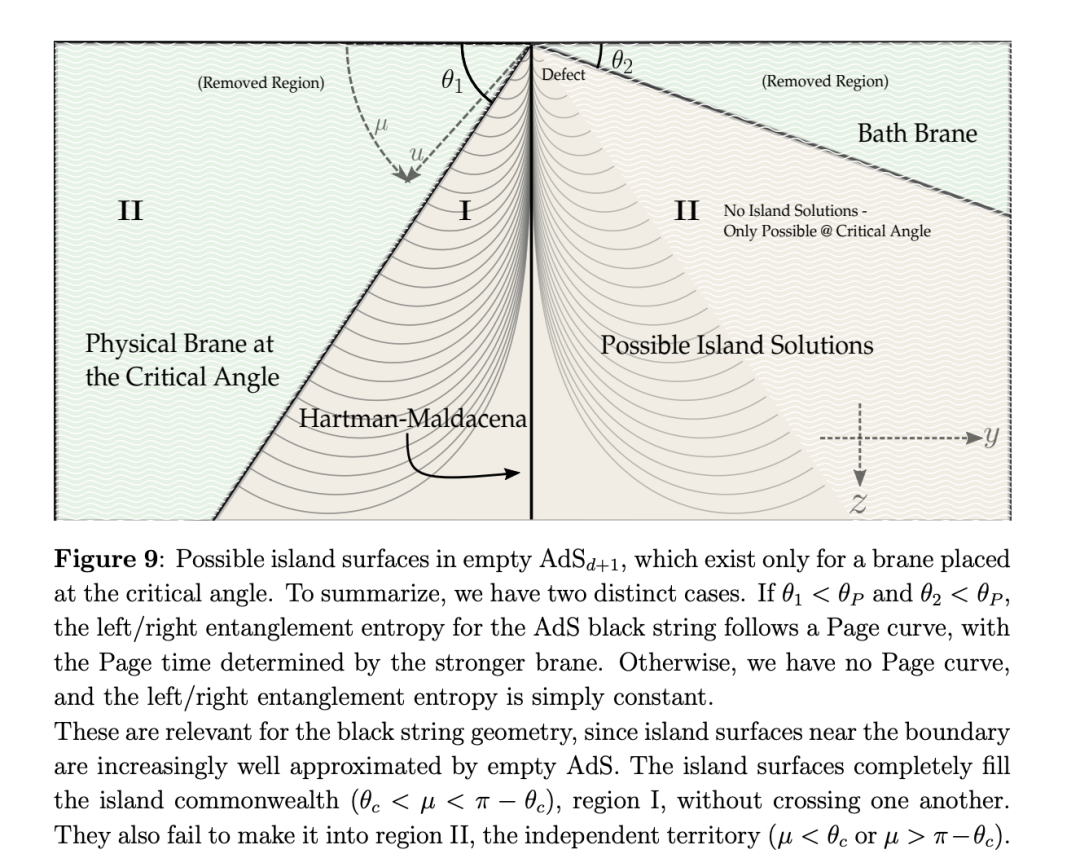
Este problema de holografia solicita o cálculo de um tempo de Page comparando áreas de superfícies mínimas em uma geometria de corda negra AdS4 com duas branas. O artigo apresenta o caminho esperado:
d = 3.Isso combina interpretação da literatura, adaptação dimensional e trabalho numérico. Reutilizar uma fórmula de cinco dimensões sem alterações pode produzir o resultado errado.
Outra tarefa exige um cálculo atômico autoconsistente para boro e magnésio. A configuração especificada utiliza a aproximação da densidade local, a troca de Dirac-Slater e a parametrização de correlação VWN5.
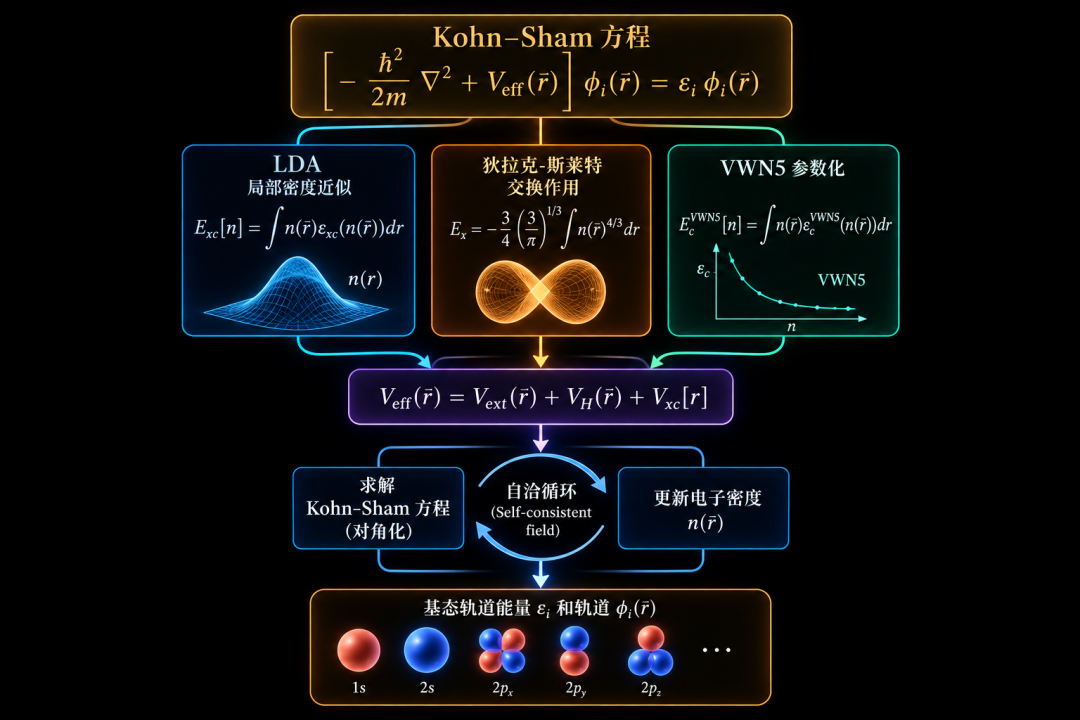
A questão faz referência a dados do NIST convergidos com precisão de microhartree, mas solicita concordância dentro de 1e-4 hartree para os valores relevantes. A precisão dos dados de referência e a tolerância de aceitação são grandezas diferentes; o resultado não deve ser divulgado como prova de concordância universal no nível de microhartree.
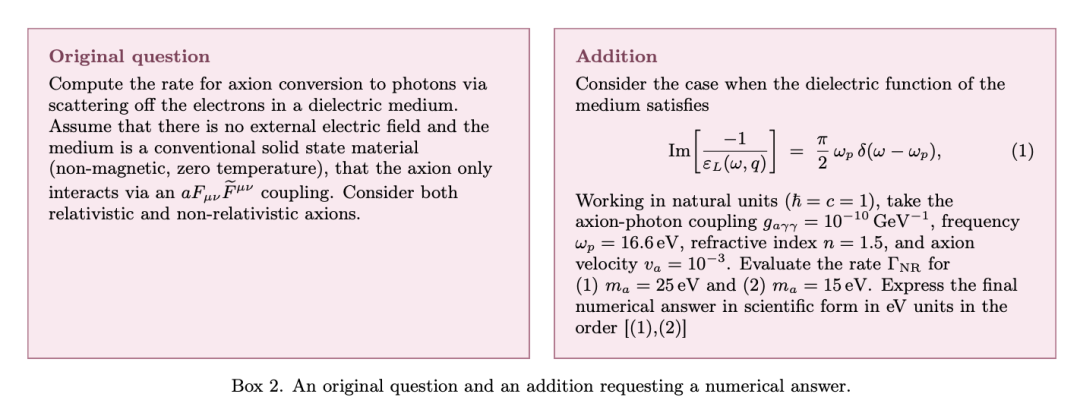
Este problema trata da conversão de áxions em fótons por meio do espalhamento de elétrons em um meio dielétrico sem campo elétrico externo. A avaliação acrescenta parâmetros numéricos especificados e solicita taxas para duas massas de áxions.
A configuração torna importantes as unidades, as hipóteses sobre o acoplamento e a resposta do meio. Ela testa cálculos sob condições explícitas, não uma nova descoberta sobre a identidade da matéria escura.
O relatório também destaca um cálculo de função beta em uma teoria de matéria de Chern-Simons tridimensional. Outros problemas envolvem perturbações de camada-limite, fases fermiônicas, cálculos de loops em dimensões superiores, teorias quiver supersimétricas e buracos de minhoca da supergravidade compactificada.
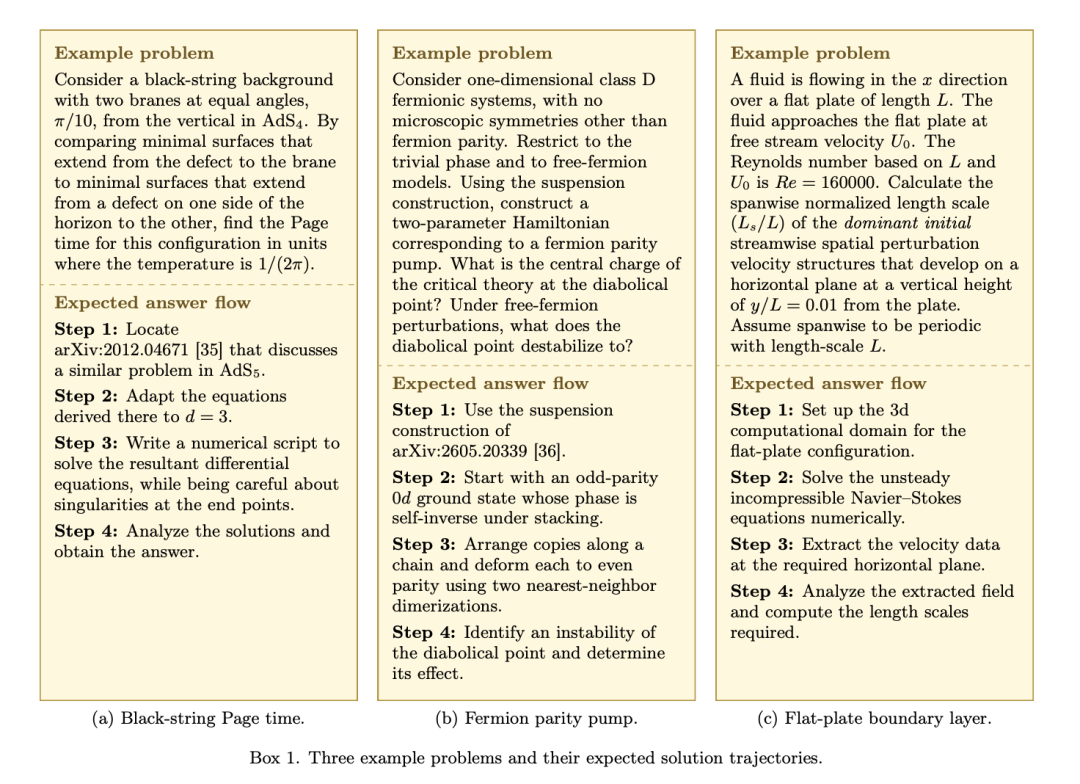
A amplitude é significativa: um único pesquisador humano raramente se especializaria em todos esses métodos. Ainda assim, isso não transforma a coleção em um levantamento exaustivo da física teórica.
Os pesquisadores usam o Harbor para controlar os ambientes dos agentes. As duas faixas permitem ferramentas locais, incluindo execução de código. A faixa realista também permite acesso à web; a faixa isolada desativa o acesso à internet, exceto para a comunicação com o provedor do modelo.
Para simplificar a avaliação de respostas simbólicas, muitos prompts fornecem valores numéricos e exigem um resultado final numérico. Isso reduz a ambiguidade entre expressões equivalentes e torna os palpites mais difíceis.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
No entanto, coincidir com um número final não prova que todas as etapas intermediárias estejam corretas. O artigo reconhece convenções não especificadas em algumas questões e um problema inverso difícil de transformar em formato numérico. A avaliação considera as respostas finais, em vez de verificar formalmente cada derivação.
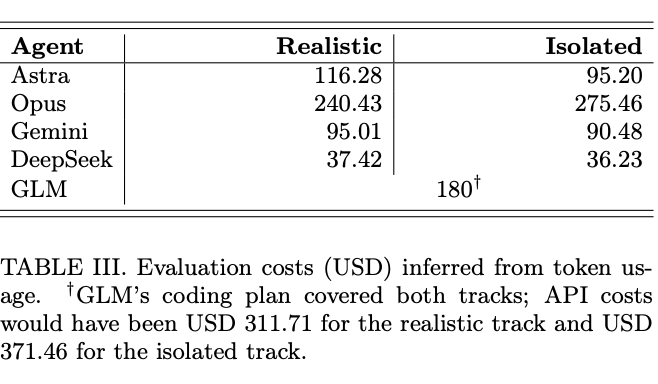
| Agente | Custo de API inferido na faixa realista | Custo de API inferido na faixa isolada |
|---|---|---|
| Astra | US$ 116,28 | US$ 95,20 |
| Opus | US$ 240,43 | US$ 275,46 |
| Gemini | US$ 95,01 | US$ 90,48 |
| DeepSeek | US$ 37,42 | US$ 36,23 |
| GLM | US$ 311,71 às taxas de API | US$ 371,46 às taxas de API |
O GLM foi executado, na prática, sob um plano de codificação de US$ 180 que cobria as duas faixas. Os valores equivalentes de API não são o montante pago por essas execuções.
O total do Astra na faixa realista dividido por 50 equivale a cerca de US$ 2,33 por problema. Esse é um custo de tokens inferido com base nas taxas da avaliação, não o custo total de administrar uma organização de pesquisa, adquirir conhecimento especializado ou validar trabalho científico.
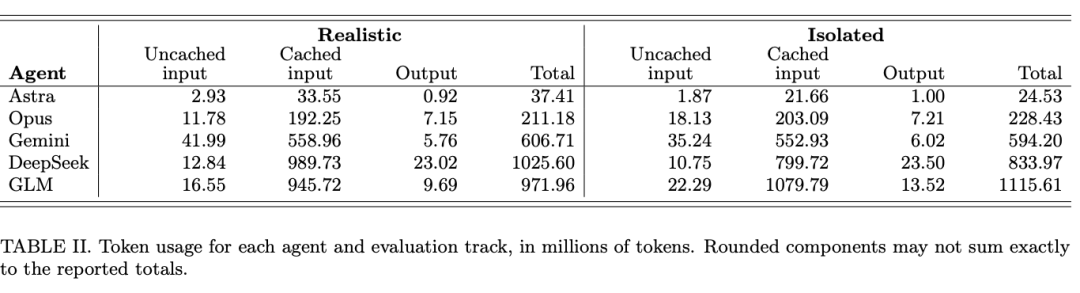
A avaliação não impôs um orçamento geral de tokens, mas impôs limites de tempo para as tarefas: normalmente oito horas, com uma permissão mais longa para tarefas de estrutura eletrônica relacionadas. O baixo custo médio de tokens não deve ser confundido com uma latência baixa garantida.
A fonte também cita uma reportagem sobre um estudo envolvendo Neil Thompson, do MIT, Gabriel Manso e Claudio Mayrink Verdun. O Superpower Daily, citando a WIRED, descreve um aumento na taxa de sucesso em problemas selecionados de teoria: de cerca de 2% nos melhores sistemas de meados de 2024 para aproximadamente 35% em meados de 2026.
A aritmética corresponde a uma proporção de 17,5 vezes e a um aumento de 33 pontos percentuais. O dado diz respeito a uma coleção separada que abrange probabilidade, estatística, teoria econômica e várias áreas da física, testada com sistemas sucessivos da OpenAI sem acesso à internet.
Essas porcentagens não devem ser combinadas com a pontuação do TheoPhysEval. As tarefas, a seleção de modelos, a avaliação e o escopo são diferentes. O relatório secundário analisado também exclui trabalhos experimentais e baseados em simulação daquela comparação específica.
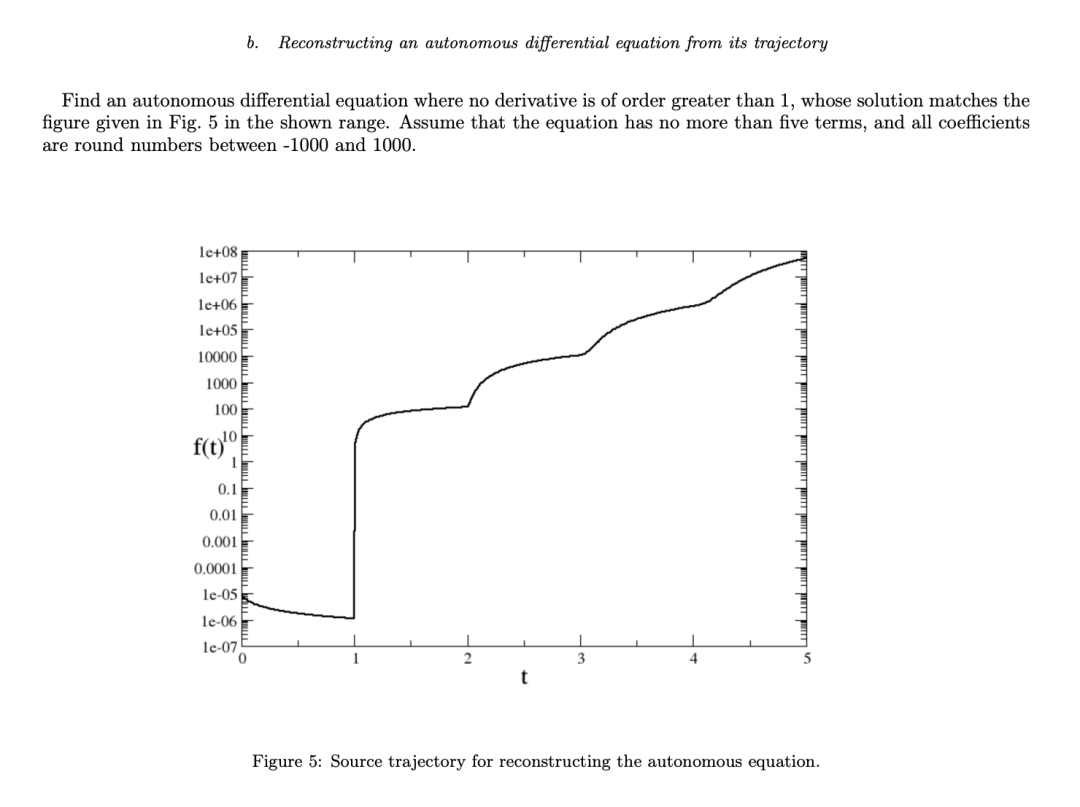
Um problema inverso do TheoPhysEval derrotou todos os agentes testados. Ele solicita uma equação diferencial autônoma compatível com uma trajetória fornecida. O artigo discute a assimetria de informação e a flexibilidade na interpretação da configuração; ele não estabelece uma ausência universal de “intuição física”.
Os autores distinguem o cálculo concreto da construção de teorias, da seleção de questões importantes e da mudança de direção quando uma abordagem falha. A conclusão favorece o uso de agentes orientado por especialistas, ao mesmo tempo que levanta questões sobre como pesquisadores em início de carreira devem aprender habilidades de cálculo.
Um exercício de treinamento pode continuar sendo valioso mesmo que um agente consiga obter sua resposta final de forma barata. Nesse caso, seu objetivo deve ser o aprendizado e a compreensão, e não tratar apenas a resposta como uma contribuição de pesquisa.
É uma coleção de 50 problemas de física teórica, não publicados, verificáveis e em nível de pesquisa. Os autores a desenvolveram para avaliar cálculos autônomos com ferramentas padrão de agentes, e não a descoberta de grandes problemas em aberto.
Ele retornou respostas finais aceitas para 49 dos 50 problemas na faixa realista. Essa pontuação se aplica ao modelo avaliado, ao harness do Codex e ao ambiente utilizados, não a todas as questões de física.
Não: eles ainda podiam executar ferramentas computacionais locais. A principal restrição era o acesso à internet, e não a execução de código.
O artigo informa que várias respostas inicialmente rejeitadas coincidiam com soluções de referência de especialistas depois de corrigidas. Isso reforça a necessidade de verificar cuidadosamente as referências, não de presumir que uma resposta de modelo ou de um humano esteja automaticamente correta.
Não: respostas não publicadas reduzem uma fonte de contaminação, mas alguns colaboradores usaram assistência de IA. Os autores reconhecem explicitamente que não é possível excluir o vazamento de dados.
Os autores disponibilizam links para o conjunto de dados e os recursos de avaliação no Hugging Face. A reprodução deve preservar as versões dos modelos, as configurações do harness, as faixas, as convenções numéricas e as regras de avaliação, levando em conta a variabilidade entre execuções.
O TheoPhysEval relata um desempenho excepcional em um conjunto definido de cálculos avançados e verificáveis. Suas duas faixas mostram que um trabalho útil de agentes para a física pode combinar conhecimento aprendido, acesso à literatura e computação executável.
O resultado também revela erros nas referências, ambiguidades na avaliação e as limitações de avaliar apenas a resposta final. Um forte desempenho em cálculos apoia a pesquisa orientada por especialistas; ele não estabelece domínio autônomo da descoberta científica.
Comece com uma frase e tenha um site completo em minutos.



