For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
Uma nova empresa de IA captou **US$ 870 milhões** poucas semanas depois de lançar um modelo que não tenta escrever ensaios, código ou respos...
Uma nova empresa de IA captou US$ 870 milhões poucas semanas depois de lançar um modelo que não tenta escrever ensaios, código ou respostas de conversa amigáveis.
A empresa é a TypeSafe AI.
Seu modelo se chama Jev.
A TypeSafe anunciou a Série A em 9 de outubro de 2026, com uma avaliação de US$ 7,5 bilhões. A Andreessen Horowitz liderou a rodada, com participação da Sequoia Capital, do investidor existente DCVC e de outros investidores.
A equipe fundadora da empresa também chamou atenção.
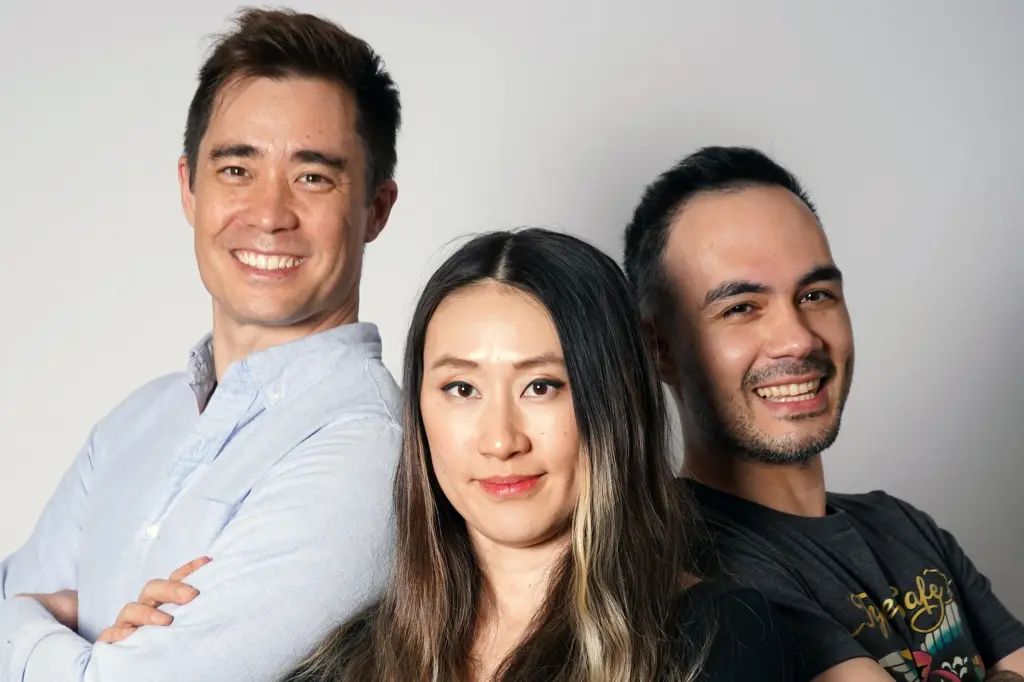
A TypeSafe foi fundada por Erik Gafni, Sasha Sheng e Diogo Almeida. Almeida trabalhou anteriormente na OpenAI e ajudou a desenvolver pesquisas por trás dos sistemas de seguimento de instruções da era do ChatGPT. Sheng trabalhou anteriormente na Meta/FAIR, enquanto Gafni tem experiência em engenharia e startups.
O Jev foi lançado publicamente em 15 de setembro.
Apenas duas semanas depois, a OpenAI anunciou uma prévia limitada de uma direção de produto surpreendentemente semelhante: uma API rápida para retornar probabilidades, escolhas e pontuações, em vez de longos textos gerados. A OpenAI levou esse produto, a Decisions API, para a versão beta pública em 6 de outubro.
Mais tarde, Nikunj Handa, líder de produto de APIs da OpenAI, reconheceu publicamente que o Jev inspirou a categoria de produto.
Isso torna o Jev interessante por dois motivos.
Primeiro, ele propõe uma maneira diferente de usar IA dentro de softwares.
Segundo, ele obrigou um laboratório de fronteira a responder de maneira excepcionalmente rápida.
O Jev não tenta ser a IA com a qual você conversa.
Ele tenta ser a IA que seu software chama milhares ou milhões de vezes sem que você jamais veja a resposta.
Abra uma caixa de entrada de e-mail e haverá centenas de pequenos julgamentos esperando para ser feitos.
Esta mensagem é importante?
Ela contém uma fatura que está prestes a vencer?
É necessário responder com urgência?
O horário da reunião mudou?
A mensagem deve ser arquivada, encaminhada para análise ou ignorada?
Um modelo de linguagem de uso geral já consegue responder a perguntas como essas.
O problema é que um LLM convencional costuma ser projetado para gerar linguagem.
Para um único e-mail, essa sobrecarga pode não importar.
Em escala, importa.
Se uma aplicação toma o mesmo tipo de decisão milhares ou milhões de vezes por dia, pequenas diferenças de latência e custo se transformam em grandes despesas operacionais.
O Jev foi projetado especificamente para esses julgamentos repetidos.
A TypeSafe descreve o Jev como um System One Model.
A referência é ao estilo de cognição rápido e intuitivo do “Sistema 1”, popularizado por Daniel Kahneman.
Em vez de pedir ao Jev que gere um parágrafo, uma aplicação fornece algum estado e um conjunto de perguntas predefinidas.
O Jev retorna valores tipados, como:
A aplicação pode usar o resultado diretamente.
Um padrão simplificado é parecido com este:
E-mail recebido
      ↓
Jev avalia várias perguntas
      ↓
urgent_reply = 0.91
billing_related = 0.74
meeting_change = 0.03
      ↓
A aplicação aplica suas próprias regras
      ↓
Alerta / arquivar / encaminhar / revisar
A diferença importante está na interface.
Com um modelo de linguagem de uso geral, os desenvolvedores frequentemente pedem JSON ou outro formato estruturado e depois validam a resposta gerada.
Com o Jev, as saídas de decisão tipadas são o núcleo do design do produto.
A API da TypeSafe expõe um endpoint systemone e permite que os desenvolvedores enviem várias perguntas sobre o mesmo estado compartilhado.
A TypeSafe enfatiza a tomada de decisões em paralelo.
Se uma aplicação quiser avaliar a mesma entrada com base em vários critérios independentes, essas perguntas podem ser enviadas juntas, em vez de transformar cada uma em uma rodada conversacional separada.
Isso é útil para softwares que precisam responder a perguntas como:
A aplicação então combina essas saídas usando código comum.
Essa é uma das razões pelas quais o Jev parece menos um chatbot e mais uma instrução condicional inteligente.
Atualmente, a TypeSafe lista o Jev por:
| Uso | Preço do Jev |
|---|---|
| Entrada | US$ 0,042 / 1 milhão de tokens |
| Saída | Grátis |
A TypeSafe afirma que a saída é barata demais para ser tarifada porque o Jev não gera longas sequências de texto de forma autorregressiva.
O preço importa porque o Jev tem como alvo decisões que podem ocorrer com frequência extremamente alta.
Uma decisão que seja cara demais para automatizar uma vez por ação do usuário pode se tornar viável quando o custo cai em uma ordem de magnitude.
Isso cria uma pergunta diferente sobre implantação.
Em vez de perguntar:
Isso é importante o suficiente para chamar um modelo de IA?
As equipes de software podem começar a perguntar:
Por que não deixar a IA avaliar também esta pequena etapa?
Esse é o argumento econômico por trás do produto.
O preço destacado por token é apenas uma parte do custo de produção.
As equipes ainda precisam medir:
Uma decisão barata que erre com frequência demais ainda pode ser cara.
Esse ponto se torna importante mais adiante, na avaliação independente do Jev.
A Vercel adicionou o Jev ao AI Gateway quase imediatamente após o lançamento.
A resposta no primeiro dia foi excepcionalmente forte.
Segundo a Vercel, em 24 horas o Jev havia sido usado por quase 13% das equipes pagantes do AI Gateway.
Isso representou mais que o dobro do alcance no primeiro dia de qualquer lançamento de modelo anterior na plataforma.
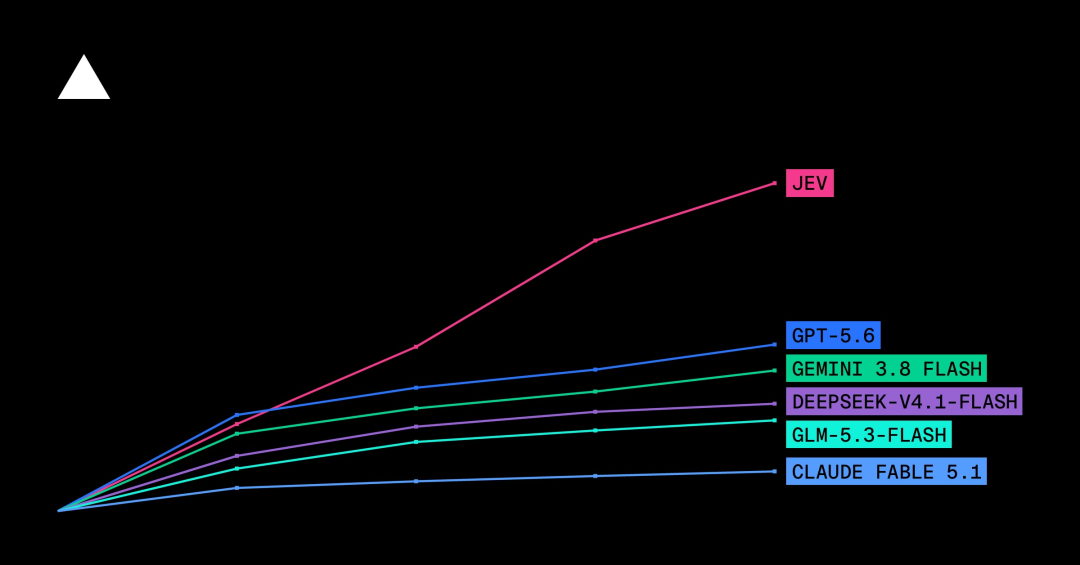
Mais tarde, a Vercel chamou o Jev de modelo adotado mais rapidamente na história do AI Gateway.
Esse pico no primeiro dia não comprova retenção de longo prazo.
Ele mostra que os desenvolvedores reconheceram imediatamente uma classe de tarefas em que um modelo de decisão especializado poderia ser útil.
A Vercel lista exemplos como:
Essas não são tarefas glamourosas.
São exatamente o tipo de tarefa que softwares de produção executam constantemente.
A ideia por trás do Jev não surgiu da noite para o dia.
Diogo Almeida afirmou que, enquanto trabalhava na OpenAI, ficou cada vez mais interessado em uma pergunta básica:
Se a IA transformar a economia, quem fará a maioria das chamadas de modelos no futuro?
Pessoas abrindo manualmente janelas de chat?
Ou softwares chamando inteligência automaticamente em segundo plano?
A resposta dele foi a segunda opção.
Isso muda o que uma interface de IA deve otimizar.
Modelos voltados para pessoas se beneficiam de conversa natural, prosa flexível, explicação e criatividade.
Modelos voltados para softwares se beneficiam de:
Almeida descreveu o Jev como uma resposta à lacuna entre modelos que são impressionantes em conversas e modelos fáceis de usar como primitivas de software confiáveis.
A TypeSafe afirma que passou aproximadamente dois anos desenvolvendo o sistema antes do lançamento público.
O lançamento do Jev não passou despercebido dentro da OpenAI.
Em uma entrevista ao Latent Space gravada durante o OpenAI DevDay, o líder de produto de APIs Nikunj Handa creditou diretamente ao Jev a inspiração para o avanço da Decisions API.
Ele explicou que usuários e equipes internas estavam pedindo um sistema de classificação muito mais rápido.
Ele também confirmou que o projeto não estava no roteiro apenas algumas semanas antes.
A OpenAI não treinou um modelo de base totalmente novo apenas para a primeira versão.
Em vez disso, usou o GPT-6 Luna e construiu uma interface de decisão dedicada e um caminho de inferência próprio em torno dele.
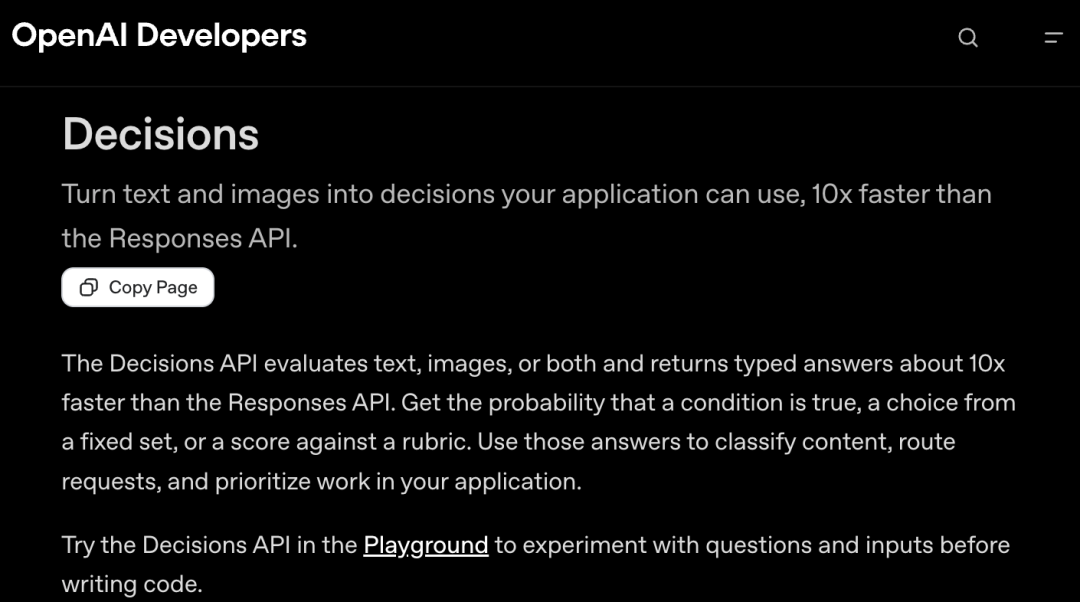
O resultado está agora disponível em beta público por meio de:
POST /v1/decisions
A Decisions API aceita evidências compartilhadas junto com uma ou mais perguntas e retorna respostas tipadas.
Atualmente, a OpenAI oferece suporte a três tipos de pergunta:
| Tipo de pergunta | Resultado |
|---|---|
predicate | Probabilidade de uma condição ser verdadeira |
choice | Uma opção selecionada, além de probabilidades/confiança |
score | Uma pontuação em níveis ordenados |
Isso se sobrepõe fortemente aos casos de uso que o Jev pretende atender.
Essa é a maior diferença arquitetônica entre os produtos públicos atuais.
A TypeSafe afirma que o Jev usa uma arquitetura de modelo especializada e um método de treinamento chamado Reinforcement Learning for Calibrated Decisions (RLCD).
A primeira versão da Decisions API da OpenAI usa, em vez disso, os pesos existentes do GPT-6 Luna, com uma interface dedicada para servir decisões.
Conceitualmente:
TypeSafe:
Modelo de decisão especializado
→ saída probabilística tipada

OpenAI:
GPT-6 Luna
→ caminho especializado da Decisions API
→ saída probabilística tipada
Isso significa que os dois produtos podem parecer semelhantes para os desenvolvedores, embora adotem abordagens diferentes internamente.
Uma diferença prática está na modalidade de entrada.
A Decisions API atual da OpenAI aceita texto, imagens ou ambos.
O lançamento público do Jev pela TypeSafe se concentrou em entradas de texto/estado.
A documentação da OpenAI inclui um exemplo em que a API inspeciona a foto de um produto e estima se há danos visíveis, como uma rachadura, rasgo ou amassado.
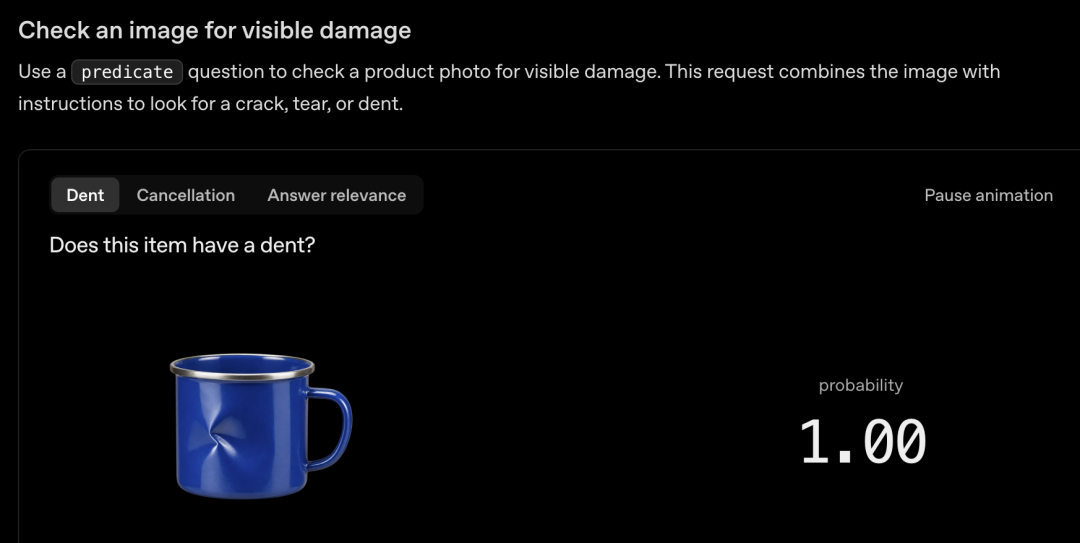
Uma aplicação de comércio eletrônico poderia usar esse padrão para encaminhar automaticamente imagens para revisão.
Por exemplo:
Foto do produto
→ Decisions API verifica danos visíveis
→ probabilidade = alta
→ encaminhar para inspeção manual
Esse é um bom exemplo de como APIs de decisão podem ser incorporadas a softwares comuns sem produzir uma resposta voltada ao usuário.
O usuário talvez nunca saiba qual modelo avaliou a foto.
Ele apenas experimenta o fluxo de trabalho resultante.
Os preços públicos atuais são diretos.
| Produto | Preço de entrada | Preço de saída |
|---|---|---|
| TypeSafe Jev | US$ 0,042 / 1 milhão de tokens | Grátis |
| OpenAI Decisions API com GPT-6 Luna | US$ 0,10 / 1 milhão de tokens | Grátis |
No preço-base por token de entrada, o Jev é mais barato.
A documentação da OpenAI sobre a Decisions API afirma que a API retorna respostas tipadas cerca de 10 vezes mais rápido que a Responses API.
Essa afirmação de 10 vezes é especificamente uma comparação com o próprio caminho Responses API da OpenAI.
Ela não representa uma vantagem de velocidade publicada em um teste direto de 10 vezes sobre o Jev.
Essa distinção é importante.
Da mesma forma, a TypeSafe publica multiplicadores de velocidade e custo muito maiores em suas próprias avaliações de fluxo de trabalho, mas reconhece explicitamente que esses testes seguem sua própria metodologia e podem estar na faixa superior dos ganhos no mundo real.
Para escolher uma solução de produção, as equipes devem comparar o desempenho com sua carga de trabalho real.
O que torna essa história de produto incomum é a franqueza com que a OpenAI reconheceu a inspiração.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Na entrevista ao Latent Space, Handa afirmou que o Jev inspirou a categoria e que usuários e equipes internas da OpenAI rapidamente começaram a pedir uma capacidade de classificação rápida semelhante.
Ele descreveu um pequeno grupo interno construindo rapidamente um protótipo e depois otimizando a latência.
Isso não significa que o Jev e a Decisions API sejam idênticos.
Mostra, sim, que a TypeSafe encontrou uma lacuna real de produto.
A competição passou de:
Quem tem o modelo geral mais capaz?
para outra pergunta:
Qual é a primitiva de modelo mais barata e rápida
para uma decisão específica e repetida dentro do software?
Esse é um mercado diferente do benchmarking tradicional de chatbots.
O baixo preço do Jev recebeu uma análise independente útil logo após o lançamento.
Em 29 de setembro, pesquisadores da Universidade de Bonn e do Lamarr Institute enviaram um preprint avaliando o Jev 1.13.0.
O estudo abrangeu:
O custo total da API do Jev foi inferior a US$ 10.
Esse é um número impressionante.
Mas a parte mais importante do artigo é o que ele afirma sobre confiabilidade.
Os pesquisadores descobriram que as probabilidades de escolha do Jev poderiam ser úteis para previsões seletivas.
Em linguagem simples:
Se o sistema responder apenas aos casos em que tem mais confiança, a precisão poderá ser maior.
À medida que a aplicação aceita mais casos de baixa confiança, a precisão cai.
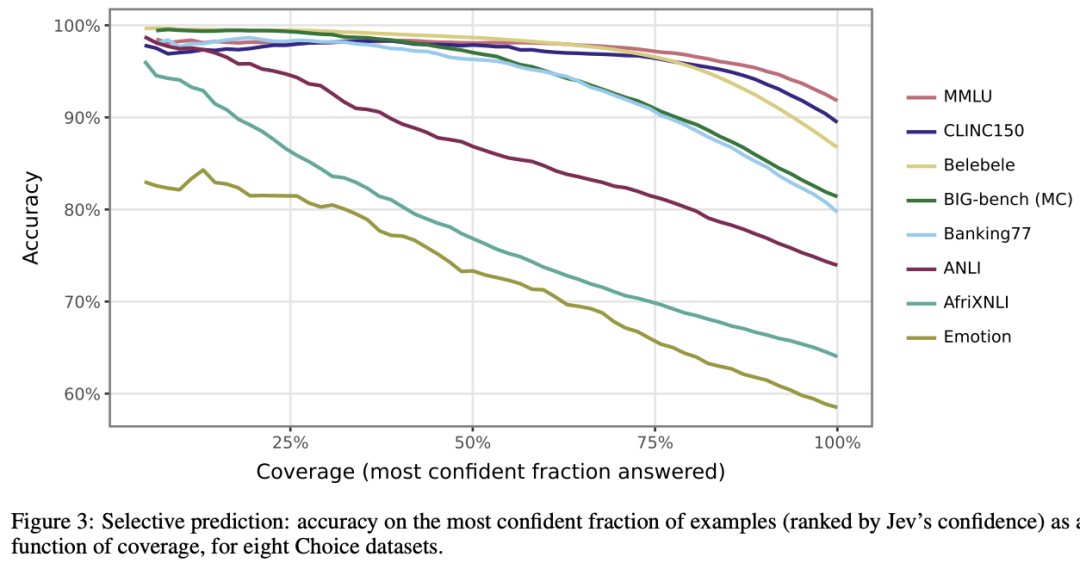
É exatamente por isso que as probabilidades são úteis na automação.
Um fluxo de produção pode definir comportamentos diferentes para diferentes níveis de confiança.
Por exemplo:
confidence >= 0.95
→ automatizar

0.70 <= confidence < 0.95
→ solicitar verificação secundária

confidence < 0.70
→ revisão humana
Os limites exatos devem vir dos dados de avaliação, não da intuição.
O estudo encontrou uma ressalva importante para decisões binárias.
As probabilidades do Jev podiam classificar bem os exemplos e, ainda assim, estar mal posicionadas em torno de um limite fixo de 0,5.
Isso significa que esta regra:
if probability >= 0.5:
    act
não é automaticamente ideal para todas as tarefas.
Em uma avaliação UNFAIR-ToS, os pesquisadores relataram que ajustar os limites com base nos dados de treinamento elevou o micro-F1 de 0,50 para 0,75.
A lição geral é simples:
Uma probabilidade é útil, mas a aplicação ainda precisa decidir qual probabilidade é alta o suficiente para justificar uma ação.
Isso não é exclusivo do Jev.
É um requisito básico para implantar classificadores probabilísticos com responsabilidade.
Voltemos ao exemplo do e-mail.
Suponha que um modelo marque incorretamente um e-mail promocional como importante.
O custo é um pequeno incômodo.
Agora suponha que ele não identifique um e-mail que exige resposta antes do fim do dia.
O custo pode ser muito maior.
O limite correto depende, portanto, da assimetria entre falsos positivos e falsos negativos.
Um sistema prático pode usar regras diferentes para decisões diferentes:
| Decisão | Padrão mais seguro |
|---|---|
| Detecção de e-mails promocionais | Automatizar de forma agressiva |
| Detecção de prazos de cobrança | Usar um limite mais baixo para alertas |
| Classificação jurídica/de conformidade | Encaminhar a incerteza para análise |
| Ação de alto risco em uma conta | Exigir confirmação humana |
| Marcação de conteúdo de baixo valor | Automatizar a maioria dos casos |
Um modelo de decisão forte não elimina a política do produto.
Ele torna a política do produto mais fácil de expressar em software.
A TypeSafe enfatiza que a saída do Jev é type-safe.
Essa é uma propriedade de engenharia real.
Se o desenvolvedor definir um conjunto permitido de saídas, o modelo não precisará inventar uma string arbitrária fora desse esquema.
Mas existem dois tipos diferentes de correção:
A saída corresponde ao tipo permitido.
A resposta selecionada está realmente correta.
Um modelo de decisão pode garantir a primeira com muito mais força que a segunda.
O benchmark independente deixa essa distinção evidente: o Jev ainda pode escolher a resposta errada mesmo quando sua resposta é perfeitamente válida como um valor tipado.
Por isso, a interpretação mais segura para produção é:
O Jev elimina uma grande classe de falhas de formatação e análise, mas não elimina o erro do modelo.
A fonte original destaca corretamente que nem todo julgamento deve ser entregue ao Jev.
O próprio material da TypeSafe reconhece que modelos System One especializados têm uma função mais limitada que os modelos de linguagem gerais.
Uma divisão útil de trabalho é:
Exemplos:
Exemplos:
Exemplos:
Exemplos:
O modelo barato não deve criar uma nova despesa ao produzir decisões que as pessoas precisam corrigir constantemente.
O nome Jev é uma referência ao economista William Stanley Jevons.
Jevons está associado à ideia hoje chamada de paradoxo de Jevons.
A versão simplificada é:
Recurso se torna mais eficiente
→ custo por uso cai
→ demanda aumenta
→ consumo total de recursos pode subir
A TypeSafe aplica essa lógica à inteligência de máquina.
Se cada chamada de IA se tornar muito mais barata, os softwares talvez não gastem simplesmente menos nas mesmas cargas de trabalho.
Os desenvolvedores podem criar cargas de trabalho totalmente novas que antes eram caras demais para justificar.
Isso já é visível em exemplos como:
O resultado pode ser um custo por decisão menor, mas um número total de decisões muito maior.
Essa é a aposta do paradoxo de Jevons por trás do Jev.
A parte mais importante dessa tendência pode ser invisível para os usuários.
Hoje, as pessoas frequentemente interagem explicitamente com a IA:
Abrir o chatbot
→ colar o contexto
→ escrever o prompt
→ ler a resposta
→ copiar o resultado de volta para outra ferramenta
Modelos de decisão nativos de máquina sugerem outro padrão:
Usuário usa o software normalmente
→ IA avalia pequenas decisões em segundo plano
→ software encaminha, pontua, verifica ou filtra automaticamente
→ pessoa vê apenas os casos que importam
Uma caixa de entrada pode mostrar apenas os e-mails urgentes.
Uma ferramenta de escrita pode sinalizar apenas as frases que precisam de revisão.
Um agente pode escolher a próxima ferramenta automaticamente.
Um sistema de suporte pode encaminhar chamados antes que uma pessoa os veja.
Um marketplace pode classificar candidatos imediatamente após o cadastro.
Nesse ponto, o usuário talvez não se importe se o sistema subjacente usou Jev, GPT-6 Luna ou outro modelo de decisão.
O usuário se importa que o software pareça mais rápido e exija menos etapas manuais.
A captação da TypeSafe faz mais sentido sob essa perspectiva.
A empresa não está apostando que as pessoas querem outra aba de chatbot.
Ela aposta que o próprio software fará um número enorme de chamadas de modelos.
A TypeSafe afirma que um terço das empresas da Fortune 500 já usa o Jev, embora esse seja um número de adoção informado pela própria empresa e ela não tenha identificado publicamente todos esses clientes.
A Série A de US$ 870 milhões fornece à TypeSafe um capital significativo para expandir essa estratégia.
O anúncio de investimento afirma que a empresa pretende desenvolver:
A resposta rápida da OpenAI com a Decisions API sugere que os grandes laboratórios enxergam a mesma oportunidade.
A próxima questão competitiva não é simplesmente saber qual sistema é mais barato.
É saber qual deles produz decisões suficientemente confiáveis para que os desenvolvedores se sintam confortáveis permitindo que o software aja sobre elas automaticamente.
O Jev é o primeiro “System One Model” da TypeSafe AI, projetado para decisões rápidas e legíveis por máquina, em vez de geração de texto livre. Ele recebe um estado compartilhado junto com perguntas tipadas e retorna escolhas, pontuações ou probabilidades que o software pode usar diretamente.
Atualmente, a TypeSafe lista o Jev a US$ 0,042 por milhão de tokens de entrada, com saída gratuita. O custo real da aplicação depende do volume de solicitações, do tamanho das entradas, de novas tentativas, da sobrecarga de avaliação e da quantidade de casos encaminhados para modelos maiores ou para pessoas.
A TypeSafe descreve o Jev como um modelo System One baseado em transformers, e não como um modelo de linguagem grande convencional para geração de texto. Seu comportamento de produto característico é não gerar prosa arbitrária; ele retorna decisões probabilísticas tipadas.
Sim. A saída type-safe evita determinados erros de formatação e esquema, mas a decisão selecionada ainda pode estar semanticamente errada. Avaliações independentes mostram resultados fortes em muitos conjuntos de dados, mas também identificam erros dependentes da tarefa e problemas de calibração de limites.
A OpenAI Decisions API é um endpoint em beta público alimentado pelo GPT-6 Luna que transforma texto ou imagens em predicados, escolhas ou pontuações tipadas. A OpenAI anuncia que ela é aproximadamente 10 vezes mais rápida que realizar o mesmo tipo de trabalho por meio da Responses API.
O preço atual da Decisions API é de US$ 0,10 por milhão de tokens de entrada, sem cobrança por tokens de saída. O preço-base publicado do Jev é menor, de US$ 0,042 por milhão de tokens, também com saída gratuita.
Uma probabilidade, por si só, não informa à aplicação qual ação tomar. As equipes devem escolher os limites usando dados de avaliação rotulados e o custo real de falsos positivos, falsos negativos e revisão humana, em vez de presumir que 0,5 é sempre o corte correto.
Modelos de decisão são mais adequados para classificação, roteamento, pontuação, verificação e ramificação em alto volume, quando as saídas possíveis podem ser definidas antecipadamente. Use modelos de uso geral quando a tarefa exigir raciocínio aberto, explicação, geração de conteúdo ou planejamento complexo.
O TypeSafe Jev adota uma abordagem deliberadamente restrita para a IA: em vez de produzir linguagem para pessoas, produz decisões tipadas para softwares. Esse design torna a classificação, o roteamento, a pontuação e a verificação em alto volume muito mais baratos e fáceis de integrar ao código.
A adoção inicial do modelo foi forte o suficiente para que a OpenAI entrasse rapidamente na mesma categoria de produto com a Decisions API baseada no GPT-6 Luna. O Jev continua mais barato no preço-base publicado por token de entrada, enquanto a OpenAI acrescenta suporte a imagens e a escala de uma plataforma de modelos de uso geral já existente.
O principal desafio de engenharia é a confiabilidade, não a formatação. Saídas tipadas eliminam uma classe de falhas, mas a precisão das decisões ainda depende do conjunto de dados, do limite, do custo dos erros e da política de encaminhamento. O estudo independente do Jev deixa isso especialmente claro.
A mudança maior é que a IA pode deixar de ser algo com que os usuários “conversam” explicitamente e se tornar uma camada de decisão de baixo custo, executada silenciosamente dentro de softwares comuns.
Comece com uma frase e tenha um site completo em minutos.



