For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/-gemini-35-flash-3-api-mcp-.md.
Практическое руководство для разработчиков по Gemini 3.5 Flash, охватывающее три дорогостоящие ловушки при миграции API, 14-кратный биллинг ...
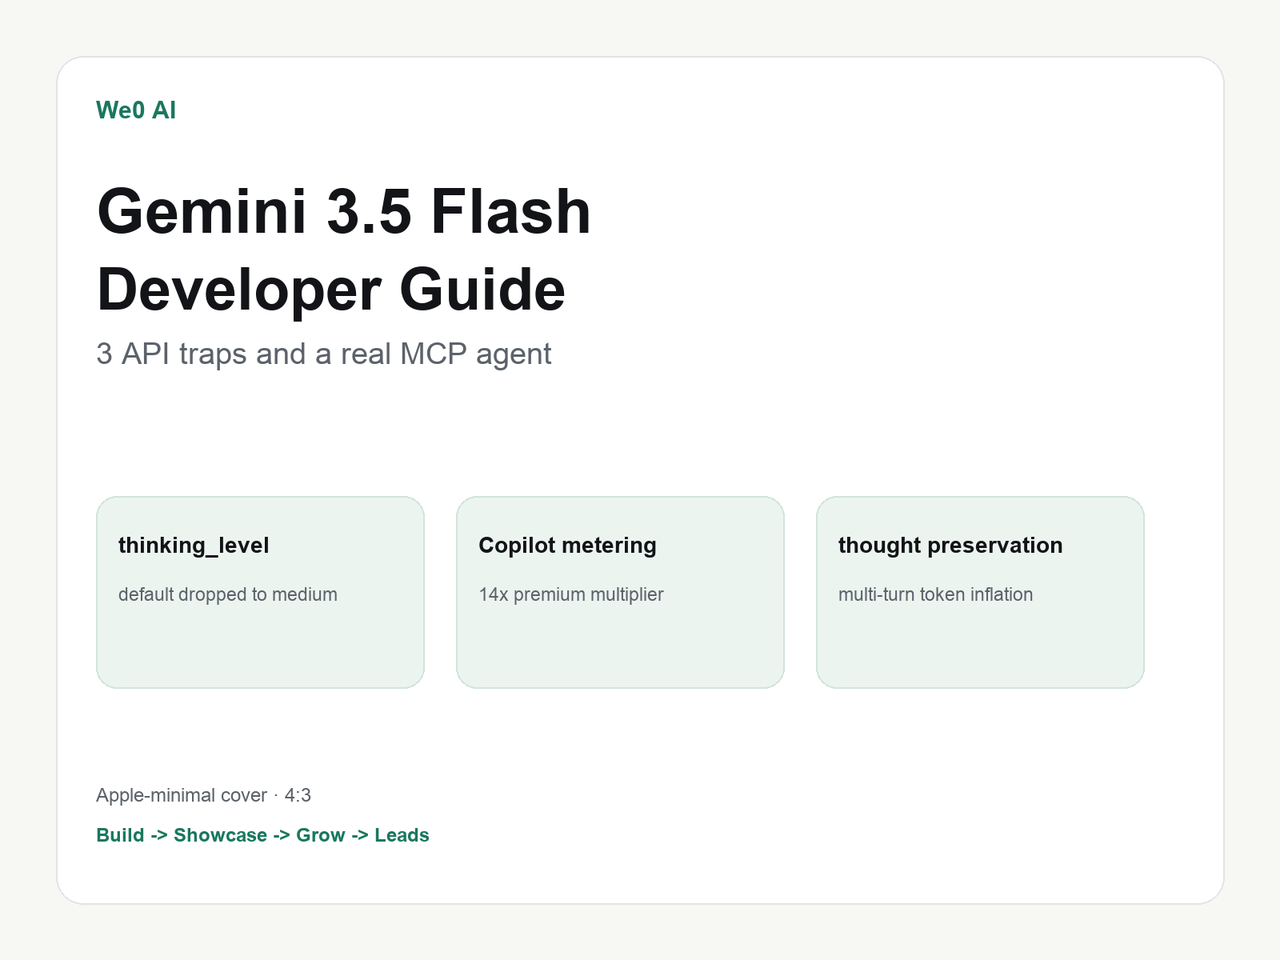
Самые дорогие ошибки в Gemini 3.5 Flash — это не синтаксические ошибки, а незаметные настройки по умолчанию.
Для многих агентных сценариев программирования low оказывается лучшим значением по умолчанию, чем ожидают люди.
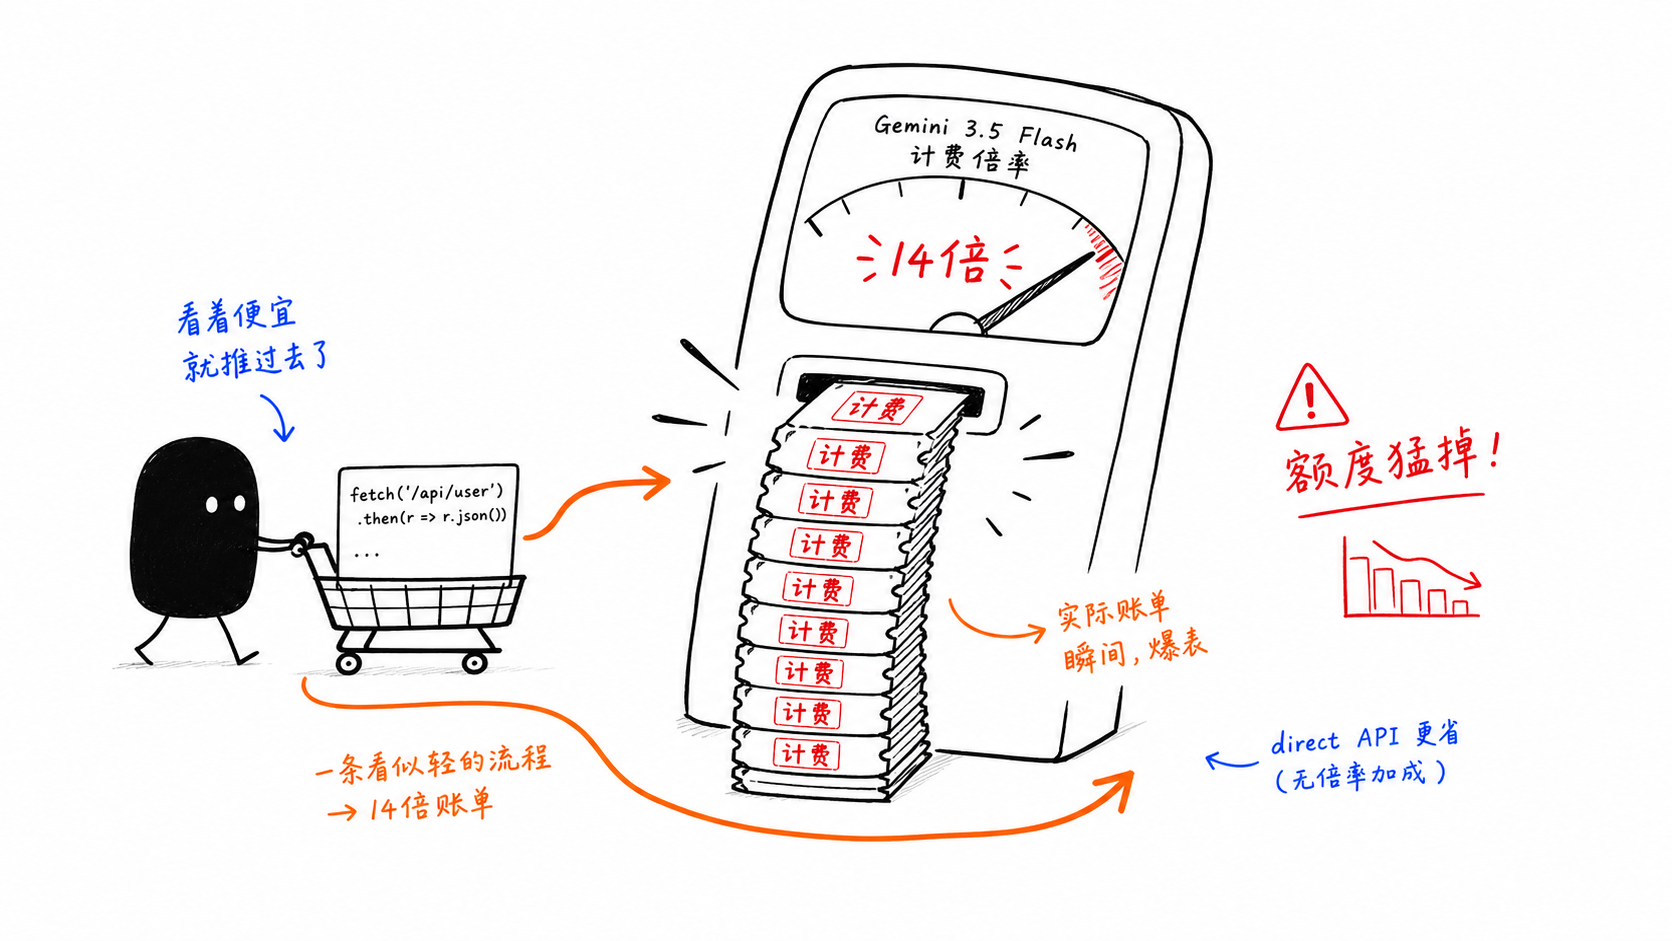
Тяжёлые агентные циклы через GitHub Copilot могут стать намного дороже из-за тарификации 14x.
В We0 AI выбор модели — лишь часть рабочего процесса. Всё остальное — это то, как продукт объясняется, показывается и обнаруживается пользователями.
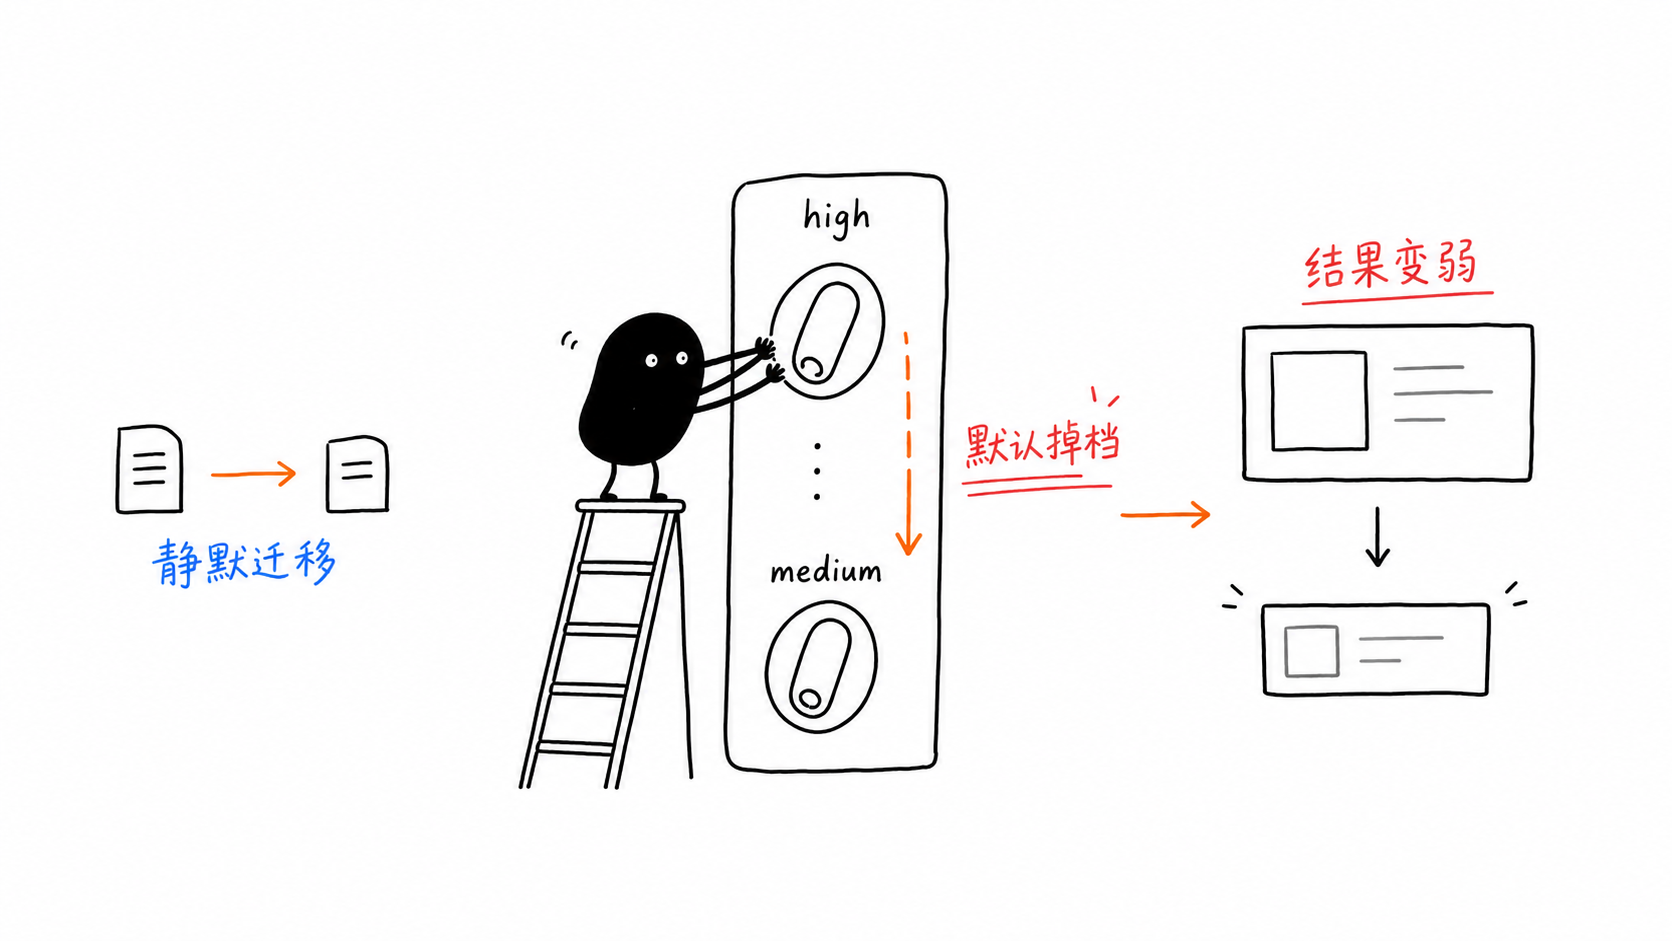
gemini-3.5-flash кажется простым для вызова.
Именно поэтому его легко недооценить. Даже небольшая миграция с кода эпохи preview всё ещё может привести к худшим результатам, другому профилю затрат и более дорогим многошаговым циклам без единой видимой ошибки.
Это руководство сосредоточено на трёх самых важных ловушках, форме кода, которая позволяет их избежать, и практическом агентном цикле в стиле MCP, который можно быстро адаптировать.
thinking_level снизилось с high до mediumЭто опасно, потому что ничего не ломается.
Вы переносите старый код, запрос по-прежнему возвращает результат, но модель уже рассуждает не на том уровне, который вы предполагали.
Значение
Что делает
Когда использовать
minimal
Минимально необходимое рассуждение
Автодополнение, классификация, одношаговые завершения
Кодовые агенты, циклы инструментов MCP, многошаговые рабочие процессы
medium
Потребительский чат, общие вопросы и ответы
high
Максимальное усилие рассуждения
Сложные рассуждения, отладка новых проблем, математика, планирование
response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents=prompt,
)

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
)
Второй фрагмент выполняется, но значения по умолчанию уже не те же самые.
from google import genai
import os

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
    config={
        "thinking_config": {
            "thinking_level": "high"  # or "low" for coding agents
        }
    },
)Для многих рабочих процессов с кодовыми агентами лучше начинать с low, а не с high.
Практическая причина проста:
быстрее
дешевле
часто достаточно хорошо или сопоставимо для циклов программирования с активным использованием инструментов
Проблема не в базовой цене модели. Проблема в множителе premium-request внутри GitHub Copilot. Как только Flash начинает использоваться агентно, структура затрат быстро меняется.
лёгкое интерактивное использование остаётся внутри Copilot
тяжёлые циклы и пакетные рабочие процессы идут через прямой API
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Архитектура становится инструментом контроля затрат.
Gemini 3.5 Flash переносит внутренние рассуждения между ходами диалога.
Это повышает согласованность, но также означает, что эти мысли могут продолжать появляться в учёте токенов на последующих шагах.
Для длинных агентных циклов это может существенно увеличить расход токенов.
сбрасывайте чаты на чистых границах этапов
резюмируйте и переносите дальше только действительно важное
используйте кэширование промптов для стабильных инструкций и определений инструментов
следите за соотношением токенов мыслей к токенам промпта с течением времени
Исходная статья включает очень полезный сквозной шаблон: один инструмент для чтения файлов, один инструмент для получения данных по URL, стандартную форму объявления функций и цикл, который отправляет ответы инструментов обратно в модель.
import os
import httpx
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

read_file = types.FunctionDeclaration(
    name="read_file",
    description="Read a local file and return its contents as text.",
    parameters={
        "type": "object",
        "properties": {
            "path": {
                "type": "string",
                "description": "Absolute path to the file"
            }
        },
        "required": ["path"],
    },
)

fetch_url = types.FunctionDeclaration(
    name="fetch_url",
    description="Fetch a URL and return the response body as text.",
    parameters={
        "type": "object",
        "properties": {
            "url": {
                "type": "string",
                "description": "Fully-qualified URL"
            }
        },
        "required": ["url"],
    },
)tools = types.Tool(function_declarations=[read_file, fetch_url])
def execute_tool(call):
if call.name == "read_file":
return Path(call.args["path"]).read_text(encoding="utf-8")
if call.name == "fetch_url":
return httpx.get(call.args["url"], timeout=15).text[:50000]
raise ValueError(f"Unknown tool: {call.name}")
def run_agent(task: str, max_turns: int = 8):
history = [types.Content(role="user", parts=[types.Part(text=task)])]
for _ in range(max_turns):
response = client.models.generate_content(
model="gemini-3.5-flash",
contents=history,
config=types.GenerateContentConfig(
tools=[tools],
thinking_config=types.ThinkingConfig(thinking_level="low"),
),
)
if not response.function_calls:
return response.text
history.append(response.candidates[0].content)
tool_results = []
for call in response.function_calls:
result = execute_tool(call)
tool_results.append(
types.Part(
function_response=types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": result},
)
)
)
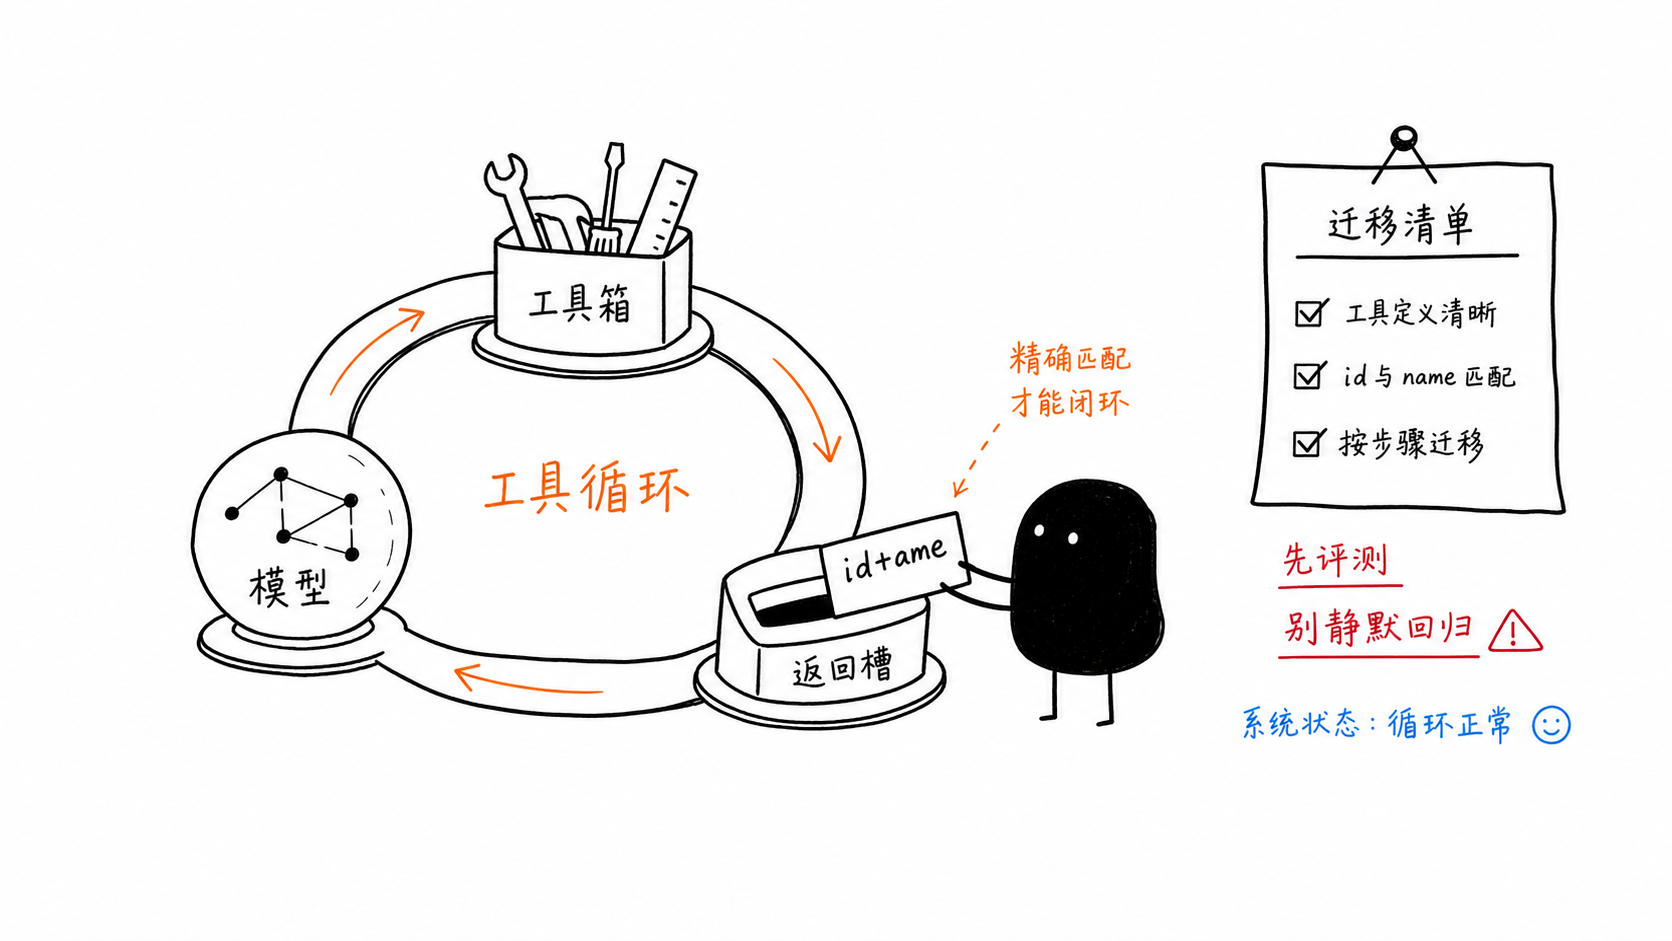
history.append(types.Content(role="tool", parts=tool_results))Небольшое, но критически важное правило миграции заключается в том, что ответ вашей функции должен соответствовать и id, и name из исходного вызова.
Вручную строить циклы инструментов нормально для прототипов. Но в продакшене вы быстро приходите к тому, что заново создаёте оркестрацию, кэширование, маршрутизацию, повторные попытки и наблюдаемость.
Именно поэтому более важный вопрос заключается не только в том, «могу ли я подключить эту модель», но и в том, «какой объём агентной инфраструктуры мне придётся поддерживать самостоятельно?»
Если вы переходите с gemini-3-flash-preview на gemini-3.5-flash, явно проверьте следующие пункты:
внимательно замените идентификатор модели
осознанно задайте thinking_level
удалите устаревшие переопределения сэмплирования, если только оценки не подтверждают их необходимость
id и name в ответах инструментовпроверяйте response.usage_metadata.thoughts_token_count
оставьте preview для неподдерживаемых API, от которых вы всё ещё зависите
проводите оценки до и после
сравнивайте тарификацию Copilot с прямыми затратами на API
Если ваша цель — не только тестировать промпты, но и связывать вместе файлы, репозитории, API, документы и агентные рабочие процессы, вам обычно нужно нечто большее, чем просто конечная точка модели.
В We0 AI этот же принцип идёт ещё на шаг дальше: рабочий процесс агента — это лишь половина дела. Остальное — сделать продукт понятным, доступным для поиска, рекомендованным и конверсионным с помощью документации, FAQ, страниц продукта, демонстрационного контента и поверхностей SEO / GEO.
Сам вызов короткий. Важная часть — явно задать thinking_level, чтобы миграция не привела незаметно к ухудшению качества вывода.
thinking_level?minimal для очень лёгких задач
low для программирования и агентных рабочих процессов
medium как стильный по умолчанию вариант для потребительских сценариев
high для более сложных рассуждений и более глубокого планирования
Потому что множитель тарификации меняет экономику использования. При интенсивном использовании агентом это может влиять на общую стоимость сильнее, чем базовая цена модели.
Это когда модель переносит внутреннее рассуждение между ходами диалога. Это помогает сохранять связность в многошаговых взаимодействиях, но также увеличивает вероятность того, что со временем стоимость токенов будет расти.
Да, особенно когда схемы инструментов, сопоставление ответов, thinking_level и распределение токенов обрабатываются тщательно.
Начните с одной фразы и получите полноценный сайт за считанные минуты.