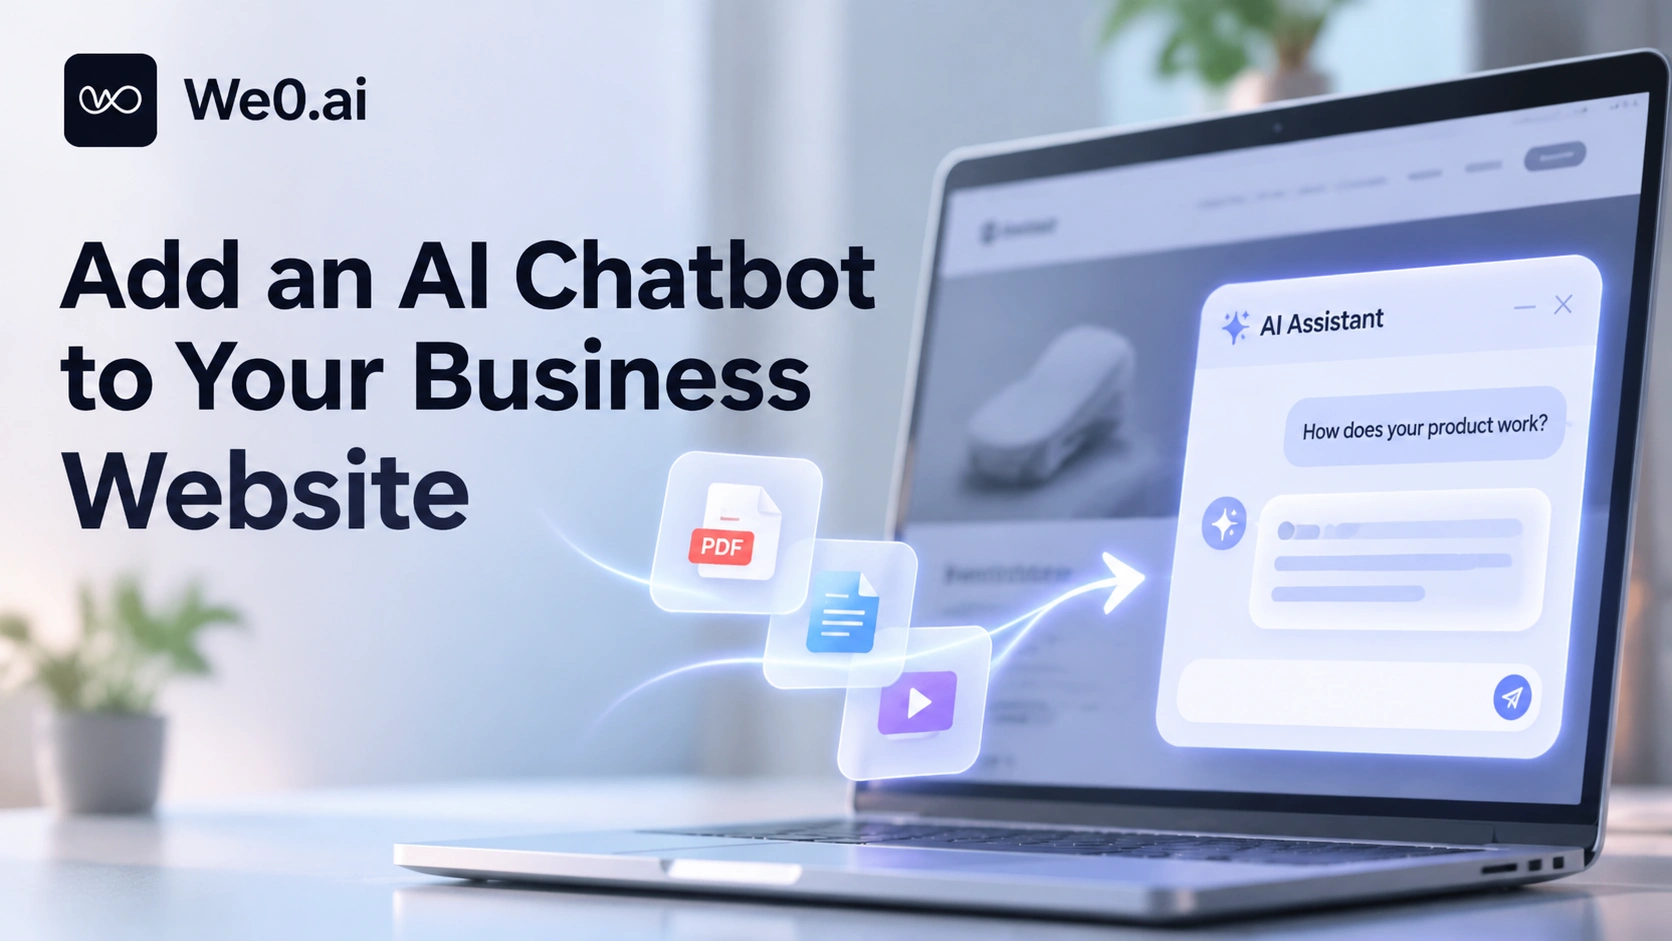
Логика обычной страницы FAQ — «человек ищет ответ»: пользователь сам решает, какой пункт открыть, читает весь раздел и соотносит его со своей ситуацией. А на корпоративный сайт часто приходят запросы вроде «Поддерживает ли наша версия приватное развёртывание? Данные не должны покидать внутреннюю сеть» — это составной вопрос, тогда как в FAQ есть только пункт «Поддерживается приватное развёртывание», и после прочтения пользователь всё равно не уверен.
Отличие AI-поддержки в том, что ответ собирается под конкретный вопрос на месте. Она использует контент сайта, продуктовую документацию и список FAQ как единую базу знаний: когда пользователь задаёт вопрос, система сначала находит релевантные материалы, а затем большая модель формирует из них абзац с прямым ответом (Документация AI-поддержки Alibaba Cloud). Для предпродажных консультаций, подсказок по функциям и информационных запросов на сайте — этих часто повторяющихся сценариев — такое отличие определяет, продолжит ли пользователь читать или просто закроет страницу и пойдёт спрашивать конкурента.
Поэтому поставлять нужно не чат-окно, а знаниевый актив, который можно найти поиском и который достаточно точен. Оформление окна — последний шаг; первые два определяют, будет ли оно вообще полезным.
Технический каркас, который позволяет AI-поддержке «понимать собственный продукт»: RAG
Чтобы чат-бот отвечал по материалам компании, основной подход — генерация с дополнением поиском (RAG). Её суть не в том, чтобы модель «запомнила» ваш продукт, а в том, чтобы перед каждым ответом найти в базе знаний релевантные фрагменты и написать ответ на их основе. В документации Cloudera RAG Studio такие системы описываются так: чат-бот обращается к базе знаний, извлекает контент, связанный с вопросом пользователя, и затем генерирует ответ, соответствующий этому вопросу (Описание сценариев RAG Studio).
Минимально рабочая цепочка состоит из пяти шагов:
- Разбиение: разбить руководства, условия, продуктовые страницы на небольшие блоки, доступные для поиска;
- Индексирование: создать для каждого блока векторный или ключевой индекс;
- Поиск: при вопросе пользователя извлечь несколько наиболее релевантных блоков;
- Генерация: передать найденный контент вместе с вопросом модели, чтобы она собрала ответ;
- Ссылки на источники: рядом с ответом указать источник, чтобы пользователь мог перейти и проверить.
Пятый шаг часто упускают, но он решает две задачи одновременно: доверие пользователя и вашу последующую проверку того, из какого документа взялась эта фраза. После обновления материалов модель не нужно переобучать — достаточно изменить базу знаний; поэтому RAG лучше подходит для часто обновляемой продуктовой документации, чем дообучение.
Шаг 1. Инвентаризация источников знаний: что именно должно попасть в базу знаний
Перед подключением разложите материалы по категориям. Не всё подходит для прямой загрузки, и не всё следует показывать публично.
| Источник знаний | Что подходит для размещения | На что обратить внимание при подключении |
|---|---|---|
| Страницы сайта | Описание продукта, страницы функций, страницы цен, статьи справочного центра | Можно собирать автоматически, но нужно убедиться, что онлайн-страницы являются актуальной версией |
| PDF / Word-документы | Продуктовые руководства, спецификации, описание интерфейсов, условия обслуживания | Сканы нужно сначала распознать, иначе поиск их не найдёт |
| Стандартные вопросы и ответы FAQ | Политики, сроки, возврат и обмен, счета, процесс послепродажного обслуживания | Наивысший приоритет срабатывания, ответы наиболее контролируемы |
| Внутренние материалы | Правила ценообразования, SOP продаж, руководство по устранению неисправностей | Связаны с правами доступа; нельзя смешивать с публичными знаниями в одном поисковом диапазоне |
Типичная ошибка — загрузить все материалы без разбора, в результате модель находит три спецификации разных периодов и ответы противоречат друг другу. Сначала дедупликация и сведение версий — это гораздо эффективнее, чем настройка промптов.
Шаг 2. Создайте базу знаний и сделайте её доступной для поиска
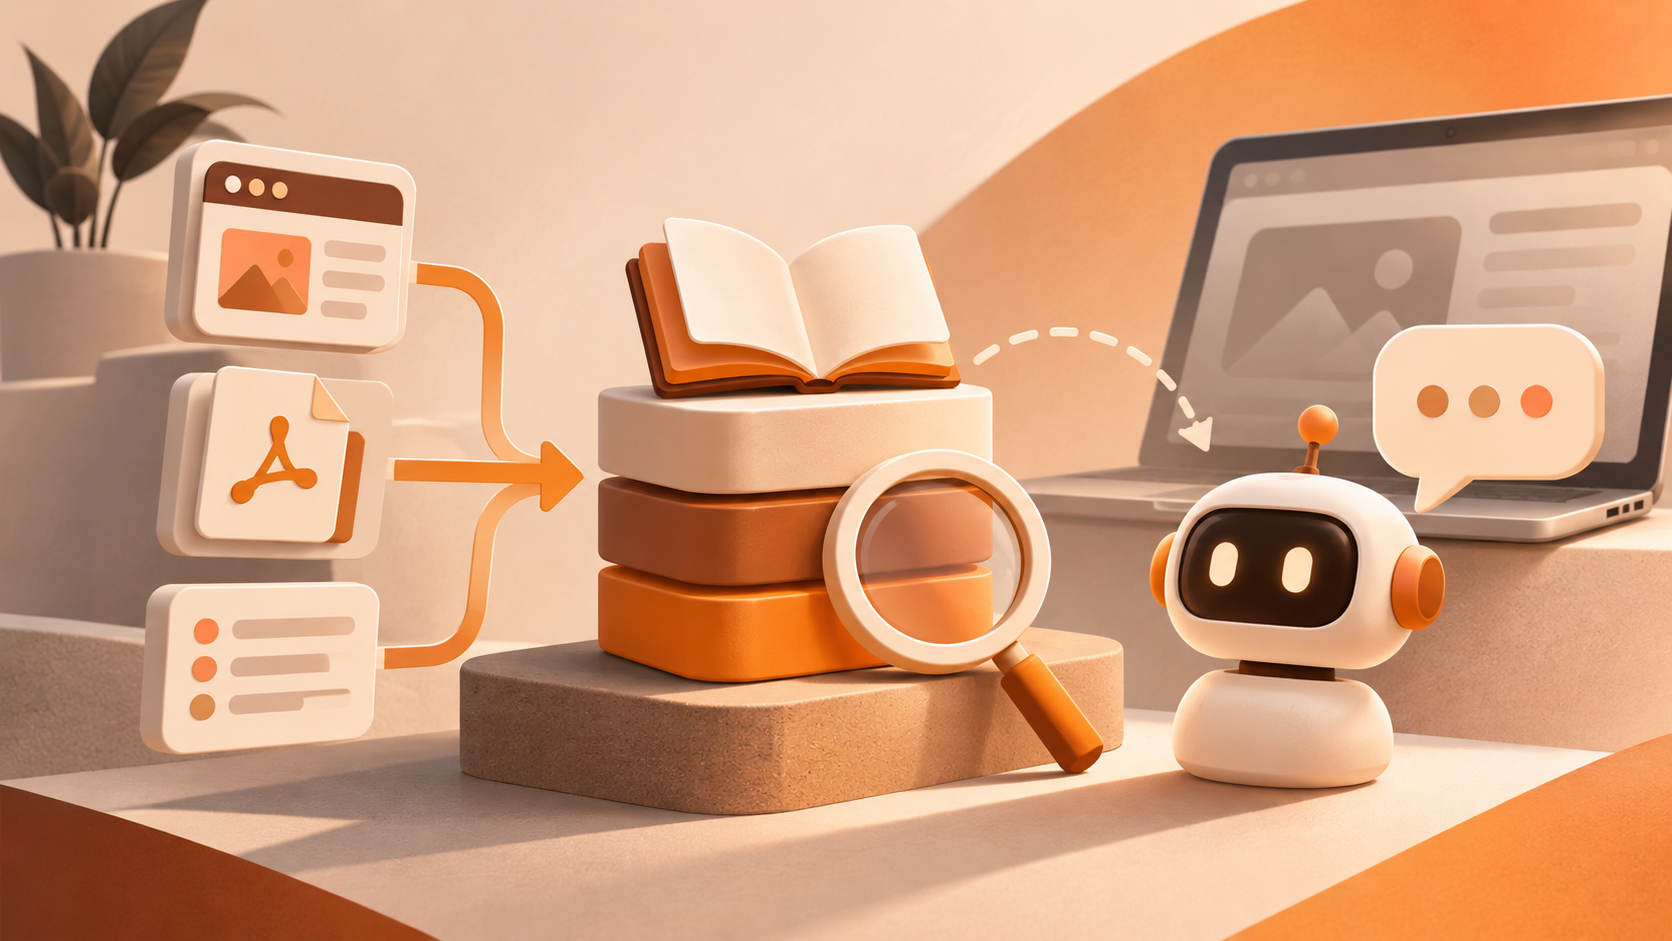
Обычно есть три способа построения базы знаний: импорт сайта, загрузка файлов и ввод FAQ. На примере реализации AI-поддержки Alibaba Cloud: после включения сервиса система автоматически разбирает публичный контент сайта как начальную базу знаний, а время сбора зависит от объёма контента на сайте; загрузка файлов поддерживает шесть форматов — pdf, doc, docx, txt, markdown и excel; FAQ используется для ввода стандартных пар вопрос-ответ, и когда вопрос пользователя одновременно совпадает с несколькими источниками знаний, система в первую очередь использует стандартный ответ из FAQ (Документация AI-поддержки Alibaba Cloud).
На уровне выполнения有几个 действия стоит зафиксировать как процесс:
- После импорта сайта просмотрите список собранных страниц и удалите устаревшие промостраницы и черновики;
- При обновлении контента вручную запустите повторный сбор или включите регулярную автосинхронизацию, чтобы база знаний не застряла на состоянии трёхмесячной давности;
- Превратите десять групп вопросов, на которые чаще всего даются неверные ответы, в FAQ, чтобы стандартные ответы ограничили свободную импровизацию модели;
- Для каждой статьи знаний назначьте ответственного, иначе через полгода никто не решится удалить старый документ.
Шаг 3. Разместите окно поддержки на сайте
Когда база знаний работает, наступает очередь внешней настройки. Такие поля, как цвет окна, название сервиса, описание сервиса и стартовые вопросы, кажутся декоративными, но на самом деле влияют на качество первого диалога: если в описании сервиса чётко обозначены границы возможностей, пользователь не спросит «напиши мне договор» — то есть то, что выходит за рамки; стартовые вопросы дают вход к частым темам и заметно снижают затраты пользователя на сомнения перед первой фразой (Документация AI-поддержки Alibaba Cloud).
Есть ещё одна настройка, которую легко упустить: контактные данные. Когда AI не может решить вопрос пользователя, интерфейс должен предлагать телефон, электронную почту или другой альтернативный канал; иначе после ответа «Я не знаю» пользователь действительно уйдёт.
Если на самом сайте есть система входа, публичные знания и знания, видимые после входа, — это два отдельных пространства знаний. Для удобства такого разделения базовому сайту лучше иметь возможности аккаунтов — например, в возможностях сайта we0 есть базовая система аккаунтов с подтверждением по электронной почте, входом через Google и GitHub, а также CMS-админка от управления пользователями до поддержки контента (Обзор функций we0); такая основа позволяет сэкономить на самостоятельной сборке входа и поддержки контента.
Как не дать AI выдумывать несуществующую информацию о продукте
Это самый практичный риск при подключении: клиент спрашивает «Вы поддерживаете SAML единый вход?», а модель, чтобы продолжить диалог, вполне может выдать звучащее правдоподобно «поддерживаем».
Снижать такие ошибки нужно ограничениями, а не надеждой. Доступные средства по соотношению эффективности и затрат:
- Ограничьте область ответа: явно требуйте, чтобы модель отвечала только на основе найденных фрагментов; если поиск пуст, прямо сообщайте, что в базе знаний этого нет.
- Задайте запасной сценарий: если совпадений нет, не работайте вхолостую, а предложите пользователю переформулировать вопрос или перейти к оператору; сохраните кнопку оценки для сбора негативной обратной связи.
- Приоритет FAQ: превратите параметры, цены, соответствие требованиям и другие темы, где нельзя ошибаться, в стандартные вопросы-ответы и дайте им приоритет над свободными формулировками модели.
- Обязательные источники: добавляйте к ответу ссылку на источник, чтобы пользователь мог проверить, а вы — разобрать ситуацию позже.
- Выборочная проверка перед запуском: создайте тестовый набор из исторических вопросов реальных обращений в поддержку и сравните ответы с документами по одному; не принимайте работу по вопросам вроде «Здравствуйте» или «Где находится ваша компания?».
Пример рабочей системной инструкции выглядит примерно так:
Ты — продуктовая поддержка на этом сайте. Отвечай только на основе приведённых ниже фрагментов поиска.
Если в фрагментах нет ответа, прямо ответь: «В базе знаний нет соответствующей информации», и предложи пользователю посмотреть контактные данные.
Не выдвигай предположений о функциях, ценах, версиях или обещаниях, которых нет во фрагментах.
В конце ответа в виде списка укажи заголовки страниц-источников.
Можно ли рекомендовать продукты на основе вопроса пользователя
Можно, но рекомендация должна опираться на условия, которые реально существуют в материалах. Рабочий подход — понизить «рекомендацию» до «фильтрации по условиям»: извлечь из описания пользователя сценарий, масштаб, способ развёртывания и другие элементы, затем сопоставить их с явно прописанными в документах различиями версий или разделением тарифов и в конце дать соответствующую страницу продукта. Каждая фраза такой рекомендации прослеживается до источника; наоборот, позволить модели свободно сочинять «наиболее подходящее для вас решение» — значит дать ей сделать за вас неподтверждённое коммерческое обещание.
Данные тоже могут помочь. В панелях некоторых систем поддержки вопросы агрегируются по категориям; рекомендация продуктов — одна из таких категорий, при этом считаются количество сессий, количество пользователей, количество отвеченных вопросов и доля решённых вопросов (количество отвеченных вопросов ÷ общее количество заданных вопросов × 100%) (Документация AI-поддержки Alibaba Cloud). Если доля решённых вопросов в категории рекомендаций долго остаётся низкой, обычно проблема не в модели, а в том, что на продуктовых страницах не хватает информации для решения — критериев сравнения, ценовых диапазонов, подходящих и неподходящих сценариев.
Как передавать сложные вопросы оператору
Ценность AI-поддержки не в том, чтобы отгородить людей, а в том, чтобы переварить простые вопросы и передать сложные вместе с контекстом. Условия перевода на оператора лучше оформить списком, чтобы избежать формулировки «по ситуации»:
Создайте сайт-витрину и привлекайте лиды за минуты
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
- Тема попадает в высокоценные или высокорисковые ключевые слова: коммерческое предложение, условия договора, индивидуальная разработка, сбои и безопасность данных, жалобы;
- Два раунда подряд без решения или пользователь сам просит оператора;
- Эмоциональный фон пользователя явно негативный, есть выраженное недовольство;
- Поиск по базе знаний не дал результатов, а вопрос касается аккаунта, заказа или других тем, требующих проверки во внутренней системе.
При передаче отправьте оператору сводку диалога, уже найденные источники и страницу, на которой находится пользователь, — клиенту не придётся пересказывать всё с начала. Этот шаг технически несложен, но именно на нём возникает самый большой разрыв в опыте: многие компании внедряют AI-поддержку, но переводят на оператора фразой «пожалуйста, опишите вашу проблему заново».
Записывайте диалоги и превращайте их в основу для обновления базы знаний
Диалоги поддержки — самое дешёвое исследование потребностей. Система обычно сохраняет историю сессий, включая вопросы пользователей, ответы AI и источники знаний, на которых основан ответ, а также поддерживает фильтрацию по статусу (например, «решено», «частично решено») (Документация AI-поддержки Alibaba Cloud). Если тратить двадцать минут в неделю на просмотр этих данных, можно получить три типа сигналов:
- Повторяющиеся вопросы с плохими ответами: в базе знаний не хватает статей — дополните FAQ;
- Вопросы с расплывчатыми ответами: документы написаны абстрактно — нужно добавить конкретные параметры или примеры;
- Вопросы, которые клиенты задают сами, а вы не готовились: сигнал предпродажного спроса, его стоит передать продукту и маркетингу.
Некоторые системы предлагают раздел «оптимизация вопросов», где нерешённый вопрос можно одним действием превратить в новую статью FAQ, просто добавив стандартный ответ. Если включить это в еженедельный процесс, база знаний будет расти сама.
После запуска: ритм обновления базы знаний и ответственные
Если AI-поддержка начинает ошибаться через три месяца после запуска, почти всегда дело в том, что базой знаний никто не управляет. Поддерживайте её по фиксированному ритму:
- Еженедельно: разбирайте список нерешённых вопросов, добавляйте 3–5 статей FAQ;
- Ежемесячно: сверяйте согласованность страниц цен, страниц тарифов и документации, снимайте устаревший промо-контент;
- При каждом релизе: в день выпуска синхронно обновляйте документацию по функциям и журнал изменений; не позволяйте AI представлять старую версию;
- Ежеквартально: выборочно проверяйте 30 реальных диалогов, повторно прогоняйте тестовый набор и фиксируйте изменение доли решённых вопросов.
Ответственным не обязательно должен быть руководитель поддержки, но это должен быть конкретный человек, а не «команда». Когда управляют несколько человек, ответственности нет ни у кого.
Пример полной цепочки для SaaS-компании
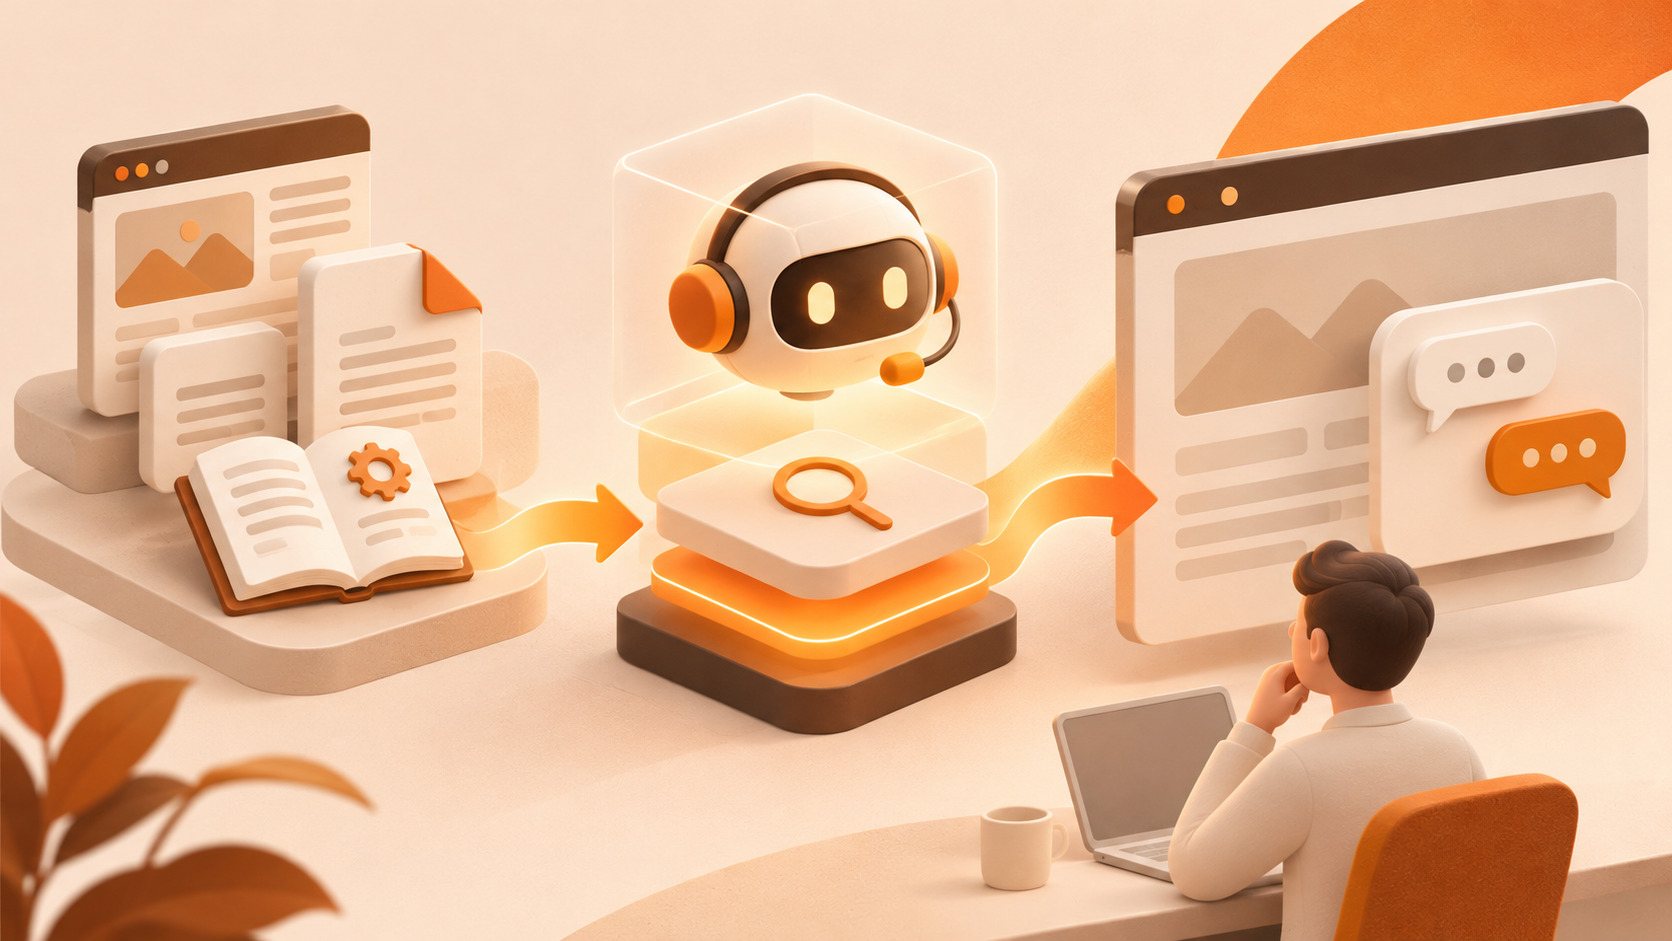
Предположим, SaaS-компания, делающая дашборды для данных, только что запустила новый сайт. У продукта есть три формы: бесплатная версия, командная версия и приватное развёртывание, а документация разбросана по справочному центру и PDF-руководствам.
- Вопрос пользователя: посетитель вводит в окне в правом нижнем углу страницы цен: «У нас аналитическая команда из 80 человек, данные не должны покидать внутреннюю сеть. Как вы берёте плату?»
- Поиск: система извлекает релевантный контент из справочного центра, описания приватного развёртывания и PDF-руководства с ценами.
- Формирование ответа: сначала отвечает, удовлетворяет ли форма развёртывания требованию «данные не покидают внутреннюю сеть», затем объясняет параметры расчёта цены для приватного решения; тон сдержанный, конкретная сумма не обещается.
- Предоставление связанных страниц: добавляет страницу с описанием приватного развёртывания и вход для связи с отделом продаж.
- Перевод оператору при невозможности решить: пользователь уточняет условия договора и сроки внедрения; срабатывают высокорисковые ключевые слова — происходит прямой перевод на оператора с приложением сводки диалога.
- Закрепление знания: вопрос попадает в список нерешённых, операционная команда добавляет статью FAQ «Как рассчитывается цена приватного развёртывания».
Во всей этой цепочке AI ничего не «угадывает»: каждый шаг можно проследить до документа.
Что we0 может взять на себя в этой цепочке, а что нужно создавать самостоятельно
Если корпоративный сайт ещё находится на этапе создания, планировать возможности поддержки вместе с ним будет проще. Позиционирование we0 — набор возможностей для сайта, ориентированный на поставку в продакшен; официальный список возможностей включает подключение AI-возможностей (генерация текста, изображений, видео, аудио и т. п., подходящая для расширения в диалоговый продукт), CMS и админ-панель, систему аутентификации, организацию мультиязычности и публикацию/запуск; в сценариях применения прямо упоминаются интеллектуальная поддержка и приложения на основе базы знаний (Обзор функций we0).
Нужно чётко обозначить границы: это базовые возможности для создания сайта и подключения AI, а не готовое «из коробки» корпоративное обслуживание на основе базы знаний. Разбиение и индексирование документов, стратегия поиска, фильтрация знаний по правам пользователя, перевод на живого оператора и интеграция с тикетами обычно всё ещё требуют собственной разработки на основе возможности генерации кода полного стека или интеграции сторонних RAG-систем и систем поддержки. При оценке рассматривайте «может создать сайт» и «может управлять поддержкой на базе знаний» как две разные вещи — это поможет не обнаружить после запуска, что половины цепочки не хватает.
Комплаенс и границы контента: какие материалы нельзя собирать
Чем шире источники знаний, тем важнее следить за тем, как контент попадает в систему. Импортируйте только собственный публичный контент, разрешённый к сбору, и материалы, на которые у вас есть права; не получайте сторонний контент в обход пейволов, ограничений входа или антибот-механизмов. Одно консультативное заключение Суда ЕС даёт здесь ориентир: когда чат-бот в ответе в реальном времени извлекает и повторно использует новостной издательский контент, это может нарушать права издателя, если контент получен незаконно или формулировка ответа почти заменяет оригинал; а фактическое резюме своими словами со ссылкой на оригинал существенно снижает риск (Разбор соответствующего дела).
Для поддержки на корпоративном сайте этот принцип переводится просто: в базе знаний лежат собственные материалы и лицензированный контент, ответы строятся в основном на резюме и указании источника, а не на дословном пересказе чужих материалов.
Частые вопросы
Может ли AI-поддержка напрямую читать PDF и Word?
Может. На примере распространённых платформ для сайтов и поддержки загрузка файлов поддерживает форматы pdf, doc, docx, txt, markdown и excel и т. д.; после загрузки файл проходит разбор, и после успешного разбора он может участвовать в поиске (Документация AI-поддержки Alibaba Cloud). Сканированные PDF нужно сначала преобразовать в текст, доступный для поиска.
Цены в базе знаний часто меняются. Как гарантировать правильный ответ?
Цены, тарифы и другую часто меняющуюся информацию делайте отдельными стандартными ответами FAQ и назначайте ежемесячную проверку; не разносите цены по нескольким PDF, иначе модель будет находить разные версии.
Может ли AI-поддержка раскрыть клиентам внутренние материалы?
Зависит от того, как разграничены области знаний. Публичные знания и внутренние материалы следует хранить в разных наборах знаний; внутренние материалы открываются только определённым ролям после входа, а не защищаются просьбой к модели «не говорить об этом».
Нужно ли добавлять к ответу ссылки на источники?
Рекомендуется. Это повышает доверие и позволяет при разборе подтвердить, на какую версию документа опирался ответ.
Сколько времени занимает запуск?
Основное время уходит на подготовку материалов и выборочную проверку тестового набора, а не на техническое подключение. Реальнее сначала запустить версию с покрытием 70%, а затем еженедельно дополнять FAQ, чем сразу гнаться за полным покрытием.
Связанные инструменты
- Консоль базы знаний и поддержки: управление импортом сайта, загрузкой файлов, FAQ и оптимизацией вопросов
- CMS и контент-админка: поддержка версий справочного центра, продуктовой документации и страниц цен
- Инструменты аналитики сайта: наблюдение за кликами по входу в диалог и путями конверсии
- Система тикетов / IM: приём переведённых от AI человеческих диалогов и сводок разговора
- Сервисы RAG и векторного поиска: используются при самостоятельном построении поискового слоя
Связанные ссылки
- Документация AI-поддержки Alibaba Cloud
- Описание сценариев Cloudera RAG Studio
- Обзор функций we0
- Разбор дела об AI-чат-ботах и новостном авторском праве
Резюме
Если компания хочет, чтобы AI-поддержка на сайте отвечала на вопросы о её продуктах, ключ не в окне чата, а в базе знаний и цепочке поиска. В статье сначала объясняется разница между AI-поддержкой и статическим FAQ, затем приводится трёхшаговый путь внедрения: инвентаризация источников знаний (страницы сайта, PDF/Word-документы, FAQ), использование RAG, чтобы ответы опирались на источники, и размещение окна поддержки на сайте. Далее рассматривается, как избежать выдумывания информации о продукте, какие границы должны быть у рекомендаций продуктов, по каким правилам сложные вопросы передаются оператору, как замкнуть цикл записей диалогов и оптимизации вопросов, каким должен быть ритм обновления базы знаний после запуска, а также разбирается полная цепочка на примере SaaS-сценария. Статья также объясняет, какие готовые возможности может дать такая основа для сайта, как we0, какие звенья нужно создавать самостоятельно или интегрировать со сторонними системами и где проходят границы комплаенса при сборе контента.