curl -sL https://www.example.com/ | grep -o "[^"
curl -sL https://www.example.com/ | head -c 1200
Если в ответе только `
` и куча тегов script, без читаемого названия компании, продукта и абзацев текста, значит поисковый сканер в первый раз получает именно эту пустую оболочку. Документация Google по JavaScript SEO объясняет связь сканирования и рендеринга: содержимое скриптов не является полностью невидимым, но рендеринг требует дополнительной очереди сканирования и ресурсов; чем сильнее контент и ссылки зависят от скриптов, тем выше неопределённость корректного чтения (см. [Основы JavaScript SEO от Google](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)).
**Как исправить**: выведите ключевой контент в исходный HTML — через серверный рендеринг, статическую генерацию или хотя бы через реальные теги заголовка, текста и внутренних ссылок. Критерий простой: при отключённом JavaScript в браузере страница всё ещё должна читаться.
## Проверка 2: Правильно ли заданы Title и Meta Description?

При генерации страниц ИИ чаще всего пропускает метаданные, потому что визуально они совершенно не видны. Три частые ошибки:
- **Одинаковый Title на всём сайте**: шаблонная переменная не заменена, все страницы называются «Главная | Название компании»;
- **Пустой Description**: Google приходится самому вырезать фрагмент текста, и такой сниппет часто выглядит неинформативно;
- **Слишком длинный Title**: китайский заголовок длиннее примерно 30 символов обрезается на мобильных, и часть оффера теряется.
```html
Создание корпоративного сайта: полный процесс от требований до запуска | Название бренда
Самопроверка: возьмите 5 ключевых страниц (главную, страницу продукта, страницу тарифов, страницу кейсов, страницу блога) и убедитесь, что Title у всех разные и содержат тему страницы; Description — полное предложение, а не набор ключевых слов.
Проверка 3: Действительно ли работают sitemap.xml и robots.txt?
Эти два файла — вход для сканеров на сайт и одновременно два файла, которые чаще всего игнорируются в ИИ-конструкторах, потому что в интерфейсе их не существует.
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
Проверьте три вещи: домен в sitemap должен быть боевым доменом, а не preview-доменом; пути, закрытые через Disallow, не должны одновременно появляться в sitemap; строка Sitemap: должна содержать абсолютный адрес.
Также важно понимать границы robots.txt. Google в руководстве по индексации напоминает, что robots.txt управляет сканированием, но не является надёжным способом запрета индексации: URL, заблокированный через robots.txt, всё равно может появиться в результатах поиска из-за внешних ссылок; если страница должна явно не попадать в индекс, используйте noindex (meta-тег robots или HTTP-заголовок X-Robots-Tag). Google также в обновлении документации в октябре 2026 года добавил раздел «индексировать только контент, предназначенный для поиска» и рекомендует по умолчанию не индексировать сгенерированные страницы, предназначенные только для обмена, совместной работы или вывода инструментов, а также отслеживать аномалии индексации через отчёты об индексации страниц и эффективности поиска в Search Console (подробнее — разбор обновления руководства Google по индексации).
Проверка 4: canonical указывает на эту страницу?
rel=canonical сообщает поисковой системе, какой URL является основной версией в группе похожих URL. При ИИ-генерации часто возникают три типа ошибок:
- Все страницы указывают на главную — это говорит Google, что каждая страница является копией главной.
- canonical указывает на preview- или тестовый домен, и боевая страница воспринимается как копия.
- Адреса с параметрами и чистые адреса указывают друг на друга, из-за чего сигналы конфликтуют.
-
Правильный подход: canonical использует абсолютный адрес, https и полностью совпадает с конечным URL, который вы хотите индексировать (наличие или отсутствие завершающего слэша должно быть единым по всему сайту); в мультиязычных сайтах каждая языковая версия указывает на себя и связывается с другими через hreflang, а не через canonical на английскую версию.
Проверка 5: Не содержат ли структурированные данные ошибочную информацию?

ИИ хорошо «дополняет» структурированные данные и так же хорошо заодно выдумывает: несуществующие оценки, отсутствующие ценовые диапазоны, фиктивный год основания. Всё это нарушает базовое требование к структурированным данным — данные должны совпадать с видимым содержимым страницы.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Название бренда",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
Принцип — лучше меньше, чем лишнее: указывайте только поля, которые видны на странице; сомнительные год основания, рейтинги и статус наличия удаляйте; перед публикацией прогоняйте через инструмент проверки структурированных данных и убеждайтесь, что ошибок разбора нет.
Проверка 6: Не блокируют ли формы, попапы и интерактив сканеры?
Формы сами по себе не влияют на индексацию; проблема в том, что они часто «замещают» основной текст: на странице только форма для заявки, контент закрыт за логином, на первом экране всплывает полноэкранный попап с требованием сначала согласиться на cookie. Для сканеров такие страницы лишены текста, по которому можно сопоставить поисковый интент.
Кроме того, ИИ-конструкторы часто создают много «одноразовых» страниц — страницу успешной отправки формы, страницу результата расчёта, ссылку для обмена. Если такие страницы индексируются, они размывают качество сайта. По рекомендации Google надёжнее по умолчанию ставить им noindex (разбор руководства по индексации); настоящие поисковые лендинги должны сохранять полный видимый HTML-текст, а не раскрываться только по клику.
Создайте сайт-витрину и привлекайте лиды за минуты
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Проверка 7: Не откатятся ли SEO-настройки при следующем изменении страницы с помощью ИИ?
Это самый недооценённый риск ИИ-конструирования: страницы генерируются постоянно, и вручную исправленные сегодня Title, canonical и правила robots завтра может перезаписать одна перегенерация «поменяй цвета и заодно оптимизируй текст».
Рабочий подход — не полагаться на память, а закрепить процесс:
- Соберите SEO-настройки в шаблоне или глобальной конфигурации, чтобы меньше писать вручную на каждой странице;
- После каждой перегенерации прогоняйте чек-лист как минимум по главной, странице продукта и странице тарифов;
- Следите за аномальным ростом количества URL: изменения шаблонов или запуск новых функций часто массово создают новые URL; Google рекомендует одновременно отслеживать объём создания контента на стороне платформы и изменения объёма индексации (там же);
- Перед запуском фиксируйте «diff настроек»: сравните Title, canonical, robots и sitemap с предыдущей опубликованной версией.
Проверка 8: Почему в это стоит вкладываться?
Техническое SEO — не узкая тема. По данным Mordor Intelligence, рынок услуг технического SEO в 2025 году составил 1,573 млрд долларов США, а с 1,689 млрд в 2026 году, по прогнозу, вырастет до 2,837 млрд к 2031 году; среднегодовой темп роста в 2026–2031 годах — около 10,93%. На категорию технического SEO в 2025 году пришлось 32,41%, и причина именно в том, что рендеринг, структура сайта, редиректы, структурированные данные и производительность страниц напрямую определяют, можно ли массово обнаружить и извлечь контент; в отчёте также отмечается, что Google по-прежнему учитывает Core Web Vitals в оценке поиска (данные — в отчёте о рынке Technical SEO Services). Иными словами, публикация страницы — только начало; возможность быть просканированным, понятым и процитированным — это входной билет в эпоху поиска и ИИ-поиска.
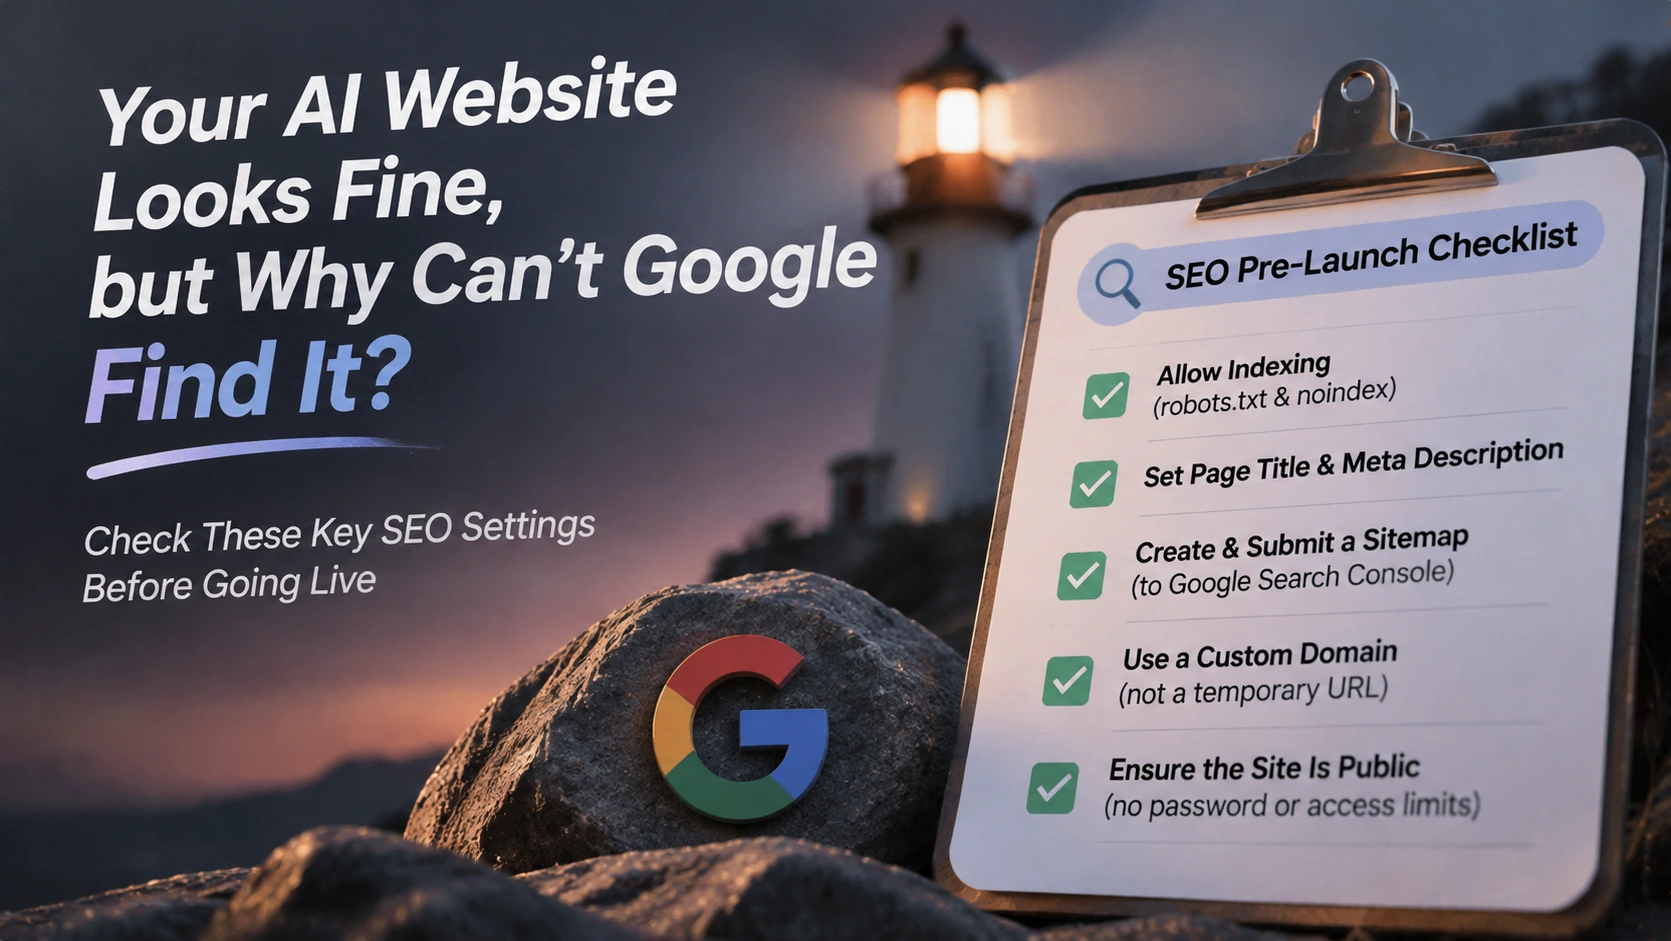
Чек-лист из 10 SEO-проверок перед запуском ИИ-сайта
| # | Проверка | Критерий прохождения |
|---|---|---|
| 1 | Исходный HTML | При отключённом JS видны заголовок и основной текст |
| 2 | HTTP-статус | Ключевые страницы возвращают 200, старые адреса — 301 на новые |
| 3 | Title | Уникален на каждой странице, содержит тему, контролируемая длина |
| 4 | Meta Description | Уникален для каждой страницы, представляет собой полное предложение |
| 5 | robots.txt | Блокирует только админку и preview-пути, Sitemap указан абсолютным адресом |
| 6 | sitemap.xml | Содержит только боевой домен и индексируемые страницы |
| 7 | canonical | Указывает на собственный боевой URL, правило слэша едино по сайту |
| 8 | noindex | Preview-сайты, страницы результатов и страницы обмена по умолчанию не индексируются |
| 9 | Структурированные данные | Только видимые на странице поля, без ошибок разбора |
| 10 | Интерактив и формы | Основной текст не вытеснен попапом, логин-стеной или формой |
Ценность этой таблицы не в «продвинутых приёмах», а в повторяемости: прогоняйте её перед каждым релизом — десять минут помогут отсечь большую часть случаев «сделали, а не находится».
Что компаниям делать сейчас
Если вы создаёте сайт с помощью ИИ-инструментов, можно изменить порядок: сначала сгенерировать структуру и контент, затем добавить метаданные и правила индексирования, а в конце единообразно провести проверку перед публикацией. Такие ИИ-платформы для создания сайтов, как We0, уже объединяют генерацию страниц, CMS-админку, развёртывание домена и настройки SEO/GEO в одной цепочке (см. сайт We0); скорость генерации не меняет предпосылки: поисковик признаёт только то, что реально выведено в HTML, поэтому фактическая проверка после запуска всё равно обязательна.
Конкретные действия можно разбить на три шага: сначала посмотрите исходный HTML через curl, затем подтвердите статус сканирования и индексации в Search Console, а в конце сделайте 10 пунктов выше обязательным этапом перед релизом и внесите их в документ процесса запуска команды.
FAQ
Вопрос: Сайты, сгенерированные ИИ, по определению не соответствуют требованиям SEO?
Нет. ИИ — это лишь способ производства; проблема в том, что процесс генерации по умолчанию ориентирован на «правильно ли выглядит страница», а не на «что прочитала поисковая система». Если исходный HTML содержит основной текст, а метаданные и правила индексирования корректны, между сайтом на ИИ и сайтом, сделанным вручную, нет принципиальной разницы в поисковых результатах.
Вопрос: Страница не находится в Google — значит, наложен санкционный фильтр?
В большинстве случаев дело ещё не дошло до «понижения»; страница просто не просканирована или не проиндексирована. Сначала проверьте статус индексации, затем — не блокируют ли её robots.txt или noindex, и только после этого смотрите на качество контента и конкуренцию.
Вопрос: Если отправить только sitemap, можно гарантировать индексацию?
Нет. sitemap — это подсказка для обнаружения, а не обещание индексации; он помогает сканерам быстрее узнать, какие страницы у вас есть, но индексация зависит от доступа сканера, качества контента и правил индексирования.
Вопрос: Google обязательно не прочитает страницу, отрендеренную JavaScript?
Не обязательно, но неопределённость выше. Для рендеринга нужны дополнительные ресурсы, и чем сильнее страница зависит от скриптов, тем ниже вероятность корректного чтения текста и ссылок первого экрана. Вывести ключевой контент в исходный HTML — самая дешёвая страховка.
Вопрос: Через сколько будет виден эффект?
Единого графика индексации и рейтинга нет: всё зависит от частоты сканирования, размера сайта и конкуренции. Точно известно одно: ошибки в настройках действуют постоянно, пока вы их не обнаружите и не исправите.
Связанные инструменты
- Google Search Console: просмотр отчёта об индексации страниц и эффективности поиска
- Документация Google по JavaScript SEO: фактические правила рендеринга и сканирования
curl/ инструменты разработчика браузера: проверка исходного HTML и читаемости при отключённом JS- Инструмент проверки структурированных данных: проверка разбираемости JSON-LD
Связанные ссылки
- Основы JavaScript SEO от Google
- Разбор обновления руководства Google по индексации: страницы для обмена и сгенерированный контент
- Отчёт о размере и тенденциях рынка Technical SEO Services
- Сайт We0
Резюме
ИИ-конструирование ускоряет запуск, но не меняет принцип работы поисковых систем: они читают HTML, заголовки ответа и структуру ссылок, а не макет на вашем экране. Перед запуском проверьте семь зон — исходный HTML, Title и Description, robots.txt и sitemap, canonical, noindex, структурированные данные, формы и интерактив — и закрепите это в процессе. Тогда «сайт готов, но трафика нет» перестанет быть нормой и станет диагностируемой проблемой.