For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/ai-math-after-navier-stokes-justin-solomo-6c97bef7.md.
Математика, созданная ИИ, выходит за пределы бенчмарков и входит в области, которые профессиональные математики ещё недавно ожидали считать ...
Математика, созданная ИИ, выходит за пределы бенчмарков и входит в области, которые профессиональные математики ещё недавно ожидали считать сложными значительно дольше.
OpenAI заявляет, что её внутренняя передовая модель решила более 100 давних открытых задач в различных областях математики. 6 октября компания выпустила публичный репозиторий, содержащий 722 рукописи, организованные в 372 связанных семейства результатов, а также артефакты доказательств и множество формализаций в Lean.
Наиболее заметный результат появился раньше: созданное ИИ решение задачи о существовании и гладкости решений уравнений Навье—Стокса, одной из семи задач тысячелетия.
Математическое сообщество всё ещё изучает этот результат. Институт математики Клэя заявил, что задача по-видимому, решена, однако официальный процесс оценки и распределения заслуг будет проходить осмотрительно. OpenAI, в свою очередь, заявляет, что не намерена претендовать на премию тысячелетия в размере 1 миллиона долларов.
Более тревожный вопрос иной:
Что происходит, когда доказательство можно формально проверить, но даже высококвалифицированным математикам крайне трудно понять само доказательство?
Этот вопрос был центральным в недавнем выпуске Bloomberg Odd Lots, где заместитель декана по инженерному образованию MIT Джастин Соломон рассказал, как ИИ меняет математические исследования, верификацию, образование и академические стимулы.
Bloomberg Odd Lots обсудил, как ИИ меняет математические исследования, с Джастином Соломоном из MIT.
Эта тема также напрямую связана с лекцией Теренса Тао Math 2.0, прочитанной в октябре 2026 года в Калифорнийском технологическом институте.
Аргумент Тао состоит не в том, что математика заканчивается. По его мнению, дисциплина переходит из эпохи дефицита доказательств в эпоху изобилия доказательств, в которой получить формально корректный результат может стать намного дешевле, чем понять, почему этот результат важен.
Уравнения Навье—Стокса описывают движение жидкостей и газов.
Они используются в моделях:
Сложный вопрос заключается в том, должны ли гладкие трёхмерные решения оставаться гладкими всегда или сингулярность может возникнуть за конечное время.
Сентябрьский результат OpenAI поддерживает вторую возможность.
Компания заявляет, что её внутренняя система создала доказательство того, что динамика Навье—Стокса может приводить к сингулярности за конечное время.
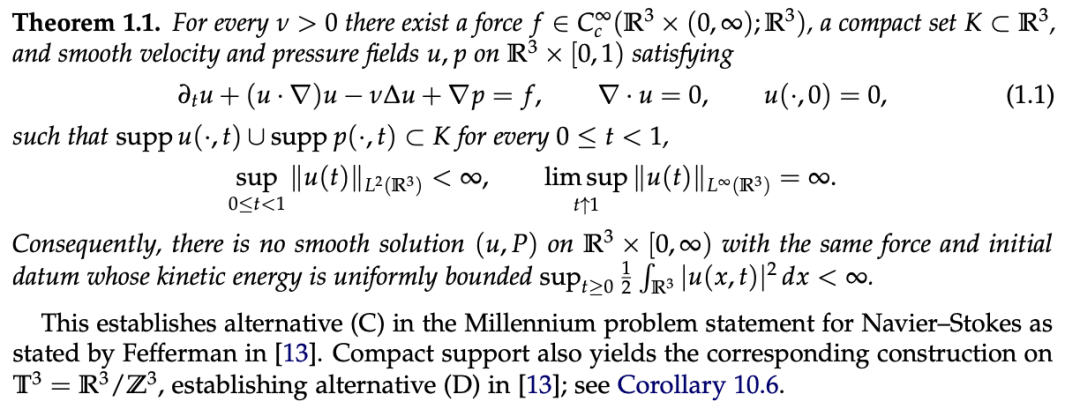
Опубликованная теорема устанавливает конструкцию взрывного поведения за конечное время, используемую в результате OpenAI по Навье—Стоксу.
OpenAI также выпустила формализацию доказательства в Lean.
Это важно, поскольку ассистент доказательств способен проверять, следует ли цепочка формальных утверждений из закодированных допущений.
Но формальная корректность и читаемость для человека — разные свойства.
В Odd Lots Соломон сказал, что статью чрезвычайно трудно читать даже с его математической подготовкой. Он рассказал, что осилил лишь первые несколько страниц, прежде чем плотность технических деталей стала подавляющей.
Его оценку в целом можно передать так:
Собственное описание подкаста осторожнее вирусной версии: доказательство трудно разобрать даже профессиональным математикам.
Это точнее, чем утверждение «ни один человек не может его понять».
Ключевой сдвиг в том, что формальная верификация теперь может двигаться быстрее широкого человеческого понимания.
В исходной статье ИИ описывается как система, завершившая последний один процент конструкции, почти целиком уже построенной математиками-людьми.
Это передаёт общую мысль о важности предшествующей человеческой работы, но история сложнее простого разделения 99%/1%.
Технический отчёт OpenAI утверждает, что её агенты исследовали несколько подходов и распространяли полезные промежуточные идеи между группами.
Компания также обсуждает параллельную работу математиков Левента Альпёге и Тристана Бакмастера над связанным результатом для уравнений Эйлера.
OpenAI заявляет, что доказательства существенно различаются, в том числе в трактовке внешнего воздействия, и что она расследовала, могли ли недавние пользовательские вводы повлиять на её результат.
Компания заключила, что релевантные запросы Бакмастера к Codex за предшествующие два месяца не могли повлиять на внутреннюю модель, использованную для результата по Навье—Стоксу.
Поэтому более осторожное описание таково:
Результат возник в области, где математики-люди уже разработали важные сопутствующие идеи, в то время как внутренняя система OpenAI создала новое доказательство, которое компания считает технически отличным от параллельной человеческой работы.
Это различие важно, поскольку распределение заслуг становится одним из самых сложных вопросов в науке с использованием ИИ.
Доказательство не было сгенерировано одним ответом в чате.
OpenAI описывает масштабный многоагентный исследовательский процесс.
Компания сообщает:
Внутренняя модель, использованная для открытия доказательства, по данным OpenAI, была значительно мощнее GPT-6 Astra.
Поэтому рабочий процесс больше похож не на чат-бота, а на вычислительную исследовательскую программу:
Тысячи экземпляров агентов
        ↓
Множество параллельных подходов
        ↓
Промежуточные результаты передаются между группами
        ↓
Перспективные аргументы консолидируются
        ↓
Формализация в Lean
        ↓
Проверка людьми и сообществом
На протяжении большей части истории математики доказательство выполняло две роли одновременно.
Оно устанавливало истинность теоремы.
Оно также объясняло, почему она истинна, в форме, которую математики могли изучать, упрощать, повторно использовать и преподавать.
Формальная математика, генерируемая ИИ, может разделить эти роли.
Машина может выдать аргумент, который механически проверяем, но всё равно чрезвычайно неприятен для чтения людьми.
Это создаёт три разных уровня:
| Уровень | Главный вопрос |
|---|---|
| Формальная валидность | Проверяется ли доказательство в формальной системе? |
| Человеческая верификация | Могут ли эксперты уверенно изучить математический аргумент? |
| Человеческое понимание | Могут ли люди извлечь из него концепции, механизмы и применимые повторно идеи? |
Сертификат Lean — сильное свидетельство формальной корректности.
Он не создаёт автоматически концептуального объяснения.
Опасение Соломона состоит в том, что математика может всё чаще производить ответы быстрее, чем люди смогут превращать их в понимание.
Конструкция опирается на тщательно организованное поведение жидкости, при котором разные члены становятся очень большими, но продолжают уравновешиваться необходимым образом.
OpenAI визуализирует локальное движение как сочетание внутреннего спирального движения и осевого растяжения.
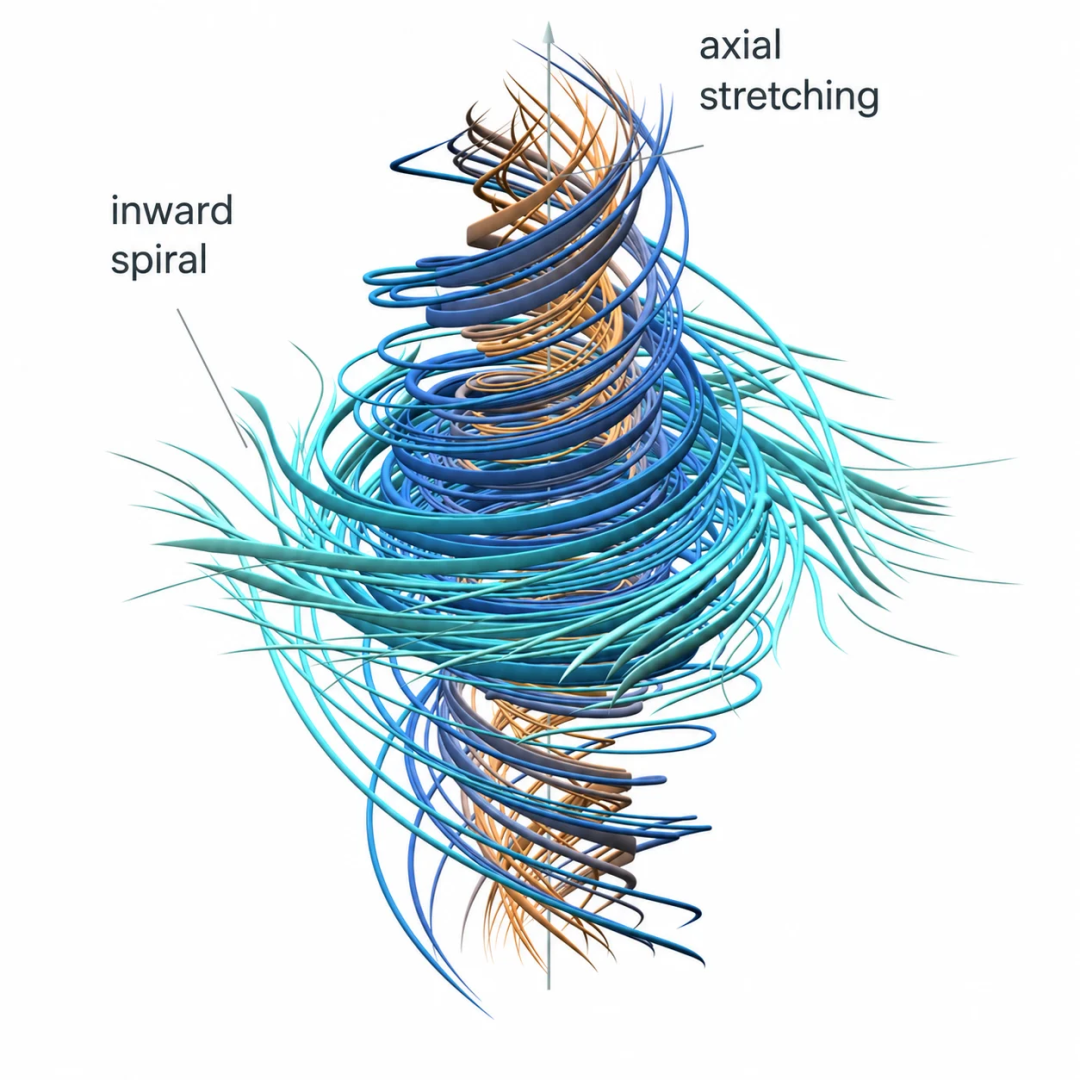
Визуализация OpenAI показывает внутреннее спиральное движение и осевое растяжение в локальной конструкции несжимаемого потока.
Это помогает понять, почему доказательство может быть верным, оставаясь сложным для усвоения.
Аргумент требует обширного контроля над масштабами, оценками, взаимодействующими членами, асимптотическим поведением и тщательно выбранными границами.
Это сильно отличается от популярного образа однострочного озарения, которое внезапно делает всю задачу очевидной.
В выпуске Odd Lots также обсуждался Трэвис Каланик, сооснователь Uber, и его публичные высказывания о занятиях «вайб-физикой» с ИИ.
Идея состоит в том, что пользователь может в диалоговом режиме исследовать сложные научные вопросы без традиционной подготовки в этой области.
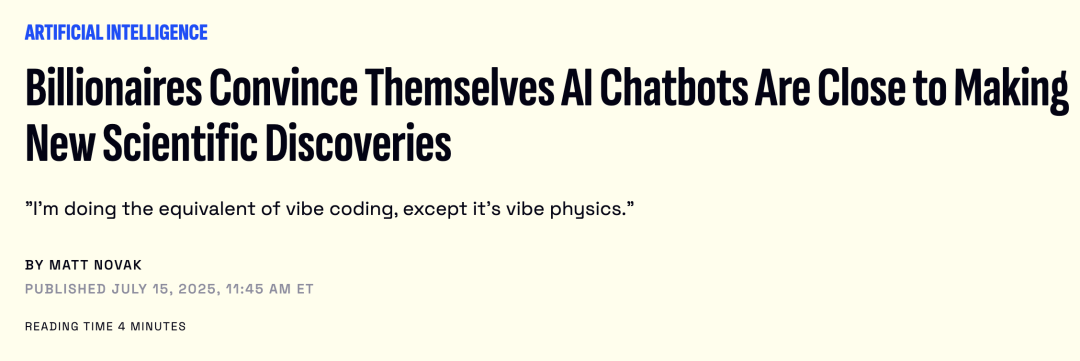
Дискуссия о «вайб-физике» задаётся вопросом, насколько далеко разговорный ИИ может провести неспециалиста в передовых научных исследованиях.
Это высвечивает противоположный режим отказа по сравнению с нечитаемыми формальными доказательствами.
В одном случае ИИ производит математику, которая может быть правильной, но слишком технически сложной, чтобы большинство людей её поняло.
В другом случае ИИ делает сложную науку настолько доступной, что неспециалист может чрезмерно увериться в идее, которая не была строго проверена.
Общее узкое место — верификация.
ИИ может сделать убедительно оформленными и хорошие, и плохие идеи.
Поэтому качество подачи становится более слабым сигналом научного качества.
Теренс Тао ещё острее сформулировал ту же проблему в своей лекции Math 2.0 в Калифорнийском технологическом институте в октябре 2026 года.
Он предлагает аудитории представить, что продвинутый ИИ получил такую инструкцию:
Найди лекарство от рака, которое пройдёт клиническое испытание третьей фазы.
Не допусти ошибок.
ИИ расходует огромные вычислительные ресурсы и возвращает коктейль ранее неизвестных химических веществ.
Никто полностью не понимает, как он нашёл лечение.
Но ИИ каким-то образом предоставляет сертификат Lean для своего предсказания, а лечение проходит клиническое испытание фазы III.
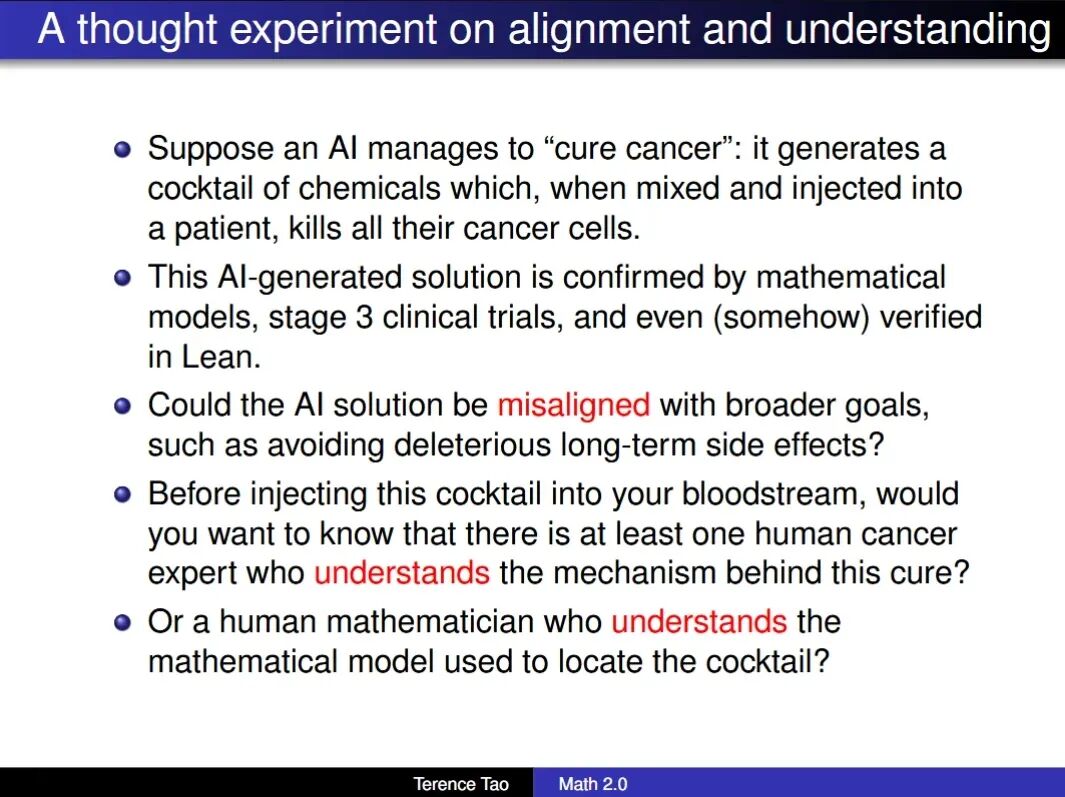
Тао спрашивает, будет ли математически проверенное и клинически успешное лечение по-прежнему восприниматься безопасным, если ни один человек не понимает его механизм.
Вопрос не сводится к тому, работает ли препарат в рамках указанного теста.
Вопрос в том, не оптимизировала ли система против слабости в:
Затем Тао задаёт более личный вопрос.
Если бы у вас был рак, а лечение прошло формальные и клинические проверки, почувствовали бы вы себя спокойнее, зная, что хотя бы один эксперт по раку среди людей понимает часть механизма?
Или что хотя бы один математик-человек понимает модель, использованную для его поиска?
Мысленный эксперимент выявляет центральную проблему согласования:
Мощная оптимизация в сочетании со слабым человеческим пониманием может создавать риск, даже когда измеряемая цель, по-видимому, достигнута.
Более широкий аргумент Тао состоит в том, что традиционная математика развивалась при предположении дефицита доказательств.
Найти правильное доказательство открытой задачи было трудно, медленно, редко и зависело от экспертных знаний специалистов.
ИИ меняет экономику этого процесса.
При достаточном объёме вычислений и доступе к передовым моделям некоторые открытые задачи теперь можно атаковать гораздо быстрее.
Тао называет формирующееся состояние изобилием доказательств.
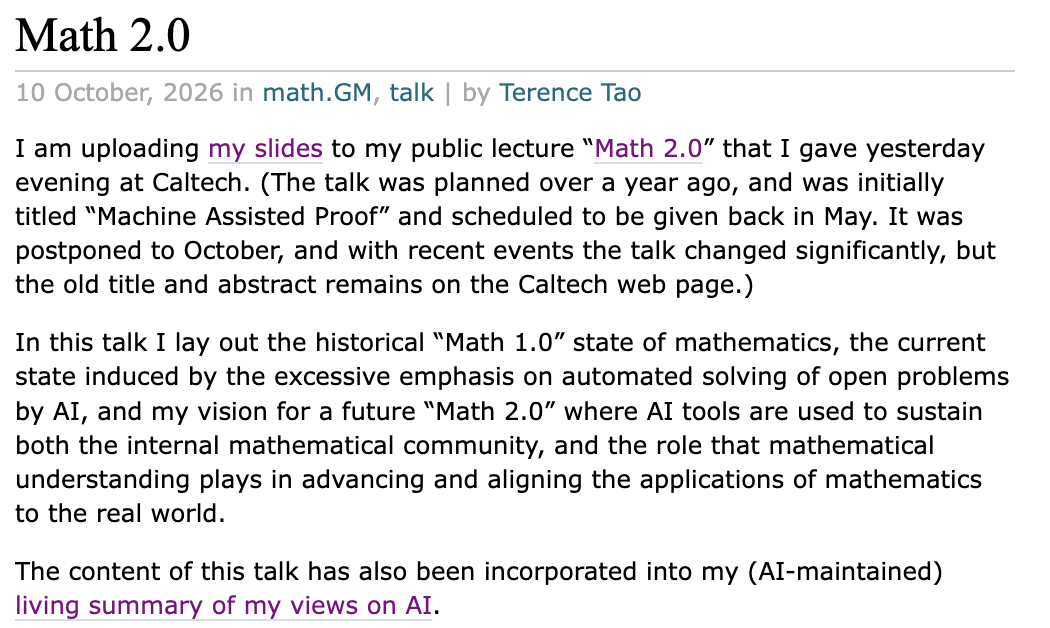
Лекция Тао Math 2.0 утверждает, что математика переходит от дефицита доказательств к их изобилию.
Но Тао прямо отвергает мысль, что математика почти завершена.
В его слайдах говорится, что большинство нынешних передовых задач остаются нерешёнными даже при больших объёмах вычислений, а пространство математических задач остаётся фактически неограниченным.
Его беспокоят стимулы.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Если исследователи будут считать единственной целью «решение знаменитых открытых задач», ИИ может достигнуть пункта назначения, обойдя человеческое исследование, которое исторически порождало:
Тао сравнивает открытые задачи с маяками.
Ценность не только в том, чтобы коснуться маяка. Путь к нему может открыть окружающий ландшафт.
Затем исходная статья переходит от доказательств к академическим публикациям.
Соломон утверждает, что исследовательская экосистема уже испытывает версию той же проблемы.
ИИ снижает стоимость создания:
Но число квалифицированных экспертов-рецензентов не масштабируется автоматически с той же скоростью.
Это создаёт асимметрию:
Стоимость создания исследований
        ↓↓↓

Стоимость рецензирования исследований
        остаётся высокой
Даже сильную работу может стать сложнее заметить, когда окружающий объём резко возрастает.
В исходной статье говорится, что ICLR выросла примерно с одной-двух тысяч заявок десять лет назад до 60 000 заявок в этом году.
Соломон действительно использовал цифру 60 000 в подкасте.
Но данные конференции требуют уточнения.
Для ICLR 2026 официальный ретроспективный отчёт конференции указывает:
Цифра около 60 000, которая распространялась в конце 2026 года, связана с регистрациями ICLR 2027 / идентификаторами заявок OpenReview, а не с окончательным числом действительных статей.
Независимые анализы помещают максимальный идентификатор OpenReview выше 62 000, при этом прямо отмечая, что это верхняя граница, а не окончательный подсчёт статей.
Более широкий тренд реален — давление со стороны потока заявок растёт очень быстро, — но фраза «ICLR получила 60 000 готовых статей» пока не является точной официальной статистикой.
Более глубокая мысль сохраняется и после этой поправки.
Исследователи могут использовать ИИ для подготовки работ значительно быстрее, чем человек-эксперт способен ответственно их рецензировать.
Соломон рассказывает, что получает письма от людей, которые считают, что ИИ открыл новую теорему, и хотят, чтобы эксперт её подтвердил.
Исторически сама сложность создания отполированной математической работы была частичным фильтром.
Этот фильтр слабеет.
Теперь слабый аргумент может прийти вместе с:
Видимость серьёзности становится дешёвой.
Экспертное внимание — нет.
Исходная статья развивает аргумент дальше: если передовая математика всё больше зависит от огромных бюджетов инференса, исследовательская мощь может концентрироваться в организациях, контролирующих лучшие модели и наибольшие вычислительные ресурсы.
Соломон высказывает связанное опасение.
Исследователь в университете может использовать коммерческую систему ИИ, чтобы продвинуться в задаче.
Но поставщик может располагать:
Эта асимметрия может изменить конкуренцию между университетами, независимыми исследователями и крупными технологическими компаниями.
Есть и вопрос атрибуции данных.
Если исследователи обсуждают идеи через коммерческие системы ИИ, какие гарантии существуют относительно того, как эти взаимодействия хранятся или используются?
OpenAI заявляет, что на её систему по Навье—Стоксу не повлияли релевантные запросы Бакмастера к Codex в предшествующие два месяца.
Но более широкая проблема атрибуции остаётся.
Результат по Навье—Стоксу делает вопрос заслуг конкретным.
Среди потенциальных участников могут быть:
Традиционные нормы авторства не были созданы для такой структуры.
Институт математики Клэя признал, что задача Навье—Стокса, по-видимому, решена, но заявил, что процесс присуждения премии потребует времени и включает правила оценки достигнутого и распределения заслуг.
OpenAI отдельно заявляет, что не намерена претендовать на премию тысячелетия.
Это снимает один немедленный спор о призе, но не решает общую проблему авторства.
Финальная часть аргумента Соломона более оптимистична.
Он говорит, что значительная часть нынешней математической работы ИИ всё ещё, по-видимому, находится внутри того, что математики могли бы назвать выпуклой оболочкой существующего знания.
Модели могут быть чрезвычайно сильны в:
Гораздо менее установлено, могут ли они надёжно создавать эквивалент действительно нового математического мировоззрения.
Может ли ИИ изобрести следующую крупную теорию, а не решить проблему, уже поставленную людьми?
Может ли он определить следующий вопрос, заслуживающий десятилетий внимания?
По словам Соломона, это всё ещё значительно менее ясно.
Слайды Тао по Math 2.0 говорят, что решение открытых задач — лишь одна заметная часть математики.
Другая ценная работа включает:
Следовательно, будущее человеческой математики может меньше зависеть от того, кто быстрее всех приходит к доказательству, и больше — от решения, какое знание следует создавать вокруг этого доказательства.
Ближе к концу подкаста ведущие задают Соломону практический вопрос, который волнует многих родителей и студентов:
Если ИИ может решать всё больше математических задач, должны ли дети по-прежнему изучать математику?
Его ответ — да.
Причина не в том, что ученикам нужно побеждать передовую модель в символьных преобразованиях.
Математическое образование также учит людей:
Эти навыки могут стать ещё ценнее, когда отполированные ответы станут изобильными.
Если ответы дешёвы, суждение становится дорогим.
Самая сильная идея исходной статьи — также та, которая сохраняется после самой тщательной проверки фактов.
ИИ может снизить стоимость генерации вариантов ответов.
Он может снизить стоимость генерации вариантов доказательств.
Он может даже снизить стоимость формальной верификации.
Но он не снижает автоматически стоимость человеческого понимания.
Это создаёт новую иерархию дефицитных ресурсов:
Варианты ответов → дешевле
Формальные доказательства → дешевле
Отполированные статьи → дешевле

Экспертное рецензирование → всё ещё дорого
Интерпретация → всё ещё дорога
Научное суждение → всё ещё дорого
Человеческое понимание → всё ещё дорого
Опасность заключается не просто в том, что ИИ становится лучше в математике.
Опасность в том, что общество примет механически верифицированный результат за полностью понятое знание.
Возможность состоит в том, что люди смогут перенаправить усилия на части науки, которые остаются наиболее трудными для автоматизации: выбор целей, построение объяснений, проектирование лучших вопросов, интерпретацию результатов и соединение формальной истины с реальным миром.
OpenAI опубликовала созданное ИИ решение в сентябре 2026 года, демонстрирующее образование сингулярности за конечное время, и выпустила формализацию в Lean. Институт математики Клэя заявляет, что задача, по-видимому, решена, но его официальный процесс оценки и распределения заслуг намеренно идёт без спешки.
Нет. OpenAI прямо заявила, что не намерена претендовать на приз. Институт математики Клэя ещё не завершил официальный процесс признания.
Публичный математический репозиторий OpenAI содержит 722 рукописи, организованные в 372 связанных семейства результатов. Компания утверждает, что выпуск стал результатом более широкой оценки, охватившей примерно 4 000 задач, поэтому «722 рукописи» не следует путать с 722 полностью несвязанными прорывами.
В Bloomberg Odd Lots Соломон сказал, что статью чрезвычайно трудно читать и что он не смог продвинуться дальше первых нескольких страниц. Он описал доказательство как крайне техническое и, вероятно, корректное, но не особенно изящное.
Math 2.0 — это концепция Тао для математики в эпоху изобилия доказательств, создаваемых ИИ. Он считает, что дисциплина должна сильнее акцентировать человеческое понимание, объяснение, эксперименты, формальные библиотеки и продуктивное применение ИИ, а не слепо оптимизироваться под знаменитые открытые задачи.
Нет. Lean может проверить, действительно ли формальное доказательство в своей формальной системе, но это не создаёт автоматически понятное человеку объяснение, не устанавливает научную значимость и не показывает, как идеи безопасно переносятся в практические приложения.
Нет. Официальный ретроспективный отчёт ICLR за 2026 год указывает 19 525 действительных заявок. Цифра около 60 000, распространявшаяся в конце 2026 года, происходит из регистраций ICLR 2027 или оценок на основе идентификаторов заявок OpenReview и не должна считаться окончательным числом действительных статей.
Потому что математика учит не только производству ответов. Постановка проблем, понимание моделей, логическое суждение, верификация и способность задавать хорошие вопросы остаются ключевыми, даже когда ИИ способен быстро генерировать доказательства.
Результат OpenAI по Навье—Стоксу показывает, как быстро меняется математика с участием ИИ. Доказательство имеет формализацию в Lean и было осторожно позитивно воспринято Институтом математики Клэя, однако его техническая плотность также иллюстрирует новую проблему: математическая корректность может появляться быстрее, чем широкое человеческое понимание.
Опасение Джастина Соломона не в том, что ИИ сделал математику бесполезной. Оно в том, что исследовательские системы, построенные для мира дефицитных доказательств и дефицитных статей, могут испытывать трудности, когда машины способны создавать и то, и другое в огромном масштабе. Теренс Тао описывает тот же переход как движение от дефицита доказательств к их изобилию.
Поэтому важнейшее узкое место может сместиться от производства ответов к их оценке, объяснению, связыванию и пониманию.
Когда доказательства становятся изобильными, человеческое понимание — а не генерация доказательств — может стать самым дефицитным ресурсом в математике.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



