Объём поиска по ключевым словам отвечает на вопрос «сколько людей ищут эту группу слов», но не отвечает на вопрос «что ещё этот человек спросит перед принятием решения». AI-поиск превращает последнее в решающую переменную: когда пользователь задаёт в ChatGPT, Perplexity, Gemini или Google AI Mode вопрос с ограничениями, движок сам генерирует несколько подзапросов для поиска, а затем собирает найденные фрагменты в ответ с цитатами. То, будете ли вы процитированы, зависит уже не только от того, попали ли вы в выдачу по какому-то слову, а от того, есть ли на странице фрагмент, который можно извлечь отдельно и который точно отвечает на один из подзапросов.
Поэтому более точная формулировка: объём поиска остаётся полезным сигналом масштаба спроса, но это отправная метрика, а не конечная. Исследование ключевых слов должно добавить три вещи — полную цепочку вопросов за этим спросом, поисковую форму каждого вопроса и наличие на странице извлекаемых блоков ответов.
Почему ориентация только на объём поиска упускает реальные покупательские намерения
Традиционный процесс — «основное ключевое слово → связанные слова → контент» — предполагает, что каждый поиск представляет собой независимый запрос с фиксированной словоформой. Поведение пользователей изменилось: один реальный вопрос часто одновременно содержит бюджет, сценарий, совместимость и способ использования, например «ноутбук до пятнадцати тысяч, для монтажа видео, с хорошей автономностью, удобный в командировках». В AI-поиске эти условия разбиваются на разные ветки и ищутся отдельно.
Возьмём B2B-закупки: за запросом «best CRM software» обычно стоит серия последовательных уточнений: какая подходит для малого бизнеса? Поддерживает ли автоматизацию почты? Интегрируется ли с Shopify? У какого самая низкая месячная плата? Поисковая ценность этих четырёх вопросов может быть выше, чем у исходного слова, но месячный объём поиска у них часто близок к нулю — мало кто вводит целый вопрос в поисковую строку, но именно так люди спрашивают AI.
Отсюда два пробела. Во-первых, низкий объём поиска не равен низкой коммерческой ценности. Во-вторых, объём поиска ничего не говорит о форме ответа: он не подскажет, что для сравнительного запроса нужна таблица, для процессного — нумерованные шаги, для определительного — самостоятельное объяснение в тридцать-пятьдесят слов. А именно эти формы определяют, будет ли контент найден.
Что такое Query Fan-Out (разветвление запросов)
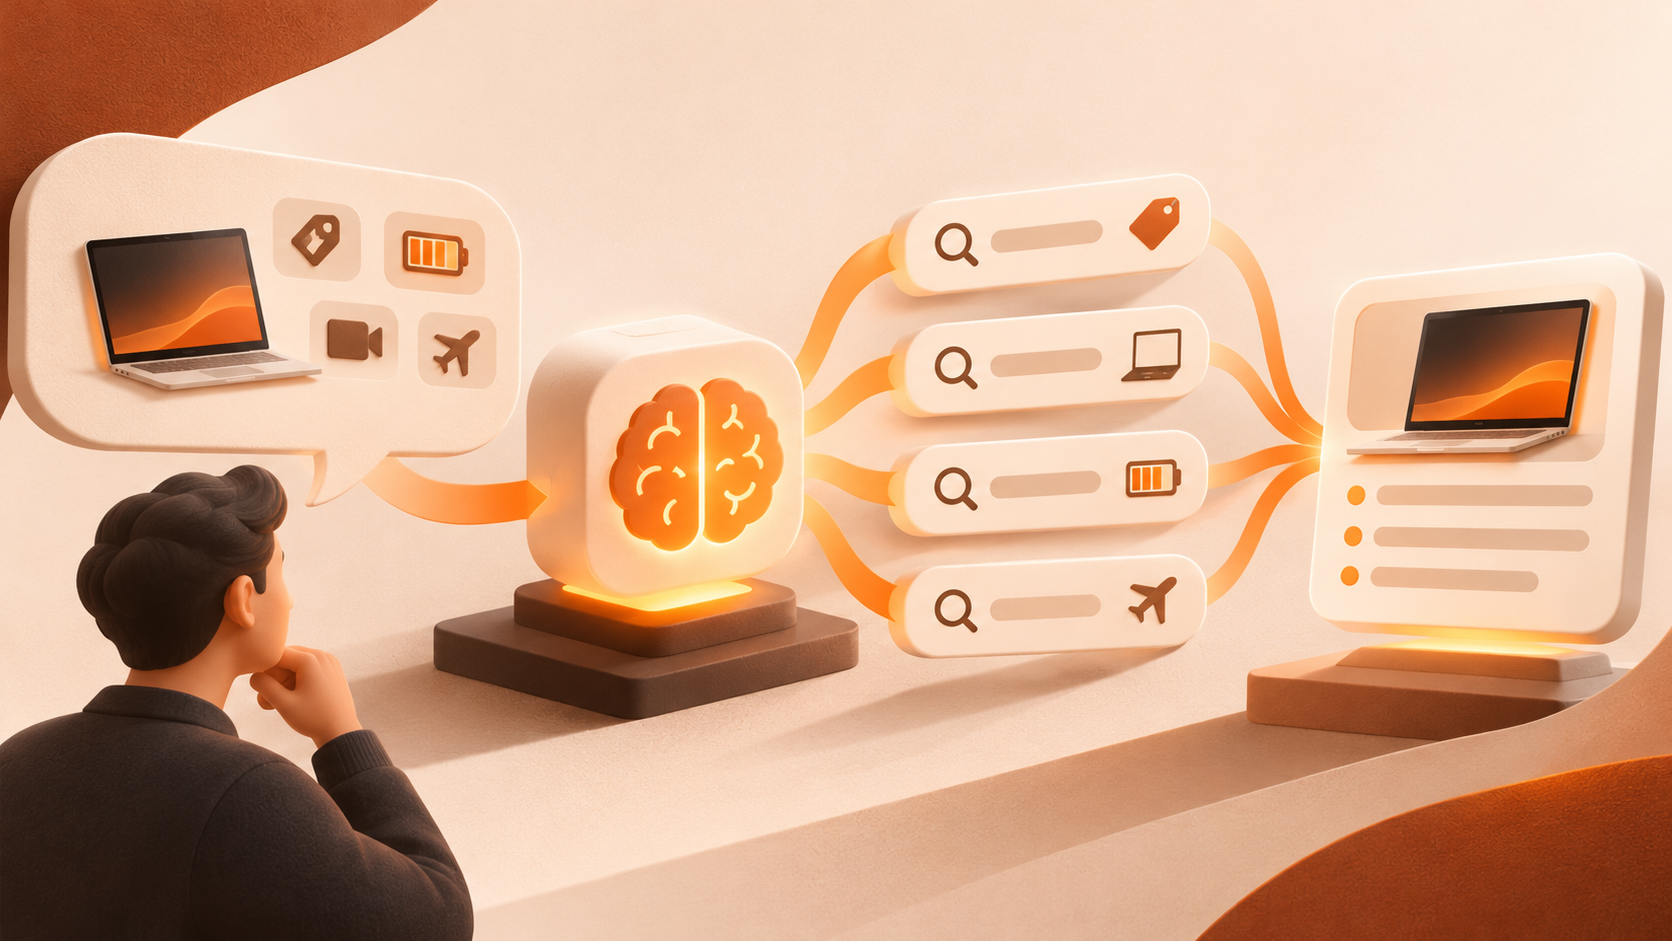
Query Fan-Out означает, что AI-поисковик разбивает один вопрос на несколько подзапросов, сгенерированных самой моделью, параллельно ищет по ним, оценивает возвращённые фрагменты и синтезирует ответ с цитатами. Google в документации по AI-функциям указывает, что такие функции, как AI Mode и AI Overviews, могут использовать эту технологию, чтобы показывать «более широкий и разнообразный набор полезных ссылок», чем обычная страница результатов (Google Search Central).
С инженерной точки зрения обычно выделяют пять шагов: определение намерения и сложности, генерация подзапросов, фильтрация сильно дублирующихся подзапросов, параллельный поиск, синтез ответа с цитатами. Третий шаг чаще всего упускают: система предпочитает охват, а не повторение, поэтому две близкие по содержанию страницы обычно не попадают в поиск одновременно.
По масштабу публичные наблюдения примерно таковы: один запрос в AI Mode порождает около 8–12 параллельных подзапросов (на практике часто 3–8); ChatGPT в среднем делает 4,7 подзапроса за один поиск в интернете; «сотни поисков» относятся только к многораундовым пайплайнам вроде Deep Search с лимитом около 20 раундов. Важнее форма подзапросов — обратный анализ показывает, что их средняя длина составляет 70–80 слов, а сложность примерно в 17–26 раз выше, чем у традиционного ключевого слова из трёх-четырёх слов (MaximusLabs). Движок ищет не по вашему ключевому слову, а по полному описанию с контекстом и сценарием использования.
Разветвление происходит не всегда. Соответствующие патенты связывают генерацию подзапросов с длиной ввода, частотой запросов, качеством результатов, количеством токенов и нагрузкой на сервер. Для коротких навигационных или простых фактических вопросов часто выполняется один поиск, близкий к исходному запросу; для длинных сравнительных и оценочных вопросов раскрывается самое большое дерево веток. Поэтому бюджет следует в первую очередь направлять на сложные коммерческие вопросы.
Поисковое намерение превращается из «одного слова» в «цепочку вопросов»
Четыре типа намерений — навигационное, информационное, коммерческое исследование и транзакционное — по-прежнему актуальны, но в AI-поиске одно основное намерение порождает несколько уровней поднамерений. Возьмём «How do I choose the best SEO tool for my business?»: основное намерение — выбрать инструмент, а поднамерения включают: какой тип инструмента мне нужен? какой бюджет? какие функции ключевые? нужны ли технические SEO-возможности? что подходит новичку, а что агентству?
Здесь важно различать два часто смешиваемых понятия: кластеризация ключевых слов группирует похожие слова по намерению, семантике и пересечению выдачи и решает, как организовать контент; Query Fan-Out описывает, как один вопрос распадается на несколько поисковых путей, включая темы, которые пользователь никогда не упоминал, и решает, как происходит поиск (SEO for Today). Первое — редакционный метод, второе — инженерный механизм, они не заменяют друг друга.
Таблица: восемь типов подзапросов и необходимые им форматы контента
После классификации веток разветвления один вопрос обычно порождает восемь типов подзапросов, каждому из которых нужен свой формат фрагмента. Эту таблицу можно использовать как чек-лист для самопроверки контента:
| Тип подзапроса | Пример | Необходимый формат контента |
|---|---|---|
| Точное совпадение | best CRM software | Блок ответа с прямым перечислением вариантов |
| Семантический вариант | top CRM platforms | Пересказ того же ответа другими словами покупателя |
| Навигационный | страница цен определённого вендора | Индексируемая, структурированная страница продукта или цен |
| Сравнительный | A vs B for small business | Строка таблицы с явными атрибутами |
| Определительный | what is pipeline attribution | Самостоятельное краткое определение в 30–50 слов |
| Процессный | how to migrate CRM data | Нумерованные шаги, одно действие на шаг |
| Рейтинговый | CRM tools for agencies | Легко просматриваемый список с условиями фильтрации |
| Сценарный | CRM for a 3-person team | Уточняющее предложение с указанием размера команды и сценария использования |
Чисто прозаическая страница обычно покрывает лишь два-три типа из восьми: без таблицы сравнительной ветке нечего извлечь; без нумерованных шагов процессная ветка проваливается; если никогда не указывался размер команды, сценарная ветка не совпадает. Формат здесь — не типографское предпочтение, а сама извлекаемость.
От одного ключевого слова к полной цепочке вопросов: пять шагов
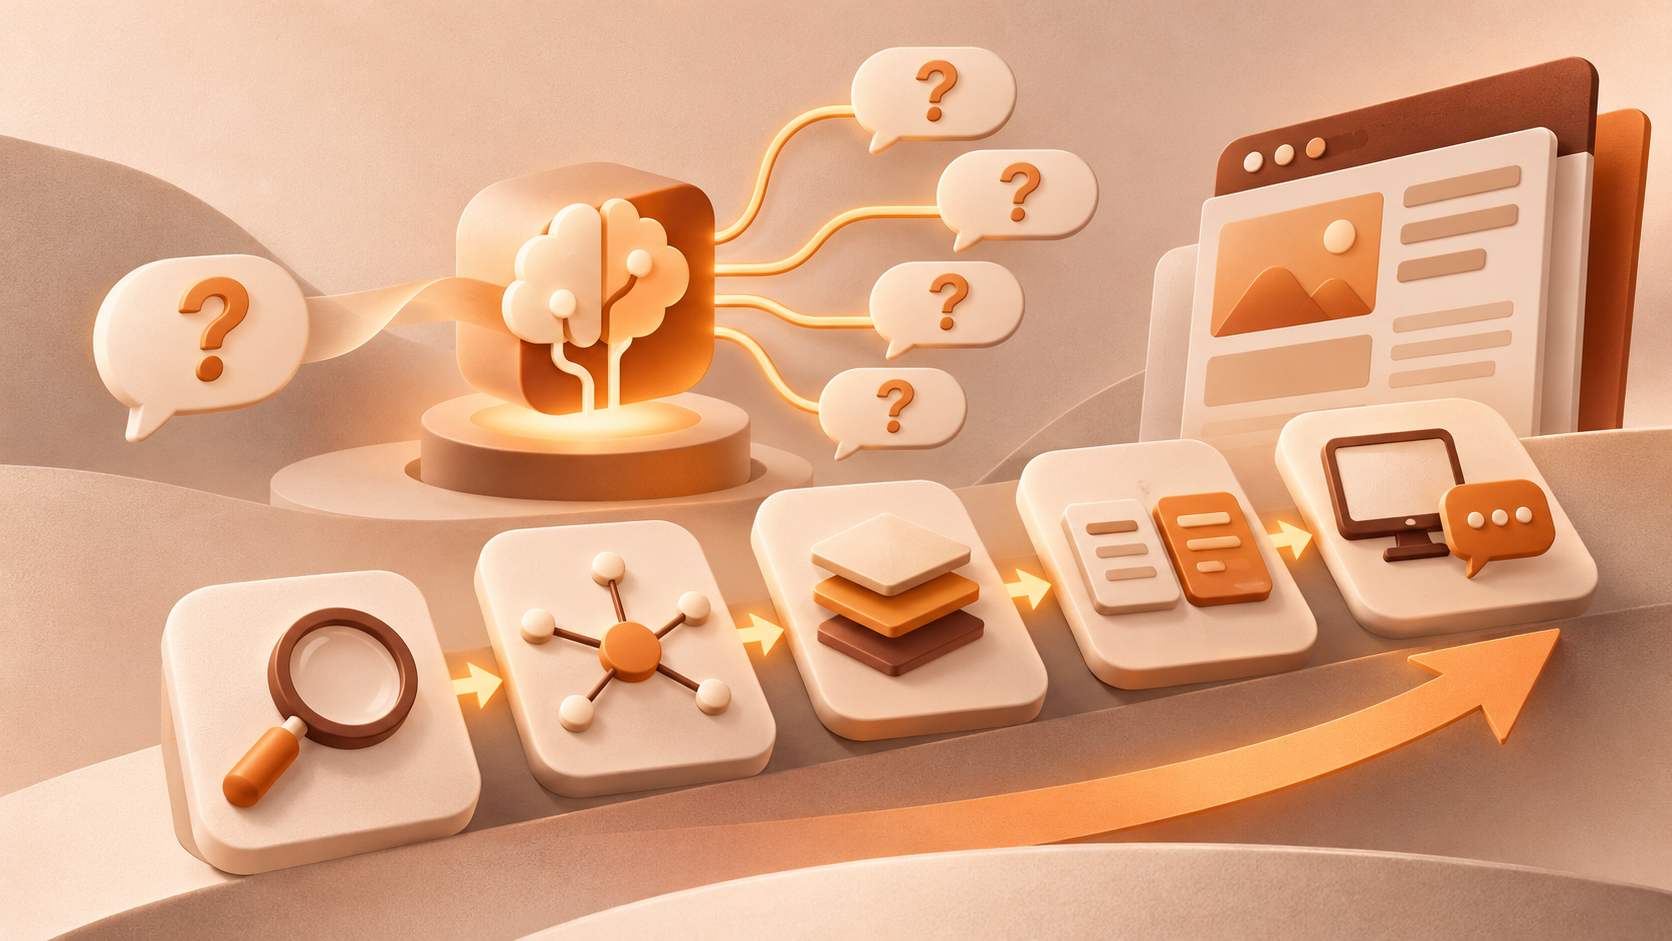
Шаг первый: составьте список seed-подсказок, а не ключевых слов. Соберите 10–20 вопросов, которые идеальный клиент действительно задаёт перед записью на демо, чем разговорнее, тем лучше.
Шаг второй: прогoните каждую seed-подсказку через Perplexity. Его интерфейс показывает фактически выполненные поиски — одно из немногих мест, где сегодня можно наблюдать поведение разветвления.
Шаг третий: запишите по порядку 5–8 связанных вопросов, которые он выводит, сохраняя исходные формулировки, не переписывая их в ключевые слова.
Шаг четвёртый: перекрёстно сверьте ту же группу seed-подсказок с помощью вопросных инструментов вроде AlsoAsked, чтобы добавить пропущенные ветки.
Шаг пятый: сопоставьте выжившие подвопросы с H2 и H3 на существующих страницах. Принцип — «один кластер вопросов — одна страница», а не «один подзапрос — одна страница»: создание отдельной тонкой страницы под каждый подзапрос размывает авторитетность и приближается к границе политики Google в отношении масштабного злоупотребления контентом (MaximusLabs).
Нужно чётко понимать: реальное дерево веток диалогично и персонализировано, снаружи его невозможно полностью воспроизвести. Цепочка вопросов — это реконструированное приближение, подходящее для планирования охвата, но не как точные данные для внешней отчётности.
Создайте сайт-витрину и привлекайте лиды за минуты
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Контентные кластеры: превращаем цепочку вопросов в трёхуровневую структуру
На практике можно выделить три уровня: опорная страница отвечает на «полную рамку того, как принимать это решение»; подстраницы принимают подвопросы с самостоятельным поисковым спросом, например сравнение определённого класса решений или структура цен в отрасли; блок FAQ принимает второстепенные вопросы, например совместимость, возврат средств, минимальные требования.
Чтобы решить, нужна ли подвопросу отдельная страница, используйте три проверки: задают ли его отдельно в реальном диалоге? не может ли опорная страница справиться с задачей ответа, не уходя в сторону? можете ли вы одной фразой объяснить, чем она не пересекается с одноуровневыми страницами? Только если все три ответа «да», создавайте новую страницу.
При этом нужно осознавать разницу приоритетов на нижней части воронки. Разветвление покупательских вопросов обычно сосредоточено на цене, тарифах, бесплатном лимите, политике возврата и сравнении с конкурентами, поэтому страницы сравнения и цен легче попадают в путь покупки, чем страницы определений; определительные вопросы часто движок отвечает сам, и победа в них даёт лишь упоминание.
Как должны разделять обязанности FAQ и страницы продукта
Они выполняют разные поисковые задачи, и смешение ухудшает обе. Цель страницы продукта — ясно объяснить «подходит ли мне это»: кому подходит, какие возможности включает, где границы, какова структура цен, как начать. На ней следует явно указывать размер команды, сценарии использования, интеграции и ограничения, поскольку именно эти уточняющие сведения используются сценарными подзапросами для сопоставления.
Цель FAQ — устранить трение при принятии решения, ответив на второстепенные вопросы, которые не входят в основную линию, но которые пользователь обязательно задаст. Каждый ответ должен быть самостоятельным вне контекста: замените местоимения на названия сущностей, сначала дайте вывод, затем условия, держите длину в пределах нескольких десятков слов.
Порядок структуры внутри страницы также влияет на поисковое решение. В наблюдениях за режимом цитирования около 44% доли цитирований сосредоточено в первых 30% основного текста, затем постепенно снижается (MaximusLabs). Поэтому самые коммерческие ответы должны появляться в первой трети страницы, а не оставаться на конец.
Можно ли одновременно охватить поисковые системы и диалоговый поиск
В большинстве случаев да, пересечение больше, чем кажется. Предпочтения нескольких основных входных точек не конфликтуют: AI Mode ценит охват подтем и ясность фрагментов; ChatGPT — самодостаточные блоки вопросов-ответов и сигналы экспертности; Perplexity — актуальность и прозрачность источников; режим исследования Claude — глубину и методологию. Их пересечение — ответ в начале, видимые источники, простой язык, реальная глубина основного текста.
Стоит отметить одно направленное изменение: в публичных наблюдениях зависимость цитирований AI Overview от топ-10 органических результатов снизилась примерно с 76% до 38%, а значительная доля цитирований приходится на позиции за пределами топ-100 (MaximusLabs). Это означает не «ранжирование бесполезно», а «ранжирование больше не единственный порог для цитирования» — вес извлекаемости фрагмента и способности напрямую ответить на вопрос заметно вырос.
Базовые вещи по-прежнему нужны: техническая индексируемость, структура контента, внутренние ссылки и структурированные данные остаются предпосылкой для попадания в AI-поиск (Google Search Central).
Что делать компаниям сейчас: чек-лист из шести пунктов
| Приоритет | Действие | Критерий завершения |
|---|---|---|
| 1 | Заменить список ключевых слов 10–20 реальными вопросами клиентов | Каждый — полный разговорный вопрос |
| 2 | Прогнать через Perplexity и записать последующие вопросы | Для каждой seed-подсказки записано минимум 5 веток |
| 3 | Провести самопроверку покрытия восьми типов подзапросов на ключевых коммерческих страницах | Покрыто минимум шесть из восьми типов |
| 4 | Добавить под каждый H2 самостоятельный блок ответа | Местоимения заменены на сущности, сначала вывод, затем условия |
| 5 | Перенести самые коммерческие блоки в первую треть | Появляются в пределах одного экрана после первого |
| 6 | Закрепить за каждым кластером вопросов единственную страницу-владельца | Нет двух страниц, отвечающих на один вопрос |
При этом сохраняйте часть оценки по объёму поиска: это по-прежнему недорогой сигнал для оценки масштаба спроса, расстановки приоритетов и определения сезонности. Действительно стоит отказаться от однолинейного правила «высокий объём — пишем, низкий — не пишем».
Как we0 поддерживает эту цепочку
Чтобы цепочка вопросов стала контентным активом, она в конечном счёте должна воплотиться на сайте: структура страниц, блоки FAQ, сравнительные таблицы, структурированные данные, многоязычные версии и ритм последующих обновлений. Подход we0.ai — объединить создание сайта и контентный рост в одном рабочем пространстве: опишите задачу на естественном языке, несколько агентов совместно сгенерируют работающую страницу, после настройки на визуальном холсте разверните её на собственном домене, затем поддерживайте контент через CMS и настраивайте SEO и GEO на стороне сайта (we0.ai).
Для команд, которым нужно быстро проверять кластеры вопросов, ценность такой интеграции не в том, «как быстро генерируется», а в том, что от одной формулировки задачи до публикации страницы и проверки охвата по цепочке вопросов не нужно переносить контент и тексты между тремя-четырьмя инструментами.
FAQ
Вопрос: нужно ли по-прежнему смотреть объём поиска по ключевым словам?
Да, но для оценки масштаба спроса и приоритета, а не как единственную основу для выбора темы. Объём поиска не отражает ветки подзапросов, форматы ответов и уровни намерений — эти три вещи нужно восполнять исследованием цепочек вопросов.
Вопрос: Query Fan-Out и кластеризация ключевых слов — это одно и то же?
Нет. Кластеризация ключевых слов группирует похожие слова по намерению и семантике и используется для организации контента; разветвление запросов — это механизм, при котором движок разбивает один вопрос на несколько подзапросов и ищет параллельно, и используется для объяснения поискового поведения.
Вопрос: как определить, может ли моя страница быть процитирована?
Начните с извлекаемости: есть ли в каждом разделе самостоятельный блок ответа, указаны ли сущности и сценарии применения, есть ли таблицы или шаги, видны ли источники. Всё это можно проверить вручную, не полагаясь на сторонние оценки.
Вопрос: что делать небольшой команде без бюджета на полное исследование?
Сначала минимальный цикл: выберите 10 реальных вопросов клиентов, прогоните диалоговый поиск и запишите ветки, дополните ключевые коммерческие страницы таблицами, шагами и блоками ответов, повторяйте ежеквартально с отметкой даты, чтобы отличать изменения результатов из-за правок контента от обновлений движка.
Related Tools
- Документация Google Search Central по AI-функциям: подтверждение официальных формулировок и базовых требований.
- Perplexity: в интерфейсе виден процесс поиска, подходит для наблюдения за разветвлением.
- AlsoAsked: получение кластеров вопросов по ключевому слову, восполнение пропущенных веток.
- we0.ai: интегрированное рабочее пространство от создания сайта до контентных операций и настроек SEO/GEO.
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
Объём поиска не утратил значения — он просто отошёл от роли «основы для выбора темы» к роли «справочника по масштабу спроса». Новая работа в исследовании ключевых слов заключается в том, чтобы расширить одно слово в полную цепочку вопросов, подготовить для каждого вопроса извлекаемый формат ответа и распределять страницы по кластерам вопросов, а не по отдельным словам. Это одновременно обслуживает традиционные результаты поиска и диалоговый поиск, который сам переписывает запросы. Критерий оценки также меняется: важно не то, сколько поисковых запросов у этого слова, а то, сможет ли ваш сайт остаться тем самым ответом, который процитируют, когда пользователь дойдёт до четвёртого, пятого вопроса подряд.