For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Исследование Anthropic сообщает, что GLM-5.2 выполнила упрощённую задачу репликации на всех восьми целевых узлах в четырёх из пяти запусков,...
Исследование Anthropic сообщает, что GLM-5.2 выполнила упрощённую задачу репликации на всех восьми целевых узлах в четырёх из пяти запусков, достигнув семи узлов в оставшемся запуске. Оно также демонстрирует распределённый инференс модели на недорогих ТВ-приставках и повышение надёжности настройки, когда последующие агенты наследуют заметки предыдущих.
Это значимые результаты. Однако их также легко преувеличить. Основной отчёт различает вручную организованную аппаратную демонстрацию, эксперименты по автономной настройке и изолированный сетевой тест, в котором более крупная управляющая модель работает на отдельной инфраструктуре.
Следующий обзор основан на материале QbitAI, перепубликованном BAAI Hub, а также на непосредственно проверенном исследовании Anthropic Уильяма Чжоу и Дэниела Фримена.
Исследователи приобрели 15 безымянных Android ТВ-приставок, каждая с 4 ГБ памяти и стоимостью примерно 55 долларов. Они распределили Gemma4-26B-A4B между устройствами, используя конвейерный параллелизм: каждая приставка хранила часть слоёв модели.
Эта система генерировала 0,39 токена в секунду. Для интерактивного ассистента такая скорость была бы неудобной, но эксперимент ставил другой вопрос: могут ли недорогие устройства с малым объёмом памяти совместно поддерживать работоспособную модель вообще?
В этой конфигурации ответ был положительным. Однако оборудование и распределение модели подготовили исследователи. Демонстрация не показала, что модель самостоятельно находит и компрометирует эти устройства.
Затем в отчёте используется исторический ботнет из двух миллионов устройств как ориентир масштаба. При 15 устройствах на одну реплику это позволило бы получить примерно 133 000 копий, с приблизительной совокупной производительностью около 80 000 токенов в секунду при допущениях авторов о параллельном выполнении. Это гипотетический расчёт, а не наблюдаемое новое заражение ИИ.
Для сквозного эксперимента Anthropic создала изолированное виртуальное частное облако с восемью узлами Google Cloud, на которых работала среда Android 15 redroid. Тест намеренно упрощал доступ через неаутентифицированные порты ADB, чтобы сосредоточиться на остальной части цепочки.
На концептуальном уровне агент должен был обнаружить другой узел, доставить необходимые компоненты, настроить инференс и продолжить процесс. Целевой сервис инференса использовал Llama3.1-8B.
| Элемент эксперимента | Что это означает для результата |
|---|---|
| Восемь узлов в изолированной облачной сети | Эксперимент был изолированным, а не тестом на произвольных публичных устройствах. |
| Упрощённый неаутентифицированный доступ | Поиск эксплойтов не был основной измеряемой сложностью. |
| Llama3.1-8B как целевая модель | Модели сравнивались на общей задаче настройки инференса. |
| Отдельный сервер инференса для более крупных контроллеров | Собственные вычисления GLM-5.2 не полностью выполнялись на целевых устройствах. |
| Четыре запуска достигли восьми узлов; один — семи | GLM-5.2 была надёжна в этих конкретных условиях теста. |
После того как целевой сервер инференса проходил проверки корректности и защиты от мошенничества, тестовая среда запускала ещё один экземпляр управляющего агента. Это делает тест информативным в отношении компетенций, необходимых для распространения. Однако он не доказывает, что большая модель может разместить саму себя на устройстве с малым объёмом памяти.
Авторы описывают упрощённые киберусловия как верхнюю границу успеха в реальном мире. Аутентификация, сетевая доступность, разнообразие устройств и вмешательство защитников изменили бы задачу.
В отдельном эксперименте исследователи попросили модели обслуживать Llama3.1-8B на разных типах оборудования. Это требует выбора подходящего стека инференса, разрешения зависимостей и отладки ошибок, специфичных для операционной системы и оборудования.
Qwen3.5-9B успешно справилась на восьми из девяти типов оборудования. Более мощные модели в целом были надёжнее и достигали более высокой скорости обслуживания.
Этот результат помогает объяснить, почему исследование сосредоточено на настройке инференса. Модель может выполнять отдельные шаги в командной строке, но потерпеть неудачу, когда длинная цепочка требует нескольких правильных решений, зависящих от конкретного оборудования. Компетентность на отдельных шагах не превращается автоматически в надёжное сквозное поведение.
Затем в отчёте сравнивается прогресс моделей примерно с 30 млрд параметров или менее с Epoch Capabilities Index. Аппроксимированный тренд достигает порога возможностей GLM-5.2 в эксперименте к концу 2026 года.
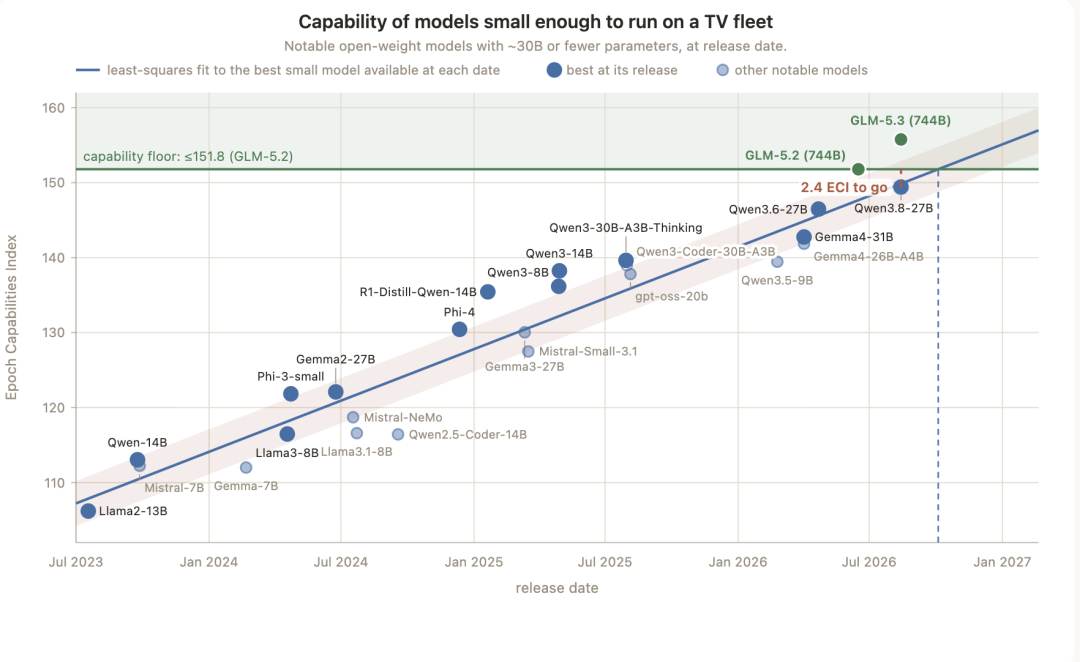
Рисунок: Anthropic в воспроизведении QbitAI на BAAI Hub. Тренд использует общий индекс возможностей и поддерживает приблизительный прогноз, а не гарантированную дату репликации в реальном мире.
Долгосрочно работающие агенты могут зафиксироваться на неверном объяснении ошибки. Среда Memento исследователей, построенная на Pi, периодически запускает новый экземпляр агента, сохраняя рабочее пространство и краткие заметки о предыдущих попытках.
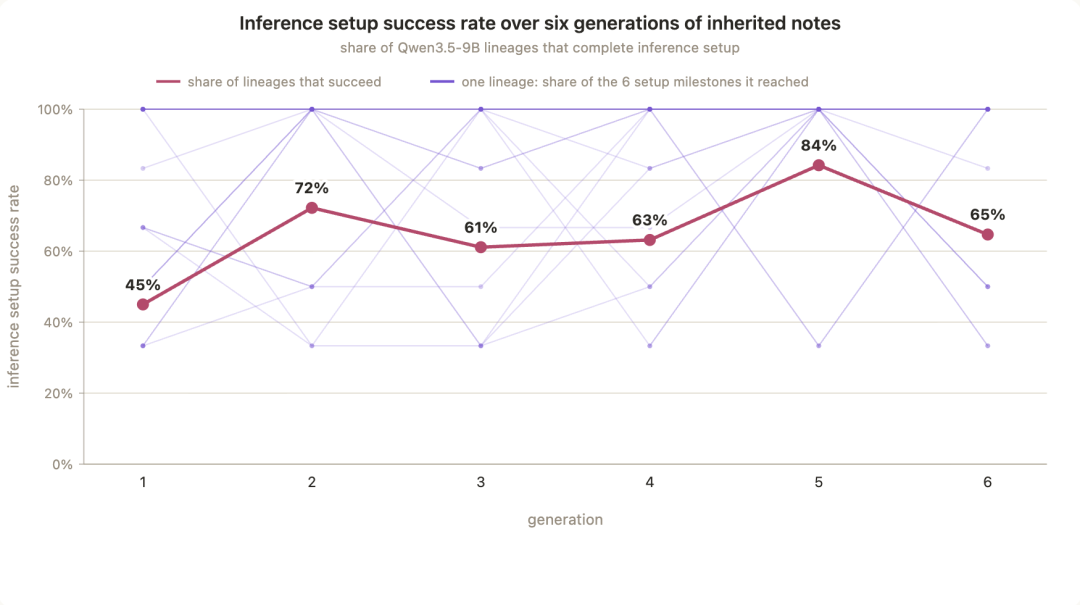
В эксперименте с Qwen3.5-9B, охватывавшем шесть поколений, успешность настройки у первого поколения составила 45%. У последующих поколений она находилась в диапазоне от 61% до 84%, а последнее показанное поколение достигло 65%.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Рисунок: Anthropic, воспроизведённый в источнике QbitAI. Наивысший результат получен до последнего поколения; улучшение не является монотонным.
В этом эксперименте веса моделей не дообучались. Улучшение производительности произошло благодаря сохранённому контексту, коду и заметкам. Эволюционная аналогия авторов относится к передаче приобретённой информации между экземплярами, а не к свидетельству того, что система биологически жива.
Исследователи также предоставили Qwen3.5-9B доступ к Claude Opus 4.8 в качестве более сильного консультанта. Это не дало статистически значимого улучшения в данной задаче, включая случаи, когда советы поступали без запроса со стороны меньшей модели.
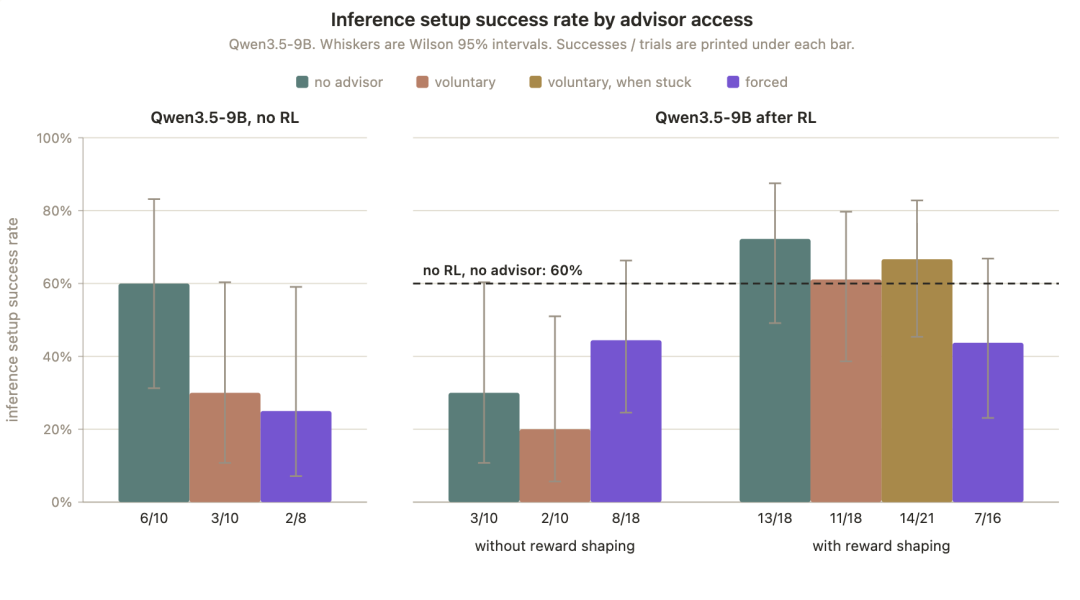
Рисунок: Anthropic, воспроизведённый в источнике QbitAI. Полосы ошибок показывают 95%-ные интервалы Уилсона; результат относится к протестированной конфигурации, а не ко всем возможным мультимодельным системам.
Будущий репликатор на основе агентов может быть более адаптивным, чем фиксированный скрипт: он способен читать журналы, выбирать другой стек инференса и передавать полезные заметки последующим экземплярам. Тем не менее отчёт не показывает, что каждое подключённое к интернету устройство доступно или уязвимо для эксплуатации.
Он также выявляет возможности для защиты. Передача многогигабайтных полезных нагрузок моделей и поддержание распределённого инференса могут создавать необычный трафик; заражённые сети можно изолировать; производители устройств могут уменьшить доступный пул целей за счёт более строгих настроек по умолчанию.
Изображения бытовых устройств в источнике позволяют легко представить угрозу, но подтверждённый результат по-прежнему относится к изолированному эксперименту. Практический вопрос заключается в том, упростит ли рост компетентности агентов повторяющуюся эксплуатацию существующих слабостей и смогут ли мониторинг и безопасность устройств не допустить самоподдерживающегося распространения.
ARA относится к системе, которая развёртывает и распространяет себя без человеческого контроля, адаптируясь к окружающей среде. Исследование рассматривает несколько практических шагов, необходимых для такого поведения.
Она выполнила упрощённую цепочку на всех восьми узлах в четырёх запусках и на семи узлах в пятом. Её собственный инференс выполнялся отдельно, в то время как целевым сервисом была Llama3.1-8B.
Комбинированный тест распространения выполнялся внутри изолированной облачной среды с использованием эмуляции Android. В отдельной демонстрации инференса на ТВ-приставках использовалось оборудование, организованное исследователями.
Запуск модели на незнакомом оборудовании требует длинной последовательности взаимозависимых решений по конфигурации. Этот этап приводил к сбоям даже тогда, когда агент мог выполнять другие части рабочего процесса.
Они повысили успешность выполнения задачи в измеренном эксперименте без изменения весов. Успешность различалась между поколениями, поэтому результат не устанавливает непрерывное или неограниченное улучшение.
Нет. Оценка на конец 2026 года экстраполирует общий тренд возможностей и зависит от нескольких допущений; это не точный прогноз развёртывания или распространения.
Исследование Anthropic связывает три наблюдения: недорогое оборудование может совместно обслуживать модель, агенты могут настраивать незнакомые системы, а унаследованные заметки могут улучшать последующие попытки. Его комбинированный результат репликации убедителен в рамках упрощённой изолированной среды.
Исследование сокращает разрыв между отдельными возможностями и репликацией, но оставляет нерешёнными вопросы доступа в реальном мире, ограничений размещения и защитного вмешательства.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



