For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoft переводит свою программу собственной ИИ-инфраструктуры в значительно более масштабную фазу развертывания.
Microsoft переводит свою программу собственной ИИ-инфраструктуры в значительно более масштабную фазу развертывания.
12 октября 2026 года компания сообщила, что планирует масштабировать семейство Azure Maia до многогигаваттных развертываний, начиная с 2027 года, при этом Maia должна стать основной системой инференса для продуктов и сервисов Microsoft.
Анонс связывает два поколения аппаратного обеспечения для ИИ, разработанного Microsoft.
Maia 200 уже находится в производственной эксплуатации и обслуживает нагрузки Microsoft. Maia 300, следующая система, должна начать производственное развертывание в 2027 году и специально спроектирована для рассуждений с длинным контекстом, чувствительных к задержкам диалогов и продолжительных многошаговых агентных нагрузок.
Главный аргумент Microsoft заключается в том, что эффективность инференса больше нельзя улучшать, рассматривая только чип.
Компания совместно проектирует:
как единую систему.
Именно этот системный подход Microsoft намерена масштабировать до многогигаваттного уровня.
Прежде чем перейти к Maia 300, Microsoft начинает свой анонс с текущего поколения.
Maia 200 больше не является только платформой разработки.
Microsoft сообщает, что система уже обслуживает производственные нагрузки, включая Microsoft Copilot, а также поддерживает команду Microsoft AI при разработке моделей следующего поколения.
Компания заявляет, что GitHub Copilot и Microsoft Foundry, как ожидается, последуют к концу 2026 года.
Для этих нагрузок Maia 200 может запускать:
Это важно, поскольку Microsoft не представляет Maia как кремний для одного проприетарного семейства моделей.
Архитектура предназначена для поддержки гетерогенного портфеля моделей внутри Azure и собственных сервисов Microsoft.
Microsoft эксплуатирует ИИ-продукты в огромном масштабе.
Это дает ее инфраструктурным командам прямое представление о том, где развернутые модели расходуют время, пропускную способность памяти, сетевую емкость и электроэнергию.
Вместо того чтобы сначала проектировать универсальный ускоритель, а затем решать, как приложения должны его использовать, Microsoft заявляет, что ее аппаратные и программные группы работают совместно за годы до развертывания.
Цель — предвидеть будущие требования моделей и переводить их в аппаратные решения, такие как:
Этот цикл обратной связи уже влияет на следующее поколение.
Microsoft сообщает, что Maia 200 развертывается в:
Для встроенных ИИ-возможностей в таких продуктах, как Microsoft Teams, Copilot и Cowork, Microsoft указывает, что Maia 200 может обеспечивать до 1,7× больше токенов на ватт, чем то, что компания называет ведущей инфраструктурой на базе GPU.
Это сравнение, заявленное Microsoft, а не независимый опубликованный бенчмарк на стандартизированных сторонних системах.
Формулировка имеет значение.
Это свидетельство внутреннего производственного опыта Microsoft, однако его не следует трактовать как универсальное преимущество в 1,7× для каждой модели, промпта, размера батча, целевого уровня задержки или развертывания GPU.
Microsoft сообщает, что производственный опыт Maia 200 напрямую повлиял на проектирование Maia 300.
Новая система предназначена для поддержки более широкого спектра нагрузок, включая:
Общим ограничением для этих нагрузок является инференс.
Они требуют, чтобы модели сохраняли отзывчивость при обработке более длинных контекстов, поддержании большего состояния и выполнении большего количества шагов.
Microsoft описывает Maia 300 как третье поколение своей программы Azure Maia.
Конструкция ориентирована прежде всего на инференс.
Это означает, что Microsoft оптимизирует систему под нагрузки, которые, по ее ожиданиям, будут доминировать в развернутых ИИ-системах, а не только под пропускную способность обучения.
К таким нагрузкам относятся:
Целевой метрикой все чаще становятся не только пиковые FLOPS.
Важно, сколько полезных токенов дата-центр может предоставить в рамках фиксированных ограничений по:
Microsoft заявляет, что Maia 300, как ожидается, обеспечит на 40% больше токенов на мегаватт, чем ведущие системы на базе GPU.
Этот показатель является ожиданием Microsoft относительно эффективности развертывания системы в целом, а не публичным независимым бенчмарком с полной межвендорной методологией тестирования.
В полной стойке с 96 ускорителями Microsoft также заявляет, что Maia 300 может обеспечивать до 7× большей стоечной пропускной способности по токенам, чем Maia 200.
Эти две цифры измеряют разные сравнения:
| Заявление | Сравнение |
|---|---|
| На 40% больше токенов на мегаватт | Maia 300 по сравнению с ведущими системами на базе GPU |
| До 7× стоечной пропускной способности по токенам | Полная стойка Maia 300 с 96 ускорителями по сравнению с Maia 200 |
Их не следует считать взаимозаменяемыми.
Одна из ключевых идей Maia 300 заключается в том, что перемещение данных стало серьезным узким местом.
Современные системы инференса многократно перемещают:
между вычислительными блоками, памятью и сетевыми соединениями.
Каждое перемещение требует задержек и энергии.
Ответ Microsoft — развитие Software Defined Locally Accessed Dataflow Architecture, или SDLA, представленной вместе с Maia 200.
Программное обеспечение управляет тем, где размещаются данные и когда они перемещаются между:
Maia 300 расширяет эту идею на многокристальную конструкцию.
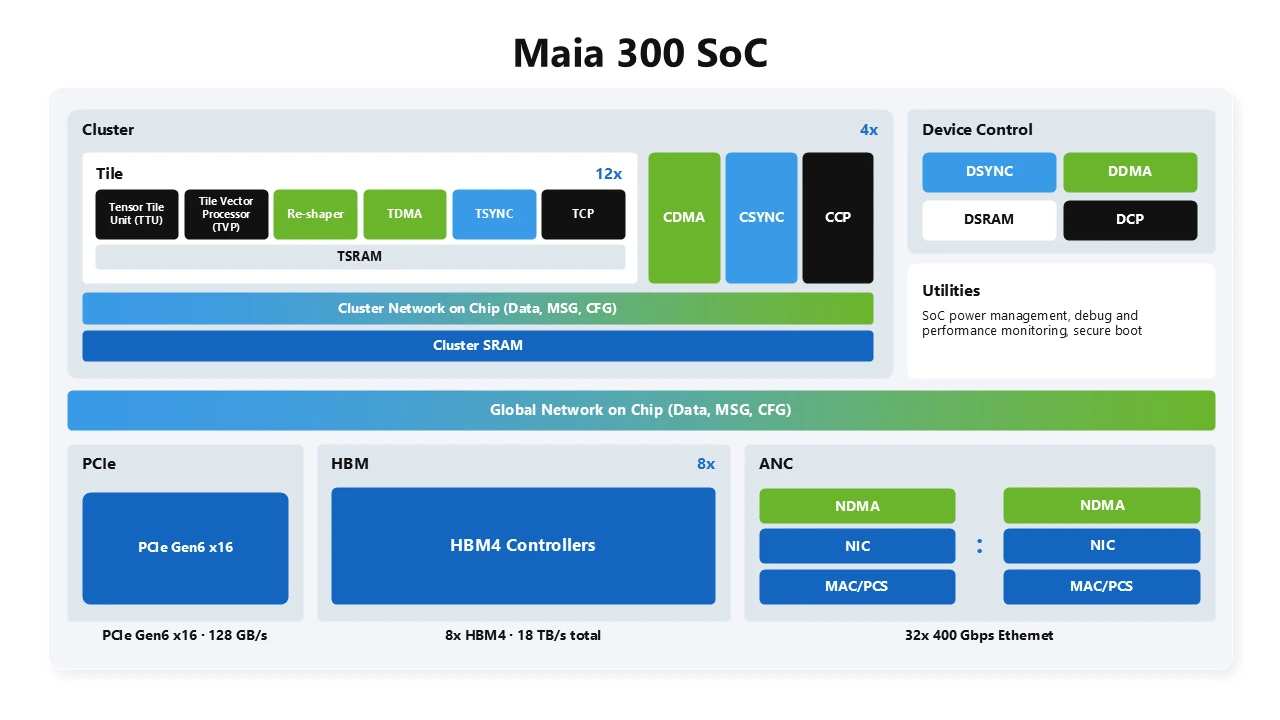
Maia 300 переходит от более однородной организации памяти к учитывающей локальность архитектуре неоднородной памяти между чиплетами.
Цель проста:
Хранить данные ближе к вычислениям, которые их используют
→ перемещать меньше байтов
→ снижать задержки и энергопотребление
→ повышать загрузку ресурсов
Архитектура возлагает на программное обеспечение более прямую ответственность за управление локальностью.
Это особенно важно для инференса с длинным контекстом и высокой нагрузкой на декодирование, где перемещение состояния модели и KV-кэша может доминировать в нагрузке.
Память — одно из крупнейших обновлений Maia 300.
Каждый ускоритель использует восемь стеков HBM4, обеспечивающих:
Microsoft заявляет, что это обеспечивает примерно:
Система также использует SRAM на кристалле как управляемую программным обеспечением рабочую область.
Это может снизить нагрузку на HBM, удерживая часто повторно используемые данные ближе к вычислительным блокам.
Для инференса это важно, поскольку многие нагрузки ограничены скоростью доставки состояния к вычислительным движкам, а не пиковой арифметической производительностью этих движков.
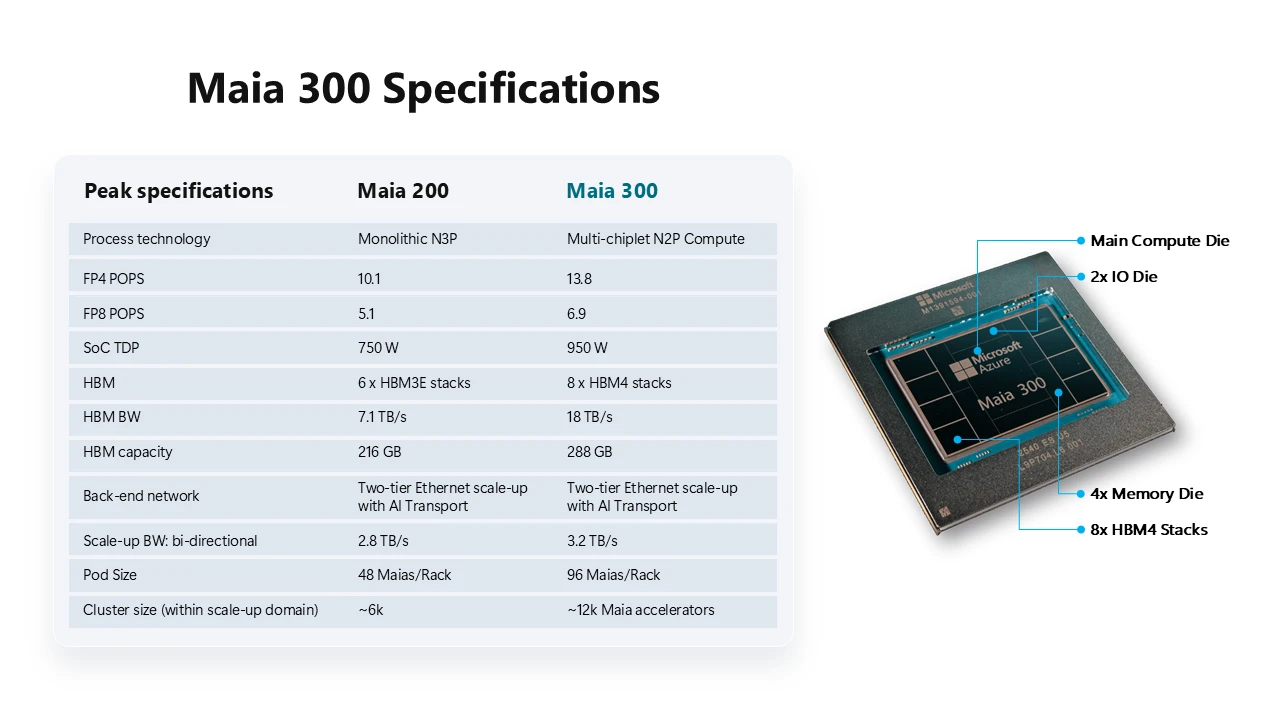
Maia 300 не является единым монолитным кристаллом в том же смысле, что Maia 200.
Microsoft разделяет ключевые функции между чиплетами.
Архитектура включает отдельные функции для:
Вычислительные чиплеты изготовлены по техпроцессу N2P компании TSMC.
Обоснование носит как экономический, так и технический характер.
Наиболее передовая технология производства может быть сосредоточена там, где она дает наибольшую выгоду по производительности на ватт, тогда как для других функций могут использоваться конструкции, оптимизированные для пропускной способности, связности или стоимости.
В техническом материале Microsoft по архитектуре говорится, что изменение способствует:
по сравнению с Maia 200.
Maia 300 также расширяет поддержку инференса с более низкой точностью.
В технических материалах по архитектуре Microsoft выделяет улучшенную поддержку MXFP4 и форматы хранения с точностью менее 3 бит.
Более низкая точность может уменьшить:
Преимущество заключается не только в меньших числах.
Если модель может сохранять требуемое качество при более низкой точности, инфраструктура может поддерживать:
Microsoft также заявляет, что векторный движок добавляет оптимизации на уровне инструкций для ядер инференса, таких как softmax и преобразование данных низкой точности.
В крупном масштабе ускорители полезны только при возможности эффективно обмениваться данными.
Maia 300 расширяет свою модель потоков данных на саму сеть.
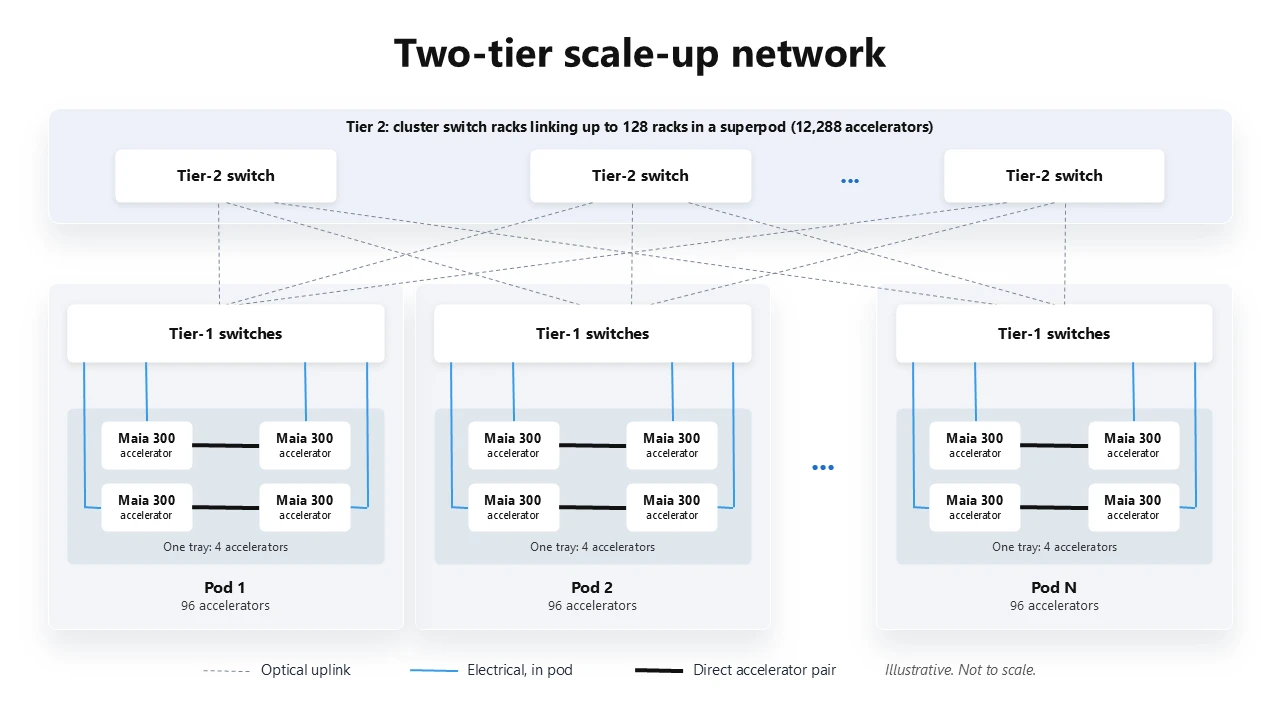
Microsoft использует собственный ИИ-транспорт поверх инфраструктуры на базе Ethernet и двухуровневую топологию масштабирования.
Одна стойка Maia 300 содержит:
96 ускорителей
Затем несколько стоек могут объединяться в суперпод.
Техническое описание архитектуры Microsoft указывает максимальный суперпод из:
128 стоек
12 288 ускорителей Maia 300
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Внутри стойки прямые соединения связывают пары ускорителей, а коммутируемые электрические пути объединяют полный под из 96 ускорителей.
Microsoft заявляет, что сохранение электрического масштабирования внутри стойки помогает снизить энергопотребление и стоимость.
Второй сетевой уровень использует оптическую связность для соединения стоек.
Это позволяет до 128 стойкам участвовать в одном домене масштабирования.
Заявленная цель Microsoft — избежать использования отдельных семантик коммуникации для каждой физической границы.
Одна и та же общая модель коммуникации охватывает:
Это дает планировщикам и программному обеспечению больше гибкости в размещении нагрузок с тензорным, конвейерным и экспертным параллелизмом.
Стойка Maia 300 — важная часть системного проектирования.
Каждая стойка содержит:
В сравнении архитектур Microsoft округляет общую емкость HBM до 27,7 ТБ в таблице стоек.
Разница объясняется простым округлением 96 × 288 ГБ.
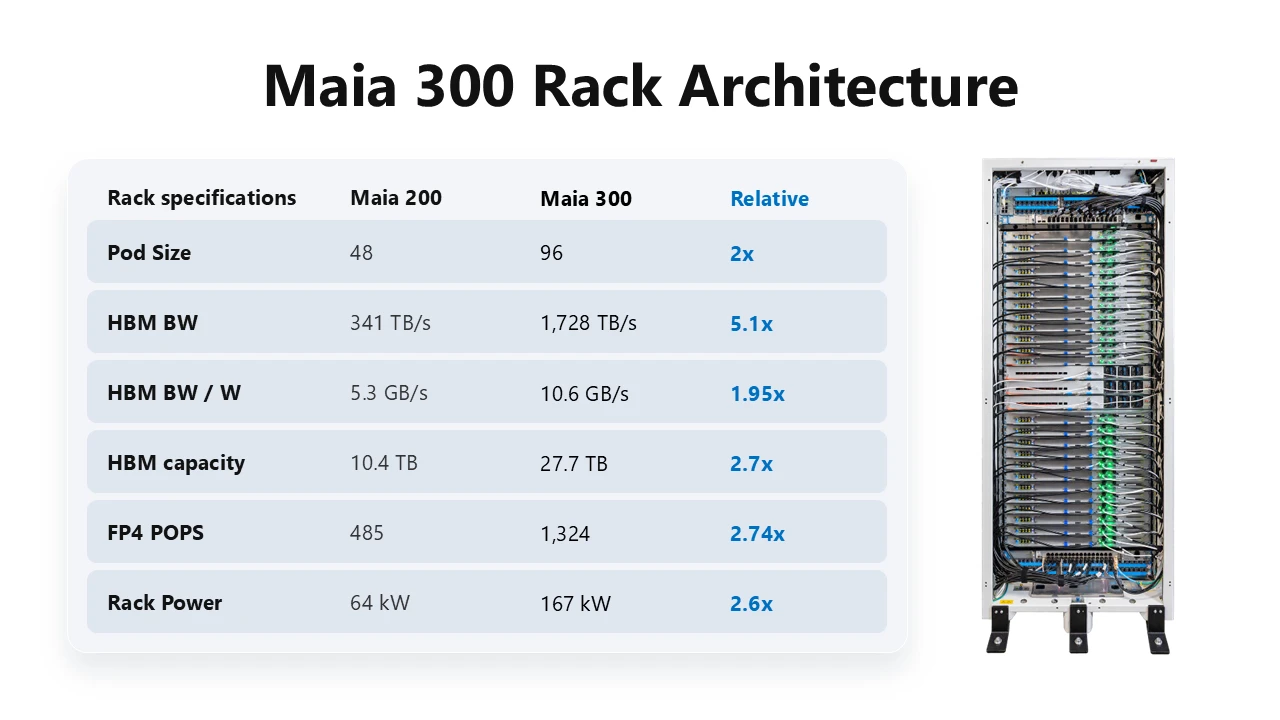
Плотность ускорителей вдвое выше, чем у Maia 200.
Microsoft интегрирует хостовые вычисления, память, хранилище, охлаждение и ускорители в каждый лоток, а не требует отдельных лотков для хостов.
Это освобождает пространство в стойке и позволяет управлять питанием и тепловыми режимами как единой системой.
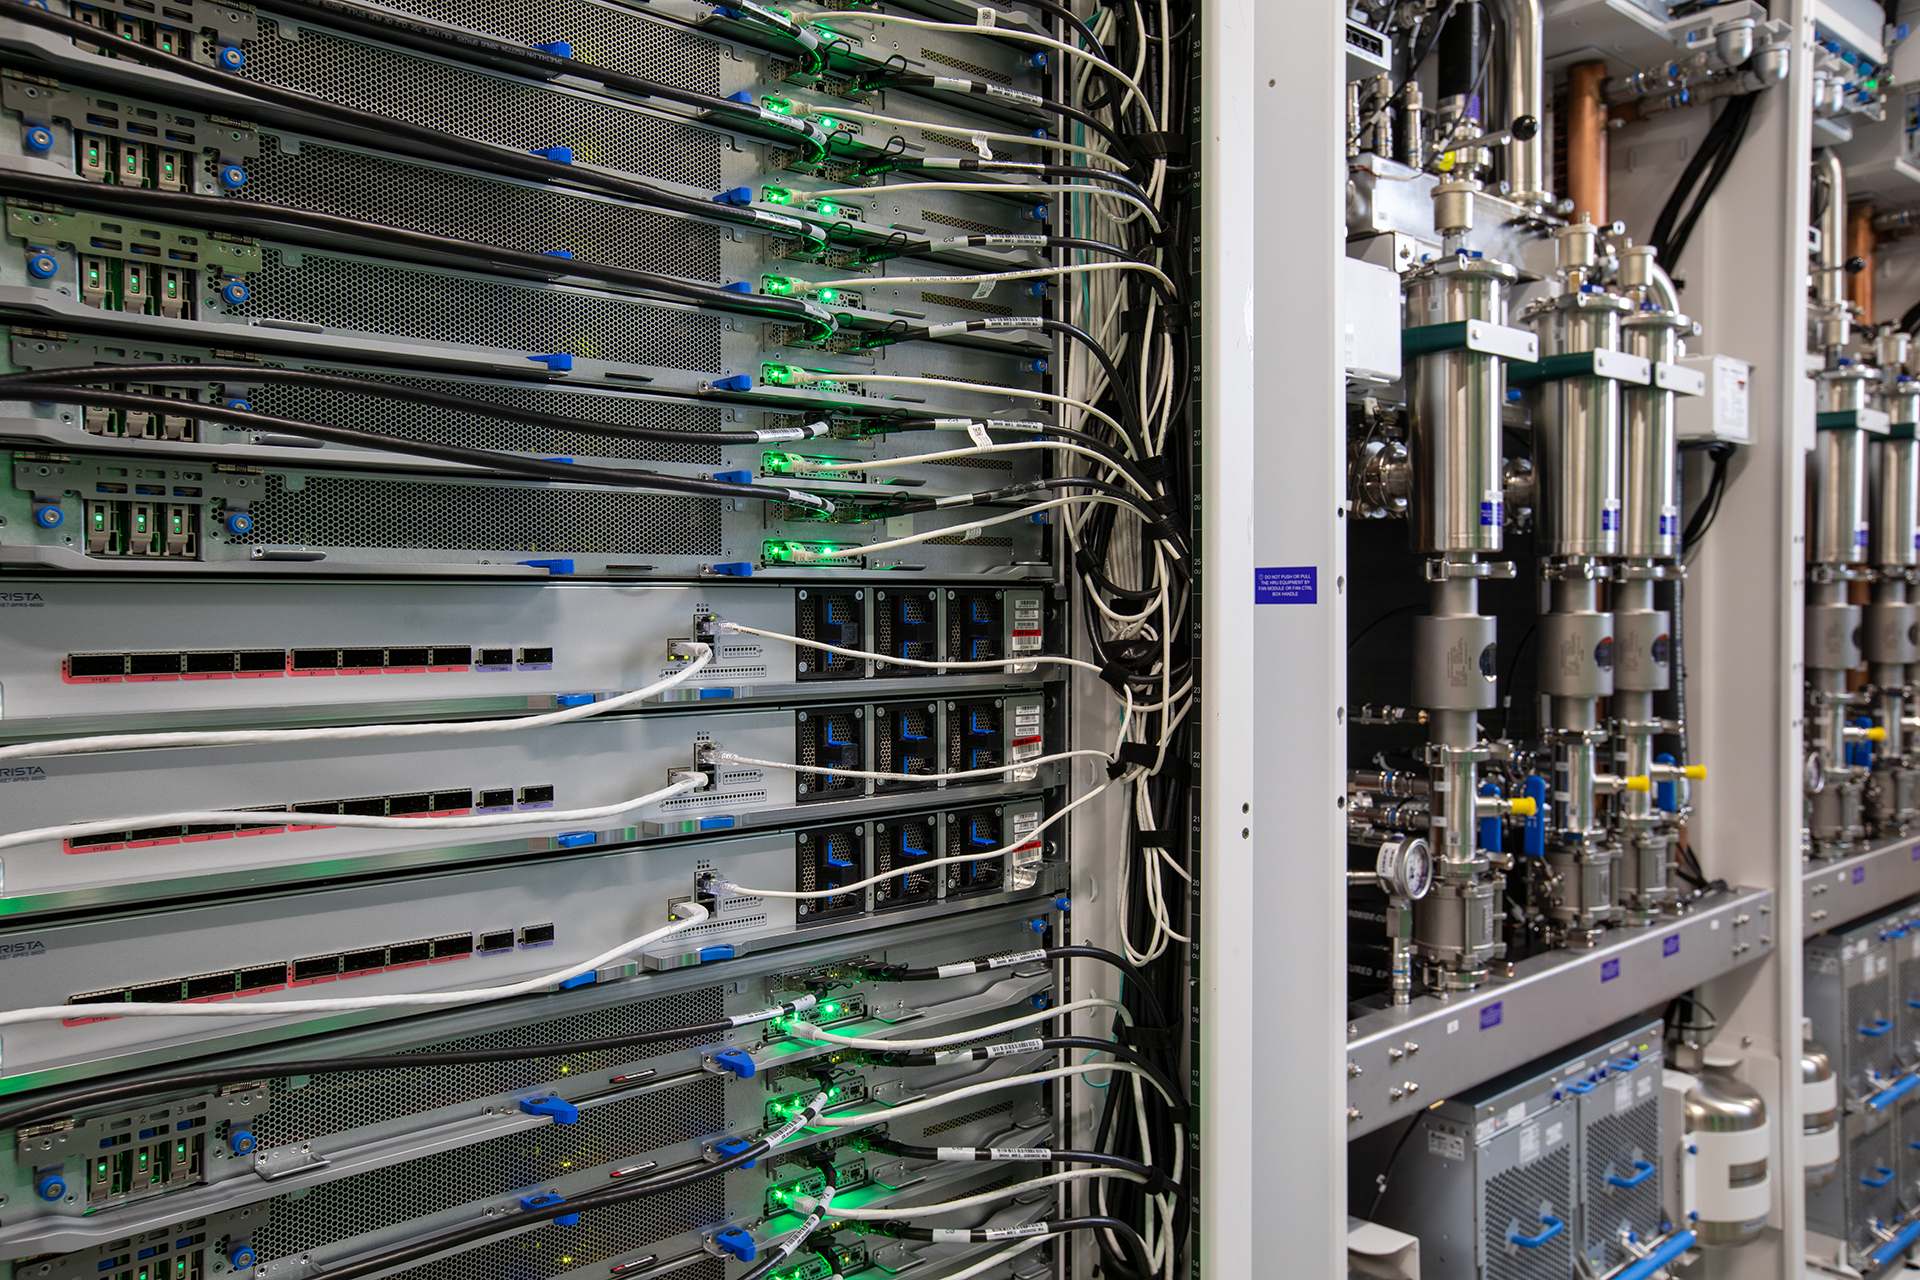
ИИ-стойка мощностью 167 кВт создает значительную задачу по управлению температурой.
Microsoft сообщает, что жидкостное охлаждение отводит более 80% тепловой нагрузки стойки от таких компонентов, как:
Воздушное охлаждение сохраняется для таких компонентов, как память, хранилище и другие вспомогательные системы.
Стойка может подключаться напрямую к технической воде объекта там, где такая инфраструктура существует.
Также она может использовать теплообменный блок в объектах, которые в остальном охлаждаются воздухом.
Эта гибкость важна для масштаба развертывания.
Microsoft не может расширять Maia только в дата-центрах, построенных под одну конкретную конфигурацию охлаждения.
Следующая таблица объединяет опубликованные Microsoft характеристики Maia 300 и их сравнение с Maia 200.
| Характеристика | Maia 200 | Maia 300 |
|---|---|---|
| Техпроцесс / подход к корпусированию | Монолитный N3P | Многокристальная архитектура, вычисления N2P |
| Пиковая производительность FP4 | 10,1 POPS | 13,8 POPS |
| Пиковая производительность FP8 | 5,1 POPS | 6,9 POPS |
| TDP SoC | 750 Вт | 950 Вт |
| HBM | 6 × HBM3E | 8 × HBM4 |
| Емкость HBM на ускоритель | 216 ГБ | 288 ГБ |
| Пропускная способность HBM на ускоритель | 7,1 ТБ/с | 18 ТБ/с |
| Двунаправленная пропускная способность масштабирования | 2,8 ТБ/с | 3,2 ТБ/с |
| Ускорителей на стойку | 48 | 96 |
| Примерная емкость HBM на стойку | 10,4 ТБ | 27,7 ТБ |
| Мощность стойки | 64 кВт | 167 кВт |
| Максимальный опубликованный домен масштабирования | ~6 тыс. ускорителей | ~12 тыс. ускорителей |
Это опубликованные Microsoft пиковые и системные характеристики.
Они не являются гарантиями производительности на уровне приложений.
Фактическая пропускная способность зависит от модели, точности, размера батча, целевого уровня задержки, стратегии параллелизма, программного стека и состава нагрузок.
Главная цифра — план Microsoft вывести Azure Maia на многогигаваттные развертывания, начиная с 2027 года.
Это заявление о масштабе инфраструктуры.
Microsoft не раскрыла точную общую величину в гигаваттах, график развертывания для каждого проекта или число ускорителей, связанное с этим заявлением.
Его также не следует трактовать как утверждение, что один дата-центр Maia 300 обязательно будет потреблять несколько гигаватт.
Программа гигаваттного масштаба может охватывать:
Анонс компании намеренно сосредоточен на системной стратегии, а не на плане строительства для каждого объекта.
ИИ-инфраструктура все сильнее ограничена объемом полезных вычислений, который можно разместить в рамках доступной мощности.
Дата-центр не может бесконечно добавлять ускорители, если не может также обеспечить:
Именно поэтому Microsoft акцентирует внимание на токенах на мегаватт.
Эта метрика связывает объем обслуживания моделей с дефицитным ресурсом, который все чаще определяет расширение дата-центров.
Чип, который работает быстрее, но потребляет пропорционально больше энергии, может не решить реальную задачу развертывания.
Цель состоит в том, чтобы генерировать больше полезного ИИ-результата в рамках той же инфраструктуры.
Анонс Microsoft выходит за рамки заявления о том, что Maia 300 будет еще одним вариантом ускорителя.
Компания утверждает, что по мере масштабирования развертывания семейство Maia станет ее основной системой инференса для продуктов и сервисов Microsoft.
Это делает Maia стратегически важной для всего стека Microsoft.
Компания называет или упоминает такие нагрузки, как:
Это не означает, что Microsoft отказывается от GPU или других ускорителей.
Microsoft явно описывает свою более широкую инфраструктуру как гетерогенную и разнообразную по моделям.
Программа Maia дает Microsoft еще один инфраструктурный вариант, который компания может тщательно оптимизировать под собственные паттерны сервисов.
В заключительном разделе своего анонса Microsoft помещает Maia в рамки того, что компания называет Frontier Transformation.
Идея состоит в том, что ИИ-инфраструктуру не следует оптимизировать как изолированные уровни.
Microsoft стремится связать:
Кремний
→ системы
→ дата-центры
→ обслуживание моделей
→ агенты
→ приложения
Поскольку Microsoft управляет всеми этими уровнями, компания может использовать производственную обратную связь от приложений для влияния на будущее аппаратное обеспечение.
Верно и обратное.
Новые аппаратные возможности могут определять, что будущие модели и агенты смогут экономически эффективно делать в крупном масштабе.
В этом состоит стратегическое назначение Maia.
Компания не пытается доказать, что один чип заменит каждый ускоритель.
Она создает вертикально совместно спроектированную платформу инференса, способную работать наряду с другим оборудованием в Azure.
Опубликованные характеристики Maia 300 существенны, однако большая часть ключевой системы все еще находится на стадии до производственного запуска.
Производственное развертывание начинается в 2027 году.
После выхода системы на реальные нагрузки будут важны несколько вопросов.
Microsoft ожидает на 40% больше токенов на мегаватт, чем у ведущих систем на базе GPU.
Практический вопрос будет заключаться в том, как этот результат сохранится для различных моделей и целевых уровней задержки.
Собственный кремний успешен только тогда, когда компилятор, ядра, наблюдаемость, инструменты развертывания и поддержка моделей достаточно зрелы для производственных команд.
Microsoft хочет, чтобы Maia поддерживала семейства OpenAI, MAI и моделей с открытым исходным кодом.
Важной проверкой станет производственная эффективность для гетерогенных архитектур.
Домен масштабирования из 12 288 ускорителей архитектурно значим.
Фактическая загрузка, восстановление после сбоев, планирование и межстоечная коммуникация определят, какая часть этого теоретического масштаба превратится в полезную емкость.
Производительность на ватт — только одна часть полной стоимости.
Операторов дата-центров также интересуют:
Преимущество Microsoft, если стратегия сработает, будет связано с оптимизацией всей системы, а не одного показателя бенчмарка.
Azure Maia 300 — это кастомная ИИ-система инференса Microsoft третьего поколения. Она объединяет многокристальный ускоритель, память HBM4, программно определяемый поток данных, собственную сеть масштабирования на базе Ethernet и архитектуру стойки с 96 ускорителями, разработанную для облачного ИИ-инференса в крупном масштабе.
Microsoft сообщает, что производственное развертывание начнется в 2027 году. Компания также планирует начать масштабирование семейства Maia до многогигаваттных развертываний в 2027 году.
Это означает, что Microsoft планирует инфраструктуру Maia с совокупной мощностью, измеряемой несколькими гигаваттами. Microsoft не опубликовала точную величину, число ускорителей или заявление о том, что один дата-центр будет потреблять несколько гигаватт, поэтому такие детали не следует выводить только из заголовка.
Каждый ускоритель Maia 300 имеет восемь стеков HBM4 емкостью 288 ГБ и пиковой пропускной способностью HBM 18 ТБ/с. Стойка с 96 ускорителями содержит в совокупности примерно 27,6–27,7 ТБ HBM.
Microsoft указывает энергетический бюджет 167 кВт для полной стойки Maia 300 с 96 ускорителями. Сам SoC ускорителя имеет TDP 950 Вт.
Microsoft ожидает, что Maia 300 обеспечит на 40% больше токенов на мегаватт, чем ведущие системы на базе GPU, однако компания не опубликовала полную независимую межвендорную методологию бенчмарка для этого заявления. Поэтому результат следует рассматривать как ожидание Microsoft по производительности системы в целом, а не как универсальный вывод бенчмарка.
Microsoft заявляет, что Maia станет ее основной системой инференса для продуктов и сервисов Microsoft, но также описывает Azure как открытую гетерогенную платформу с выбором моделей и кремния. Maia является частью более широкого инфраструктурного набора, а не доказательством того, что Azure будет использовать только кремний Microsoft.
Microsoft сообщает, что Maia 200 уже обслуживает Microsoft Copilot и поддерживает разработку моделей следующего поколения командой MAI. Ожидается, что GitHub Copilot и Microsoft Foundry последуют к концу 2026 года.
Microsoft превращает Azure Maia из программы кастомных ускорителей в крупномасштабную платформу инференса. Maia 200 уже выполняет производственные нагрузки, тогда как Maia 300 должна начать развертывание в 2027 году и разработана для инференса с длинным контекстом, высокой нагрузкой на декодирование и агентными сценариями.
Наиболее значительные изменения имеют системный характер: 288 ГБ HBM4 на ускоритель, пропускная способность памяти 18 ТБ/с, многокристальная конструкция N2P, 96 ускорителей в стойке мощностью 167 кВт, сеть масштабирования до 12 288 ускорителей и жидкостное охлаждение, отводящее более 80% тепла стойки.
Цель Microsoft — масштабировать семейство Maia до многогигаваттных развертываний и сделать его основной системой инференса для собственных продуктов и сервисов, сохраняя при этом гетерогенность Azure.
История Maia 300 связана не столько с заменой одного чипа другим, сколько с тем, как Microsoft проектирует весь путь от кремния до дата-центра и агента вокруг экономики ИИ-инференса.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



