Название: Развёртывание-Продакшн Описание: Проверка и развёртывание приложения в производственной среде. --- 1. Прочитайте checklist.md. 2. ...
checklist.md.scripts/verify-release.sh.Ключевой механизм — постепенное раскрытие.
Claude видит краткое описание, которое помогает ему решить, актуальна ли данная навыка. Полный текст навыка и вспомогательные файлы загружаются только тогда, когда требуется соответствующий процесс.
Мукта сравнивает это с книжной полкой.
Человеку не нужно запоминать каждую книгу до начала разговора. Ему достаточно знать, какая книга может содержать релевантную информацию, и достать её в подходящий момент.
Навыки помогают решить проблему «постоянно растущего контекстного файла»:
CLAUDE.md.Официальная документация Anthropic по навыкам рекомендует создавать навыки, когда команда многократно вставляет одни и те же инструкции, контрольные списки или многошаговые процессы в диалоги, или когда часть CLAUDE.md превратилась в процесс, а не в краткий факт.
Навыки переиспользуемы, но кто-то должен решать:
Агенты могут помогать писать и поддерживать навыки, но система по-прежнему частично зависит от ручного управления.
Это подводит нас к четвёртому подходу.
Мукта описывает память на основе файловой системы как предпочтительный паттерн, который Anthropic в настоящее время использует во многих системах памяти для агентов.
Логика здесь предельно прагматична.
Агенты уже хорошо умеют:
grep;Вместо того чтобы изобретать узкоспециализированный интерфейс памяти, команды могут организовать память в виде файлов и предоставить агентам обычные инструменты работы с файловой системой.
Возможная структура выглядит так:
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
Такая структура поддерживает разные уровни памяти:
Она также реализует постепенное раскрытие.
Агент может искать по каталогам и загружать только те файлы, которые относятся к текущей задаче.
Интерфейс в стиле файловой системы не требует, чтобы каждая корпоративная память хранилась в виде неуправляемых файлов на ноутбуке.
Базовая реализация по-прежнему может использовать:
Ключевой момент в том, что агент получает простую, навигируемую абстракцию.
Во время сессии вопросов и ответов один из слушателей спросил, не эквивалентно ли это изобретению базы данных заново.
Мукта признал, что эта архитектура возвращает нас к знакомым принципам программной инженерии. Как только команда понимает, какие действия должны быть детерминированными, их можно перенести в контрольную структуру, а не позволять модели импровизировать каждый раз.
Папка, заполненная Markdown-файлами, может работать для одного пользователя.
Но когда тысячи агентов могут обновлять общую организационную память, это становится опасным.
Мукта выделила четыре производственных принципа:
Каждое обновление памяти должно иметь историю.
Полезные метаданные включают:
Записи памяти без отслеживания происхождения трудно заслужить доверие.
Предположим, агент добавил:
- Пятничные производственные развёртывания не требуют одобрения.
Без источника, рецензента и истории изменений другой агент может принять это утверждение за авторитетное.
Версионирование поддерживает:
Система версионированной памяти должна легко отвечать на вопрос:
Какое взаимодействие привело к появлению этого правила?
Два агента могут прочитать одну и ту же запись памяти в 10:00.
Агент A записывает обновление в 10:02.
Агент B, не зная об этом изменении, записывает свою версию в 10:03 и случайно удаляет обновление агента A.
Мукта описала паттерн параллелизма на основе хэшей:
Агент читает память и фиксирует хэш A
        ↓
Агент готовит обновление
        ↓
Агент снова читает память и фиксирует хэш B
        ↓
Если хэш A == хэш B:
    зафиксировать обновление
Иначе:
    перезагрузить, пересобрать и повторить
Это оптимистичный контроль параллелизма.
Модель может решать, какие изменения предложить, но контрольная структура должна детерминированно предотвращать перезапись более новых версий устаревшими.
Не каждый агент должен иметь право редактировать каждую запись памяти.
Разумная модель разрешений может выглядеть так:
| Область памяти | Типичный способ доступа |
|---|---|
| Принципы организации | Большинство агентов — только чтение; запись только через процесс рецензирования |
| Политика безопасности | Соответствующие агенты — только чтение; ограниченная запись под контролем человека |
| Процессы команды | Команда — только чтение; указанные сопровождающие — запись |
| Решения проекта | Агенты проекта — только чтение; предлагаемые правки требуют одобрения |
| Черновик агента | Чтение и запись — один агент |
| Предпочтения пользователя | Доступ для агентов в области пользователя |
| Конфиденциальный контекст клиента | Строгий доступ на основе ролей |
Агент не должен иметь возможность превратить неуверенное наблюдение в правило уровня организации.
Границы разрешений также должны применяться к Dreaming. Задачи интеграции могут получать только те разговоры и записи памяти, к которым их идентичность авторизована.
Память может стать одним из самых ценных AI-активов организации.
Она содержит:
Мукта считает, что командам следует избегать проектирования этого актива так, чтобы он работал только внутри одного продукта.
Переносимая система памяти должна иметь:
Переносимость позволяет одному и тому же тщательно организованному контексту поддерживать:
Даже хорошо спроектированные инструменты памяти имеют два структурных ограничения.
Агент должен одновременно выполнять задачу и поддерживать память в порядке.
Запись в память потребляет ресурсы, которые могли бы быть направлены на текущую цель.
Агент может:
Ограничение второе: агент видит только один сеанс
Агент может заметить, что какая-то команда один раз завершилась ошибкой.
Он не может увидеть, что та же самая команда завершилась ошибкой и в других 300 сеансах.
Специалист поддержки может увидеть, что один клиент запутался в каком-то положении политики.
Он не может увидеть, что та же путаница повторяется по всему региону.
Механизм обучения на уровне всей системы требует процесса с более широкой видимостью.
Именно этот процесс Anthropic называет «сновидением» (Dreaming).
Сновидение — это асинхронный процесс, который просматривает историю агентов после завершения обычной работы.
В текущих примечаниях к выпуску API Anthropic функция «сновидения» для управляемых агентов Claude описана как исследовательская предварительная версия.
Одно «сновидение» считывает:
Затем оно создаёт реорганизованное выходное хранилище памяти, в котором можно:
Это не переобучение модели.
Веса базовой модели не меняются.
Улучшение достигается за счёт изменения персистентного контекста, чтобы будущие сеансы могли извлекать эти материалы.
Мукта использует школу, чтобы объяснить разницу между обычной памятью и «сновидением».
Представьте:
Учитель может помочь одному ученику исправить одну ошибку.
Завуч же может заметить, что каждый ученик на уроке географии ошибается в одном и том же месте, потому что этот материал просто отсутствует в учебной программе.
Исправление на уровне системы — это не проверка каждого листа с ответами по отдельности.
Это обновление учебной программы.
Терминология агентов:
Это позволяет системе учиться на закономерностях, которые отдельный агент заметить не способен.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Упрощённый конвейер обработки сновидений выглядит так:
Блок-схема TD
    A[Существующее хранилище памяти] --> D[Оркестратор сновидений]
    B[Записи сеансов] --> D
    C[Вызовы инструментов и метаданные] --> D
    D --> E1[Ревизионный агент 1]
    D --> E2[Ревизионный агент 2]
    D --> E3[Ревизионный агент 3]
    E1 --> F[Агрегатор закономерностей]
    E2 --> F
    E3 --> F
    F --> G[Предлагаемые изменения памяти]
    G --> H{Человеческое утверждение}
    H -->|Принято| I[Обновлённое хранилище памяти]
    H -->|Отклонено| J[Сохранение существующей памяти]
Процесс ревизии может проверять не только сообщения пользователя и ассистента.
Полезные свидетельства включают:
Затем агенты сновидений ищут закономерности следующего рода, например:
Мукта упомянула, что дизайн Anthropic может включать примеры релевантных записей сеансов, а также статистику, показывающую частоту возникновения закономерности.
Эти свидетельства помогают человеку оценить, обосновано ли предлагаемое изменение памяти.
Процесс сновидения имеет широкий доступ и может повлиять на будущее поведение целого кластера агентов.
Это делает автоматические и непроверенные обновления рискованными.
Более безопасный рабочий процесс:
Например:
## Предлагаемое обновление памяти

**Цель:** `teams/engineering/test-process.md`

**Наблюдаемая проблема:**
Агенты в 18 из 63 релевантных сеансов использовали команду модульных тестов для запуска интеграционных тестов.

**Свидетельства:**
Сеансы `s-102`, `s-111`, `s-118`, `s-124`, …

**Предлагаемое дополнение:**
- Для всех тестов, требующих контейнеров с базой данных, использовать `npm run test:integration`.
- Не использовать `npm test` для файлов в `tests/integration/`.

**Уверенность:** высокая

**Решение человека:** ожидает
Такой подход сохраняет человеческий надзор и при этом позволяет кластеру агентов выполнять большую часть аналитической работы.
Сновидение требует дополнительных вызовов моделей.
На первый взгляд это кажется ненужными расходами.
Мукта считает, что более чистое хранилище памяти снижает общую стоимость, потому что будущие агенты с большей вероятностью выполнят задачи правильно с первой попытки.
С первой попытки.
Полезное экономическое сравнение:
Стоимость сновидения
против
стоимости повторных сбоев, повторов, переделок и чрезмерно длинных контекстов
Потенциальная экономия может быть получена за счёт:
Anthropic пока не опубликовал универсальный бенчмарк, показывающий, сколько сможет сэкономить каждая организация. Конкретная ценность зависит от:
«Сновидение» с наибольшей вероятностью окупается, когда большое количество агентов выполняет схожие задачи и repeatedly сталкивается с одними и теми же закономерностями.
Команде не обязательно ждать полной платформенной интеграции, чтобы протестировать эту концепцию.
Ручную версию можно запускать раз в неделю.
Собирайте только те записи разговоров, к которым рецензент имеет право доступа.
Организуйте их по:
Включите:
CLAUDE.mdПромпт может выглядеть так:
Просмотрите эти авторизованные записи сеансов и текущие файлы памяти.

Выявите повторяющиеся сбои, повторные исправления пользователем, устаревшие инструкции,
отсутствующие процессы и дублирующиеся записи.

Для каждого предлагаемого изменения:
1. Укажите целевой файл.
2. Приведите подтверждающие ID сеансов.
3.

Укажите частоту появления этой схемы.
4. Составьте минимально эффективное изменение.
5. Не редактируйте файлы напрямую.
Отклоняйте следующие изменения:
Используйте систему контроля версий и включайте исходные доказательства в записи коммитов или аудита.
Отслеживайте, уменьшается ли количество тех же сбоев в последующих сессиях.
Без измерения «мечтание» превращается в упражнение по созданию документации, а не в обучающую систему.
Память отвечает на вопрос:
Что агент должен запоминать из предыдущей работы?
Графовая инженерия отвечает на другой вопрос:
Какие части текущей задачи на самом деле зависят друг от друга?
Исходная статья BAAI связывает тему памяти с руководством по графовой инженерии, распространяющимся в сообществе разработчиков ИИ.
Основной тезис этого руководства заключается в том, что многие «рабочие процессы» по своей сути уже являются графами — просто плохо спроектированными.
Рабочие процессы, описанные в виде списков, часто искусственно превращаются в последовательные процессы:
Исследование
    ↓
Обобщение
    ↓
Сравнение
    ↓
Проверка фактов
    ↓
Написание
Некоторые из этих шагов действительно могут зависеть от выходных данных предыдущих шагов.
Другие могут просто ожидать без необходимости.
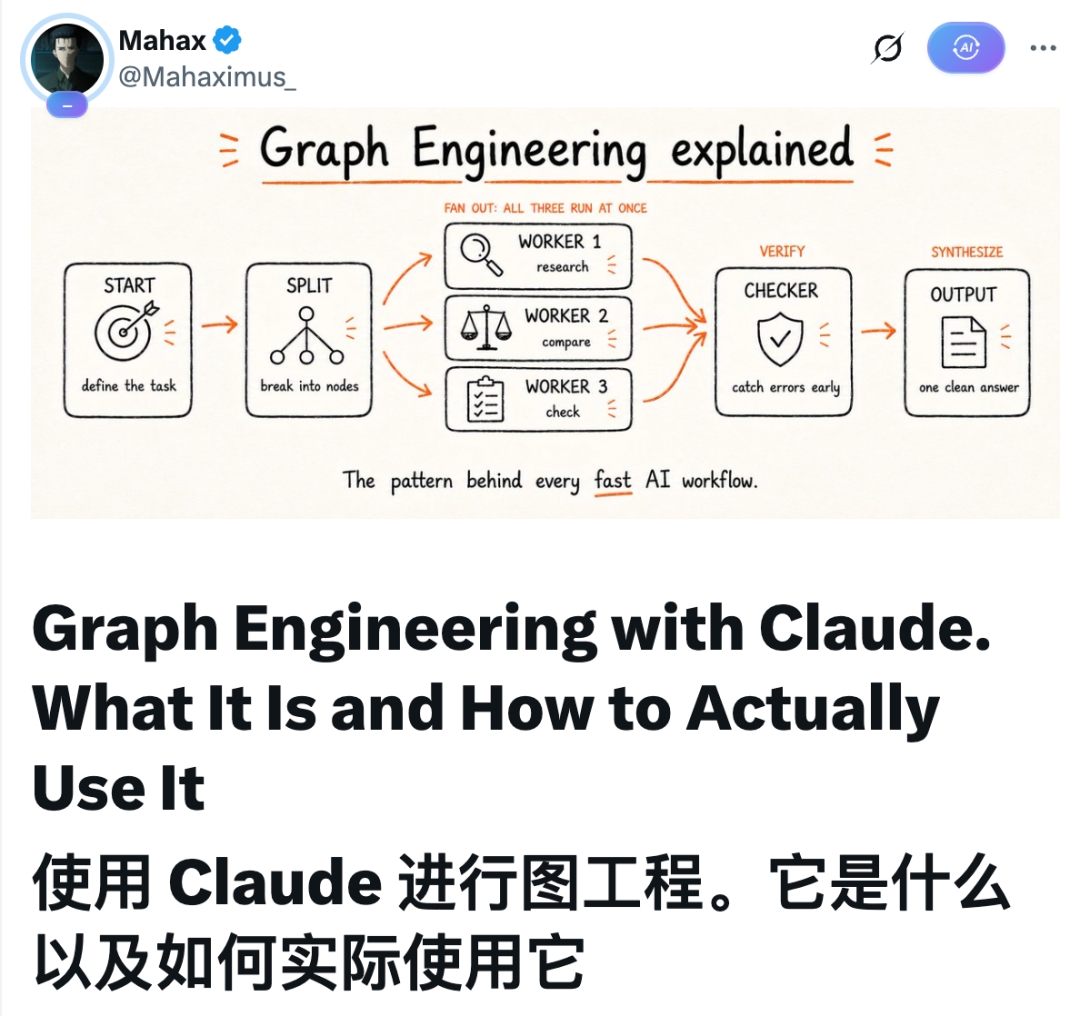
На этом рисунке наглядно показаны реальные потоки данных между узлами и рёбрами в графовой инженерии, что соответствует ключевой идее документа о том, что рабочие процессы должны избегать бессмысленной последовательности и отражать реальные зависимости. Это объясняет, как графовая инженерия упорядочивает логику ИИ-рабочих процессов.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/08/a764b6a5-a30c-40e7-a942-95d4d16746be-5eabeb96-009c-4ee8-970a-35df96f1f4a4.png)
В графе рабочего процесса:
Например:
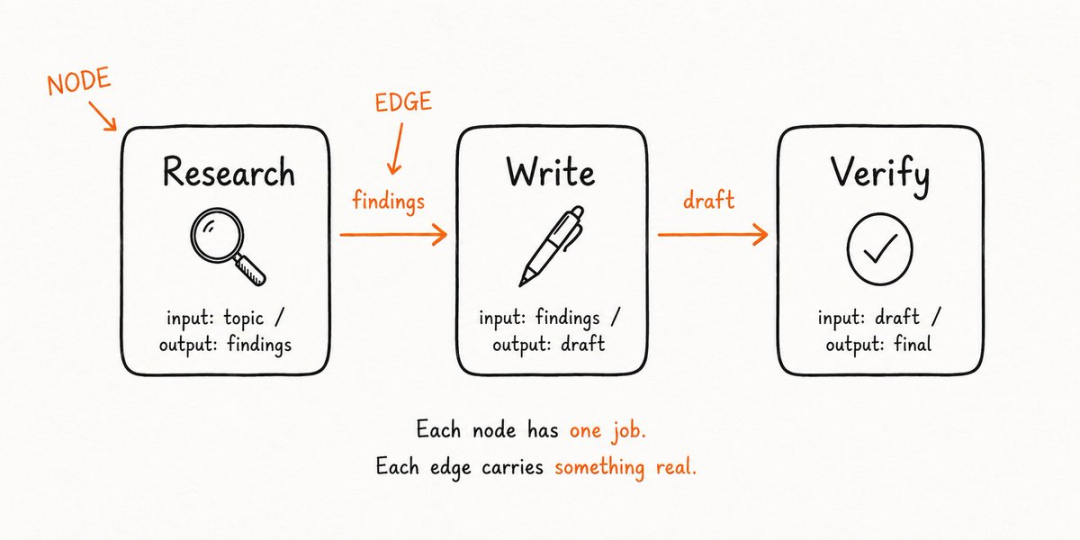
Узел исследования создаёт результаты исследования.
Узел написания потребляет эти результаты и создаёт черновик.
Узел проверки потребляет черновик и создаёт выверенный результат.
Эти стрелки обоснованы, поскольку каждый нижестоящий узел нуждается в выходных данных вышестоящего узла.
В графовом руководстве сообщества предлагается простой тест для каждой стрелки:
Действительно ли следующей задаче нужны выходные данные предыдущей?
Если ответ отрицательный, то эта зависимость является ложной.
Рассмотрим следующий рабочий процесс:
Исследование конкурента A
    ↓
Исследование конкурента B
    ↓
Исследование конкурента C
    ↓
Написание сравнительного отчёта
Для исследования конкурента B обычно не требуются выходные данные исследования конкурента A.
Для исследования конкурента C обычно не требуются выходные данные исследования конкурента B.
Эти задачи могут выполняться параллельно:
flowchart TD
    A[Определение критериев сравнения] --> B1[Исследование конкурента A]
    A --> B2[Исследование конкурента B]
    A --> B3[Исследование конкурента C]
    B1 --> C[Написание сравнительного отчёта]
    B2 --> C
    B3 --> C
Удаление ложных рёбер сокращает время ожидания.
Если три исследовательские задачи занимают 10, 12 и 15 минут соответственно:
Граф не делает ни одного конкретного агента быстрее.
Он меняет способ планирования.
После удаления ложных рёбер возникает распространённая форма:
Это обычно называют ромбом.
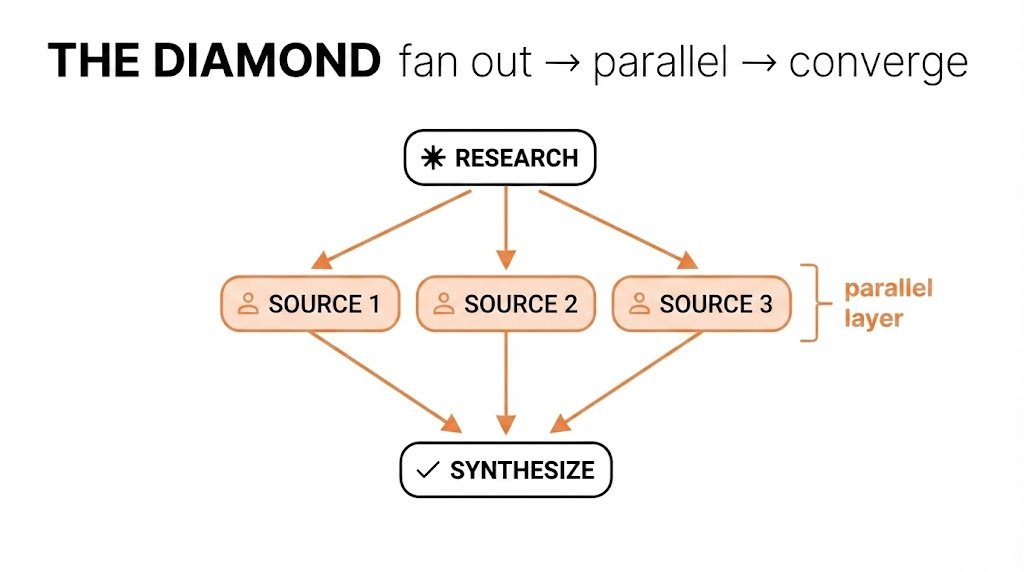
Пример исследования может выглядеть так:
flowchart TD
    A[Исследовательский вопрос] --> B1[Рыночные данные]
    A --> B2[Свидетельства клиентов]
    A --> B3[Анализ конкурентов]
    B1 --> C[Проверяющий]
    B2 --> C
    B3 --> C
    C --> D[Финальный синтез]
Общее время определяется в основном самой медленной ветвью, а не суммой времени всех ветвей.
Параллельность вносит новый
риск.
Один рабочий поток может создать слабый, устаревший или неподтверждённый результат.
Если система объединяет всё без проверки, одна плохая ветвь может испортить финальный ответ.
Поэтому графовое руководство размещает проверяющего перед этапом синтеза.
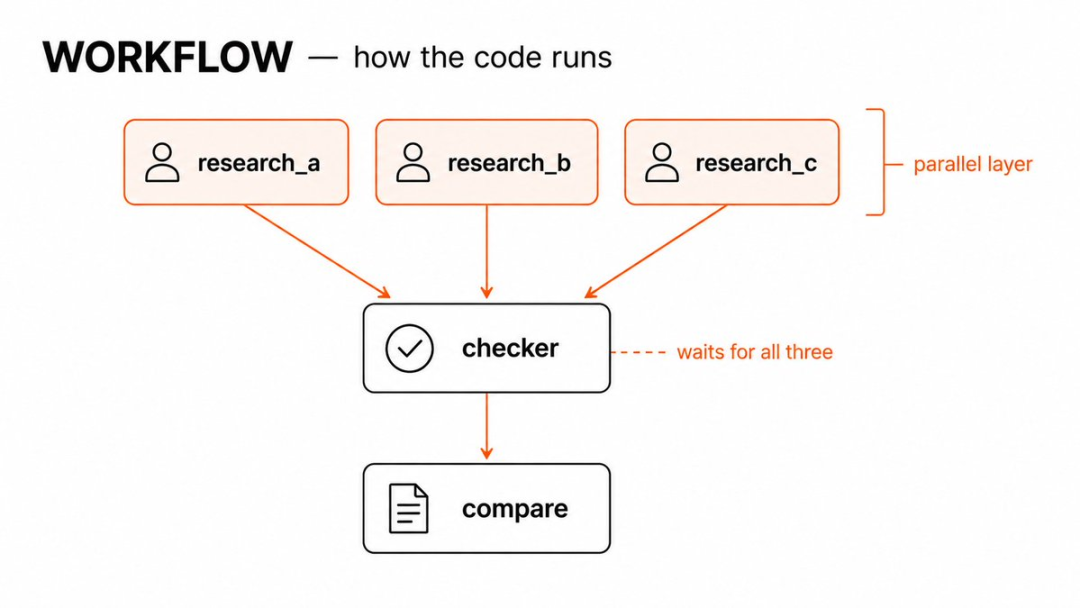
Проверяющий может задать вопросы:
Соответствует ли вывод требуемому формату?
Полезный проверщик должен иметь чёткие критерии приёмки.
Например:
Начните с одной фразы и получите полноценный сайт за считанные минуты.



